Producto y conceptos
¿Qué es Jev AI? Guía práctica de System One y las decisiones ejecutables
Jev AI es un modelo de decisión para software: proporciona el estado del negocio y preguntas tipadas para recibir resultados estructurados, probabilidades y señales de confianza que sirven para clasificar, enrutar, puntuar y realizar comprobaciones de seguridad.
¿Qué es Jev AI? Guía práctica de System One y las decisiones ejecutables
Cuando añades IA a un agente, un sistema de soporte, un flujo de trabajo o un producto SaaS, lo más difícil muchas veces no es pedirle a un modelo que escriba un párrafo. Lo complicado es tomar decisiones pequeñas de forma coherente entre muchas solicitudes: ¿a qué equipo debe llegar este ticket? ¿Esta acción necesita aprobación humana? ¿Qué urgencia tiene la tarea? ¿Qué modelo o herramienta debe ejecutarse después?
Jev AI está diseñado para convertir esos juicios en decisiones estructuradas que el software pueda consumir directamente. El sitio web de Jev AI presenta Jev como una herramienta de decisión para equipos de software. La documentación oficial de TypeSafe lo describe como su modelo insignia y su primer modelo System One: se proporcionan un State y preguntas tipadas y se reciben opciones, puntuaciones, juicios de sí/no y señales de probabilidad.
Esta guía explica qué es Jev AI, cómo funciona, dónde encaja junto a los LLM generativos, cómo conectar su API y qué limitaciones conviene tener en cuenta al diseñar para producción.
En pocas palabras: Jev AI no sustituye a todos los sistemas de IA conversacional. Es una capa de decisión dentro de tu aplicación para clasificar, enrutar, puntuar y realizar comprobaciones de seguridad de forma rápida y repetible dentro de un espacio de respuestas definido.
Tabla de contenidos
- Qué es Jev AI
- Cómo funciona Jev AI
- Los tres tipos de pregunta
- Por qué no pedir JSON a un LLM
- Dónde encaja Jev AI
- Cómo empezar
- Probabilidad, confianza y límites
- Precios de Jev AI
- Preguntas frecuentes
Qué es Jev AI
Un modelo System One para software
Los grandes modelos de lenguaje están diseñados principalmente para generar texto que lean las personas. Cuando el software necesita un juicio acotado, los desarrolladores suelen añadir tres pasos: describir el formato de salida en un prompt, analizar una respuesta en lenguaje natural o JSON y decidir después si se ejecuta una acción. Este enfoque es flexible, pero también introduce errores de formato, texto adicional e incertidumbre en la capa de aplicación.
Jev AI ofrece una interfaz diferente:
- State: envía un ticket, mensaje, campos de formulario u objeto JSON como contexto para la decisión.
- Preguntas tipadas: define exactamente el tipo de juicio que necesita la aplicación.
- Resultado estructurado: recibe un resultado que el código puede usar para ramificar, ordenar, enrutar o guardar.
Consulta la página principal de Jev AI para conocer el posicionamiento del producto y la introducción oficial de TypeSafe para ver el modelo System One y sus elementos básicos.
Jev AI frente a los LLM generativos
Jev AI y los LLM generativos no son simplemente versiones en competencia del mismo producto. Son útiles para trabajos distintos: los LLM destacan en generación abierta, explicaciones y tareas creativas; Jev está pensado para decisiones acotadas y repetidas sobre las que el software debe actuar.
| Dimensión | Jev AI | LLM generativo | Código basado en reglas |
|---|---|---|---|
| Salida principal | Opciones, puntuaciones, juicios de sí/no, probabilidades y confianza | Texto, código o contenido estructurado de formato abierto | Valores deterministas derivados de condiciones explícitas |
| Mejor para | Clasificación, enrutamiento, prioridad, comprobaciones de riesgo y control de herramientas | Redacción, resúmenes, preguntas y respuestas, razonamiento complejo | Condiciones estables que no necesitan interpretación semántica |
| Interfaz | State + preguntas tipadas | Prompt + contexto | If/else, motor de reglas o consulta |
| Incertidumbre | Visible mediante señales de probabilidad y confianza | Suele requerir validación personalizada | Normalmente no hay probabilidad de modelo |
| Función en el sistema | Capa de decisión dentro de la lógica de la aplicación | Centro de generación o razonamiento | Capa de ejecución determinista |
Jev no define tu política de negocio. Tu equipo sigue eligiendo el espacio de respuestas, la rúbrica de puntuación, los umbrales y la estrategia de revisión humana.
Cómo funciona Jev AI
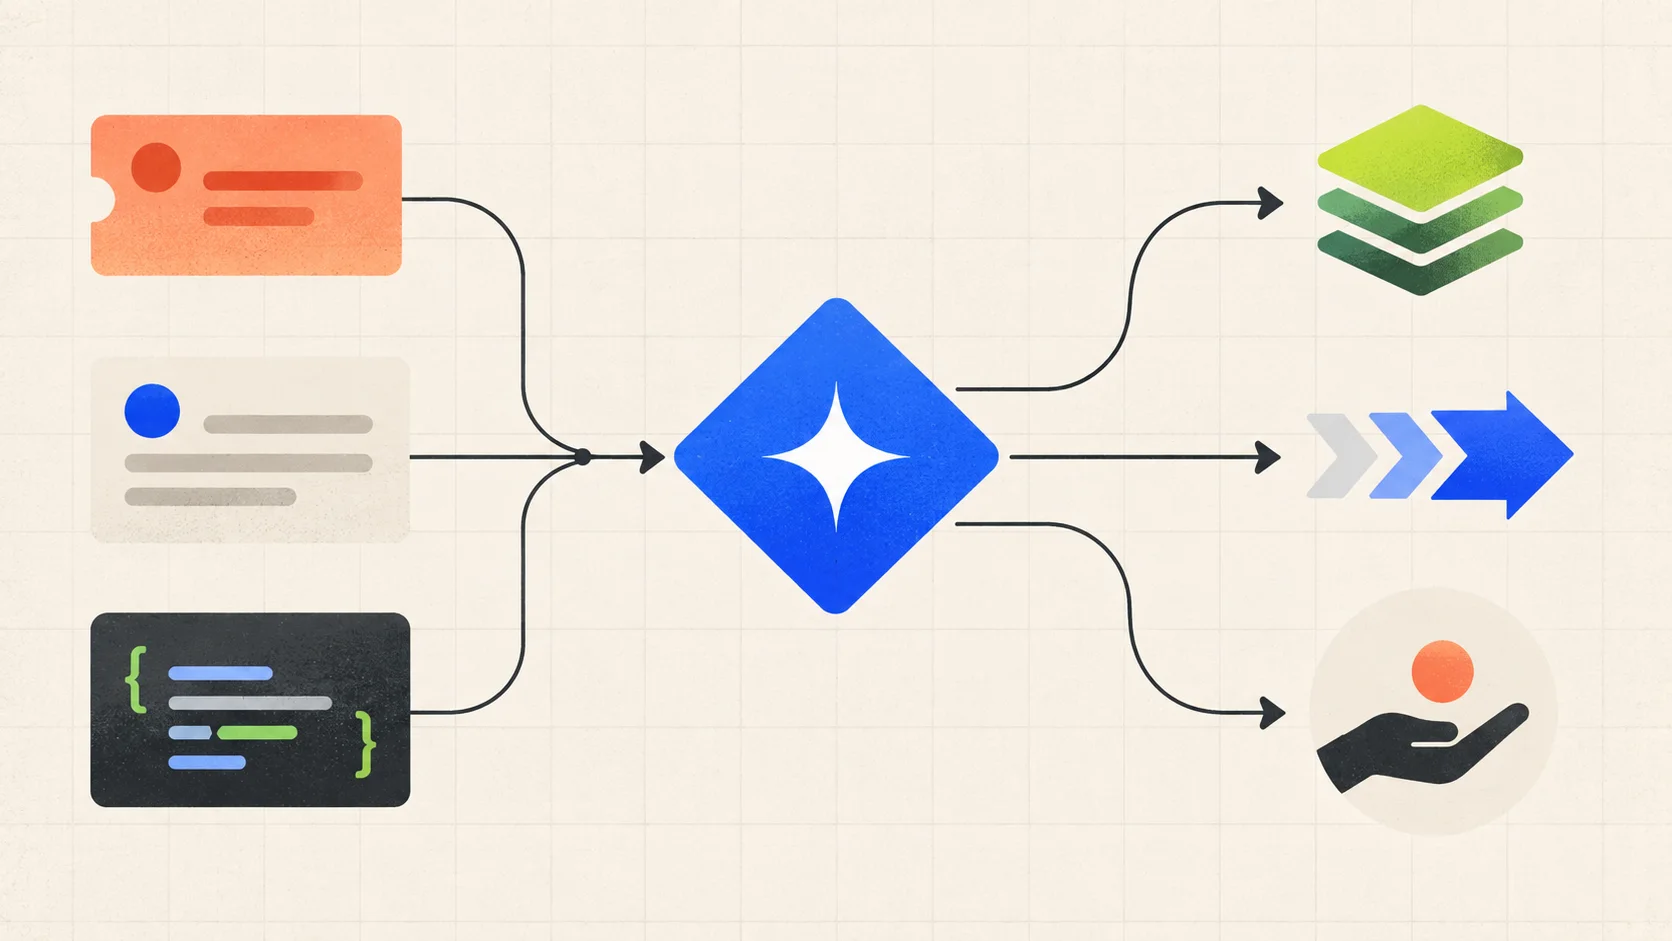
Imagen: varias preguntas pequeñas pueden consultar el mismo State, mientras el código de la aplicación decide qué ocurre después.
El flujo descrito en la documentación oficial se puede resumir en cuatro pasos.
1. Preparar el State
State es el contexto que leen todas las preguntas. Puede ser:
- una cadena en lenguaje natural, como un mensaje de soporte, una alerta o un informe de usuario;
- un objeto JSON con un ticket, un pedido, el nivel del usuario y campos de políticas;
- un array de textos, como mensajes relacionados o fragmentos recuperados.
Por lo general, las preguntas deben plantearse sobre un State compartido en lugar de incluir todo un proceso de negocio en un único prompt enorme. La documentación actual indica que Jev acepta texto, objetos JSON y arrays de textos; por ahora, las imágenes, el audio y el vídeo no son entradas directas compatibles.
2. Definir preguntas tipadas
Cada pregunta debe cubrir un juicio específico. En lugar de preguntar «¿Debemos conservar a este cliente y qué equipo debe hacer el seguimiento?», divídelo en «¿Qué equipo debe encargarse?» y «¿Hace falta un flujo de retención?». Las preguntas más pequeñas son más fáciles de probar y combinar en el código.
3. Leer la respuesta estructurada
Jev devuelve las respuestas usando los IDs de las preguntas que envías. Los campos dependen del tipo de pregunta: Choice puede devolver una opción seleccionada, probabilidades y confianza; Score puede devolver una puntuación, una leyenda, probabilidades y confianza; Noul devuelve una probabilidad de respuesta afirmativa.
Las respuestas también pueden incluir información de ejecución como usage y elapsedMs. elapsedMs indica el tiempo de extremo a extremo de la petición, no necesariamente el tiempo exclusivo de inferencia del modelo.
4. Dejar que el código decida la siguiente acción
El modelo evalúa; la aplicación actúa. El código puede llamar a route(), queue(), block(), request_review() u otro LLM. Así, los umbrales, permisos, registros de auditoría y alternativas para casos de alto riesgo siguen bajo el control de la aplicación.
Para ver el flujo completo, abre el Playground de Jev AI y prueba un estado empresarial real, pero de bajo riesgo.
Los tres tipos de pregunta
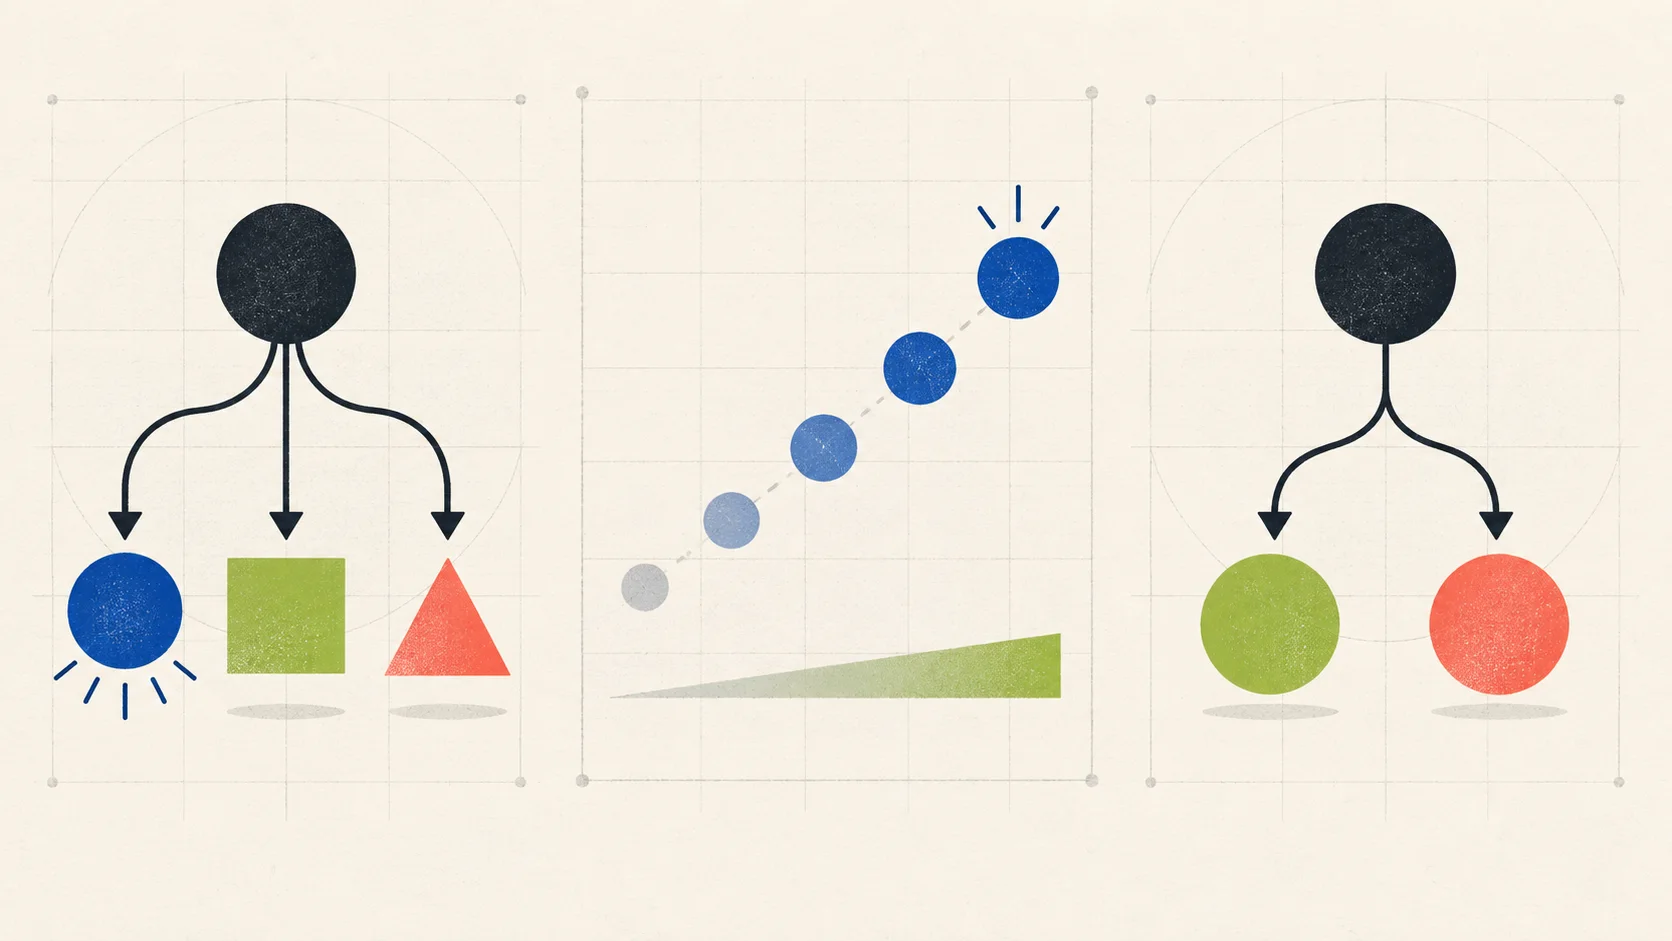
Imagen: los tres elementos básicos corresponden a elegir, puntuar y juzgar si una afirmación es verdadera.
Choice: elegir entre opciones definidas
Choice está pensado para clasificación y enrutamiento. Algunos ejemplos:
- ¿Debe esta solicitud de soporte ir a facturación, al equipo técnico o a otro equipo?
- ¿Este contenido es un tutorial, una actualización de producto o una historia de cliente?
- ¿La solicitud debe usar un modelo rápido, uno más potente o un flujo de trabajo con una persona?
Define las opciones y sus descripciones de antemano. Si pueden darse casos desconocidos, conserva una opción other o none-of-the-above para no obligar al modelo a elegir una coincidencia incorrecta.
Score: evaluar según una rúbrica ordenada
Score encaja con los niveles de gravedad, satisfacción, prioridad y riesgo. Puedes definir niveles desde «no hace falta actuar» hasta «escalado inmediato» y usar el resultado ponderado por probabilidad de Jev para ordenar una cola.
La rúbrica debe ser concreta. En vez de limitarte a pedir que se juzgue la urgencia, describe los plazos, el impacto en el cliente y las consecuencias operativas de cada nivel. Así la puntuación resulta más útil para los SLA y la lógica de priorización.
Noul: decidir si una afirmación es verdadera
Noul sirve para juicios binarios como «¿El cliente está solicitando explícitamente un reembolso?» o «¿Esta llamada a una herramienta debe requerir confirmación humana?». Devuelve una probabilidad de sí entre 0 y 1, no un segundo campo de confianza.
Cuando una conclusión contiene varias condiciones independientes, sepáralas en preguntas Noul y combina los resultados en el código. Es más fácil de evaluar que pedir a una sola pregunta que gestione hechos, riesgo y acción a la vez.
Consulta la documentación de preguntas de Jev AI y la documentación de la API de TypeSafe para ver los campos y ejemplos actuales.
Por qué no pedir JSON a un LLM
Pedir a un LLM que devuelva JSON sigue siendo un patrón de ingeniería útil. Jev AI aporta valor cuando la propia decisión tiene una forma conocida y debe repetirse de forma fiable.
El límite de respuestas es explícito
Choice, Score y Noul representan distintas semánticas de decisión. El desarrollador define primero el espacio de respuestas, así que el código de la aplicación no tiene que deducir la intención a partir de un párrafo.
Un State permite varias preguntas
Un ticket de soporte puede evaluarse por departamento, urgencia e intención de reembolso en una misma petición. La documentación oficial indica que varias preguntas se evalúan en paralelo sobre el mismo State, por lo que no hace falta encadenar llamadas separadas solo para dividir una decisión.
Las señales de probabilidad pueden formar parte del flujo de control
Cuando el resultado es suficientemente claro, el código puede enrutar automáticamente. Si está cerca del umbral o la acción es arriesgada, el sistema puede pedir una revisión humana, solicitar más información o llamar a un modelo más potente. Así, el nivel de automatización puede variar según la señal, en lugar de tratar todas las salidas como igualmente seguras.
La política permanece en el código
Jev responde a una pregunta definida sobre el State actual. Tu aplicación sigue siendo responsable de los umbrales, permisos, reintentos, pistas de auditoría y acción final. Cuando cambia la política, puedes actualizar la definición de la pregunta o el código sin reconstruir un enorme prompt conversacional.
Jev no está pensado para todas las tareas. La investigación abierta, las explicaciones largas y la generación creativa siguen correspondiendo a un modelo generativo o a una persona.
Dónde encaja Jev AI
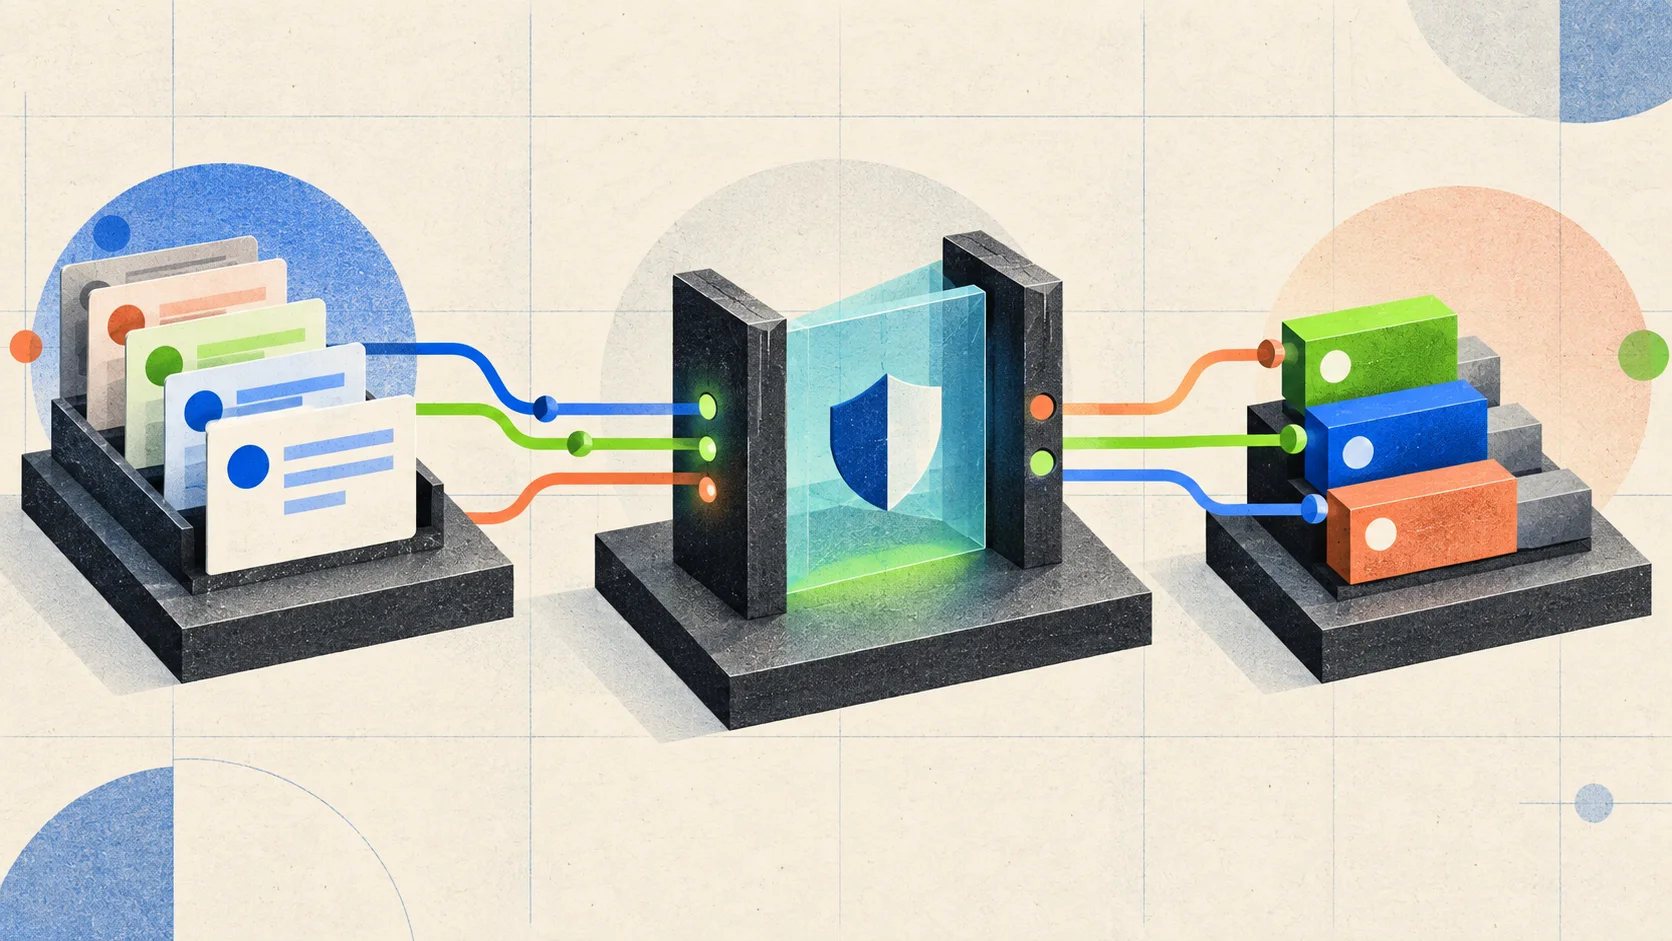
Imagen: Jev puede actuar como un nodo de decisión entre las entradas, los guardarraíles y las colas de ejecución.
Clasificación y enrutamiento de tickets de soporte
Usa el texto del ticket, el nivel del cliente y el historial relevante como State. Usa Choice para elegir el equipo y Score para estimar la urgencia. Después, la cola puede ordenarse por equipo, puntuación y probabilidad, mientras que los casos con poca confianza pasan a revisión humana.
Enrutamiento de modelos para agentes de IA
Clasifica la dificultad de la tarea, las herramientas necesarias y el riesgo antes de elegir un modelo rápido, otro más potente o un flujo humano. Jev decide la ruta; la capa de orquestación del agente sigue gestionando las llamadas a modelos, el contexto y las herramientas.
Comprobaciones de seguridad antes de llamar a herramientas
Antes de borrar datos, cargar una tarjeta, cambiar permisos o enviar un mensaje externo, usa Noul para determinar si la intención es explícita y si la solicitud cumple la condición requerida. Las acciones de alto riesgo también deben aplicar reglas estrictas, comprobaciones de autorización y registros de auditoría.
Prioridad de colas y escalado humano
Divide el impacto, el plazo y el estado del cliente en preguntas separadas de Score o Noul y combínalas después en una fórmula de clasificación en el código. Así, los equipos de operaciones pueden cambiar las ponderaciones sin reescribir un prompt enorme.
Extracción de información estructurada
Cuando los campos de destino y los valores posibles se puedan definir de antemano, Jev puede ayudar con la clasificación y validación ligeras. Para campos desconocidos, extracción de texto extenso o relaciones complejas entre entidades, usa primero un modelo generativo y Jev como validador o enrutador.
Cómo empezar
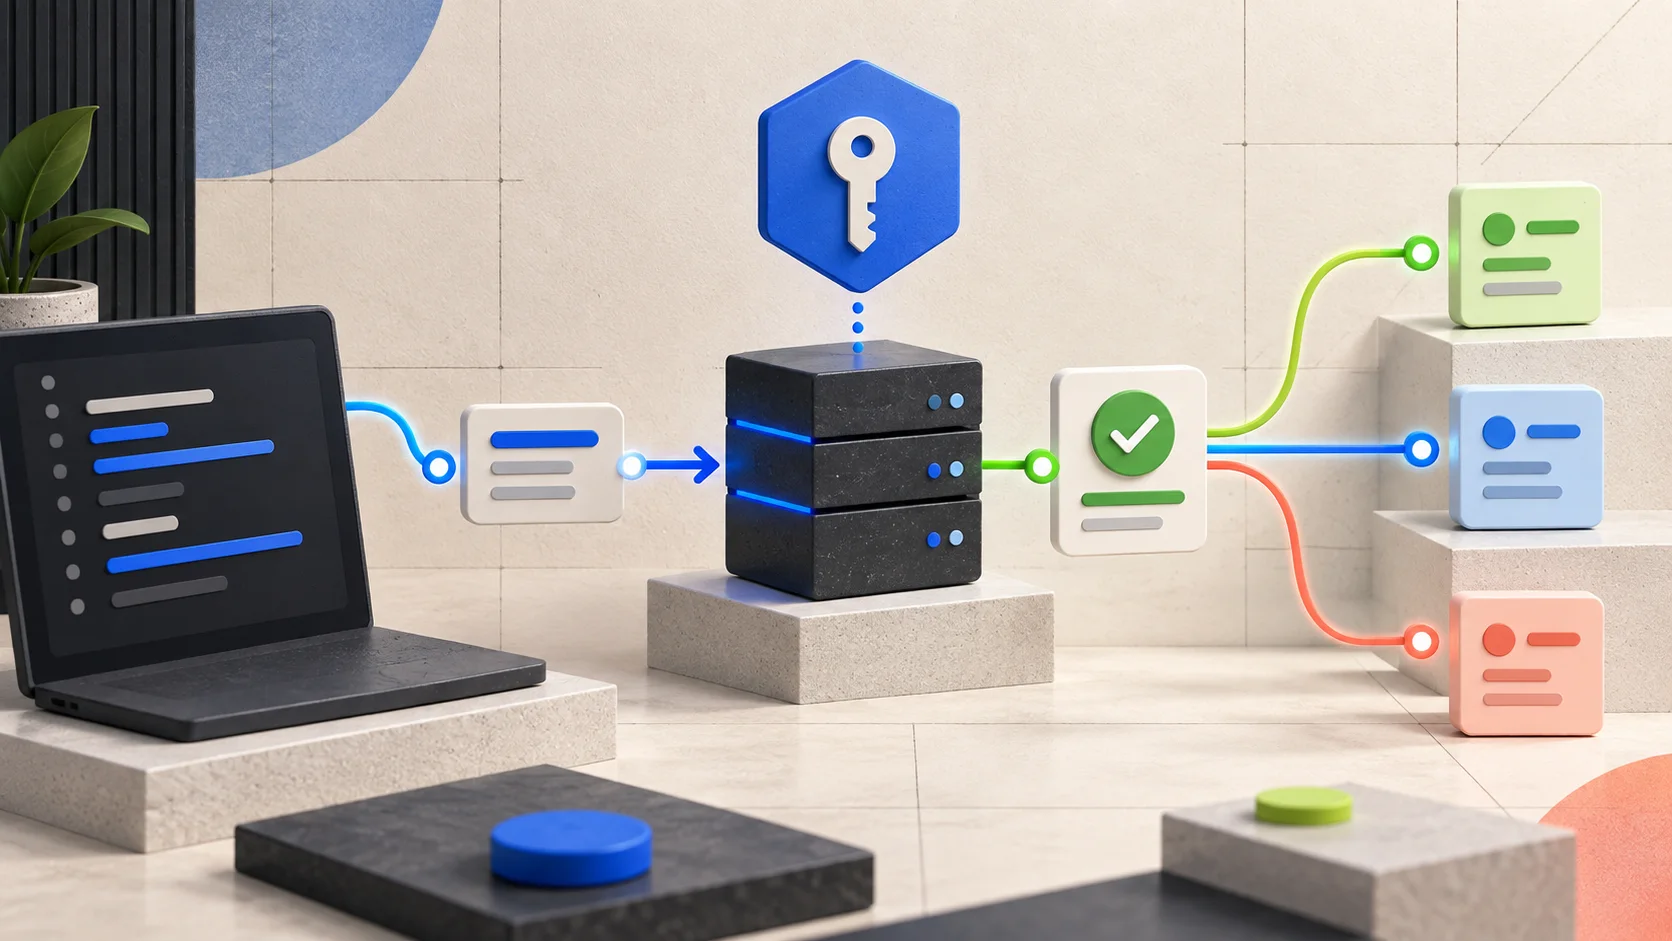
Imagen: mantén la llamada a la API en el servidor y devuelve el resultado estructurado al código de la aplicación.
Paso 1: valida una decisión en el Playground
Elige una decisión de bajo riesgo con un resultado medible y un espacio de respuestas claro. No traslades todo un flujo de trabajo a la primera prueba. Comprueba que un solo juicio realmente reduce el trabajo manual o la lógica repetida de la aplicación.
Paso 2: crea una clave de API en el servidor
Después de validar el flujo, sigue la guía de la API de Jev AI para crear una clave de API. Guárdala en una variable de entorno del servidor. Nunca la incluyas en código del navegador, en un ejemplo real de Markdown ni en un repositorio Git.
Paso 3: llama al endpoint systemone
La documentación actual del sitio web utiliza POST https://thejevai.com/v1/systemone. Este es un ejemplo mínimo de Noul basado en la estructura documentada de la petición:
curl -X POST https://thejevai.com/v1/systemone \
  -H "Authorization: Bearer $JEV_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "typesafe/jev-1.13",
    "state": "A customer has tried to connect Stripe for three days.",
    "questions": {
      "urgent": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }'
Conceptualmente, answers contiene resultados asociados a IDs de preguntas, usage contiene información de consumo y elapsedMs informa del tiempo total de la petición. El código de producción debe seguir la referencia oficial de la API para conocer todos los campos, validaciones y tratamiento de errores, en lugar de deducir cada parámetro opcional a partir de un ejemplo breve.
Paso 4: conecta el resultado con el flujo de control
Un flujo de producción robusto suele incluir:
- Validar la longitud, los permisos y los datos sensibles antes de enviar el State.
- Enviar un conjunto pequeño y bien delimitado de preguntas.
- Validar la estructura de la respuesta y el estado de la petición.
- Usar la probabilidad, la confianza, el riesgo del negocio y los umbrales para elegir entre automatización o revisión.
- Registrar la versión de entrada, la definición de la pregunta, la versión del modelo y la acción final para poder reproducir y evaluar el resultado.
Para consultar las cuotas, la gestión de claves de API y los detalles de los planes, visita la página de precios de Jev AI.
Probabilidad, confianza y límites
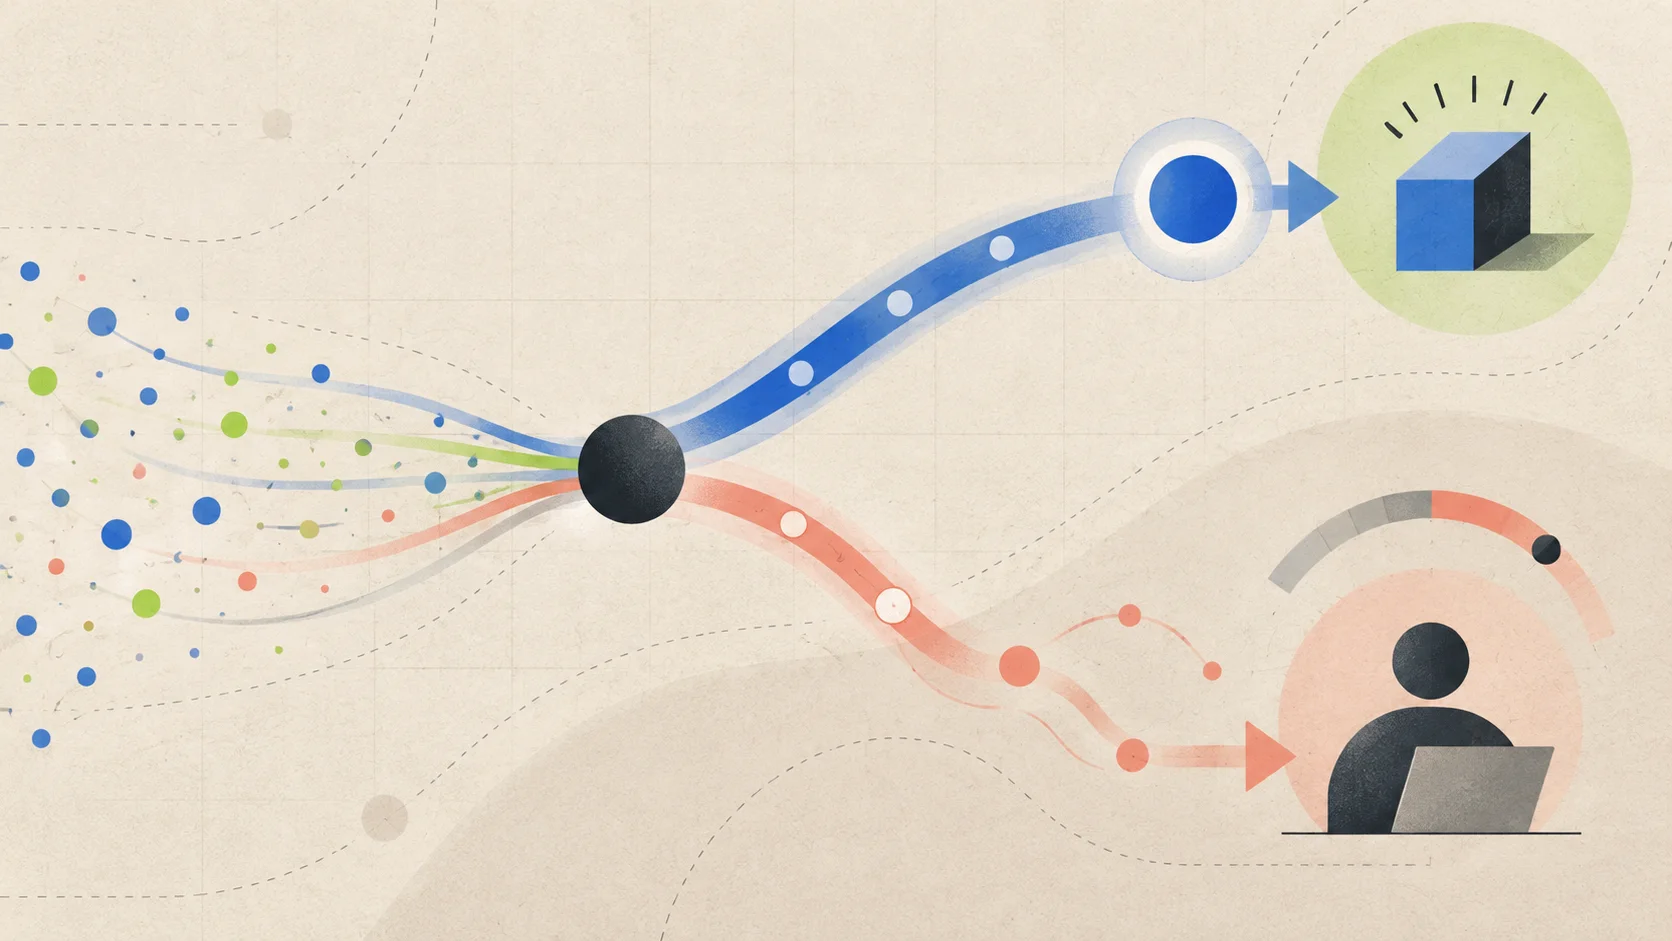
Imagen: la probabilidad debe ayudar al sistema a elegir el nivel de automatización, no sustituir los controles de riesgo.
La probabilidad no garantiza la precisión empresarial
La documentación oficial indica expresamente que la probabilidad y la confianza son señales para la automatización, no garantías de precisión empresarial. Un resultado con mucha confianza aún puede ser incorrecto para tu dominio, idioma, distribución de datos o política.
Usa estrategias distintas según la acción:
- En la clasificación de bajo riesgo puede bastar un umbral menor si existe una vía de corrección.
- Las acciones de riesgo medio deben incluir reintentos, contraejemplos y muestreo humano.
- Las eliminaciones, los pagos y los cambios de permisos deben combinar las señales del modelo con reglas estrictas, autorización y confirmación humana.
Mantén las preguntas acotadas
Una buena pregunta solicita un único juicio y da un significado claro a cada respuesta. Si necesita razonar sobre un contexto largo, varios factores independientes, una interpretación de políticas y una recomendación de acción, divídela en preguntas más pequeñas y combínalas en el código.
Preprocesa las entradas que no sean texto
La documentación actual del sitio enumera textos, objetos JSON y arrays de textos como entradas compatibles para State. Por ahora, las imágenes, el audio y el vídeo no son entradas directas. Para chino, terminología especializada o datos específicos del dominio, crea tu propio conjunto de evaluación y prueba Choice, Score y Noul por separado.
Valida la latencia en tu entorno
La página principal de Jev AI muestra un intervalo de respuesta de 70–500 ms, pero la latencia real depende de la ubicación de red, el tamaño de la petición, la concurrencia, las colas y las condiciones del servicio. Interpreta la cifra como posicionamiento del producto, no como tu SLA. Antes de depender de ella en producción, realiza pruebas de rendimiento con peticiones reales y la concurrencia prevista.
Precios de Jev AI
El siguiente resumen refleja la página de precios consultada el 20 de septiembre de 2026. Los planes y beneficios pueden cambiar, así que confírmalos en la página oficial de precios antes de comprar.
| Plan | Precio | Créditos y uso previsto |
|---|---|---|
| Starter | $10 | 100.000 créditos sin caducidad para validar un flujo real |
| Pro | $100 | 1.000.000 de créditos, varios espacios de trabajo y uso de la API en producción |
| Enterprise | $1.000 | 11.000.000 de créditos, incluido un 10 % adicional, colaboración en equipo y soporte para integraciones personalizadas |
No compares solo el total de créditos. Estima el tamaño de cada State, la cantidad de preguntas por petición, si las decisiones se evalúan en paralelo y cuántos resultados con poca confianza requerirán revisión humana.
Preguntas frecuentes
¿Jev AI es un chatbot?
No. Jev AI está diseñado para que el software consuma decisiones estructuradas, no para generar respuestas conversacionales. Puede funcionar como nodo de evaluación dentro de un chatbot, un agente o un flujo SaaS.
¿Puedo usar Jev AI sin experiencia de desarrollo?
Puedes empezar con el Playground para entender State, los tipos de pregunta y los resultados. Conectar decisiones con un producto y gestionar claves de API, permisos, reintentos y revisión humana sigue requiriendo conocimientos básicos de desarrollo backend.
¿Jev AI puede sustituir a un modelo de lenguaje grande?
Por lo general, no por sí solo. Jev se adapta a decisiones acotadas; un LLM generativo, a textos abiertos, explicaciones y razonamiento más profundo. En un sistema práctico, Jev puede enrutar peticiones y comprobar acciones arriesgadas mientras un LLM se ocupa de la generación o el razonamiento complejo.
¿Cómo elijo entre Choice, Score y Noul?
- Usa Choice cuando necesites una opción de un conjunto.
- Usa Score cuando necesites una evaluación ordenada de gravedad, prioridad o calidad.
- Usa Noul cuando necesites decidir si una afirmación es verdadera.
¿La confianza equivale a la precisión?
No. La confianza y la probabilidad son señales que ayudan a la aplicación a elegir el nivel de automatización. Evalúa el modelo con tus propios datos, idioma, dominio y nivel de riesgo, y conserva una vía de revisión humana para las acciones de alto impacto.
¿Dónde encuentro la documentación y los ejemplos más recientes?
Empieza por la documentación oficial y luego explora los flujos de la comunidad en Showcase. Si estás desarrollando una integración concreta, valida primero un ejemplo pequeño en el Playground.
Conclusión: primero haz fiable una decisión pequeña
Jev AI no pretende meter todas las capacidades de IA en un único modelo. Su valor consiste en hacer explícitos los pequeños juicios que ya están ocultos en el software: definir el estado, formular preguntas tipadas, leer señales de probabilidad y dejar que el código decida si debe enrutar, poner en cola, bloquear o solicitar confirmación humana.
Para los equipos que desarrollan agentes de IA, automatización de soporte, herramientas para desarrolladores y flujos de negocio, un buen punto de partida es una decisión de bajo riesgo y medible. Valídala en el Playground de Jev AI y después conéctala en el servidor usando la documentación de la API. Diseña los límites, umbrales y rutas de fallo junto con la llamada al modelo para que Jev se convierta en un componente de software mantenible, no en una demo puntual.
Fecha de investigación: 2026-09-20
Fuentes primarias: thejevai.com, Documentación de Jev AI, Precios de Jev AI, Introducción de TypeSafe