Guías para desarrolladores
Jev AI TypeSafe AI: guía práctica para decisiones tipadas en producción
Entiende Jev AI, TypeSafe AI y las decisiones tipadas: diseña estados y preguntas, valida respuestas y crea flujos de IA más seguros.
Jev AI TypeSafe AI: guía práctica para decisiones tipadas en producción
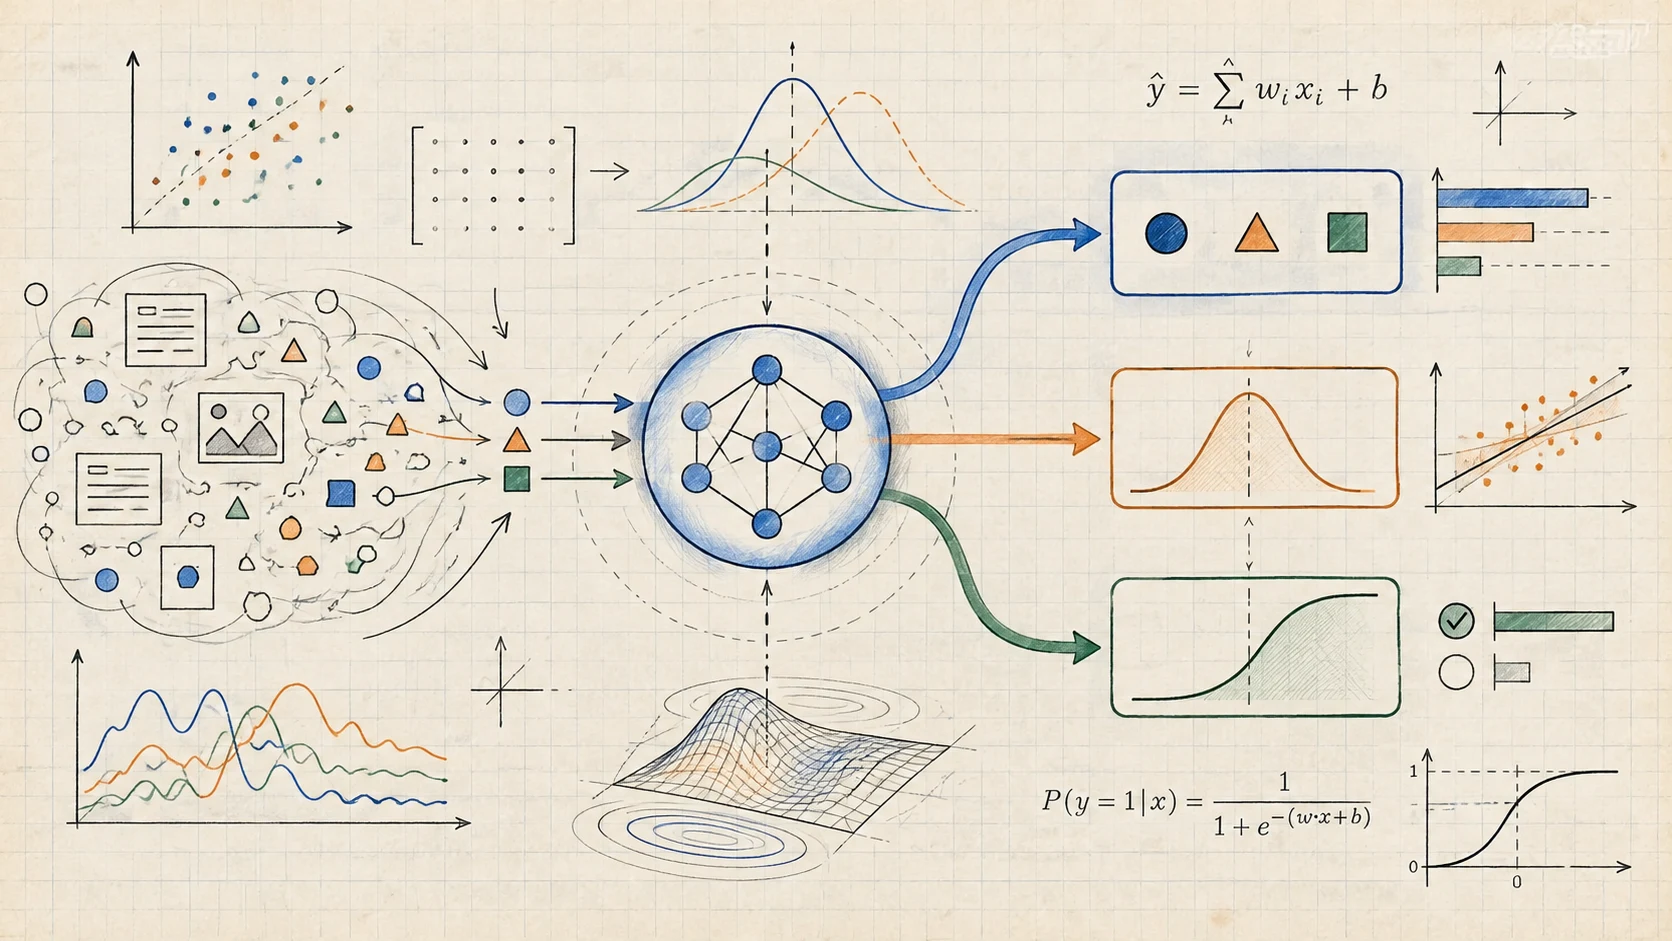
Si has buscado jev ai typesafe ai, probablemente intentas conectar tres ideas: Jev AI, TypeSafe AI y la necesidad de que el software pueda consumir resultados de IA de forma segura. La diferencia clave es que una decisión tipada no es simplemente una respuesta de chat envuelta en JSON. Es un juicio acotado, con un espacio de respuestas, una estructura verificable y un lugar claro dentro del flujo de control de tu aplicación.
Jev se presenta como una herramienta de decisiones para equipos de software. Envías un estado y una o varias preguntas tipadas y recibes respuestas estructuradas, como una opción elegida, una puntuación o una probabilidad de sí. La página principal de Jev AI describe el producto alrededor de la clasificación, el enrutamiento, la puntuación y los controles de seguridad, no de la generación de texto abierto. El sitio también aclara que Jev AI opera de forma independiente y que no está afiliado a TypeSafe, ni es operado o respaldado por TypeSafe. Esa distinción importa: usa “TypeSafe AI” como término de búsqueda y del ecosistema, pero no supongas que cada proyecto de tipos de TypeScript es el producto de Jev.
Esta guía explica Jev AI TypeSafe AI como un patrón de producción. Verás cómo diseñar el contrato de decisión, elegir entre preguntas Choice, Score y Noul, validar una respuesta remota en tiempo de ejecución, combinar Jev con un LLM generativo y crear alternativas seguras cuando la señal sea incierta o no esté disponible.
Índice
- Qué significa Jev AI TypeSafe AI
- Por qué las decisiones tipadas son distintas del JSON generado
- El contrato de decisión: estado, preguntas y política
- Los tres tipos de pregunta de Jev
- Los tipos de TypeScript no son validación en tiempo de ejecución
- Una arquitectura de producción para Jev AI
- Casos de uso de alto valor
- Cómo usar probabilidad y confianza
- Seguridad, privacidad y límites operativos
- Plan de lanzamiento y lista de comprobación
- Cuándo Jev no es la herramienta adecuada
- Preguntas frecuentes
Qué significa Jev AI TypeSafe AI
La frase suele indicar que buscas una interfaz de IA tipada, no un chatbot general. En una integración tradicional con un LLM, la aplicación envía un prompt y recibe texto. Puede pedir JSON, analizarlo y confiar en que el modelo respetó el esquema. Esto puede bastar para una tarea de bajo riesgo, pero mezcla varias responsabilidades: decidir cuál es la pregunta, describir el espacio de respuestas, extraer el resultado y decidir si ese resultado puede activar una acción.
Jev separa esas responsabilidades. Tu código proporciona el estado y define las preguntas. Jev evalúa el estado frente a esas preguntas y devuelve una respuesta para cada identificador. Después, tu aplicación aplica reglas deterministas, permisos, umbrales y políticas de revisión humana.
En este contexto, “tipado” significa tres cosas:
- La pregunta tiene una forma declarada. Es una decisión Choice, Score o Noul, no una petición abierta de prosa.
- La respuesta tiene una forma correspondiente. Choice incluye la opción elegida, probabilidades y confianza. Score incluye una puntuación ponderada por probabilidad, una leyenda, probabilidades y confianza. Noul incluye una probabilidad de sí.
- El resultado tiene un papel en la aplicación. Puede enrutar una cola, elegir un modelo, pedir confirmación o enviar un caso a revisión.
Tipado no significa infalible. Significa que el límite entre el modelo y tu código es lo bastante explícito como para validarlo, evaluarlo y monitorizarlo.
Por qué las decisiones tipadas son distintas del JSON generado
El JSON generado y las decisiones tipadas pueden parecerse en un registro, pero sus contratos de ingeniería son diferentes. En una tarea de enrutamiento de tickets, un modelo generativo podría devolver:
{
  "team": "technical",
  "reason": "The customer mentions a failed integration"
}
El objeto resulta útil, pero no indica si technical es un equipo permitido, qué tan cerca está la alternativa billing o si el caso es ambiguo. Tienes que añadir por tu cuenta el esquema, el parser y la capa de política.
Una decisión tipada empieza por el espacio de respuestas permitidas. Una pregunta Choice puede definir billing, technical, sales y needs_review, con criterios precisos para cada opción. El resultado puede conservar la distribución entre alternativas. La aplicación puede enrutar automáticamente solo cuando la opción está en su lista permitida y la confianza supera el umbral adecuado para el riesgo.
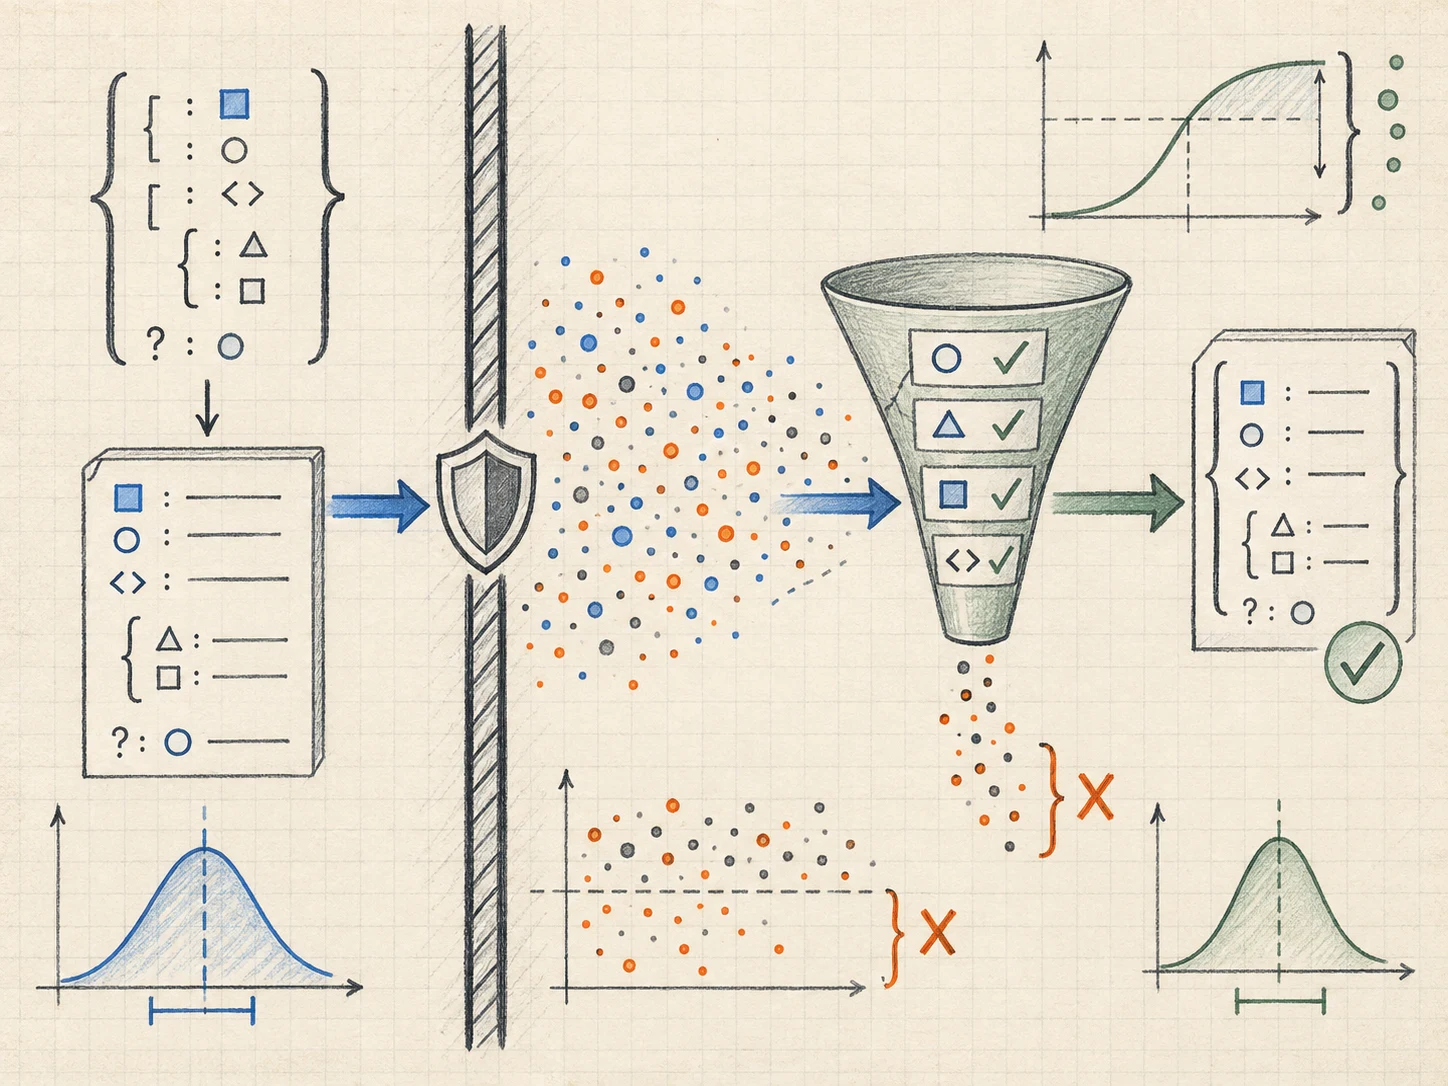
También hay una ventaja de arquitectura: varias preguntas pueden evaluarse en paralelo sobre el mismo estado. En vez de hacer una llamada para la intención, otra para la urgencia y otra para saber si hace falta una persona, puedes describir las tres decisiones independientes en una sola solicitud. Esto reduce orquestación innecesaria y mantiene visible la superficie de decisión.
El principio es sencillo: usa el modelo para un juicio semántico acotado y deja la acción final en el código normal de la aplicación.
El contrato de decisión: estado, preguntas y política
Antes de escribir una solicitud a la API, define un contrato pequeño. Debe responder cuatro preguntas:
- ¿Qué estado necesita el modelo?
- ¿Qué pregunta exacta hay que responder?
- ¿Cuáles son los resultados válidos?
- ¿Qué hace la aplicación si el resultado es incierto, inválido o no está disponible?
1. Prepara solo el estado relevante
La documentación pública de Jev describe como límite de entrada el texto, los objetos JSON y los arrays de texto. Un mensaje sencillo puede ser un string. Un flujo que necesita un ticket, el nivel de cuenta, el área de producto y un extracto de política encaja mejor en un objeto JSON. No envíes todo el registro de la base de datos solo porque está disponible.
Un estado más pequeño es más fácil de revisar y reduce el riesgo de enviar datos personales o confidenciales que no son necesarios. También hace que la evaluación sea más estable: puedes entender mejor qué campos causaron un cambio en la decisión.
2. Una decisión por cada identificador
Usa claves estables como department, urgency o needs_human. Evita preguntas compuestas como “¿Qué equipo debe atender esto, qué urgencia tiene y debemos devolver el dinero?”. Son tres decisiones diferentes, con formas de respuesta y responsables distintos.
El identificador forma parte del contrato de tu aplicación. Una etiqueta mostrada en un panel puede cambiar; una clave usada por el código solo debería cambiar mediante una migración versionada.
3. Describe el espacio de respuestas
Los criterios no son decoración. Son la rúbrica que convierte una clasificación vaga en una decisión interpretable. Explica qué pertenece a cada opción, define los extremos de una puntuación y añade una salida de reserva para los casos que no encajen en las categorías principales.
4. Mantén la política fuera del modelo
El modelo no debe decidir si una persona tiene permiso para borrar una cuenta, si un pago está autorizado o si se ha superado un límite de frecuencia. Son responsabilidades deterministas de la aplicación. Jev puede proporcionar una señal de intención o riesgo antes de ese control, pero tu servicio debe seguir imponiendo autenticación, autorización y reglas duras.
Los tres tipos de pregunta de Jev
La documentación oficial de Jev describe tres tipos principales de pregunta. Elige el tipo que corresponda a la forma de tu decisión.

Choice: elegir entre alternativas conocidas
Usa Choice cuando la salida sea una opción de un conjunto definido: equipo de soporte, segmento de un lead, tipo de documento, selección de modelo o estado editorial.
const questions = {
  department: {
    type: "choice",
    instructions: "Which team should handle this request?",
    criteria: {
      billing: "Payments, invoices, refunds, or payouts",
      technical: "Bugs, outages, or integration failures",
      sales: "Pricing, upgrades, or new accounts",
      needs_review: "The request does not clearly fit another option"
    }
  }
} as const;
La opción needs_review es importante. Sin ella, el modelo debe elegir la categoría más cercana incluso cuando ninguna encaje bien. Un espacio de respuestas completo suele ser más útil que un prompt mucho más largo.
Score: puntuar una propiedad ordenada
Usa Score cuando el concepto tenga una escala de menor a mayor, como urgencia, gravedad, relevancia o frustración. Los criterios son niveles ordenados. La puntuación devuelta es ponderada por probabilidad, así que puede quedar entre dos niveles con nombre.
Define cada nivel mediante evidencias observables y la acción que debería influir. Una puntuación de 2,7 puede recomendar una escalada, pero no puede saltarse la política de incidentes ni autorizar una acción sensible.
Noul: juzgar una proposición de sí o no
Usa Noul para una proposición concreta: “¿Este mensaje solicita explícitamente un reembolso?” o “¿Esta llamada a una herramienta contiene una acción irreversible?”. El valor noul es la probabilidad de que la respuesta sea sí; no es un segundo campo de confianza.
Si el flujo necesita una categoría, una puntuación de gravedad y una comprobación de sí/no, envía tres preguntas con nombres claros sobre el mismo estado. La aplicación puede combinarlas con lógica ordinaria y sus propias políticas.
Los tipos de TypeScript no son validación en tiempo de ejecución
Aquí fallan muchas implementaciones de “TypeSafe AI”. TypeScript comprueba el código antes de ejecutarlo, pero no inspecciona los bytes que devuelve un servidor remoto. Esta línea no es validación:
const payload = (await response.json()) as JevResponse;
La aserción cambia lo que cree el compilador, pero no demuestra que payload.answers.department.choice exista, sea un string o esté en tu propia lista permitida.
Empieza en el límite de red con unknown y valida los campos que consume tu política:
type Decision = {
  team: "billing" | "technical" | "sales" | "needs_review";
  confidence: number;
  probabilities: Record<string, number>;
};

function asRecord(value: unknown): Record<string, unknown> | null {
  return typeof value === "object" && value !== null && !Array.isArray(value)
    ? (value as Record<string, unknown>)
    : null;
}

function parseDecision(value: unknown): Decision {
  const root = asRecord(value);
  const answers = asRecord(root?.answers);
  const answer = asRecord(answers?.department);
  const team = answer?.choice;
  const confidence = answer?.confidence;
  const probabilities = asRecord(answer?.probabilities);
  const allowed = ["billing", "technical", "sales", "needs_review"];

  if (
    typeof team !== "string" ||
    !allowed.includes(team) ||
    typeof confidence !== "number" ||
    !Number.isFinite(confidence) ||
    confidence < 0 ||
    confidence > 1 ||
    !probabilities
  ) {
    throw new Error("Unexpected Jev response shape");
  }

  const values = Object.values(probabilities);
  if (!values.every((item) => typeof item === "number" && item >= 0 && item <= 1)) {
    throw new Error("Invalid probability map");
  }

  return {
    team: team as Decision["team"],
    confidence,
    probabilities: probabilities as Record<string, number>
  };
}
En producción, aplica el mismo principio a todos los campos que puedan influir en una acción. Comprueba el tipo de respuesta, las claves obligatorias, los rangos numéricos, la suma de probabilidades y los identificadores permitidos. Si falla la validación, trata el resultado como una decisión no disponible, no como una respuesta negativa con poca confianza.
Una arquitectura de producción para Jev AI
Jev funciona mejor como una capa de decisión estrecha dentro de un sistema mayor:
- Un LLM generativo o un servicio de aplicación reúne el contexto y formula una pregunta acotada.
- Jev evalúa el estado contra preguntas tipadas, idealmente en paralelo.
- Una capa de política determinista valida la respuesta, los permisos y los umbrales.
- La aplicación ejecuta una acción, pide confirmación o envía el caso a revisión.
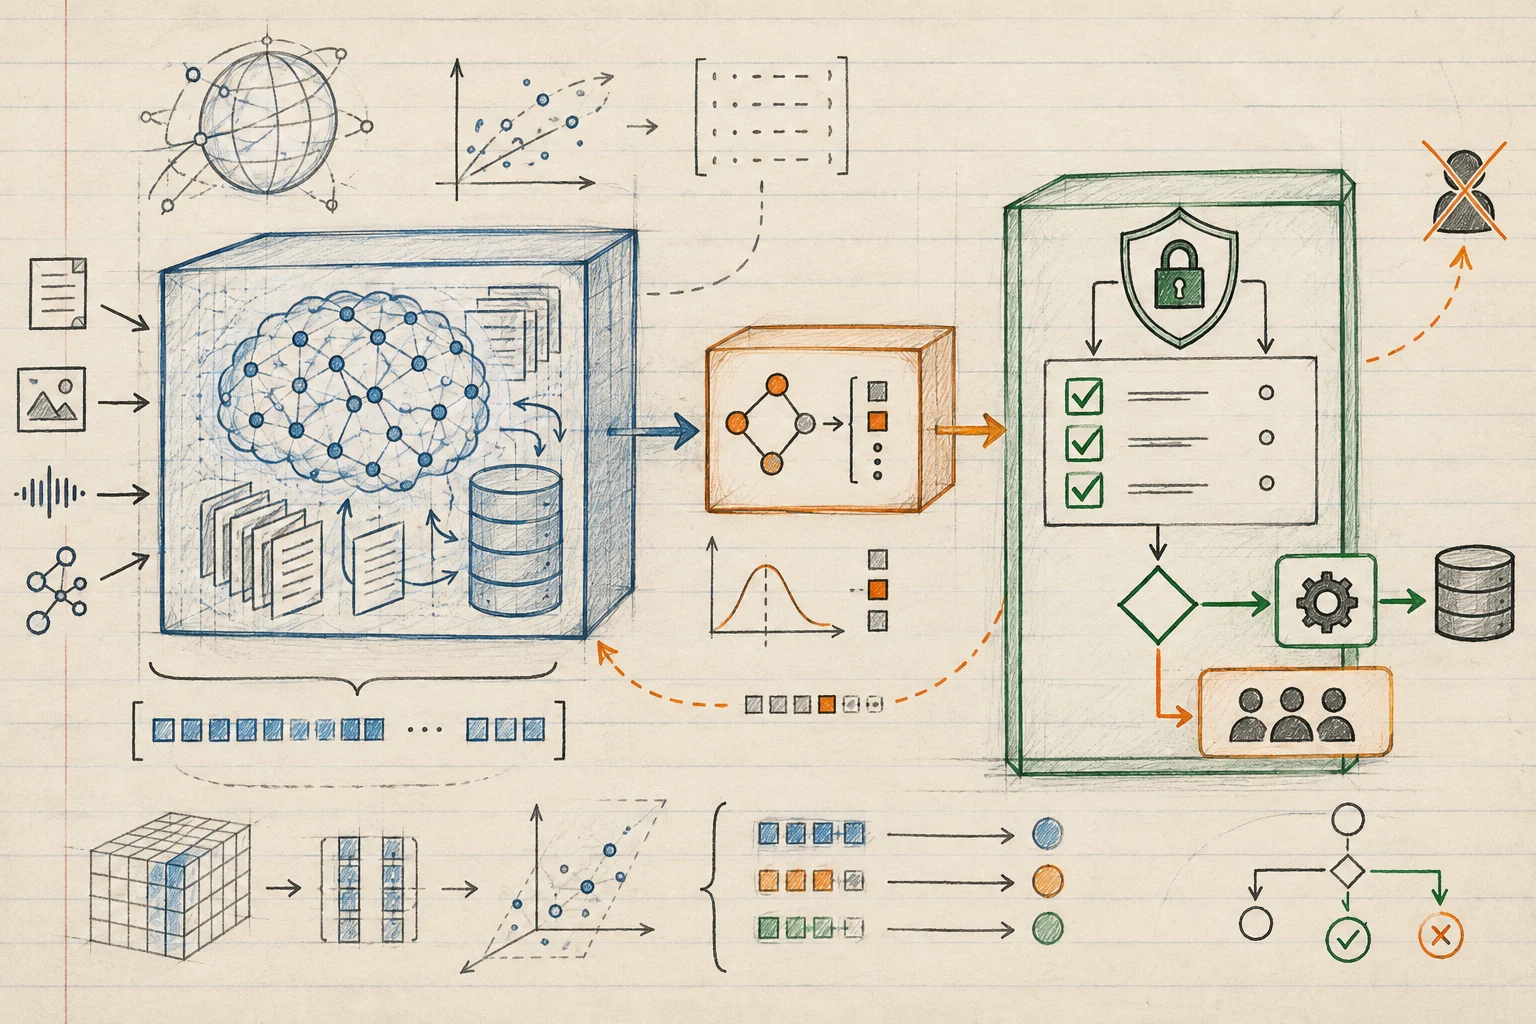
Esta separación evita que un modelo de lenguaje general interprete una petición y ejecute directamente una acción sensible. El LLM puede conservar el contexto; Jev puede juzgar si una llamada a una herramienta es arriesgada; pero la aplicación sigue controlando la clave API, la autorización, la idempotencia, los límites, la confirmación y la ejecución.
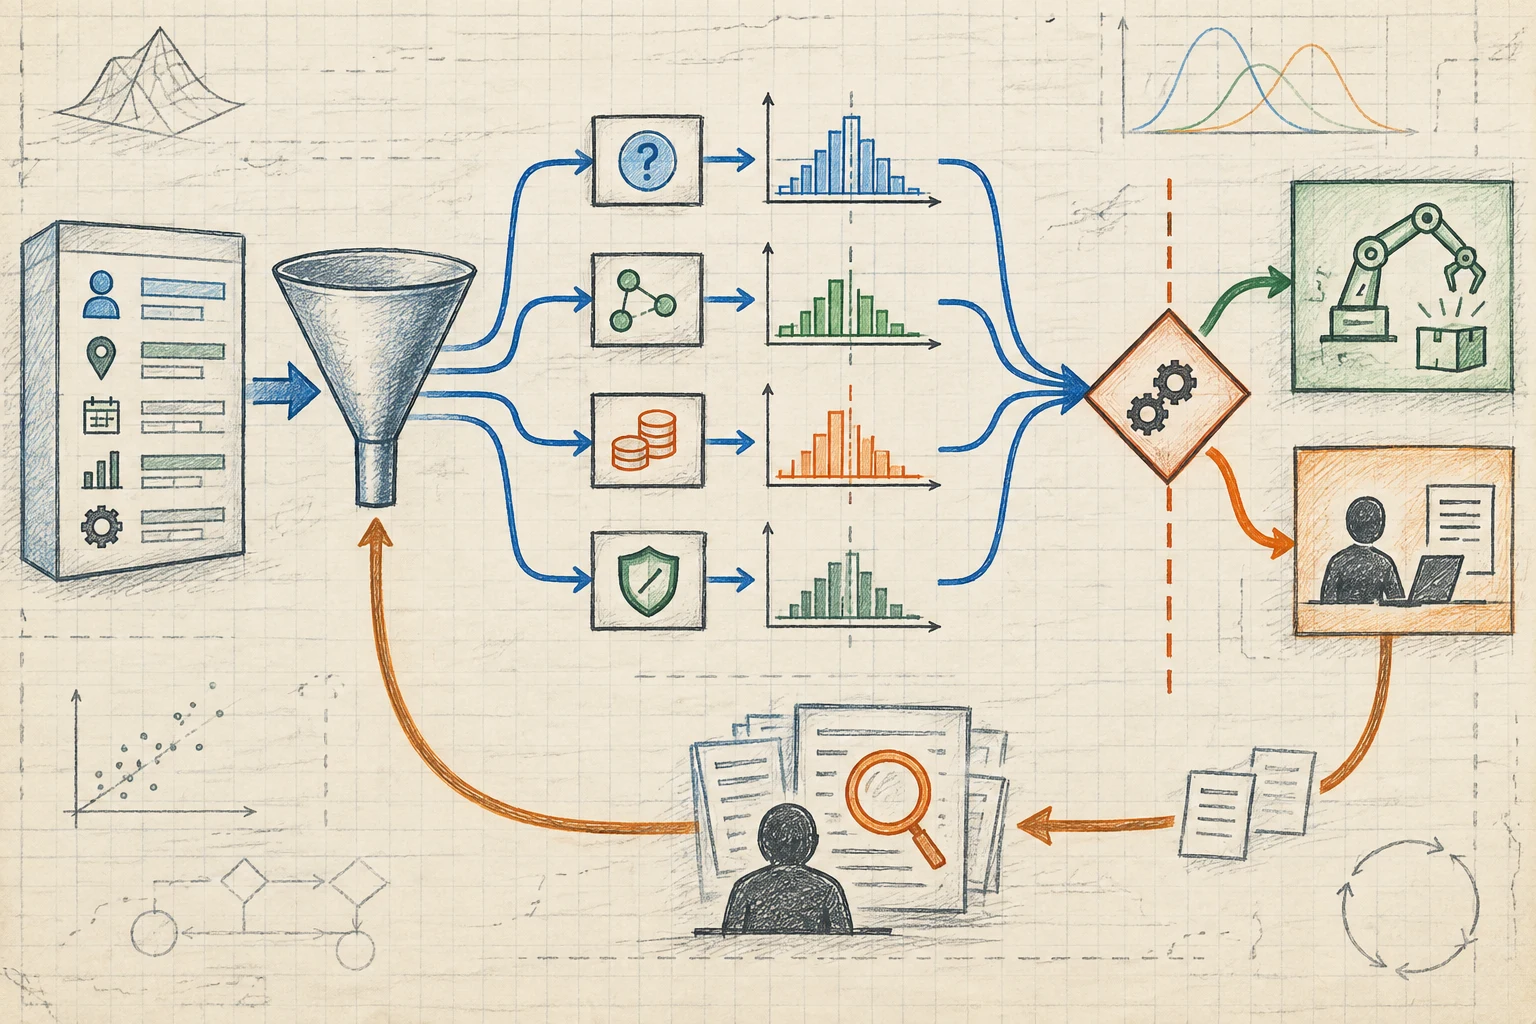
La frontera REST es sencilla. La documentación muestra POST https://thejevai.com/v1/systemone con una clave Bearer, un model como jev-latest, un state y un mapa questions. Haz la llamada en el servidor. No incluyas JEV_API_KEY en código del navegador ni en transcripciones públicas de agentes.
Modela internamente el resultado con más estados que un simple booleano:
type WorkflowResult<T> =
  | { kind: "decision"; value: T; confidence?: number }
  | { kind: "review"; reason: string }
  | { kind: "unavailable"; reason: string };
Un ticket clasificado como billing no es lo mismo que un timeout. Una llamada a una herramienta que no pudo evaluarse tampoco es una llamada segura. Los estados explícitos hacen visibles los fallbacks en las métricas y evitan que un fallo de transporte se convierta en una aprobación accidental.
Casos de uso de alto valor
Enrutamiento de soporte y operaciones
Clasifica el equipo, puntúa la urgencia y decide si hace falta una persona en una sola solicitud. Valida la ruta contra una lista permitida del servidor y mantén las reglas de escalada fuera del modelo.
Enrutamiento de modelos
Usa una decisión pequeña antes de llamar a un modelo generativo caro. Una pregunta Choice puede seleccionar fast, balanced o reasoning, y una pregunta Score puede estimar la dificultad. La aplicación elige el proveedor, aplica el presupuesto y registra el motivo de la ruta.
Seguridad de llamadas a herramientas
Antes de que un agente ejecute una herramienta, usa una pregunta Noul para saber si la petición contiene una acción irreversible. Si la respuesta es sí, exige confirmación explícita o revisión humana. Aun así, la autenticación, la autorización, la propiedad del recurso y las restricciones de entrada deben ser deterministas.
Flujos de contenido y leads
Jev puede clasificar contenido en colas editoriales conocidas, puntuar la urgencia de un lead o marcar mensajes para revisión. Versiona los criterios y mide el rendimiento por segmento. Un promedio global puede ocultar errores en un grupo de clientes de alto valor o en una categoría de seguridad poco frecuente.
Compresión de contexto y selección de memoria
Los agentes de larga duración necesitan decidir qué hechos conservar después de comprimir el contexto. Choice o Score pueden ayudar a ordenar resultados de herramientas. Guarda la fuente y la razón de conservación; no permitas que una señal probabilística elimine la única copia de un dato crítico.
Cómo usar probabilidad y confianza
La probabilidad y la confianza son señales, no garantías de corrección. El Playground de Jev permite probar estados representativos y observar la forma de respuesta antes de conectar una clave API a producción.
Elige los umbrales a partir de un conjunto de evaluación etiquetado, no de un tutorial. Incluye casos normales, ambiguos, raros, lenguaje adversarial y ejemplos que deberían ir a needs_review. Mide el coste de cada error: una falta de escalada puede agravar una incidencia; una escalada falsa consume tiempo de revisión; una ruta de modelo equivocada aumenta coste o latencia; una acción insegura puede ser irreversible.
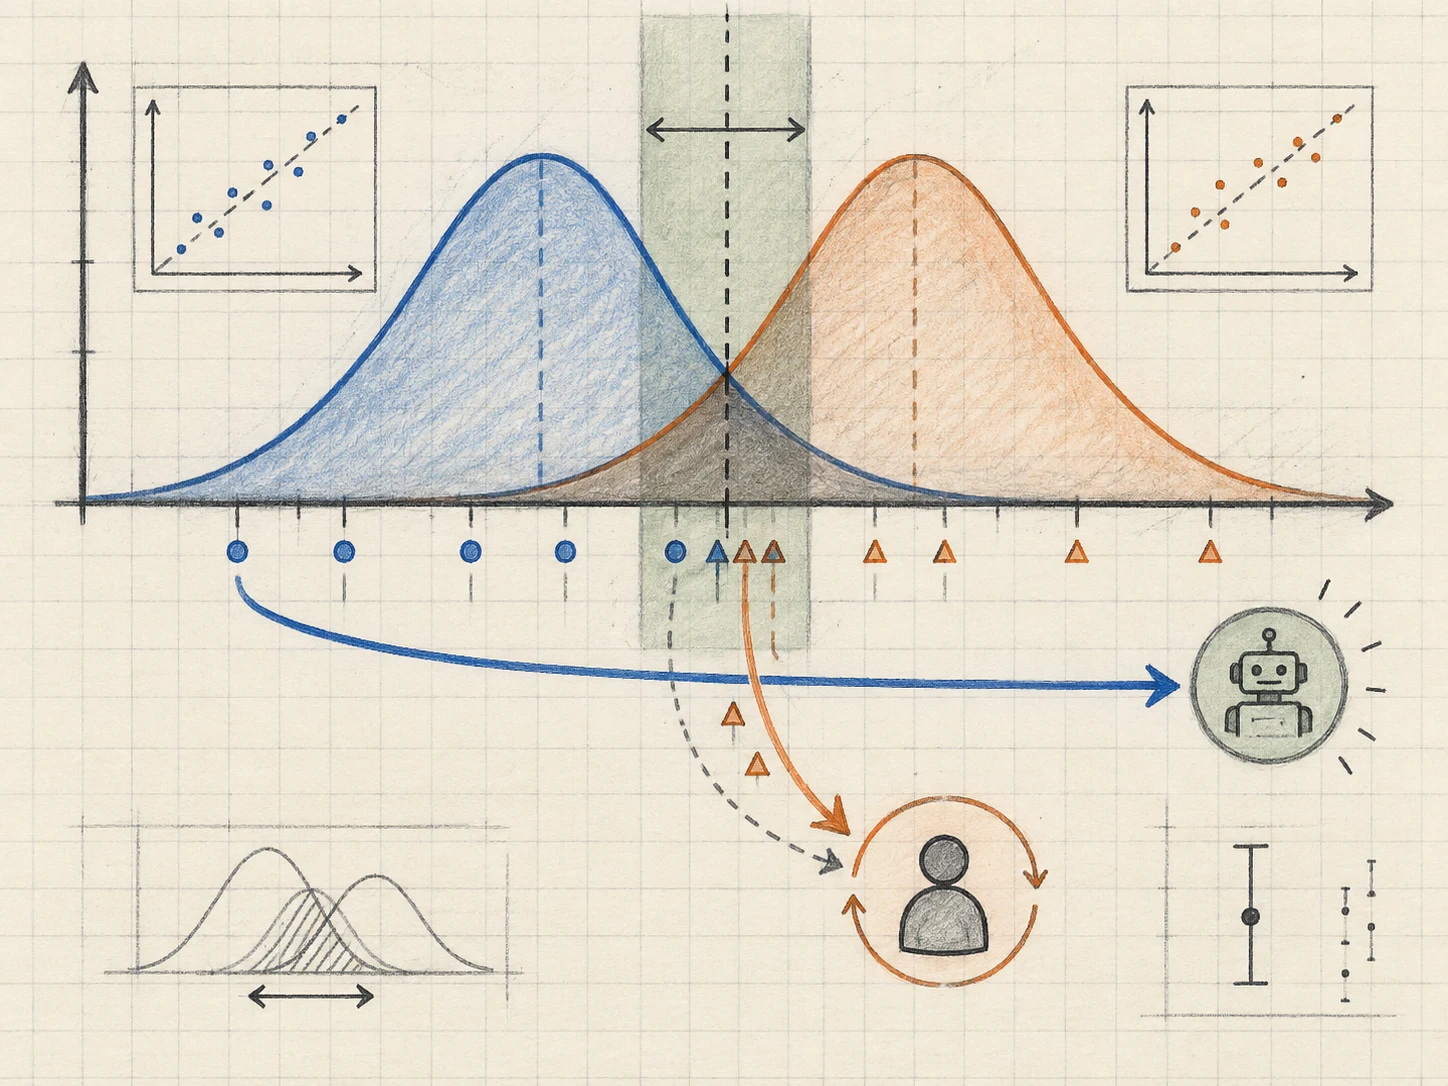
Usa umbrales distintos para acciones distintas. Una etiqueta de contenido de bajo riesgo puede automatizarse antes. Un pago, una restricción de cuenta, una eliminación o un despliegue en producción necesita evidencia más fuerte y controles deterministas, incluso con una confianza alta.
Monitoriza la opción elegida, la diferencia entre probabilidades, el segmento de entrada, las correcciones humanas, la tasa de escalada, el resultado posterior, la latencia y la tasa de indisponibilidad, no solo la confianza. Si cambia la distribución de entradas, el umbral anterior debe reevaluarse.
Seguridad, privacidad y límites operativos
Guarda las claves API en variables de entorno del servidor o en un gestor de secretos. No las escribas en logs, mensajes de error, bundles del navegador ni eventos de analítica. Envía solo el estado necesario para la pregunta. Si contiene datos personales o confidenciales, define retención, acceso, cifrado y eliminación antes de lanzar.
Usa timeouts acotados. Reintenta solo errores que puedan ser temporales, respeta las indicaciones del servidor y limita los intentos. Un fallo de validación del esquema no es un fallo de red. Cuando se agota el presupuesto de reintentos, vuelve a una ruta de reglas segura o a una cola de revisión.
Versiona las preguntas y los criterios junto al código que interpreta las respuestas. Si cambias el significado de critical, renombras una categoría o añades una ruta de revisión, actualiza el conjunto de evaluación y compara ambas versiones.
En el momento de escribir este artículo, la documentación pública describe texto, objetos JSON y arrays de texto como entradas, e indica que las entradas directas de imagen, audio y vídeo todavía no están disponibles. Si trabajas con datos multimodales, conviértelos primero en texto o estructura justificada y evalúa ese preprocesamiento por separado.
Plan de lanzamiento y lista de comprobación
Empieza con una decisión frecuente, acotada, reversible y medible:
- Explorar: prueba ejemplos reales anonimizados en el Playground y aclara los criterios.
- Evaluar offline: crea un conjunto etiquetado con casos normales, ambiguos, raros y de alto coste.
- Ejecutar en sombra: deja el flujo actual como autoridad y compara las sugerencias de Jev.
- Asistir: muestra las sugerencias a un operador y recoge correcciones.
- Automatizar selectivamente: activa solo ramas de bajo riesgo que cumplan el umbral y tengan un interruptor de pausa.
- Revisar continuamente: monitoriza deriva, indisponibilidad, correcciones y coste.
Antes de lanzar, confirma que:
- el estado no contiene secretos ni datos personales irrelevantes;
- cada pregunta tiene un identificador estable y un único propósito;
- el espacio de respuestas incluye un fallback seguro;
- el JSON remoto se analiza desde
unknowny se valida en tiempo de ejecución; - la capa de política controla permisos y acciones irreversibles;
- los umbrales están vinculados al coste medido de los errores;
- los fallos de red y de validación tienen resultados distintos;
- las claves API permanecen en el servidor;
- las versiones de preguntas y criterios son observables.
Para consultar acceso, límites de uso y planes actuales, revisa la página de precios de Jev AI directamente en lugar de copiar cifras de un artículo antiguo.
Cuándo Jev no es la herramienta adecuada
Un LLM generativo encaja mejor cuando la salida principal es una explicación larga, un borrador, una traducción o una conversación abierta. Una regla determinista es mejor cuando la condición ya se conoce por completo y debe cumplirse con exactitud. Un modelo local o un clasificador tradicional puede ser preferible cuando la residencia de datos, el funcionamiento offline o el control total de la infraestructura son prioritarios.
Jev es más valioso en el punto intermedio: la entrada es suficientemente compleja como para requerir juicio semántico, pero la salida está suficientemente limitada como para entrar en una decisión de negocio. Así el modelo ayuda sin convertirse en dueño de los permisos y efectos secundarios del producto.
Preguntas frecuentes
¿Jev AI y TypeSafe AI son lo mismo?
Son términos relacionados, pero no intercambiables. Jev AI es el producto de decisiones descrito en el sitio oficial. El sitio indica expresamente que funciona de forma independiente y que no está afiliado a TypeSafe. Para branding o integración, comprueba las páginas oficiales actuales.
¿“Tipado” garantiza una respuesta correcta?
No. Una respuesta tipada facilita la validación y la evaluación, pero no garantiza exactitud semántica, calibración de probabilidad ni corrección de negocio. Siguen siendo necesarios un conjunto de evaluación, umbrales, comprobaciones deterministas y revisión humana cuando el riesgo lo exige.
¿Puede Jev sustituir a un modelo de lenguaje grande?
No para todas las tareas. Jev está pensado para decisiones acotadas como clasificación, enrutamiento, puntuación y controles de seguridad. Usa un modelo generativo para texto abierto y añade una capa de decisión tipada cuando la aplicación necesita juzgar algo antes de actuar.
¿Debo enviar el registro completo del usuario como estado?
Normalmente no. Envía el texto u objeto estructurado mínimo que contenga la evidencia necesaria. Esto mejora la privacidad, la revisión y la reproducibilidad.
¿Qué ocurre si Jev no está disponible?
Representa la indisponibilidad explícitamente. Según el flujo, puedes pausar la acción, mantener la ruta basada en reglas o enviar el caso a una persona. Nunca conviertas silenciosamente un timeout en “no” ni elijas la primera opción de una lista.
¿Cuál es un buen primer proyecto con Jev AI TypeSafe AI?
Elige una decisión frecuente, acotada, reversible y medible: enrutamiento de soporte, prioridad de leads, selección de modelo o revisión de herramientas. Empieza en modo sombra, valida la respuesta en tiempo de ejecución y automatiza solo cuando el coste de error sea aceptable.
Conclusión
El valor práctico de jev ai typesafe ai no consiste en cambiar el nombre de “pedir JSON a un LLM”. Consiste en establecer un límite disciplinado: enviar el estado relevante, hacer preguntas tipadas y explícitas, validar las señales estructuradas y mantener la política y la ejecución dentro del código de la aplicación.
Con este enfoque, TypeScript puede describir el contrato interno, la validación en tiempo de ejecución protege la frontera de red y la evaluación muestra si la decisión funciona en el mundo real. El resultado es un flujo más fácil de probar, monitorizar y evolucionar que un prompt opaco que solo parece un esquema.