Comparativas de modelos
Jev vs. Laya: ¿API alojada o pesos abiertos? (Guía 2026)
Compara Jev y Laya por benchmark, ajuste fino, calibración, contexto, latencia, idiomas y coste total para elegir el modelo de decisión adecuado.
Al comparar Laya y Jev, empieza por el límite operativo que necesita tu producto. Jev es una API de decisiones alojada y lista para usar; Laya ofrece pesos abiertos que puedes operar y adaptar. Los datos etiquetados, la residencia de datos, los idiomas, el contexto y la capacidad de mantener la inferencia determinan la elección.
Las cifras siguientes proceden de JevBench v1.3.0, consultado el 22 de septiembre de 2026. Describen un benchmark concreto, no garantizan el rendimiento en cualquier flujo.
Respuesta rápida
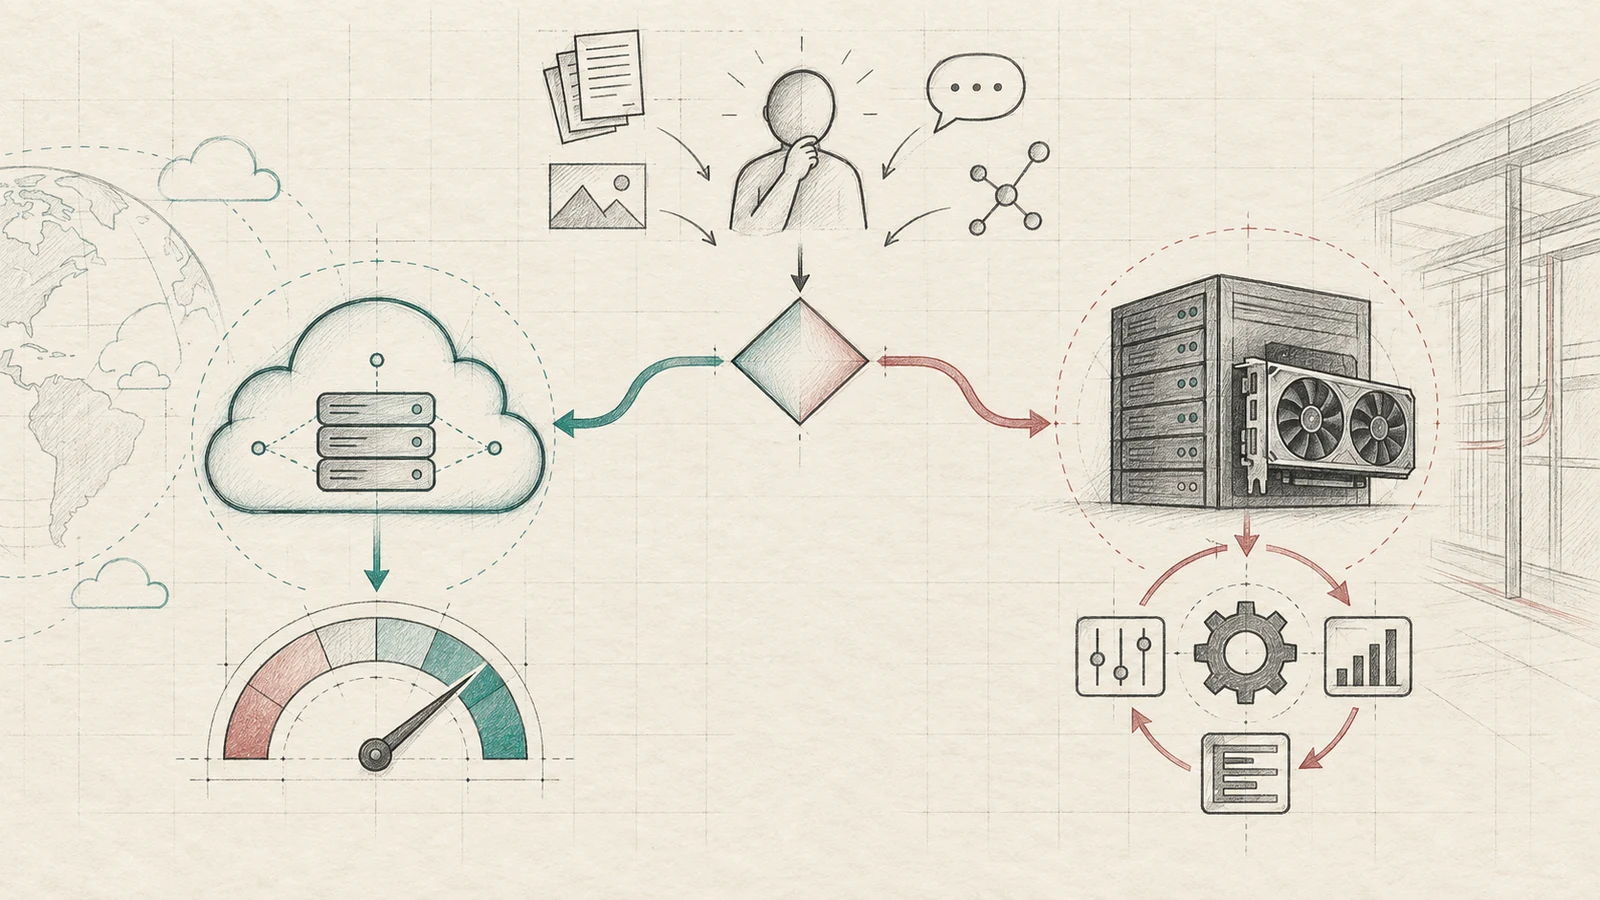
RestricciónEmpieza porMotivoSin etiquetas o equipo de ajuste finoJevAPI alojada diseñada para decisiones zero-shot.Los datos deben permanecer en tu redLayaPuedes autohospedar y adaptar los pesos abiertos.Tickets, documentos o trazas largasJevLa comparación indica 64k tokens por solicitud.Enrutamiento multilingüeCheckpoint multilingüe de LayaHay una variante multilingüe; valida cada idioma.Sin capacidad para operar GPUJevEvita aprovisionar GPU, actualizar modelos y supervisar inferencia.
Qué ofrecen los dos sistemas
Ambos responden decisiones tipadas como «¿a qué cola va?», «¿está permitido?» o «¿qué puntuación corresponde?». Son alternativas a generar texto libre y analizarlo después.
-
Jev es la API alojada System One de TypeSafe. La comparación indica uso zero-shot, hasta 64k tokens por solicitud y hasta 255 opciones de Choice. Se consume como API sin operar GPU.
-
Laya es un modelo de decisiones abierto construido sobre un codificador. La implementación Apache-2.0 puede ejecutarse localmente y ajustarse para una tarea. El checkpoint evaluado en la comparación usa 512 tokens por pregunta. El proyecto oficial de Laya publica límites distintos según el checkpoint; confirma la versión que desplegarás.
Ninguno es un chatbot general. Ambos requieren un esquema claro, etiquetas estables y una política para respuestas inciertas.
Cómo leer JevBench v1.3.0
El benchmark comparó 52 sistemas con las mismas 534 decisiones: 72 fáciles, 96 estándar, 146 de evaluación y 220 difíciles. Jev obtuvo 74,4 puntos y el puesto 1; Laya logró 54,4 y el puesto 33.
MétricaJev 1.13.0LayaPuntuación compuesta74,454,4Puntuación de inteligencia85,745,8Puntuación de calibración82,762,5Acierto en casos difíciles74,1 %34,1 %Acierto en casos estándar99,0 %72,9 %
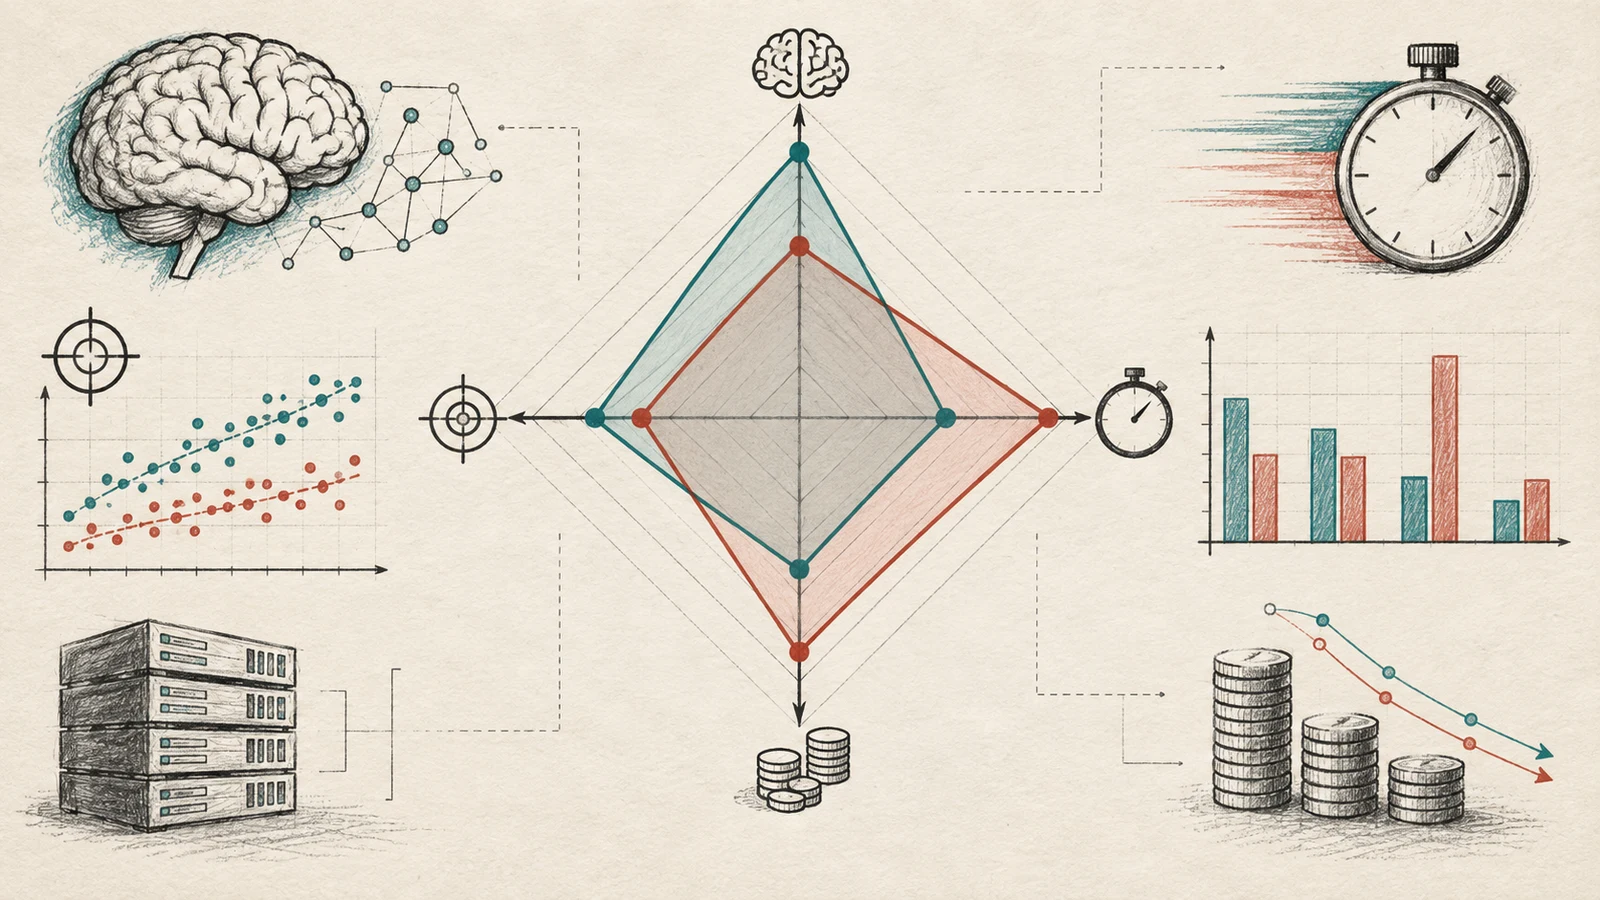
Estas cifras no son una clasificación universal. Reflejan un conjunto de decisiones y una configuración de Laya sin ajuste fino. Si ajustas Laya con etiquetas estables, evalúa ese checkpoint por separado con datos reservados.
Contexto e idiomas
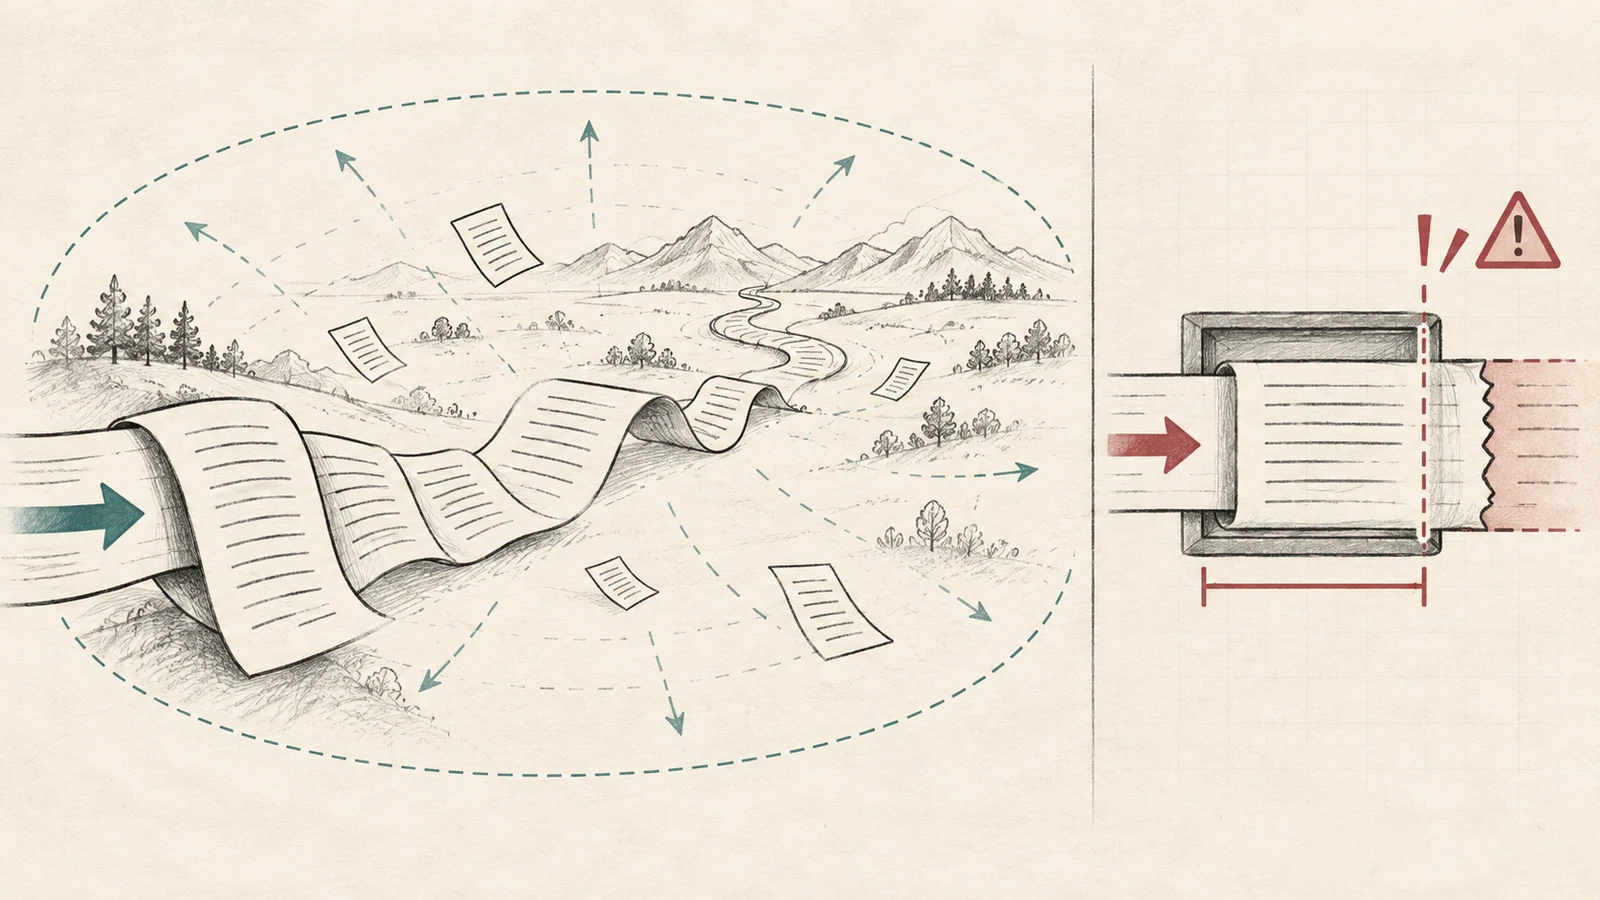
Una entrada larga puede contener justo la frase que cambia la decisión. La comparación indica 64k tokens para Jev y 512 tokens por pregunta para el checkpoint de Laya evaluado. La web oficial de Laya distingue checkpoints de inglés y multilingües, por lo que el límite depende de la versión. Mide la tokenización con el modelo y el formato exactos que vas a usar.
El checkpoint multilingüe de Laya merece una prueba cuando el inglés no basta, pero cubrir un idioma no garantiza la misma calidad en todos. Evalúa nombres, sistemas de escritura, cambios de idioma y vocabulario del dominio.
Acierto, confianza y latencia
El acierto mide si la etiqueta es correcta. La calibración comprueba si una confianza de 0,8 corresponde aproximadamente a un 80 % de acierto en casos similares. El error de calibración esperado resume la diferencia entre confianza media y acierto en grupos de confianza.
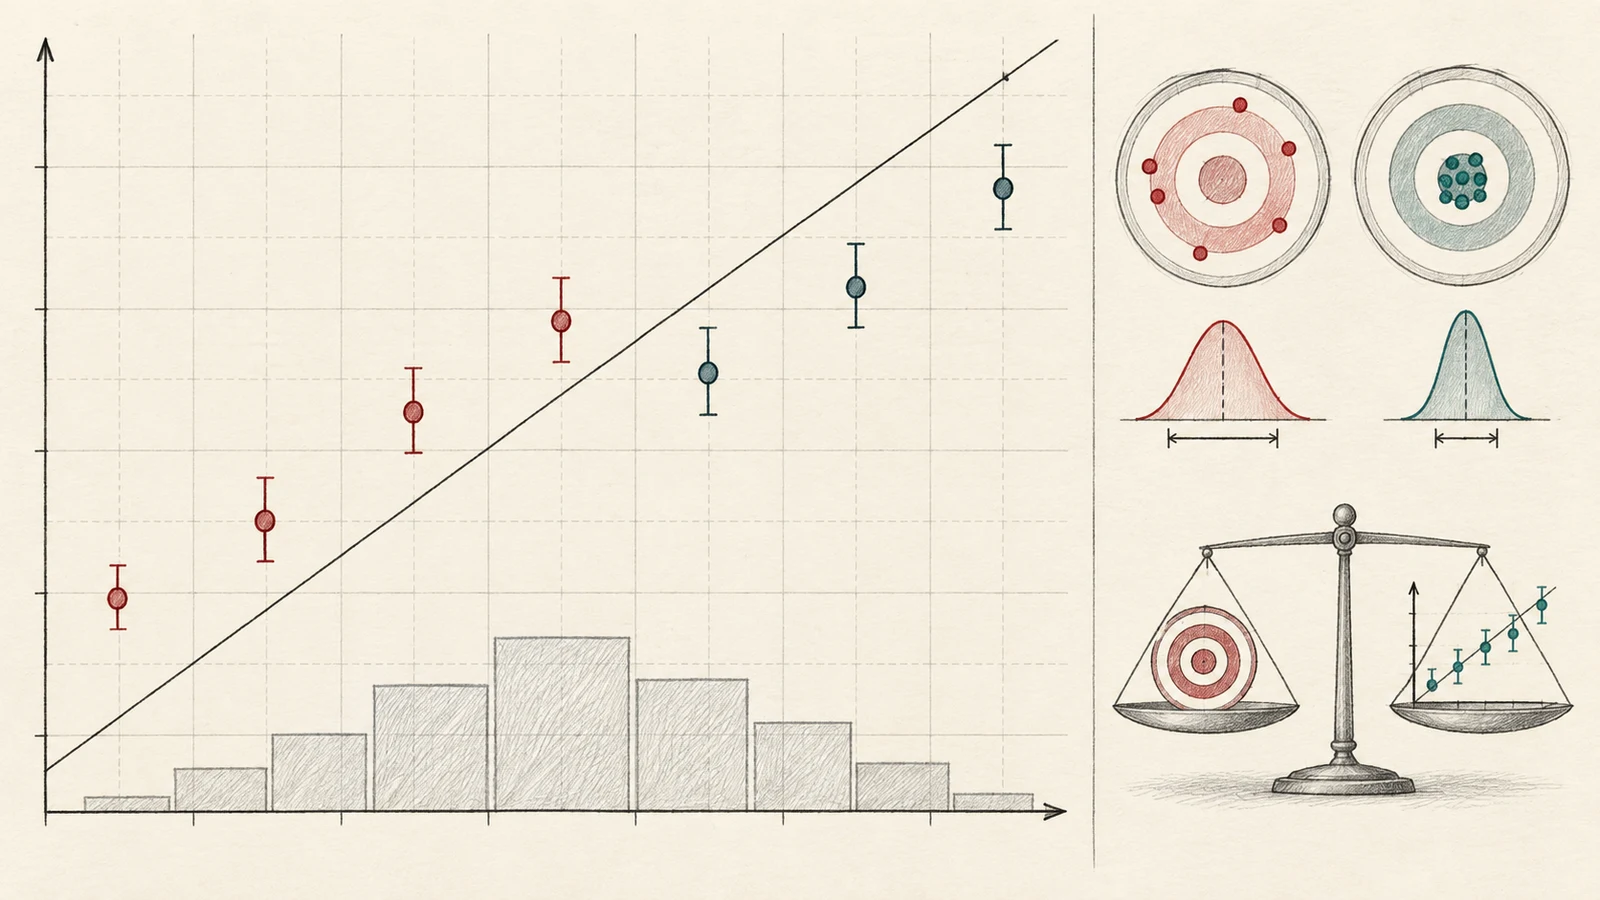
En la configuración probada, JevBench da a Jev una puntuación de calibración más alta. La documentación de Laya describe el ajuste de temperatura por tarea. Define los umbrales con datos parecidos a producción e informa acierto y cobertura: abstenerse más puede subir el acierto de los casos respondidos.
Laya comunica inferencia de decenas de milisegundos en una Tesla T4. La página comparativa también indica que la ejecución CPU de Laya en JevBench tardó 0,79 segundos en bruto y 1,72 ajustados, frente a una mediana de 0,65 segundos para la API alojada de Jev. Son hardware y rutas distintos, no una comparación directa. Mide tu red, concurrencia, arranques en frío y P95.
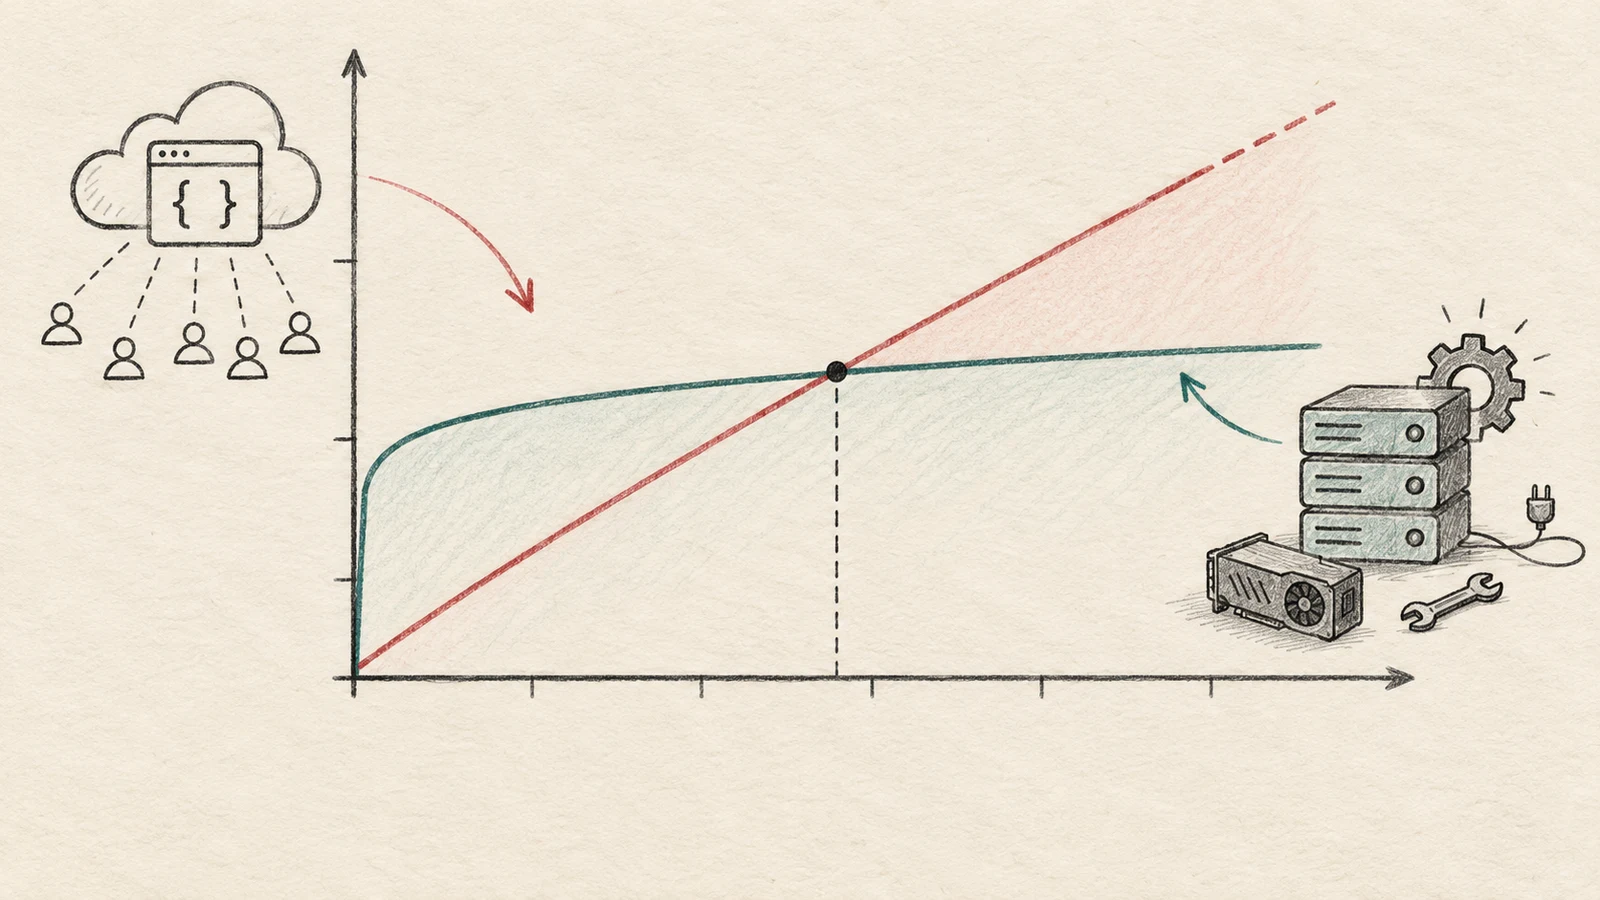
El coste debe incluir uso de API, capacidad GPU, operaciones, monitorización, ajuste fino y tiempo ocioso. Autohospedar puede ser barato con una GPU ya ocupada; la capacidad dedicada y el mantenimiento cambian el total.
Plan práctico de evaluación
-
Fija el esquema, las etiquetas, las reglas de empate y el significado de «desconocido».
-
Prepara datos reservados con casos rutinarios, ambiguos, multilingües, largos y de alto riesgo.
-
Compara F1 por clase, confusiones, calibración, cobertura por umbral y tasa de abstención.
-
Mide latencia P50/P95, rendimiento, arranque en frío, errores y truncamientos.
-
Incluye anotación, uso de GPU, hosting, monitorización, mantenimiento y API en el coste total.
-
Ejecuta ambos en modo sombra frente a resultados revisados por personas antes de permitir acciones importantes.
Empieza con Jev si necesitas decisiones zero-shot y servicio gestionado. Evalúa Laya si los pesos abiertos, la residencia de datos, el enrutamiento multilingüe o el ajuste fino son prioritarios. Guías relacionadas: Jev vs. Laya, Jev vs. OpenJev y Jev vs. djev.
Preguntas frecuentes sobre Jev vs. Laya
¿Laya puede reemplazar directamente a Jev?
No en todos los casos. Con Laya debes seleccionar y servir un checkpoint, y el ajuste fino o la calibración pueden afectar la calidad en producción. Jev es una API alojada con límites de datos y operación distintos.
¿Cuál es más rápido?
Depende del hardware y del lugar donde se atienda la solicitud. Una medición CPU no se compara directamente con una cifra de Tesla T4. Mide también red y latencia P95.
¿Cuál conviene para varios idiomas?
Laya ofrece un checkpoint multilingüe. La comparación de Jev también menciona más de 100 idiomas, con menor fiabilidad fuera del inglés. Evalúa el idioma y el dominio reales.
¿Puedo automatizar con un umbral de confianza?
Solo tras comprobar calibración y coste de error en datos reservados. Registra falsos positivos, falsos negativos, cobertura y carga de revisión humana.
Fuentes
Las cifras proceden de la comparación Jev vs. Laya y JevBench v1.3.0, consultada el 22 de septiembre de 2026. Los checkpoints se describen en el proyecto Laya y su repositorio de GitHub. Comprueba versiones, límites y precios antes de producción.