模型对比
Jev vs djev vs Laya vs OpenJev vs SemIf:五种决策模型怎么选?
从基准表现、概率校准、速度、多模态输入、自托管、开源权重和生产运维等维度,对比 Jev、djev、Laya、OpenJev 与 SemIf。
Jev vs djev vs Laya vs OpenJev vs SemIf:五种决策模型怎么选?
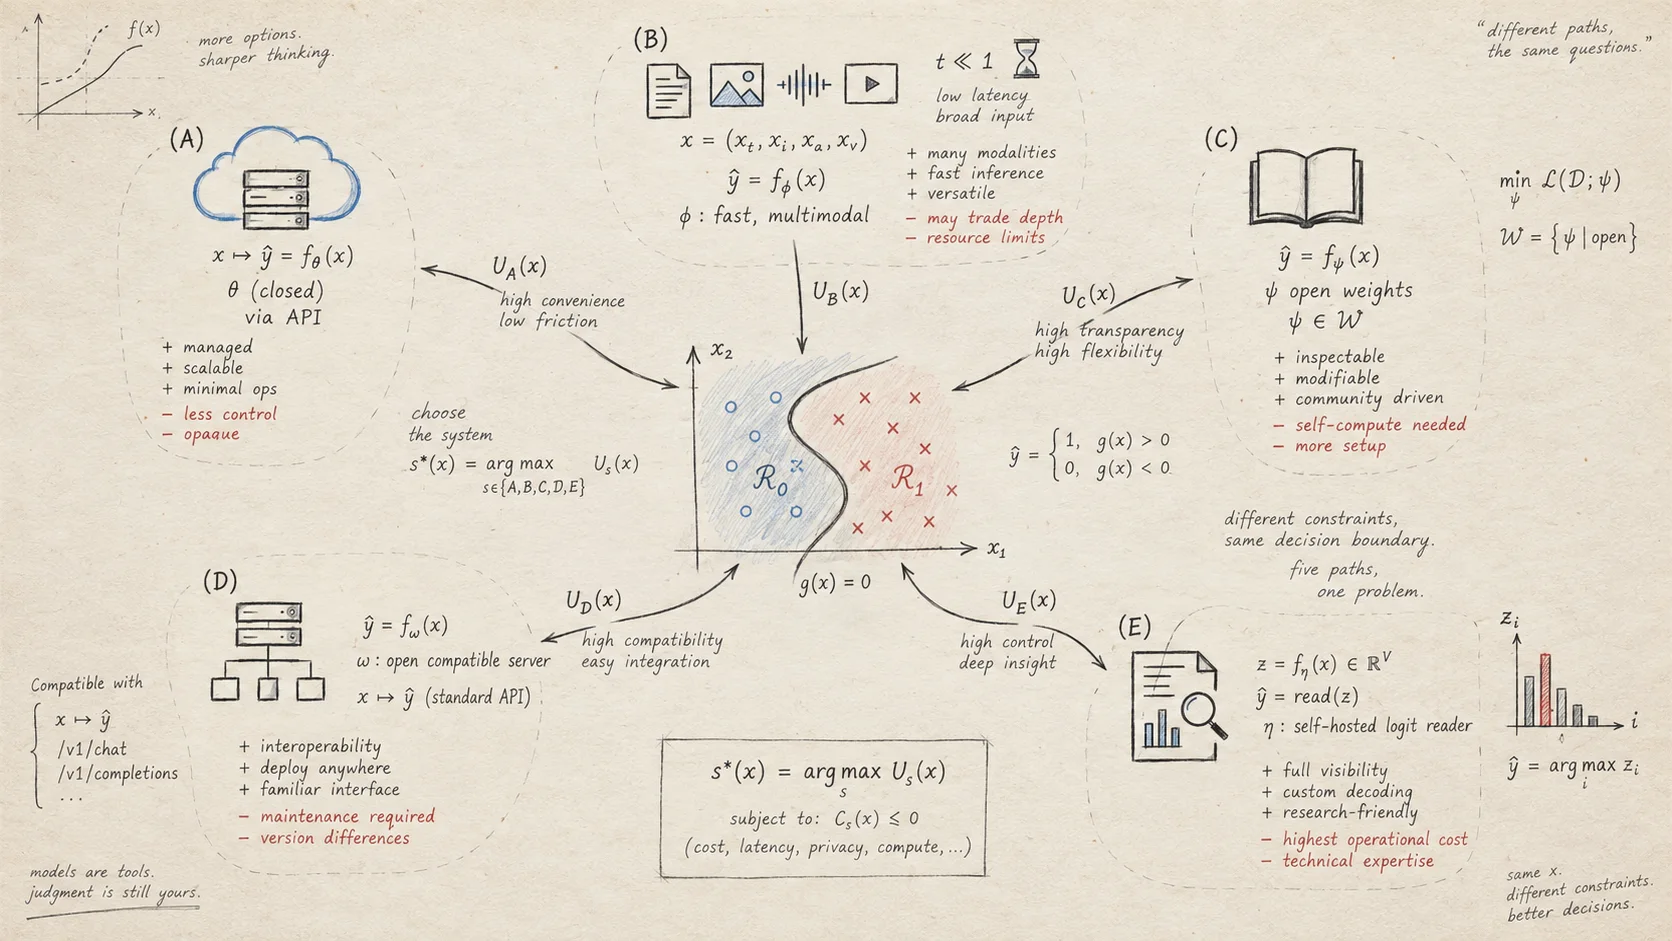
如果你正在比较 Jev vs djev vs Laya vs OpenJev vs SemIf,最有价值的问题并不是“哪个模型分数最高”,而是“哪个模型的产品形态、数据边界、延迟目标和概率校准成本适合我的系统?”
这五个系统都在尝试让软件直接获得结构化决策,但取舍并不相同。Jev 是强调类型化决策和概率校准的托管 System One 模型;djev 强调速度以及原生图片和摄像头输入;Laya 提供开源权重、自托管和微调能力;OpenJev 提供兼容 Jev 的自托管服务、图片输入和思考模式;SemIf 则从开源模型中读取 logits,在综合基准上接近 Jev,同时把运行环境交给使用者控制。
本文参考四个官方对比页面及其 2026 年 9 月更新的 JevBench v1.3.0 数据。数字适合用来确定测试方向,不应替代你对真实业务数据的验证。
目录
先看结论
当你需要托管 API、类型化答案,以及可以直接用于路由或升级处理的概率信号,同时不想运维 GPU 或先建立校准层时,优先评估 Jev。
当速度、原生图片或实时摄像头输入比生产级概率校准更重要,尤其是在托管预览足够方便时,可以评估 djev。
当你更看重开源权重、离线部署、多语言覆盖和微调能力,而不是困难决策上的零样本质量时,可以评估 Laya。
当你希望使用兼容 Jev 的请求格式,自行部署,并需要图片输入或思考模式时,可以评估 OpenJev,前提是团队能够运维运行环境。
当你希望使用开源实现,在自己控制的模型上读取决策 logits,并且拥有 GPU 和工作流校准能力时,可以评估 SemIf。
如何阅读基准数据
参考页面中的 JevBench v1.3.0 使用统一方法测试了 52 个系统和 534 个决策:72 个简单案例、96 个标准案例、146 个评审式案例和 220 个困难案例。综合分数由智能、校准、速度和成本共同构成。
公开的综合分数快照如下:
| 系统 | 排名 | 综合分数 | 主要运行方式 |
|---|---|---|---|
| Jev 1.13.0 | 第 1 名 | 74.4 | 托管生产 API |
| SemIf | 第 2 名 | 73.1 | 自托管开源模型 logits 读取器 |
| djev | 第 3 名 | 73.0 | 支持多模态输入的托管 API |
| OpenJev | 第 11 名 | 66.4 | 自托管兼容决策服务 |
| Laya | 第 33 名 | 54.4 | 自托管开源权重 |
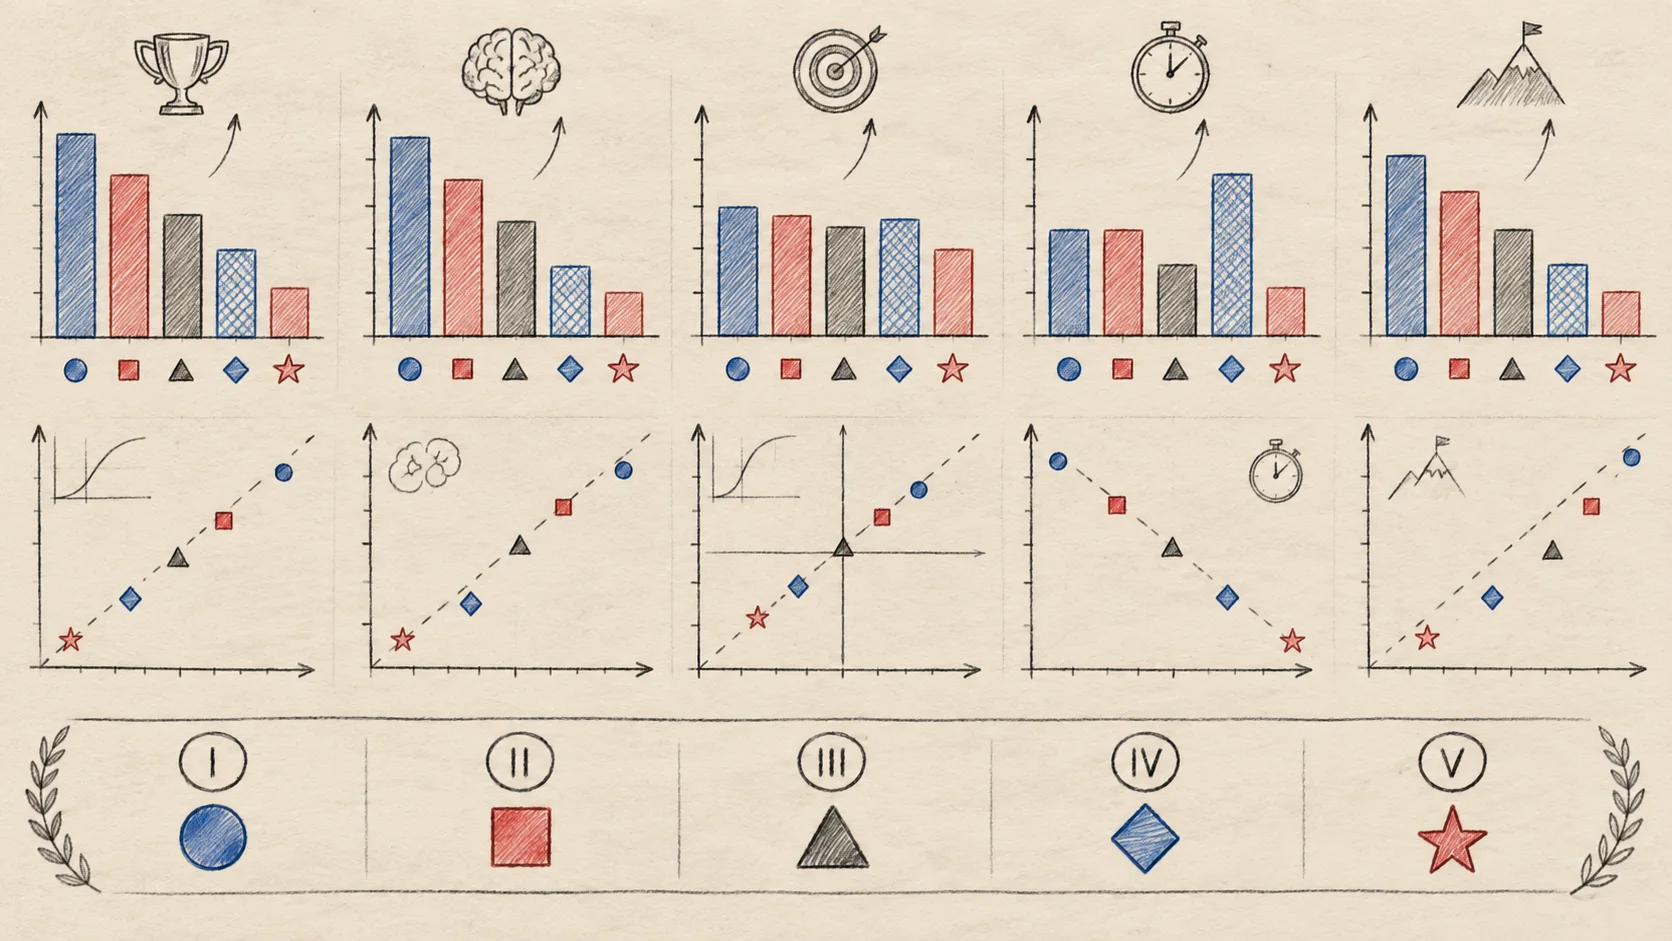
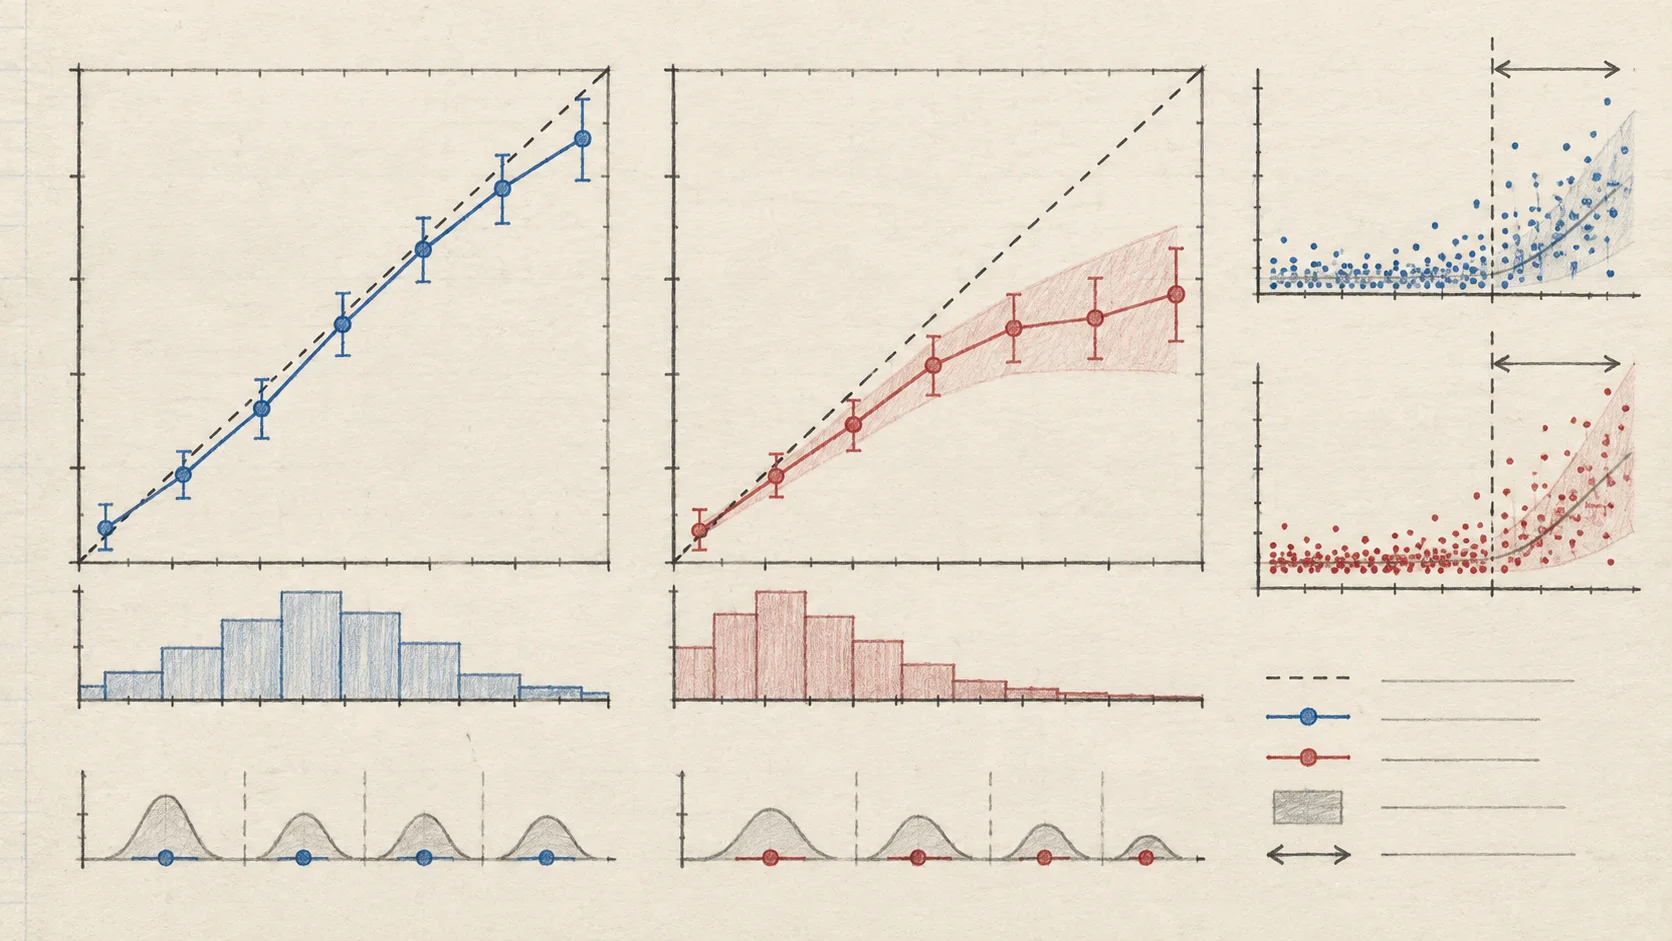
综合分数会掩盖关键差异:一个系统可能更快,但校准更弱;另一个系统可能便宜,却更难运维;还有的系统可能在评审式案例上更强,却在真正有歧义的案例上更弱。如果你的 Agent 会根据概率阈值自动批准、升级、加权或路由,校准质量可能比少量原始准确率差异更重要。
五个系统快速对比
| 系统 | 主要优势 | 主要取舍 | 适合场景 |
|---|---|---|---|
| Jev | 托管类型化决策与经过校准的概率 | 文本输入,按 API 使用量计费 | 生产路由、评分和安全守护 |
| djev | 速度快,支持原生图片和摄像头 | 概率被说明为实验性 | 快速多模态原型与视觉判断 |
| Laya | Apache-2.0 权重、自托管、可微调 | 生产质量需要任务数据与训练 | 离线或多语言系统 |
| OpenJev | 兼容 Jev API、支持图片和思考模式 | 需要运维 GPU 或 Apple Silicon | 想保留熟悉请求格式的自托管团队 |
| SemIf | 开源实现、离线 logits、综合分数接近 Jev | 需要 GPU、服务和按业务校准 | 受控网络和模型运维团队 |
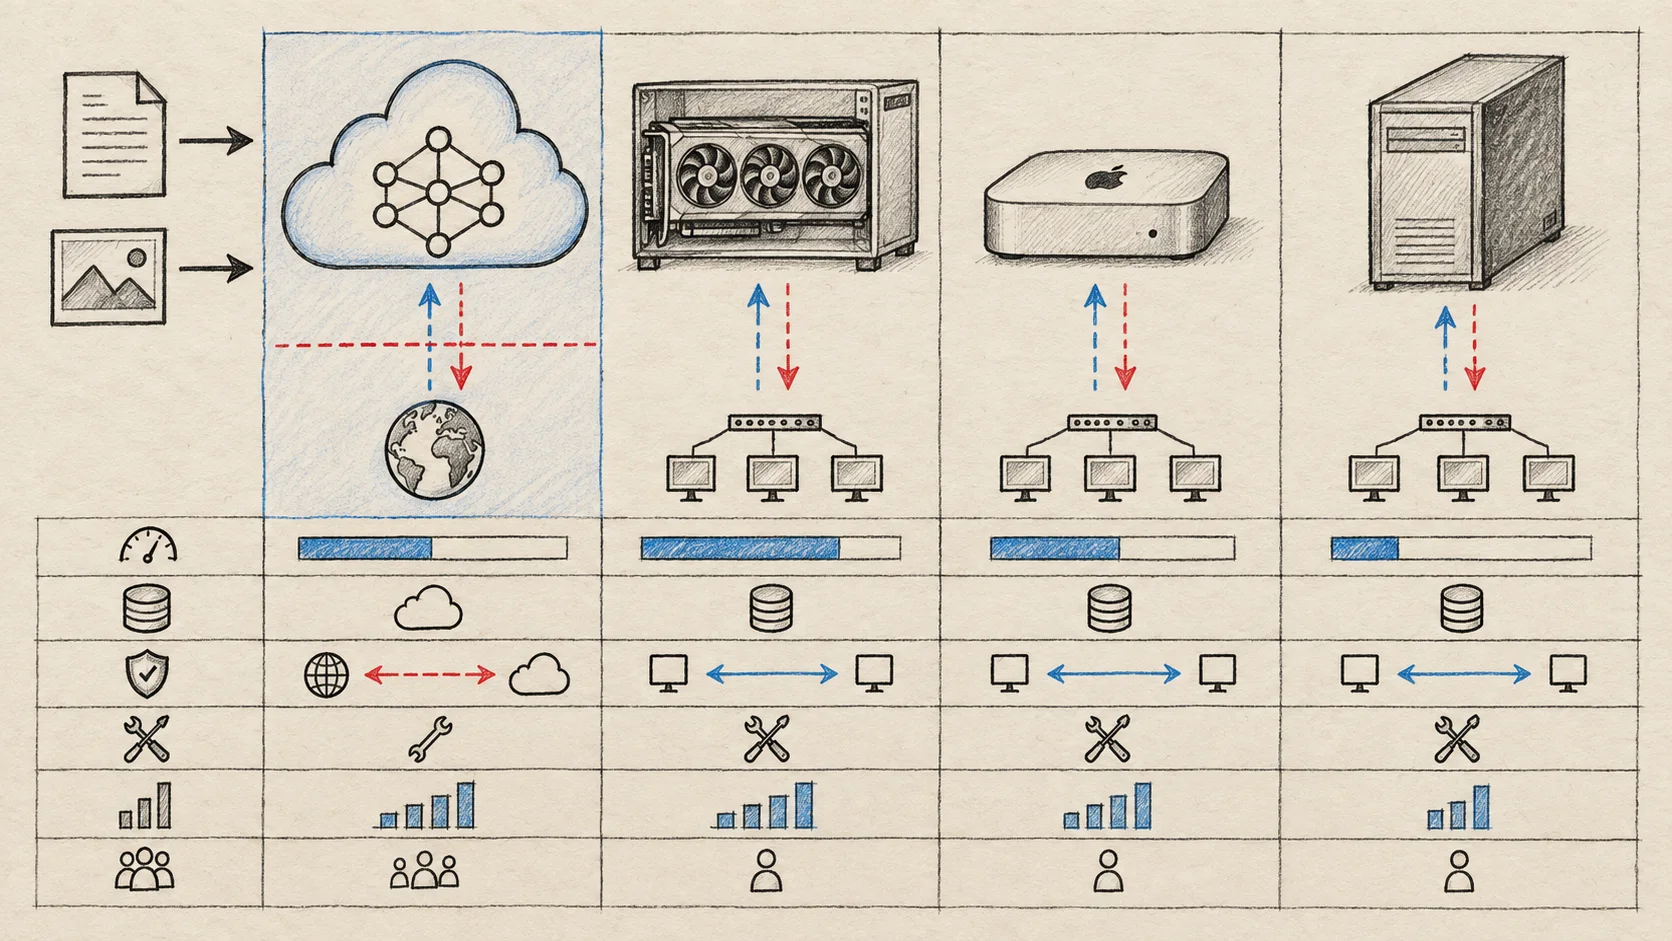
部署边界往往比排行榜更重要。托管 API 减少了基础设施工作,但请求会发送给服务商;自托管可以让数据留在自己的系统附近,却需要自己负责容量、监控、升级和校准。
Jev vs djev
Jev vs djev 对比页面 展示的是两个取舍重点不同、综合表现接近的系统。
公开校准分数中,Jev 为 82.7,djev 为 65.4;困难案例准确率分别为 74.1% 和 69.5%。djev 在速度维度领先,得分为 91.4,而 Jev 为 83.3。在简单和标准案例上,两者差距并不大,因此真实选择往往取决于输入方式和概率是否要直接驱动代码。
输入边界是关键区别:
- Jev 聚焦文本、JSON 对象和文本数组。
- djev 支持文本、原生图片、图片选项和实时摄像头帧。
- 两者都支持 Noul、Choice 和 Score 等类型化决策形状。
如果你的应用会使用概率进行自动批准、升级、加权或路由,并且希望拥有生产导向的托管路径,优先评估 Jev。如果视觉上下文或极低延迟是第一要求,可以评估 djev,但应该在自己的测试证明之前,把它的概率当作实验性信号处理。
成本形态也不同。参考页面将 Jev 描述为有明确使用模型的托管生产 API,djev 则处于带有公开定价说明的免费预览阶段。预览状态和价格都可能变化,正式确定架构前需要重新确认。
Jev vs Laya
Jev vs Laya 对比页面 主要比较“开箱即用的托管模型”和“可以自行训练的开源权重”。
在参考配置中,困难案例准确率 Jev 为 74.1%,Laya 为 34.1%;智能分数 Jev 为 85.7,Laya 为 45.8。Laya 的价值不在于零样本质量,而在于权重所有权、微调、离线部署,以及当团队已经拥有稳定 GPU 时较低的边际成本。
关键差异包括:
- 对比页面中,Jev 每次请求支持 64k tokens;Laya 每个问题的上下文为 512 tokens。
- Laya 提供 Apache-2.0 权重,以及英文和多语言 checkpoint。
- Laya 需要标注样例和微调,才能针对稳定生产任务获得可靠质量。
- Jev 通过托管 API 开箱即用,不需要管理闲置 GPU 或训练流程。
当数据不能离开内网、标签体系稳定、已经有标注数据,并且团队能够负责模型服务时,Laya 可能更合适。如果你想先验证一个决策工作流,不想立即建设这套基础设施,Jev 是更短的起步路径。
Jev vs OpenJev
Jev vs OpenJev 对比页面 的重点不是请求格式,而是请求离开应用之后由谁负责运行模型。
OpenJev 被设计为兼容 Jev 的决策服务,可以接受相同思路的 /v1/systemone 请求,运行在 24GB NVIDIA GPU 或 Apple Silicon 上,单次请求最多接受 8 张图片,并提供在质量和延迟之间取舍的思考模式。Jev 则是以文本决策为重点的托管生产 API。
在公开的默认配置对比中,Jev 的校准分数为 82.7,OpenJev 为 64.8;困难案例准确率分别为 74.1% 和 65.5%。速度分数很接近,分别是 83.3 和 83.2。OpenJev 的思考模式属于另一种运行点,参考页面报告其智能分数 88.0、困难案例准确率 78.2%,不能和默认配置混成一个简单结论。
如果你需要图片输入、自托管、Apache-2.0 代码与权重,或者需要在内网运行兼容 API,可以选择 OpenJev。如果你更看重开箱即用的概率校准、托管运维和快速上线,Jev 更合适。
Jev vs SemIf
Jev vs SemIf 对比页面 展示了公开综合排名中最接近 Jev 的开源替代方案:SemIf 得分 73.1,Jev 得分 74.4,排名分别为第 2 名和第 1 名。
差异并不是全面拉开,而是集中在几个维度:
- SemIf 在评审式案例中领先,准确率为 95.2%,Jev 为 94.5%。
- Jev 在困难案例中领先,准确率为 74.1%,SemIf 为 59.5%。
- Jev 的校准分数为 82.7,SemIf 为 72.6。
- 速度几乎持平,Jev 为 83.3,SemIf 为 83.7。
SemIf 使用开源模型 logits 读取方案,参考配置的主模型是 Qwen3.5-4B。项目代码采用 MIT 许可证,但上游模型权重仍遵循各自许可证。推理可以留在自己的环境中,但 GPU、服务栈、容量规划和业务校准都由团队负责。
如果你希望概率信号开箱即用,并且流量具有突发性、不适合长期运行闲置 GPU,Jev 更有优势。如果已经拥有持续繁忙的 GPU、需要离线运行,并且团队能够拟合和监控阈值,SemIf 值得重点测试。
按约束选择模型
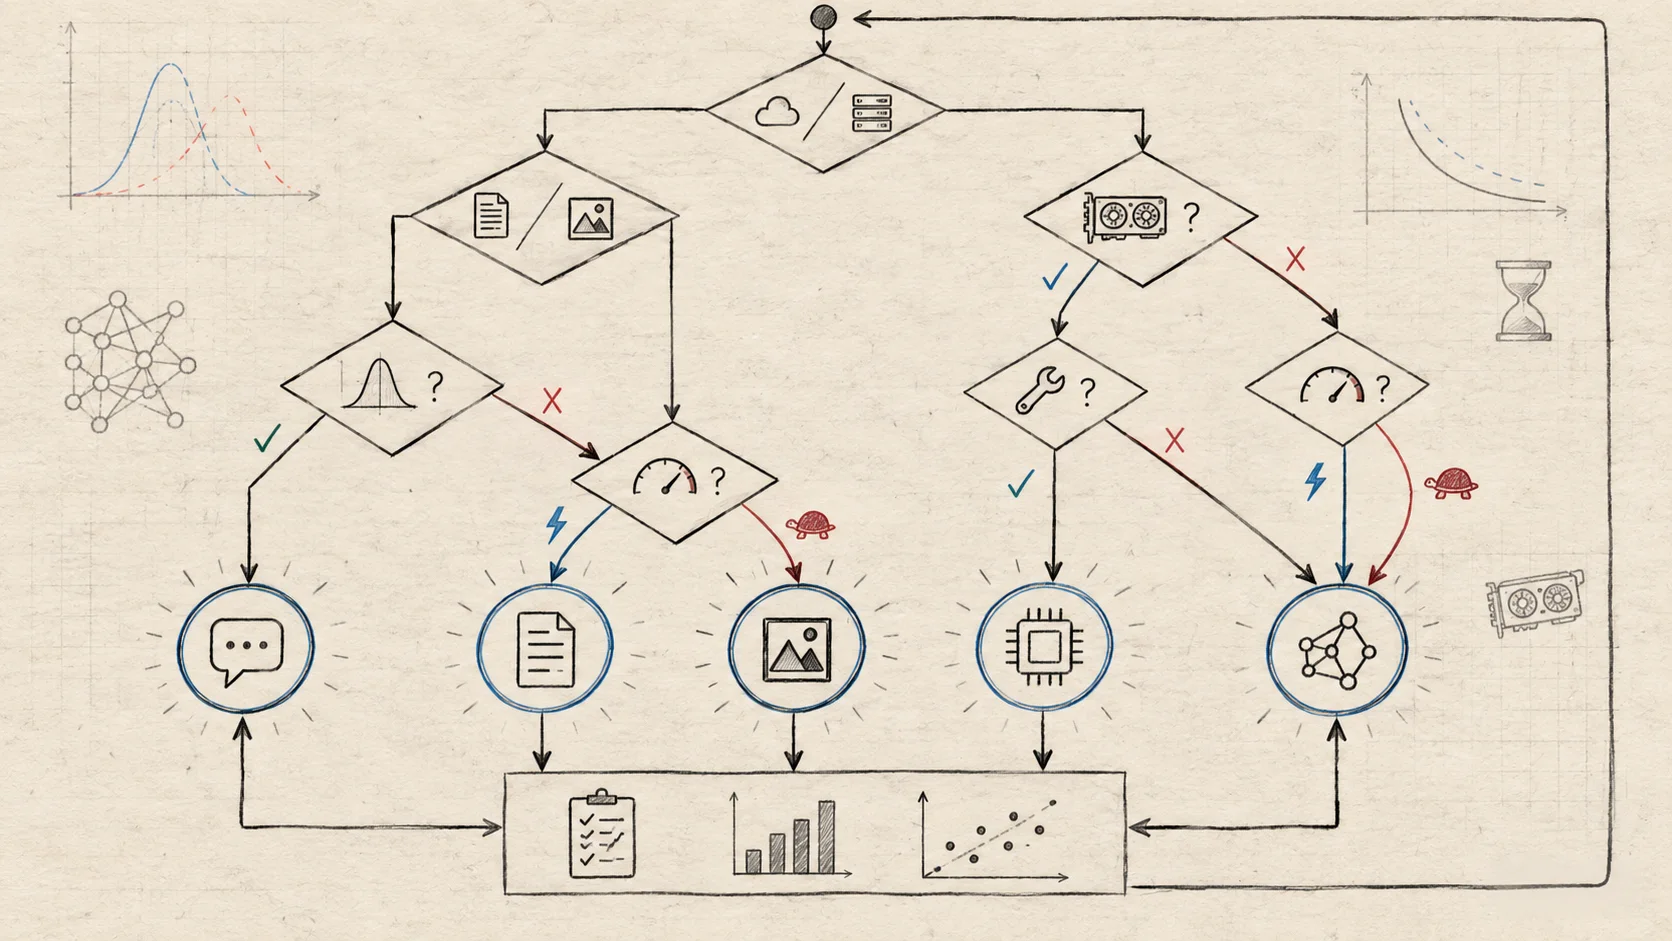
先确定最难在后期改变的约束:
| 主要约束 | 优先测试 | 原因 |
|---|---|---|
| 托管生产 API | Jev、djev | 不需要 GPU 服务栈,再比较校准和多模态需求 |
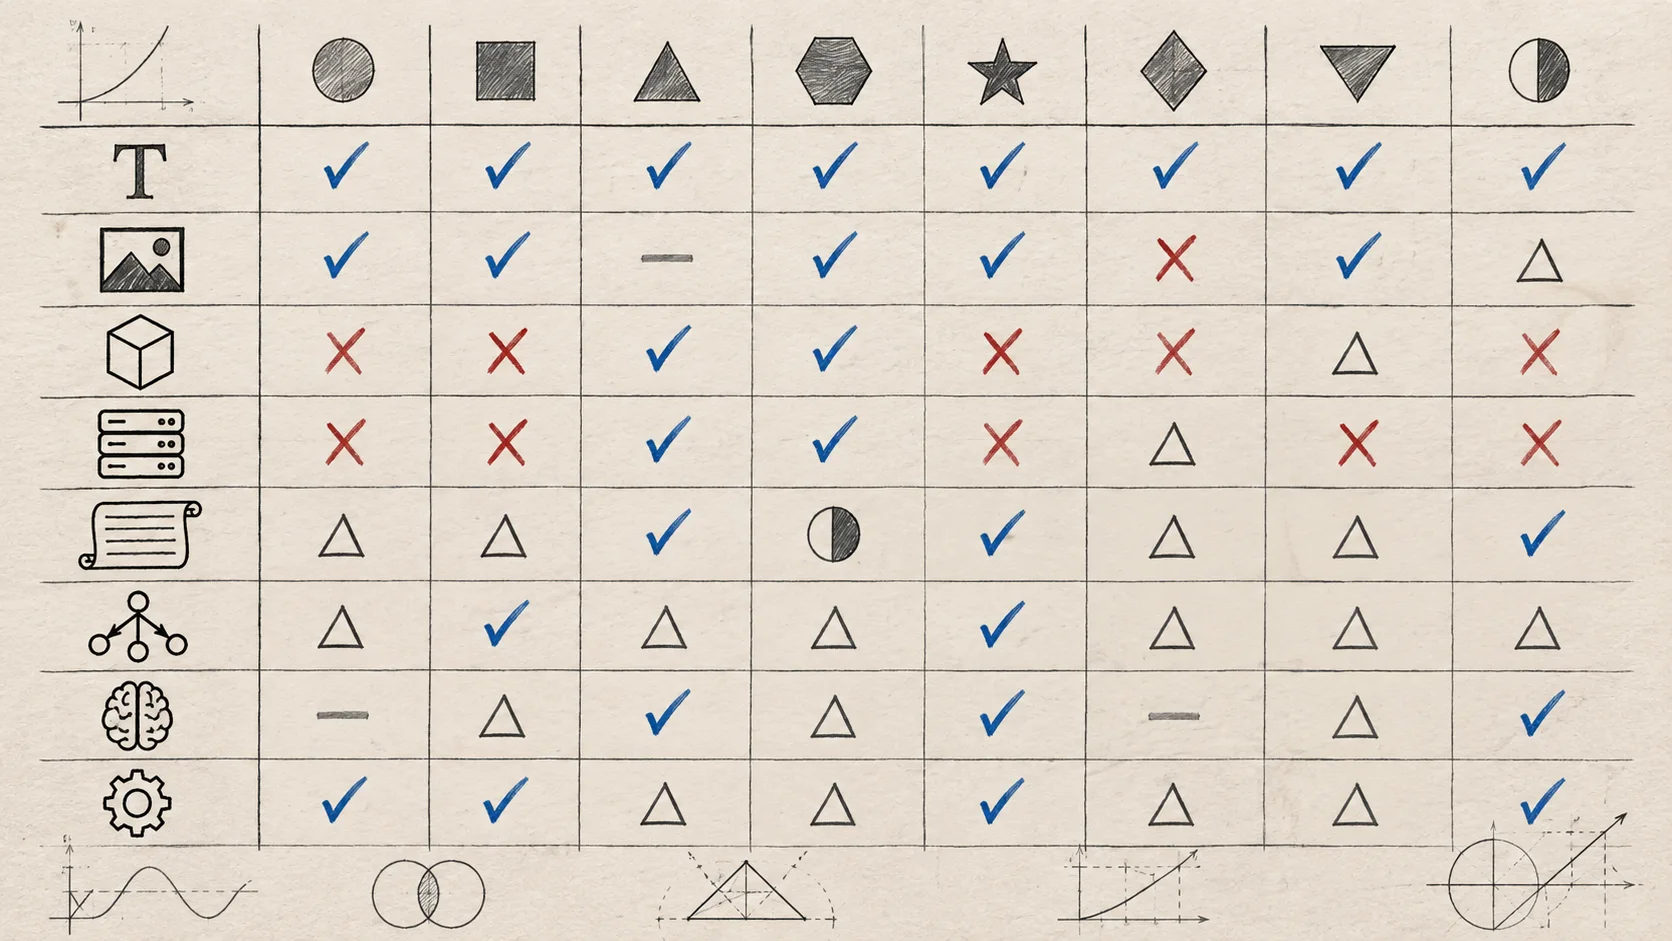
| 原生图片或摄像头输入 | djev、OpenJev | 两个对比页都强调多模态能力 |
| 数据必须留在内网 | Laya、OpenJev、SemIf | 自托管可以控制服务边界 |
| 概率要直接驱动路由 | 先测 Jev,再测 SemIf | 在困难案例上比较阈值行为 |
| 微调和开源权重 | Laya、OpenJev、SemIf | 可以检查、修改和运维运行环境 |
| 兼容 Jev 请求格式 | Jev、OpenJev | OpenJev 以兼容 API 形状为设计目标 |
| 突发流量且不想承担闲置 GPU | Jev | 托管访问避免本地加速卡容量规划 |
| 极低本地延迟 | Laya、SemIf、OpenJev | 应测端到端延迟,而非只看模型推理时间 |
如何设计自己的评估
最有价值的结果不是找到一个永远的赢家,而是找到能在真实样例上稳定工作的模型。
1. 固定决策接口
对所有系统使用同一份 State、问题描述、答案选项和输出策略。如果某个系统获得了更丰富的提示或不同的标签体系,比较就不公平。
2. 建立有代表性的测试集
同时加入正常案例、模糊案例、长上下文、对抗输入,以及应该升级处理的样例。把简单分类和真正会影响业务动作的决策分开统计。
3. 不要只测准确率
至少记录:
- 按难度拆分的准确率;
- 校准指标或预期校准误差;
- 端到端 p50 与 p95 延迟;
- 真实流量下的成本,包括闲置 GPU 成本;
- 图片参与任务时的多模态质量;
- 部署、升级和故障处理的运维工作量;
- 隐私、数据保留和网络边界要求。
4. 测试阈值策略
如果代码会根据概率自动批准、路由、阻断或升级,就必须评估阈值本身。平均表现更好的模型,如果在实际动作区域的概率不稳定,依然可能不是正确选择。
5. 变化后重新测试
开源模型、托管预览、价格、运行时和校准层都会变化。每次保存基准结果时,都记录模型版本、运行配置、日期和测试集。
常见问题
Jev 一定是质量最高的选择吗?
不是。参考基准中 Jev 在综合分数和困难案例上领先,但 SemIf 在评审式案例上领先,djev 在速度维度领先,Laya 在开源权重和本地延迟方面有优势,OpenJev 则提供带图片和思考模式的兼容自托管路径。
哪个系统适合私有化部署?
可以优先评估 Laya、OpenJev 和 SemIf,因为它们的参考页面都描述了自托管路径。最终选择取决于 GPU、数据政策、微调需求和团队的概率校准能力。
AI Agent 做工具安全判断时应该选哪个?
先选择一个你能在真实困难案例上验证概率信号和部署边界的系统。对于高影响工具,无论选择哪个模型,最终都应该在应用代码中保留确定性权限检查和人工审批。
基准分数可以当作当前产品保证吗?
不能。对比结果是在固定决策集上测量的带日期快照。它适合帮助你确定测试方向,最终仍应在计划上线的版本和部署模式上运行自己的任务集与阈值策略。
总结
Jev、djev、Laya、OpenJev 和 SemIf 的选择,本质上是系统工程决策,而不只是模型质量竞赛。Jev 优先考虑托管接入和经过校准的决策;djev 优先考虑速度与原生视觉输入;Laya 优先考虑开源权重、自托管与微调;OpenJev 优先考虑兼容部署、多模态和思考模式;SemIf 优先考虑开源 logits 以及对运行环境的控制。
先选出最重要的约束,再测试系统真正分开的困难案例,并测量代码实际使用的概率策略。这样,模型对比才能转化为可靠的生产选型。