模型对比
Jev vs Laya:托管 API 与开源权重怎么选?(2026)
Jev 与 Laya 怎么选?从 JevBench v1.3.0、微调需求、置信度、延迟、上下文长度与总拥有成本,判断哪种决策模型适合你的工作流。
比较 Laya 和 Jev,应先看产品需要什么运行边界。Jev 是开箱即用的托管决策 API;Laya 是可以自行部署和适配的开源权重模型。标注数据、数据驻留、语言、上下文长度以及团队是否能运维推理服务,决定了哪种方案更合适。
下文数据来自 JevBench v1.3.0,对比页于 2026 年 9 月 22 日核对。它反映一次基准测试,不保证适用于所有工作负载。
先看结论
约束优先评估原因没有标注数据或微调团队Jev托管 API 面向开箱即用的零样本决策。数据必须留在自有网络Laya开源权重可本地部署和适配。长工单、文档或执行轨迹Jev对比页列出的单次请求上下文为 64k tokens。多语言分流Laya 多语言检查点有专门的多语言模型,但需要逐语言验证。没有 GPU 运维能力Jev无需配置 GPU、更新检查点或监控推理服务。
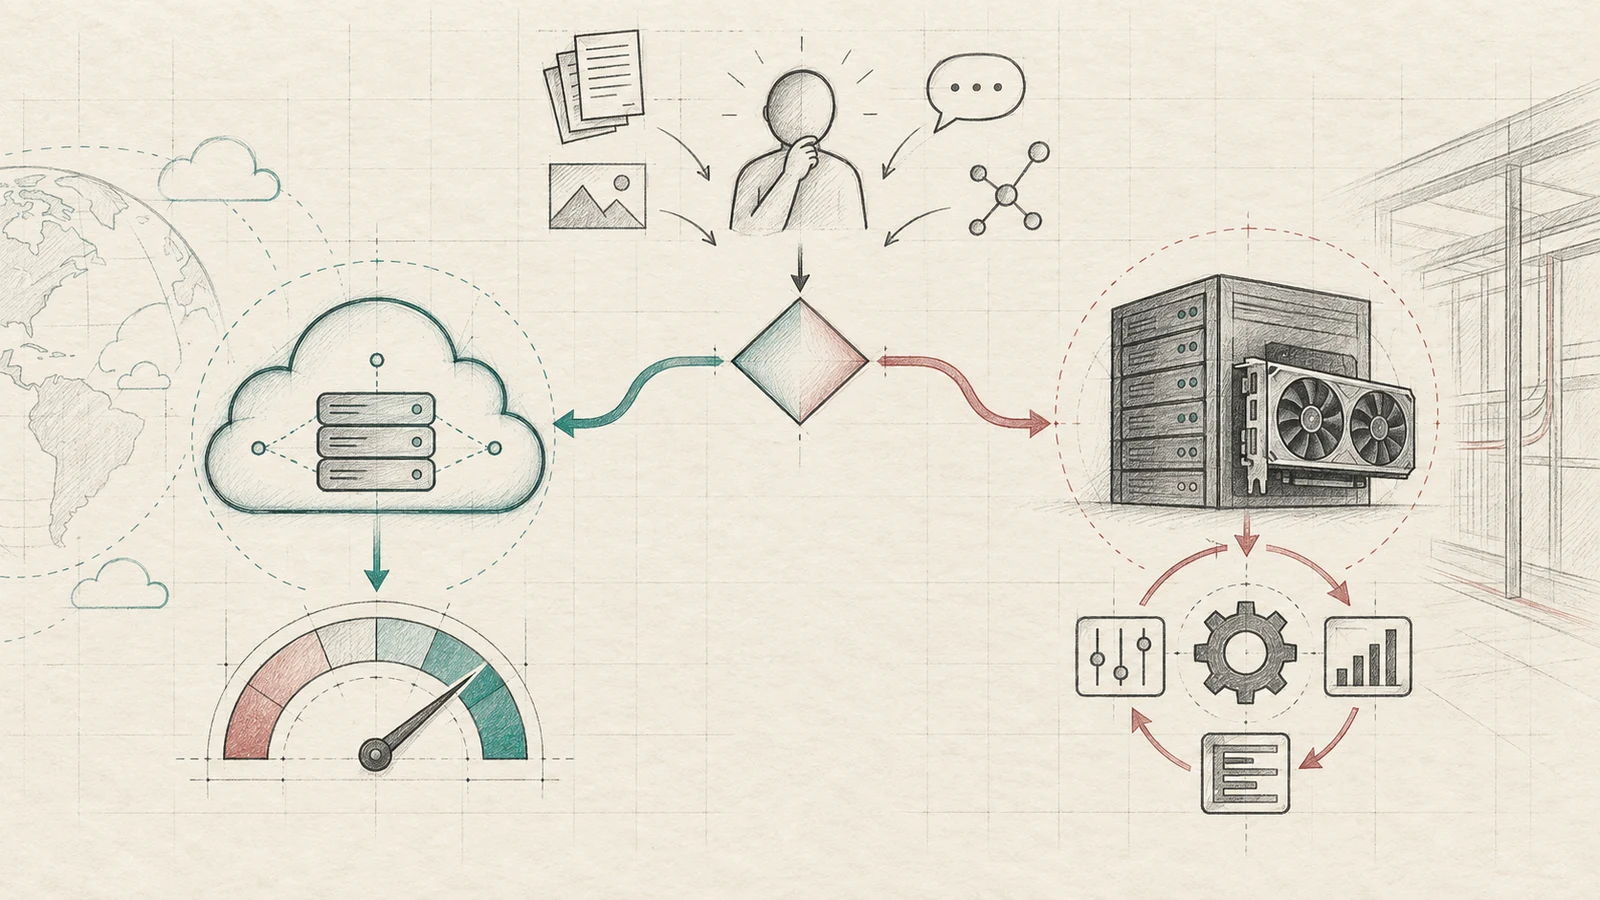
两种系统分别提供什么
两者都能回答结构化问题,例如“分到哪个队列”“是否允许”“按规则打几分”。它们可以替代先生成自由文本、再解析结果的流程。
-
Jev 是 TypeSafe 托管的 System One API。对比页列出无需先微调、单次请求最多 64k tokens,上限 255 个 choice 选项。团队调用 API,不必运维 GPU。
-
Laya 是基于编码器构建的开源决策模型。Apache-2.0 实现可本地运行和微调。对比页测试的检查点每个问题为 512 tokens;Laya 官方项目对不同检查点列出不同限制,部署前应确认具体版本。
两者都不是通用聊天模型,都需要清楚的结构、稳定的标签和处理不确定答案的规则。
JevBench v1.3.0 的结果
基准以相同方法比较了 52 个系统和 534 个结构化决策:72 个简单案例、96 个标准案例、146 个评审型案例和 220 个困难案例。Jev 综合得分 74.4(第 1);Laya 得分 54.4(第 33)。
指标Jev 1.13.0Laya综合得分74.454.4Intelligence 得分85.745.8Calibration 得分82.762.5困难案例准确率74.1%34.1%标准案例准确率99.0%72.9%
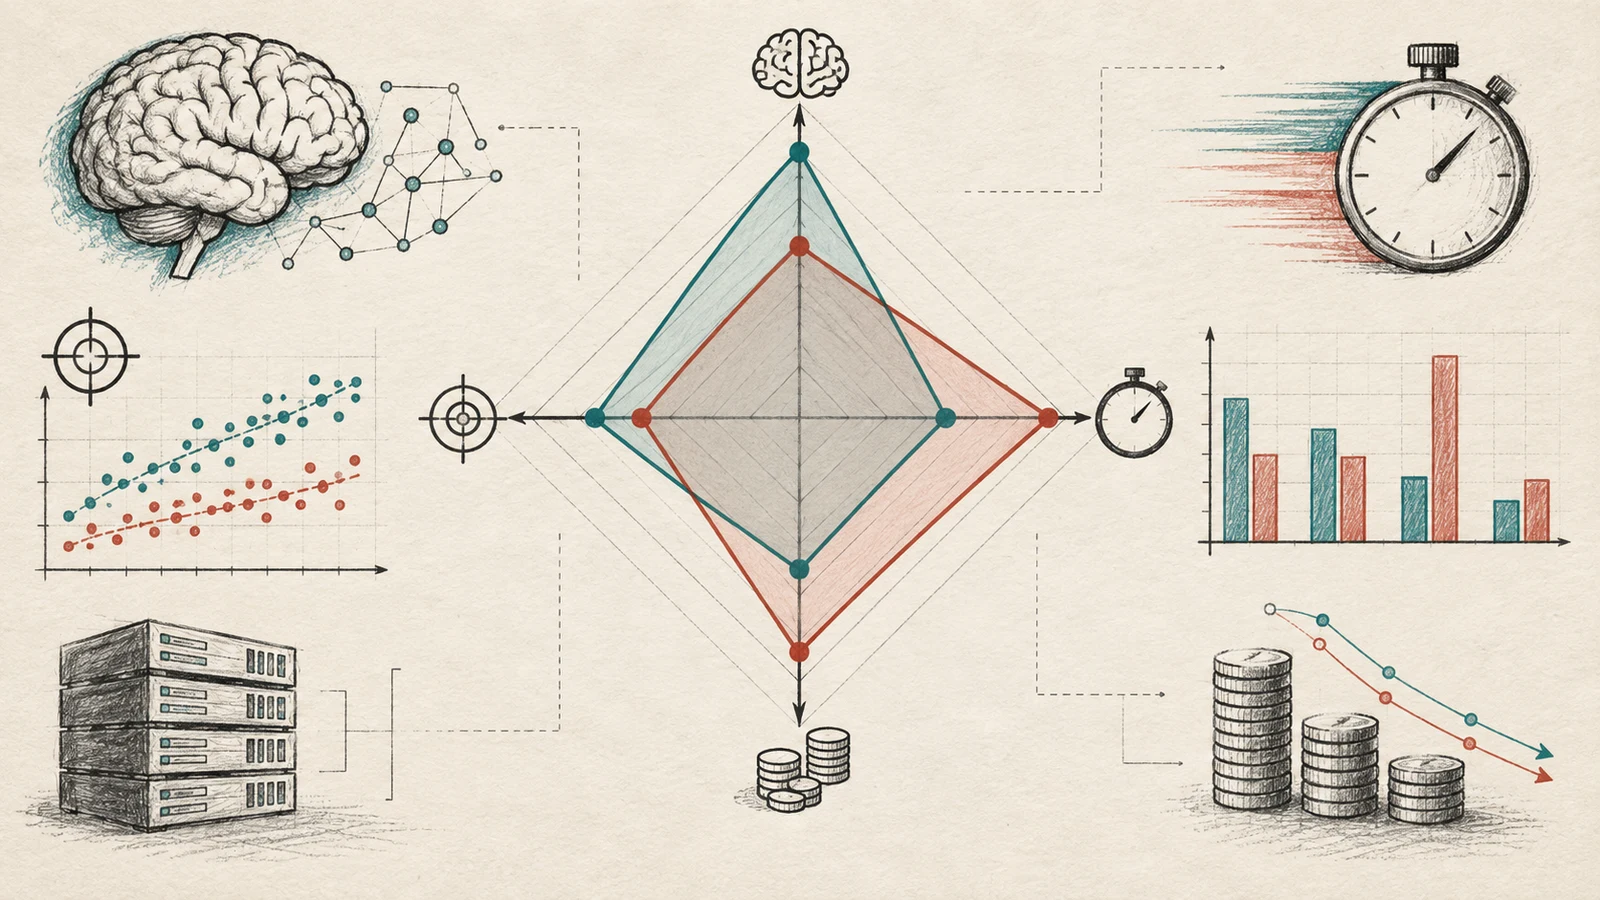
这些分数不是通用产品排名,而是特定问题集与未微调 Laya 配置的结果。如果标签稳定并计划微调 Laya,应使用独立留出集评估训练后的检查点。
上下文与多语言能力
长输入可能包含改变决策的关键条款。对比页列出 Jev 64k tokens、测试版 Laya 每题 512 tokens。Laya 官方页面区分英文与多语言检查点,因此实际上下文长度取决于版本。应使用准备上线的模型和输入格式测量 token 数。
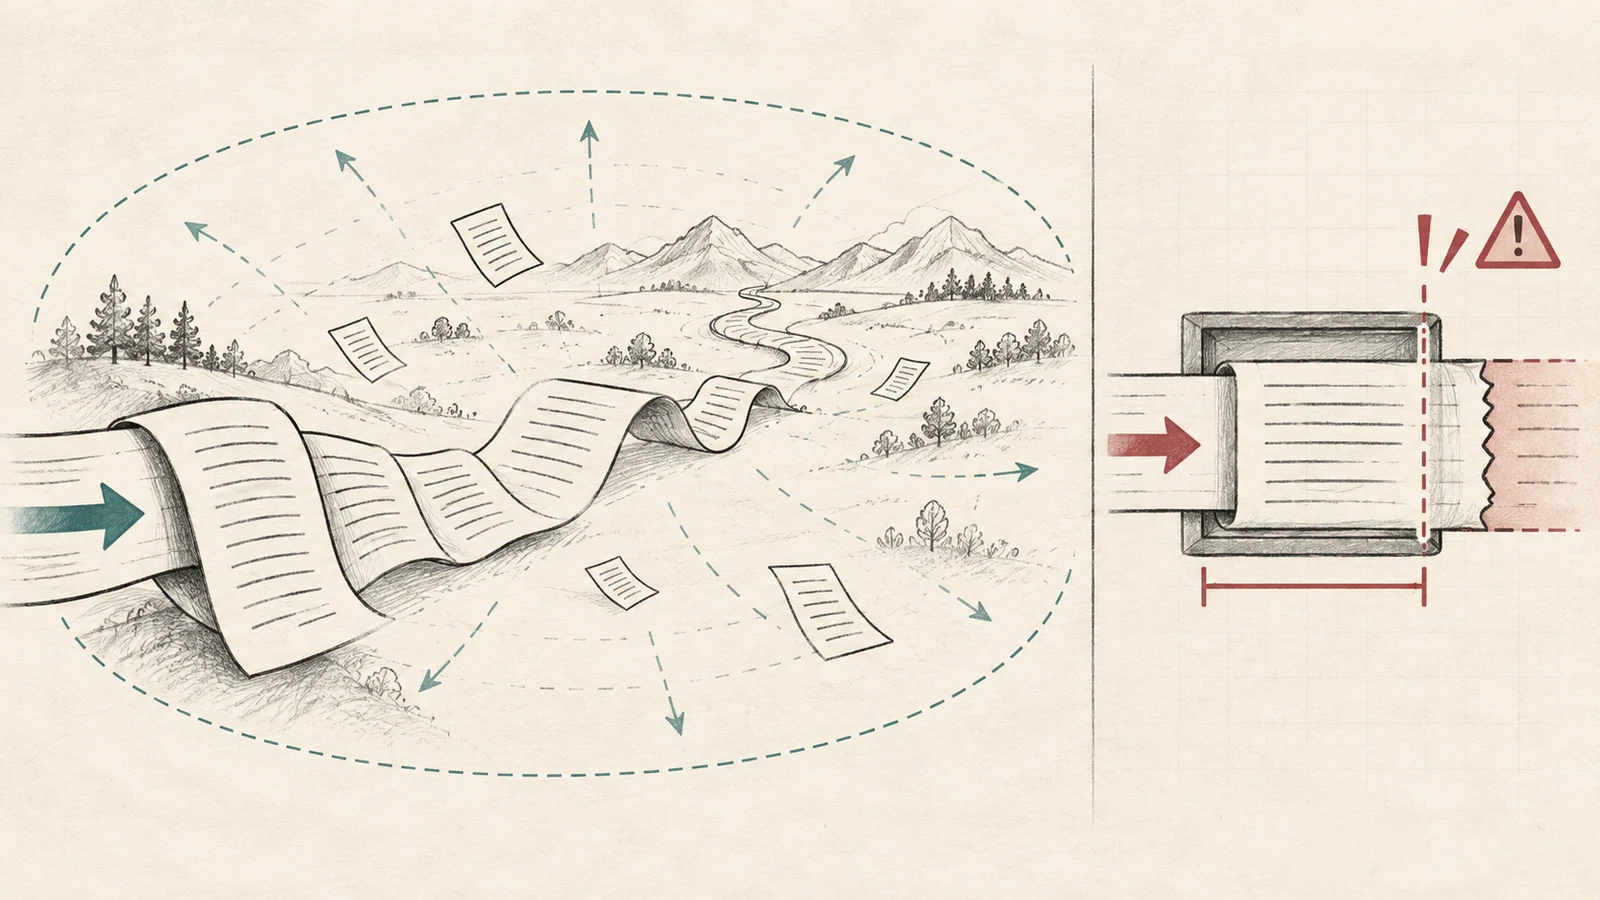
当英文不够用时,Laya 多语言检查点值得评估,但覆盖某种语言不代表每种语言质量相同。测试人名、不同文字系统、混合语种和行业词汇。
准确率、置信度与延迟
准确率衡量标签是否正确;校准衡量置信度 0.8 是否大致对应 80% 的实际正确率。常见的期望校准误差会按置信度分箱,汇总每箱准确率与平均置信度之间的差异。
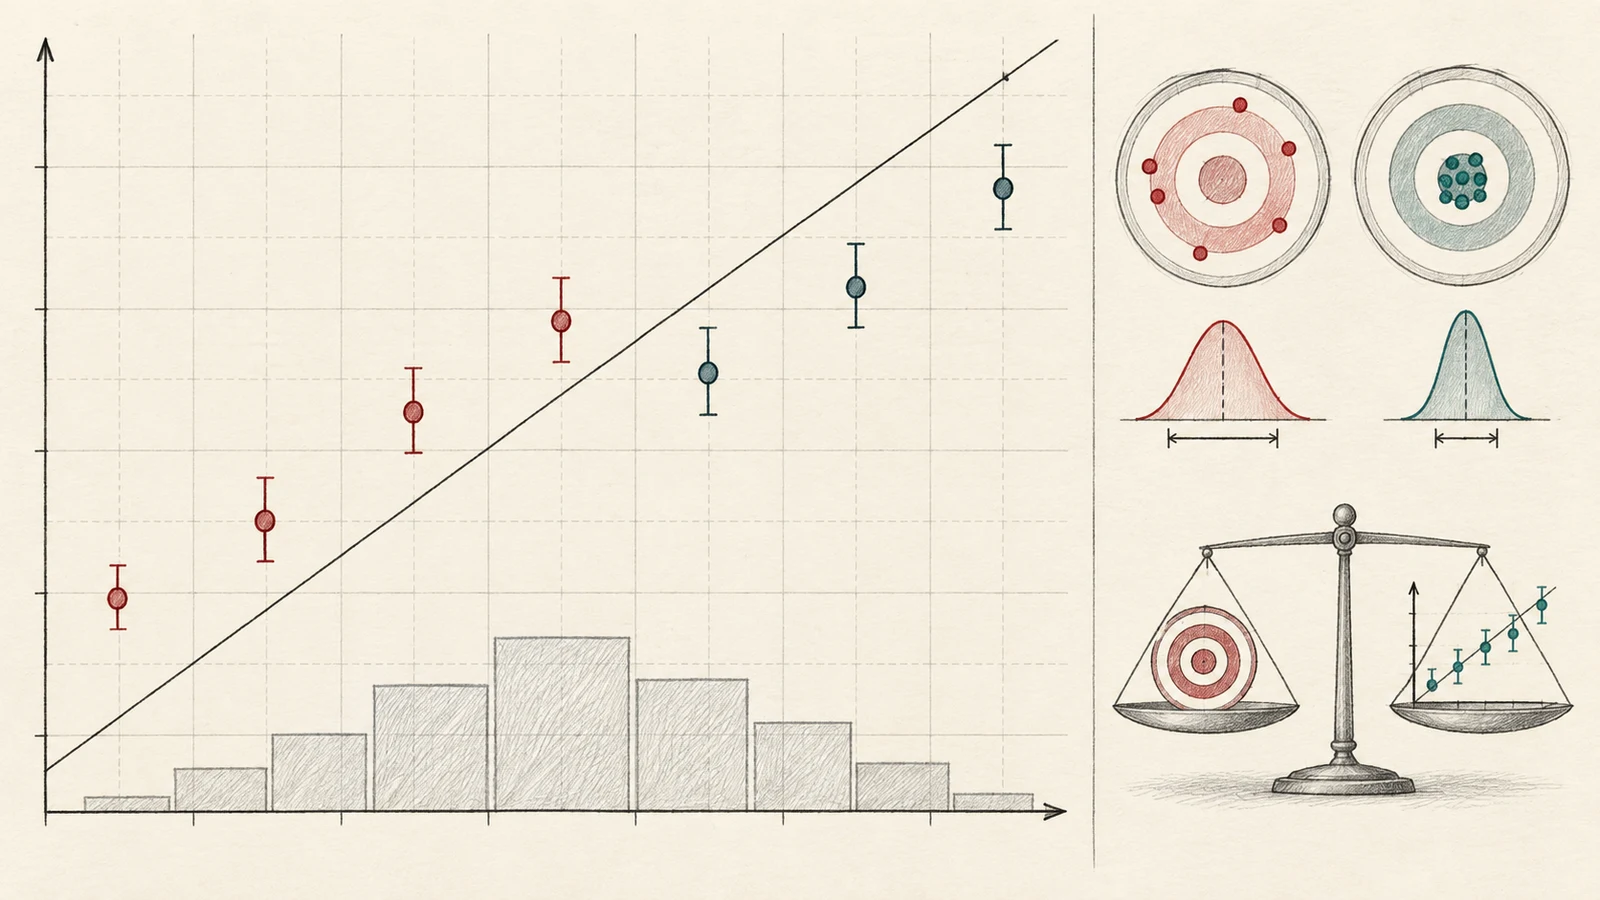
在本次配置中,JevBench 的 Jev 校准得分更高。Laya 文档介绍了针对任务做温度拟合。无论选哪种模型,都应在接近生产分布的数据上选择阈值,并同时报告准确率与覆盖率:增加弃答可能提高已回答案例的准确率。
Laya 项目报告 Tesla T4 上几十毫秒的推理时间。对比页同时列出 JevBench 在 CPU 上运行 Laya 的原始 0.79 秒、调整后 1.72 秒,以及 Jev 托管 API 0.65 秒的中位数。硬件和服务链路不同,不能视为同条件速度比较。请测量自己的网络、并发、冷启动和 P95 延迟。
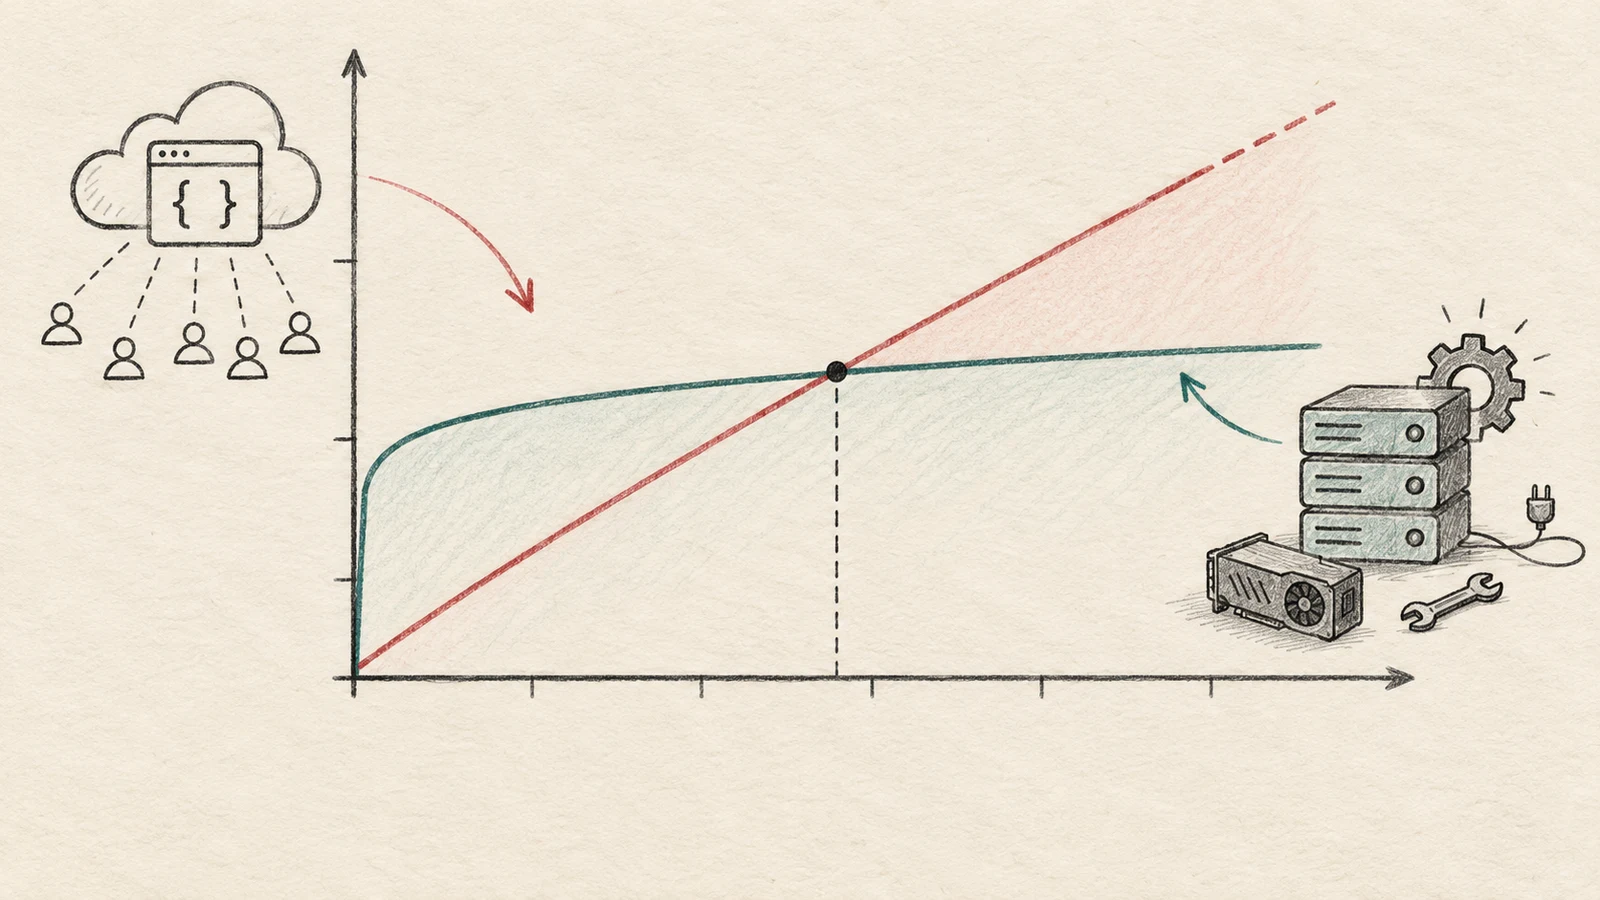
成本需要同时考虑 API 用量、GPU 容量、运维、监控、微调和闲置时间。已有高利用率 GPU 时,自托管边际成本可能较低;专用容量和维护也会抬高总成本。
实用评估步骤
-
固定输入结构、标签、平局规则和“未知”的含义。
-
准备留出集,覆盖常规、模糊、多语言、长上下文和高风险案例。
-
比较分类 F1、易混淆标签、校准、不同阈值下的覆盖率和弃答率。
-
测量 P50/P95 延迟、吞吐、冷启动、失败和截断。
-
总成本包含标注、GPU 利用率、托管、监控、维护和 API 费用。
-
先影子运行,并与人工复核对照,再启用可能产生重大后果的自动操作。
需要零样本决策和托管服务时,先用 Jev 建立基线;开放权重、数据驻留、多语言路由或微调是核心要求时,重点评估 Laya。延伸阅读:Jev 与 Laya、Jev 与 OpenJev、Jev 与 djev。
Jev vs Laya 常见问题
Laya 能直接替代 Jev 吗?
不一定。Laya 需要团队选择并部署检查点,生产效果可能依赖微调和校准;Jev 是托管 API,数据边界和运维模式不同。
哪个模型更快?
取决于硬件和请求位置。CPU 基准不能与 Tesla T4 的数据直接比较;测试时也要包括网络时间和 P95 延迟。
哪个更适合多语言?
Laya 有多语言检查点;Jev 对比页也列出 100 多种语言,但注明英语以外的可靠性较低。请按真实语种和业务领域验证。
可以用置信度阈值自动决策吗?
先用留出数据评估校准和错误成本,并记录误放行、误拒绝、覆盖率和人工复核负载。
资料来源
基准数据来自 Jev 与 Laya 对比及 JevBench v1.3.0,于 2026 年 9 月 22 日核对。检查点信息可参考 Laya 项目 与 GitHub 仓库。模型和数据可能更新,生产使用前请确认最新版本、限制与价格。