Entwicklerleitfaden
Cloudflare Clef verwenden: Ein praktisches API-Tutorial
Lernen Sie Cloudflare Clef mit REST und Workers AI kennen: typisierte Entscheidungsschemas, Konfidenzschwellen, Bildeingaben, Preise und Einführung.
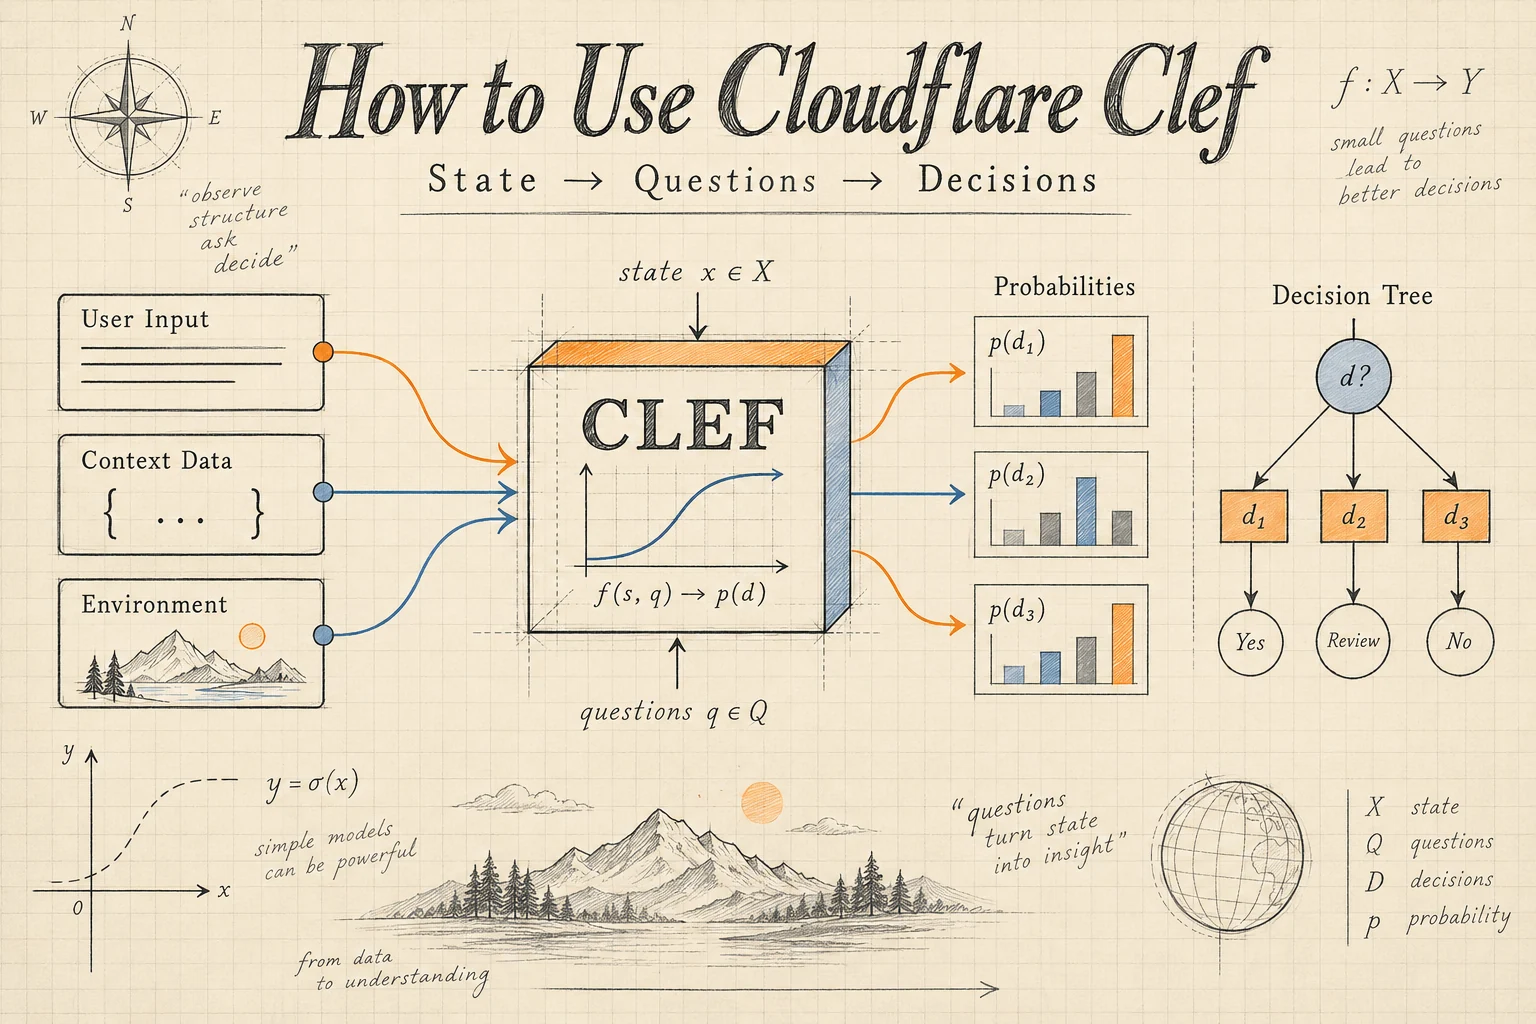
Um Cloudflare Clef zu verwenden, übergeben Sie die zu bewertenden Informationen Ihrer Anwendung in state, definieren typisierte Fragen in questions und rufen @cf/cloudflare/clef über Workers AI auf. Lesen Sie die zurückgegebenen Wahrscheinlichkeiten aus und wählen Sie anschließend anhand Ihrer eigenen Regeln eine Aktion aus. Sie können mit REST beginnen und dieselben Entscheidungsdaten später in einem Cloudflare Worker verwenden.
Clef ist ein multimodales Entscheidungsmodell mit 27 Milliarden Parametern. Es eignet sich für Software, die Einschätzungen zu vorgegebenen Optionen benötigt: Welcher Warteschlange gehört ein Supportticket? Deuten die vorliegenden Informationen auf einen Ausfall hin? Wie schwerwiegend erscheint eine Unterbrechung? Die offizielle Modellreferenz dokumentiert die gehostete Schnittstelle.
Dieses Tutorial entwickelt ein Beispiel für die Zuordnung von Supporttickets, vom Schemaentwurf bis zur Einführung. Dokumentation und Preise wurden am 3. Oktober 2026 geprüft. Die Codebeispiele wurden mit den veröffentlichten Schnittstellendefinitionen abgeglichen; sie wurden nicht mit einem aktiven Inferenzkonto ausgeführt. Alle Beispielwahrscheinlichkeiten sind synthetisch.
Inhaltsverzeichnis
- Eine geeignete Entscheidung auswählen
- Das Schema für Zustand und Fragen erstellen
- Die REST-API von Cloudflare Clef aufrufen
- Die Antwort richtig auswerten
- Clef in einem Cloudflare Worker verwenden
- Schwellenwerte anhand eigener Daten festlegen
- Bilder hinzufügen und Self-Hosting verstehen
- Die Kosten von Cloudflare Clef abschätzen
- Häufige Integrationsfehler beheben
- Den Workflow bewerten und einführen
- Häufig gestellte Fragen
Eine geeignete Entscheidung auswählen
Beginnen Sie mit einer eng umrissenen Aktion, die bereits einen Verantwortlichen und ein messbares Ergebnis hat. In diesem Beispiel muss die Anwendung ein Supportticket accounts, billing oder review zuordnen. Ein korrektes Ergebnis bedeutet, dass das empfangende Team das Problem bearbeiten kann, ohne das Ticket weitergeben zu müssen.
Formulieren Sie diese Definition, bevor Sie einen Prompt schreiben. „Den Kunden verstehen“ ist zu weit gefasst, um es bewerten zu können. „Das Team identifizieren, das für das wichtigste ungelöste Problem zuständig ist“ gibt Prüfenden eine konkrete Aufgabe.
Manche Entscheidungen benötigen kein Modell. Wenn ein gespeicherter Abonnementstatus über den Zugriff auf eine Funktion entscheidet, verwenden Sie eine Datenbankabfrage. Wenn eine Rechnung einen festen Schwellenwert überschreitet, vergleichen Sie die Zahlen im Code. Nutzen Sie Clef für die Interpretation von Informationen, deren Bedeutung sich mit einer einfachen Regel nicht zuverlässig erfassen lässt.
Trennen Sie die ausgewählte Zuordnung von den Berechtigungen zur Ausführung. Eine Klassifizierung als billing kann eine Abrechnungswarteschlange öffnen; sie sollte allein keine Rückerstattung genehmigen. Unsere Übersicht zu Cloudflare Clef erläutert diese Aufteilung der Verantwortlichkeiten näher.
Halten Sie bei Agentenanwendungen die möglichen Ziele fest, bevor Sie das Modell auswählen. Der Workflow zur Modell- und Werkzeugauswahl ist eine hilfreiche Ergänzung, wenn eine Entscheidung ein Werkzeug oder ein anderes Modell anstelle eines Supportteams auswählt.
Das Schema für Zustand und Fragen erstellen
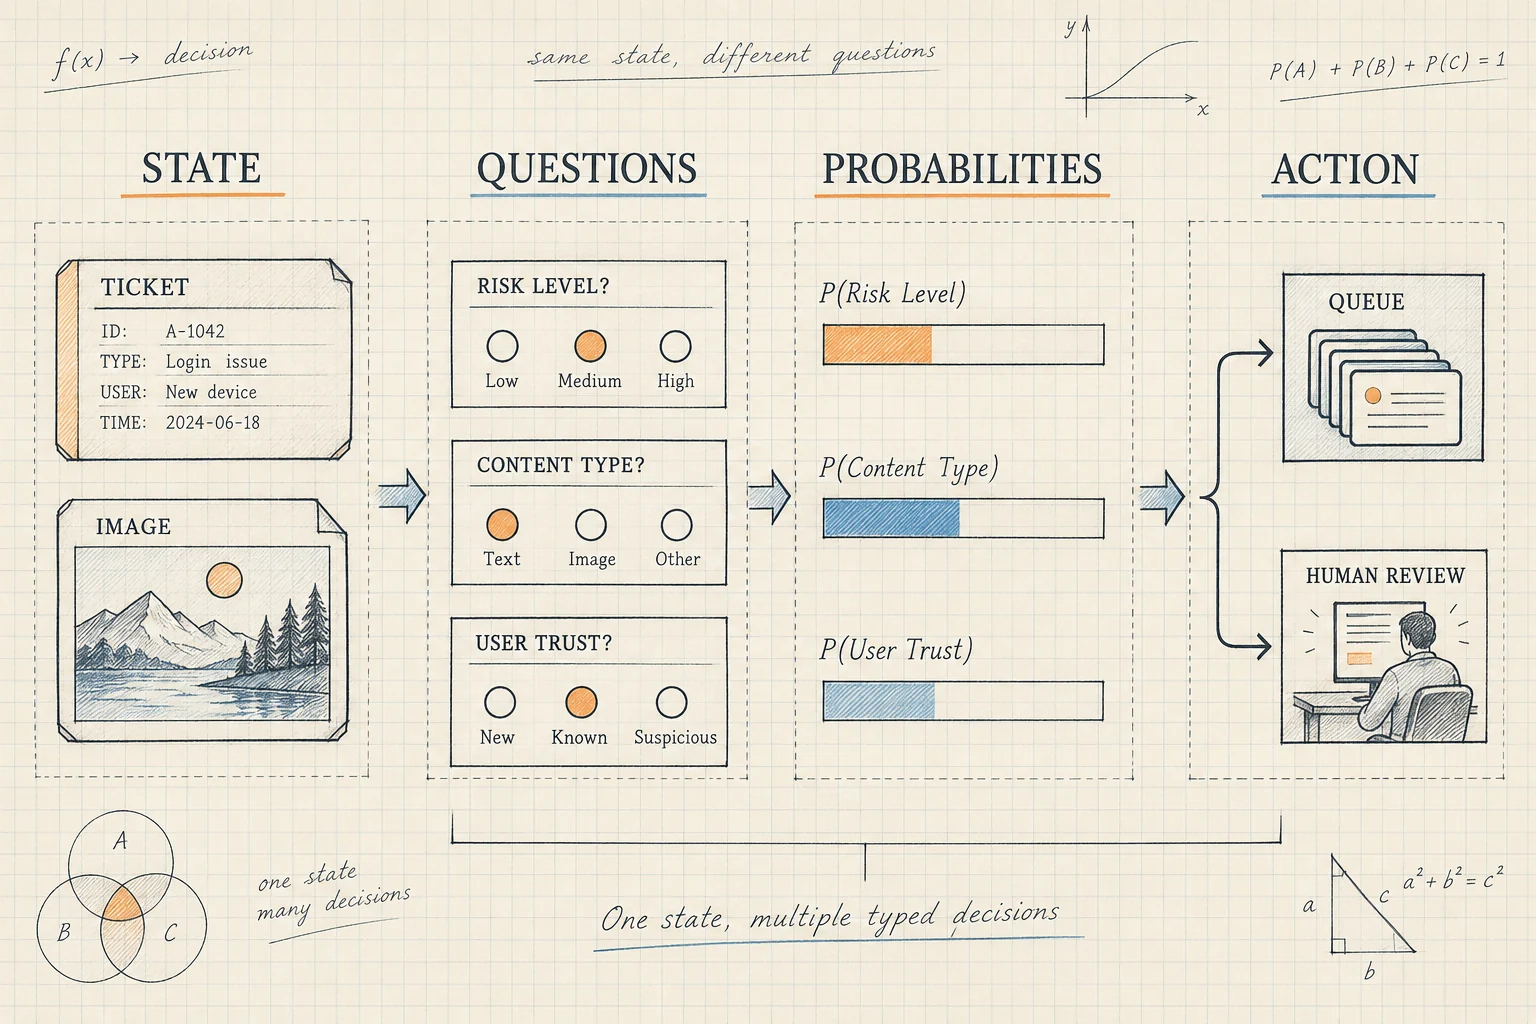
Verwenden Sie state für das zu bewertende Material. Definieren Sie die gewünschte Einschätzung über instructions und criteria jeder Frage. Von Kunden verfasster Text gehört nicht in die vertrauenswürdigen Bewertungsvorgaben.
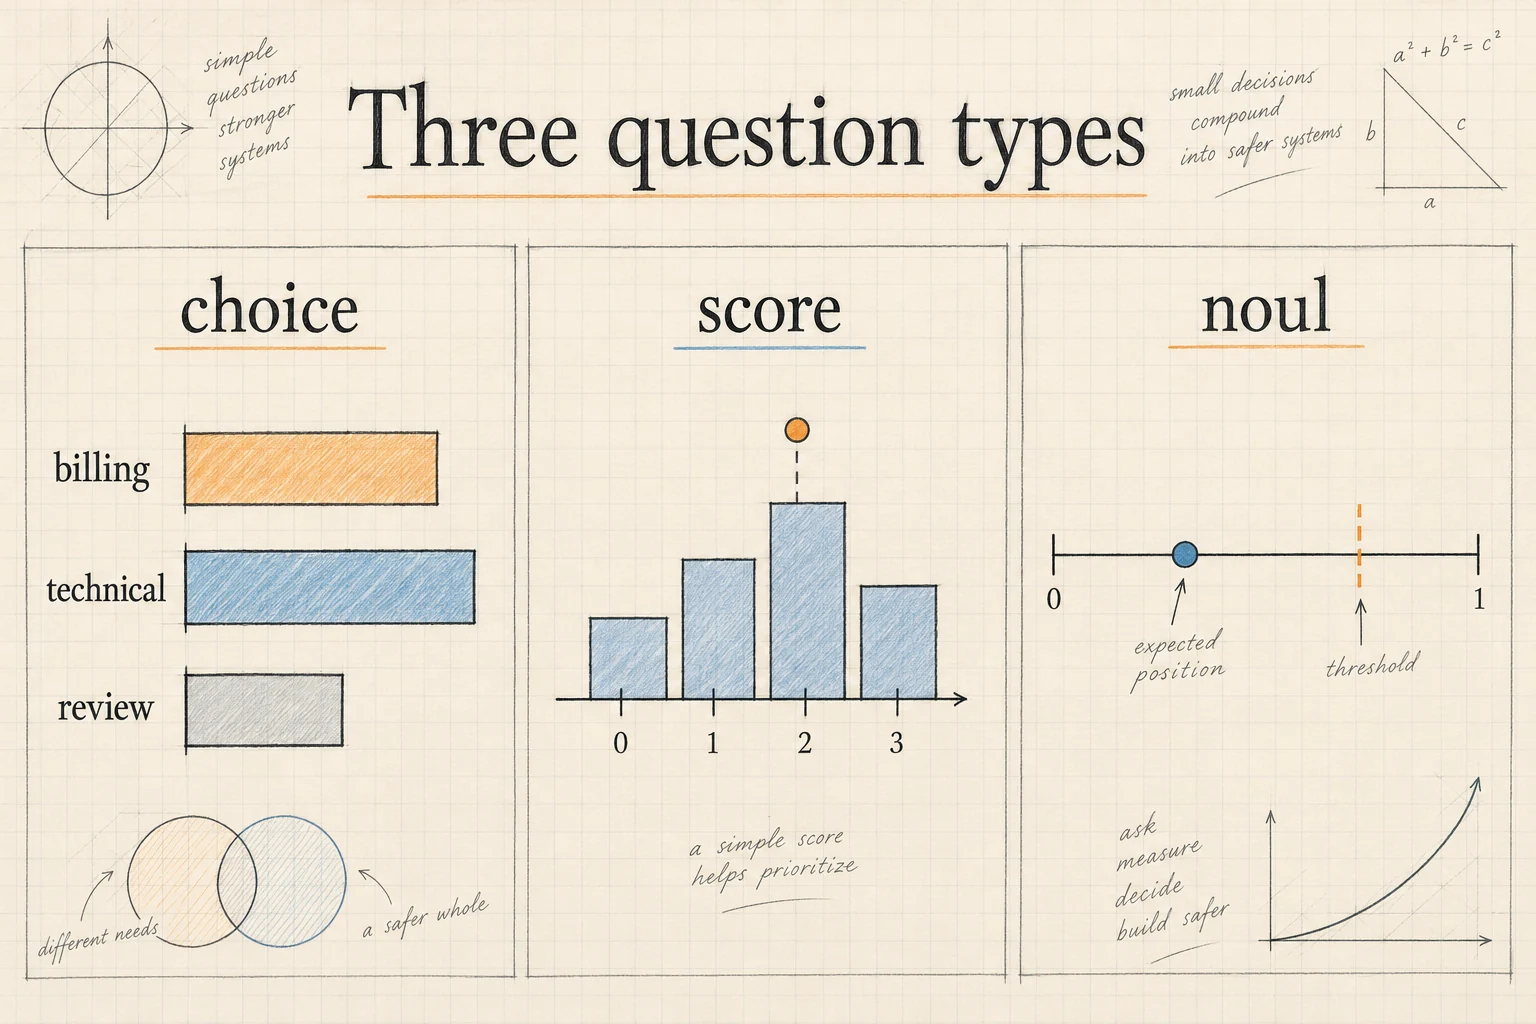
Das gehostete Eingabeschema verlangt model, state und questions. Jede Frage benötigt type und instructions; für choice und score ist zusätzlich criteria erforderlich.
| Typ | Anwendungsfall | Struktur der Kriterien |
|---|---|---|
choice |
Ein benanntes Ziel auswählen | Objekt, das Options-IDs ihren Beschreibungen zuordnet |
noul |
Eine Ja-oder-Nein-Aussage bewerten | Optionale Beschreibungen für wahr und falsch |
score |
Auswirkungen anhand einer geordneten Skala bewerten | Array mit aufsteigend geordneten Stufen |
Beschreiben Sie Optionen so, dass sie klar unterscheidbar sind. „Kontozugriff“ und „Zahlungsstreitigkeit“ definieren unterschiedliche Zuständigkeiten. „Dringendes Problem“ und „Technisches Problem“ überschneiden sich dagegen, weil Dringlichkeit und Zuständigkeit verschiedene Dimensionen sind. Stellen Sie zwei Fragen, wenn Sie zwei Dimensionen benötigen.
Sehen Sie ausdrücklich eine Zuordnung zu review für fehlende Informationen und Fälle außerhalb Ihrer Kategorien vor. Andernfalls muss jede ungewöhnliche Anfrage mit regulären Zielen konkurrieren. Dadurch kann eine fehlerhafte Taxonomie hinter scheinbar eindeutigen Ergebnissen verborgen bleiben.
Nehmen Sie beim Aufbau von state relevante Kontextinformationen auf und kennzeichnen Sie deren Herkunft. Die Aussage eines Kunden, dass der Bezahlvorgang ausgefallen sei, unterscheidet sich von einem gemessenen Ergebnis der Dienstüberwachung. Versehen Sie veränderliche Informationen mit Zeitstempeln, markieren Sie unbekannte Felder und ergänzen Sie keine sachfremde Historie, nur weil sie verfügbar ist.
Versionieren Sie das Schema zusammen mit der Anwendung. Wenn sich die Bedeutung von „schwerwiegenden Auswirkungen“ ändert, ändert sich auch die Aufgabe, selbst wenn die JSON-Schlüssel identisch bleiben. Eine feste Schemaversion macht spätere Vergleiche nachvollziehbar.
Prüfen Sie vor der API-Anbindung einige Gegenbeispiele manuell. Ein Kunde kann eine Zahlung erwähnen, obwohl er Hilfe beim Zurücksetzen seines Passworts benötigt; ein anderer kann sich anmelden, beanstandet aber eine doppelte Abbuchung. Ihre Zuordnungsdefinition sollte erklären, warum diese Tickets zu unterschiedlichen Teams gehören. Wenn zwei Prüfende allein anhand der Vorgaben nicht übereinstimmen, überarbeiten Sie diese Vorgaben, bevor Sie ein Modell damit beauftragen.
Die REST-API von Cloudflare Clef aufrufen
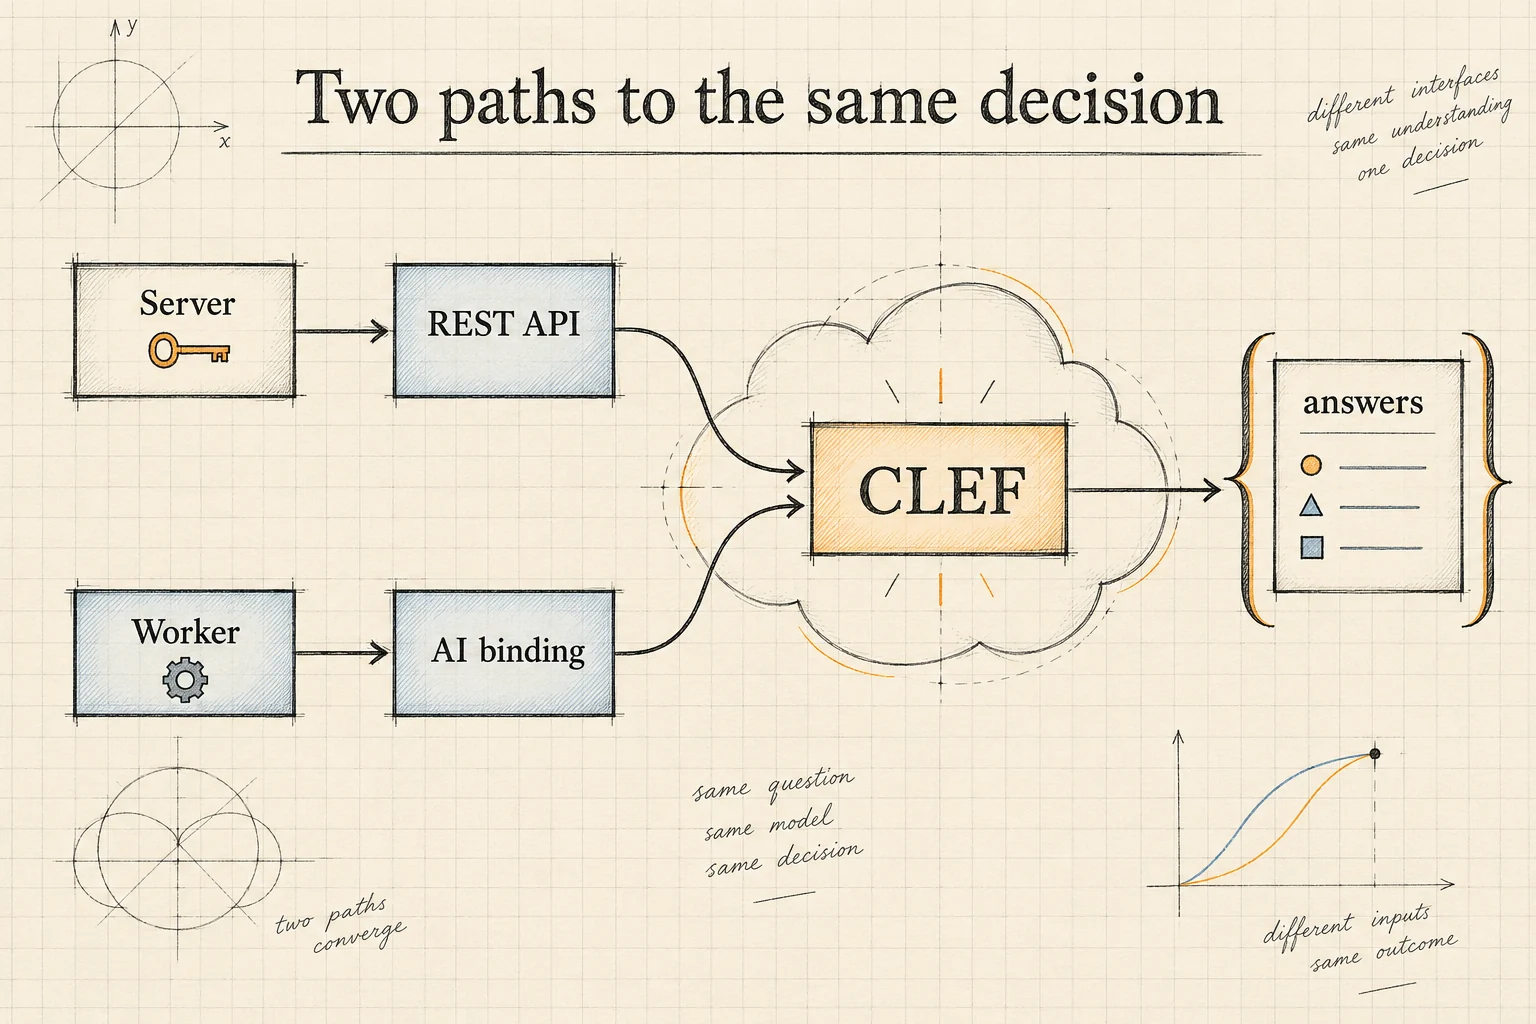
Besorgen Sie sich zunächst Ihre Cloudflare Account ID und ein Workers-AI-API-Token. Die Anleitung zur REST-Einrichtung von Cloudflare beschreibt die Tokenvorlage im Dashboard; manuell erstellte Tokens benötigen die Berechtigungen Workers AI Read und Edit. Speichern Sie die Zugangsdaten in Ihrer lokalen Umgebung oder im Geheimnisspeicher Ihres Servers.
Speichern Sie dieses eigenständige Beispiel als decision.json. Es stellt drei zusammenhängende Fragen zu einem Ticket:
{
  "model": "clef",
  "state": {
    "ticket": "I paid yesterday, but password resets still do not let me sign in.",
    "paymentStatus": "settled",
    "serviceHealth": "unknown"
  },
  "questions": {
    "owner": {
      "type": "choice",
      "instructions": "Choose the team for the primary unresolved issue.",
      "criteria": {
        "accounts": "Sign-in, credentials, or account access",
        "billing": "Unresolved charges, refunds, or payment disputes",
        "review": "Missing evidence or no matching team"
      }
    },
    "accessBlocked": {
      "type": "noul",
      "instructions": "Does the customer report being unable to sign in?"
    },
    "impact": {
      "type": "score",
      "instructions": "Rate the disruption supported by this ticket.",
      "criteria": [
        "No current disruption",
        "Partial disruption with a workaround",
        "Customer cannot access the service"
      ]
    }
  }
}
Senden Sie die Datei, nachdem Sie CLOUDFLARE_ACCOUNT_ID und CLOUDFLARE_API_TOKEN gesetzt haben:
curl --fail-with-body \
  "https://api.cloudflare.com/client/v4/accounts/${CLOUDFLARE_ACCOUNT_ID}/ai/run/@cf/cloudflare/clef" \
  -H "Authorization: Bearer ${CLOUDFLARE_API_TOKEN}" \
  -H "Content-Type: application/json" \
  --data-binary @decision.json
Die Modellangabe im Endpunkt und die Auswahl im Payload stimmen absichtlich überein: @cf/cloudflare/clef gehört zu "model": "clef". Beginnen Sie mit dieser kleinen Anfrage, damit sich Authentifizierungs- und Schemafehler leicht eingrenzen lassen.
Speichern Sie nach der ersten erfolgreichen Anfrage eine bereinigte Antwort als feste Beispieldatei für die Entwicklung. Halten Sie daneben die Schemaversion fest. Mit dieser Datei können Sie die Antwortverarbeitung prüfen, ohne bei jeder Änderung der Benutzeroberfläche eine kostenpflichtige Inferenzanfrage zu stellen.
Legen Sie für den produktiven Aufruf ein Zeitlimit fest, unterscheiden Sie eine fehlgeschlagene Inferenz von unsicheren Antworten und definieren Sie ein Ausweichziel. Wiederholen Sie vorübergehend fehlgeschlagene Anfragen nur innerhalb eines begrenzten Budgets. Ein erneuter Versuch sollte nicht dazu führen, dass die umgebende Anwendung dasselbe Supportticket zweimal erstellt.
Die Antwort richtig auswerten
Die REST-API verwendet die Antwortstruktur von Cloudflare. Prüfen Sie den HTTP-Status und success, bevor Sie unter result auf die Modellausgabe zugreifen. Eine Workers-AI-Bindung liefert die Modellausgabe direkt zurück.
Laut dem Ausgabeschema von Clef sind diese Pfade relevant:
| Wert | Pfad in der REST-Antwort | Pfad bei der Worker-Bindung |
|---|---|---|
| Ausgewähltes Team | result.answers.owner.choice |
answers.owner.choice |
| Wahrscheinlichkeiten der Teams | result.answers.owner.probabilities |
answers.owner.probabilities |
| Gemeldete Zugriffsblockade | result.answers.accessBlocked.noul |
answers.accessBlocked.noul |
| Erwartete Auswirkungsstufe | result.answers.impact.score |
answers.impact.score |
| Eingabeverbrauch | result.usage.input_tokens |
usage.input_tokens |
Eine noul-Antwort ist ein Objekt mit einem numerischen Feld namens noul, kein einfacher boolescher Wert. Antworten vom Typ choice und score enthalten außerdem confidence. Scores sind mit Wahrscheinlichkeiten gewichtete Stufenindizes und können zwischen den Stufen liegen.
Eine synthetische Verteilung der Auswirkungen von 0.10, 0.20 und 0.70 auf die Stufen 0, 1 und 2 ergibt beispielsweise 1.60. Dieser Wert ist weder eine Schweregradbezeichnung noch eine Risikoschätzung von 160 %. Ihre Regeln müssen ihn in die für Ihren Betrieb benötigte Bedeutung übersetzen.
Validieren Sie vor der Zuordnung die erwarteten Frage-IDs und Antworttypen. Behandeln Sie fehlende oder falsch strukturierte Felder als Integrationsfehler und protokollieren Sie diese getrennt von einer regulären Klassifizierung als review. Diese Unterscheidung hilft Ihnen zu entscheiden, ob Sie den Anwendungscode reparieren oder den Entscheidungsentwurf verbessern müssen.
Clef in einem Cloudflare Worker verwenden
Ergänzen Sie in einem bestehenden Worker-Projekt Ihre Wrangler-Konfiguration um eine AI-Bindung:
{
  "ai": {
    "binding": "AI"
  }
}
Kopieren Sie die zuvor erstellte Datei decision.json neben die Einstiegspunktdatei des Workers. Dieses JavaScript-Beispiel importiert die festen Eingabedaten und gibt eine Zuordnungsempfehlung zurück:
import decisionInput from "./decision.json";

export default {
  async fetch(_request, env) {
    try {
      const result = await env.AI.run(
        "@cf/cloudflare/clef",
        decisionInput
      );
      const owner = result.answers?.owner;
      const allowed = ["accounts", "billing", "review"];
      const probability = owner?.probabilities?.[owner.choice];

      if (
        owner?.type !== "choice" ||
        !allowed.includes(owner.choice) ||
        typeof probability !== "number" ||
        probability < 0 || probability > 1
      ) {
        throw new Error("Unexpected owner answer");
      }

      // Illustrative threshold: replace after evaluation.
      const route = probability >= 0.85 ? owner.choice : "review";
      return Response.json({ route, probability });
    } catch {
      return Response.json(
        { route: "review", error: "Decision unavailable" },
        { status: 503 }
      );
    }
  }
};
Die Anleitung zu Workers-Bindungen erklärt die Konfiguration und die lokale Entwicklung mit npx wrangler dev. Workers-AI-Inferenz verwendet auch während der lokalen Entwicklung Cloudflare-Ressourcen und kann Kosten verursachen.
Dieser Endpunkt mit festen Beispieldaten demonstriert die Bindung, den Zugriff auf die Antwort und das Ausweichverhalten. Für die Integration echter Tickets benötigen Sie die vorhandene Authentifizierung, Eingabevalidierung und Anfragebegrenzung Ihrer Anwendung. Erstellen Sie das vertrauenswürdige Fragenschema auf dem Server. Nehmen Sie Ticketinformationen über eine begrenzte Eingabestruktur entgegen, statt einen uneingeschränkten Inferenz-Proxy bereitzustellen.
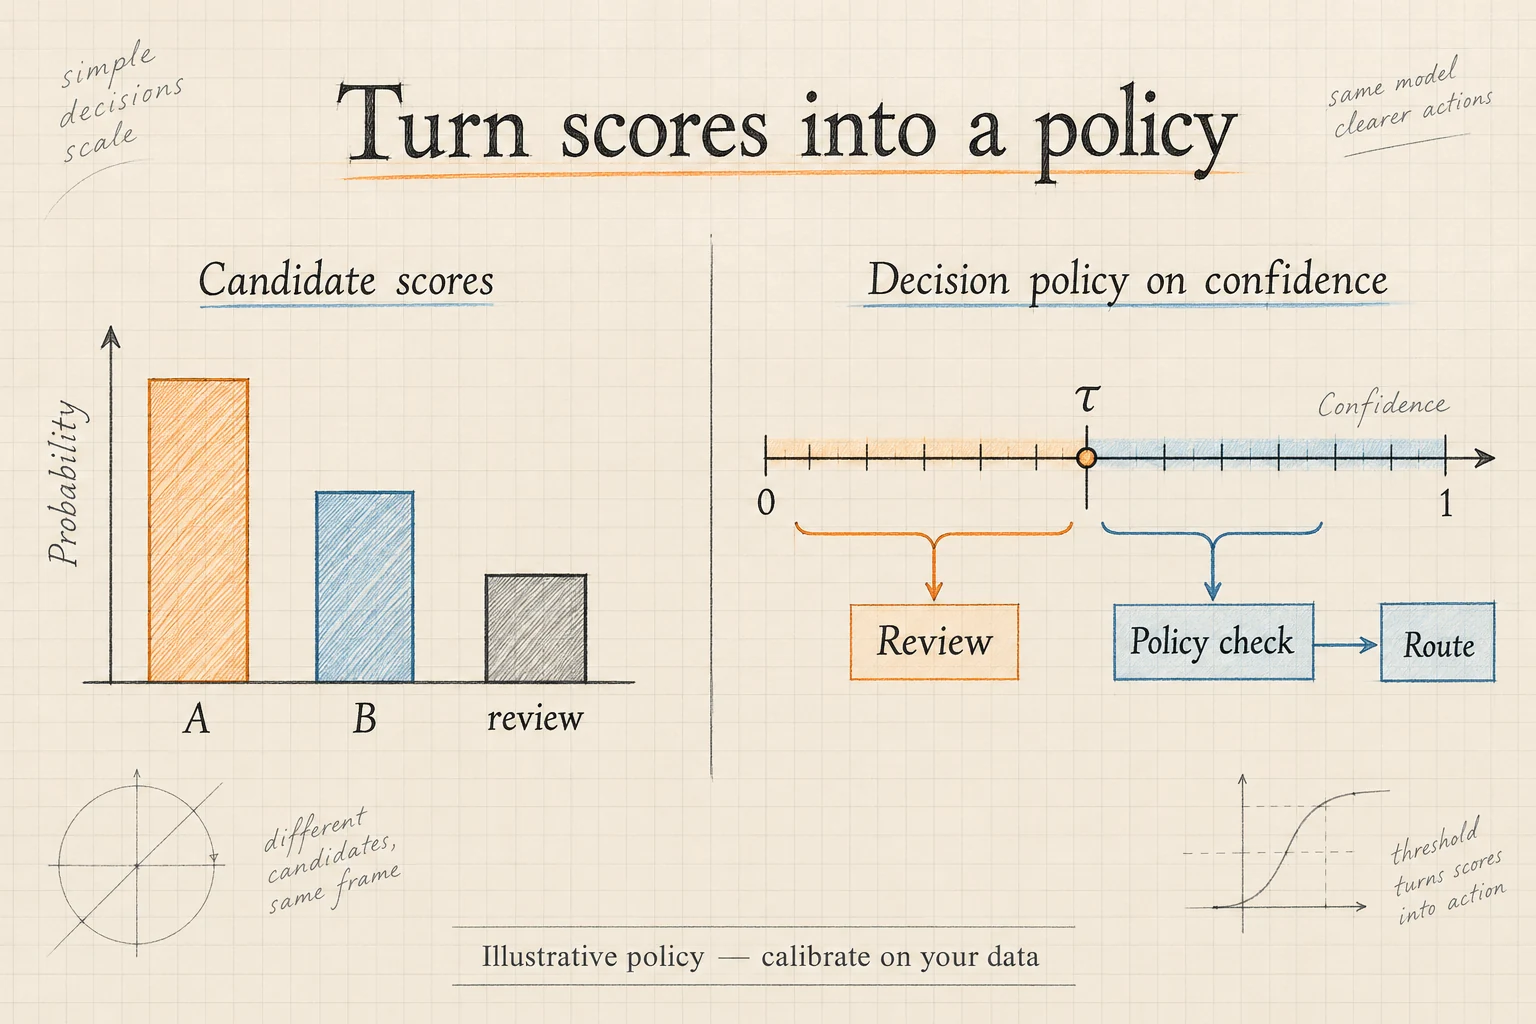
Der Grenzwert 0.85 zeigt, an welcher Stelle die Anwendungsregeln greifen. Er ist weder ein Clef-Standardwert noch eine experimentell bestätigte Empfehlung. Im nächsten Schritt ersetzen Sie ihn durch einen Schwellenwert, den Sie anhand Ihrer eigenen Evaluierung auswählen.
Schwellenwerte anhand eigener Daten festlegen
Eine hohe Wahrscheinlichkeit ist nur dann nützlich, wenn sie für Ihre tatsächlichen Fälle zuverlässige Ergebnisse vorhersagt. Interpretieren Sie das separate Feld confidence nicht als unabhängig bestätigte Erfolgsquote. Wählen Sie die Kennzahl aus, auf der Ihre Regeln beruhen sollen, dokumentieren Sie sie und bewerten Sie genau diese Regeln.
Beginnen Sie bei der Zuordnung zu Warteschlangen mit der Wahrscheinlichkeit der ausgewählten Option. Sie können außerdem den Abstand zwischen der höchsten und der zweithöchsten Wahrscheinlichkeit untersuchen. Ein knappes Ergebnis zwischen Kontozugriff und Abrechnung kann auf tatsächlich gemischte Anliegen hindeuten; es kann aber auch schlecht voneinander abgegrenzte Kategorien offenlegen.
Erstellen Sie einen beschrifteten Validierungsdatensatz und vergleichen Sie mehrere mögliche Schwellenwerte. Messen Sie für jeden davon die Zuordnungsgenauigkeit bei automatisch bearbeiteten Tickets und den Anteil der Tickets, die zur Prüfung weitergeleitet werden. Ein höherer Schwellenwert verringert üblicherweise die Abdeckung zugunsten strengerer Auswahl. Welcher Betriebspunkt sinnvoll ist, hängt jedoch von Ihren Daten und den Kosten von Fehlern ab.
Betrachten Sie einen synthetischen Validierungsdatensatz mit 1.000 Tickets. Ein Schwellenwert ordnet 800 Tickets automatisch zu, davon 720 korrekt: 80 % Abdeckung und 90 % Genauigkeit bei den zugeordneten Fällen. Ein strengerer Schwellenwert ordnet 500 Tickets zu, davon 480 korrekt: 50 % Abdeckung und 96 % Zuordnungsgenauigkeit. Keine dieser Regeln ist grundsätzlich besser. Vergleichen Sie die Kosten zusätzlicher Prüfungen mit den Kosten einer Weiterleitung an das falsche Team. Untersuchen Sie auch, welche Kategorien bei steigendem Schwellenwert aus der automatischen Bearbeitung verschwinden. Eine Verbesserung des Gesamtergebnisses kann ungleichmäßige Servicequalität verdecken.
Gruppieren Sie für die Kalibrierung Vorhersagen in Wahrscheinlichkeitsbereiche und vergleichen Sie die vorhergesagte Wahrscheinlichkeit mit der tatsächlich beobachteten Korrektheit. Wenn Vorhersagen um 0,90 nur in 70 % der Fälle richtig sind, sind die Wahrscheinlichkeitswerte auf dieser Stichprobe zu selbstsicher. Halten Sie die Kalibrierung von der abschließenden Bewertung auf dem zurückgehaltenen Testdatensatz getrennt.
Verwenden Sie unterschiedliche Regeln für unterschiedliche Aktionen. Die falsche Zuordnung eines Tickets und die Änderung von Zugangsdaten haben unterschiedliche Folgen. Unser Workflow zur Prompt-Sicherheit behandelt Entscheidungsprüfungen, die ausdrückliche Ausführungskontrollen ergänzen können.
Bilder hinzufügen und Self-Hosting verstehen
Ergänzen Sie für gehostete visuelle Entscheidungen das Feld images in der Anfrage. Verwenden Sie eingebettete Daten-URLs oder Objekte mit content_type und base64. Die gehostete Eingabedefinition akzeptiert PNG, JPEG und WebP; gewöhnliche externe Bild-URLs werden nicht akzeptiert. Sie legt maximal vier Bilder, 4 MiB und 16 Megapixel pro Bild, insgesamt 8 MiB dekodierte Bilddaten sowie eine Obergrenze von 13 MiB für den Anfragekörper fest.
Eine praktische Einstiegsaufgabe ist die Entscheidung, ob ein Screenshot sichtbar einen Anmeldefehler enthält. Kombinieren Sie das Bild mit einer gezielten Frage und relevantem Kontext. Wenn Ihre Anwendung exakt extrahierte Zahlen benötigt, überprüfen Sie die Extraktion, bevor Sie Rechenregeln anwenden.
Die Modellkarte auf Hugging Face beschreibt einen anderen Ausführungsweg: Laden Sie die Veröffentlichung herunter, laden Sie ihr Backbone und den gemeinsamen Schema-Head und verwenden Sie die bereitgestellten Hilfsfunktionen aus joint_schema_model. Die Beispiele nutzen load_release_model und systemone. Die Veröffentlichung steht unter der Apache-2.0-Lizenz; die dokumentierte Testumgebung verwendet eine einzelne H200 mit PyTorch 2.11 und Transformers 5.10.2.
Die lokalen Hilfsfunktionen beschreiben auch PIL-Bilder und Arrays mit Videoframes. Daraus lässt sich keine Unterstützung gehosteter Videoanfragen ableiten: Das aktuelle gehostete Schema dokumentiert Bilder, aber kein Videofeld in der Anfrage. Das standardmäßige Kodierungslimit der Hilfsfunktionen beträgt 16.384 Tokens und unterscheidet sich vom gehosteten Kontextfenster. Prüfen Sie die Konfiguration für Ihre Bereitstellung.
Wählen Sie Self-Hosting, wenn die Kontrolle über die Bereitstellungsumgebung den Betriebsaufwand rechtfertigt. Planen Sie GPU-Speicher, Stapelverarbeitung, Überwachung und Aktualisierungen ein. Für eine erste Integration reduziert die gehostete API die Anzahl der Systeme, die Sie gleichzeitig untersuchen müssen.
Die Kosten von Cloudflare Clef abschätzen
Die Workers-AI-Preistabelle nennt für Clef 0,24 US-Dollar pro Million Eingabetokens und für Clef-flash 0,09 US-Dollar pro Million Eingabetokens, geprüft am 3. Oktober 2026.
Bei einer beispielhaften Arbeitslast von 100.000 Anfragen mit durchschnittlich 1.200 Eingabetokens ergeben sich insgesamt 120 Millionen Eingabetokens. Mit den angegebenen Preisen ergibt das 28,80 US-Dollar für Clef beziehungsweise 10,80 US-Dollar für Clef-flash. Diese Berechnungen umfassen die Kosten der Modelleingabe vor Freibeträgen und weiteren Plattformkosten; sie sind keine vollständige Schätzung Ihrer Monatsrechnung.
Ersetzen Sie den angenommenen Durchschnitt durch gemeldete Verbrauchsdaten repräsentativer Anfragen. Lange Ticketverläufe, detaillierte Bewertungsvorgaben, Wiederholungsversuche und visuelle Eingaben können die Arbeitslast verändern. Erfassen Sie auch den Aufwand menschlicher Prüfungen: Günstigere Inferenz bedeutet nicht zwangsläufig einen günstigeren Workflow, wenn dadurch mehr manuelle Arbeit entsteht.
Vergleichen Sie Modelle anhand identischer beschrifteter Fälle mit denselben Akzeptanzregeln. Um Clef-flash auszuprobieren, ändern Sie sowohl die Endpunktkennung in @cf/cloudflare/clef-flash als auch die Modellauswahl im Anfragekörper in "model": "clef-flash". Erfassen Sie neben den Kosten auch Latenz und Qualität, statt ausschließlich anhand des Tokenpreises zu entscheiden.
Häufige Integrationsfehler beheben
Die meisten anfänglichen Fehler gehören zu einer von vier Kategorien:
| Symptom | Zuerst prüfen |
|---|---|
| Authentifizierung fehlgeschlagen | Account ID, Tokenberechtigungen und Laden der Umgebungsvariablen |
| Anfragevalidierung fehlgeschlagen | Erforderliche Anweisungen, Struktur der Kriterien und Modellauswahl |
| JavaScript liest undefinierte Antworten | REST-Antwortstruktur im Vergleich zur direkten Bindungsausgabe |
| Plausible, aber ungeeignete Entscheidungen | Qualität der Informationen, überlappende Optionen und fehlende Prüfungsroute |
Senden Sie keine messages-Struktur im Chatformat, nur weil ein anderes Workers-AI-Modell sie akzeptiert. Verwenden Sie die dokumentierte Entscheidungsschnittstelle von Clef. Vermeiden Sie ebenso, answers.owner als Zeichenfolge zu interpretieren oder eine Erklärung in Prosa in einem Chat-Completion-Feld zu erwarten.
Wählen Sie bei langen Datensätzen relevante Informationen bewusst aus. Die Seite zum gehosteten Modell nennt ein Kontextfenster von 65.536 Tokens und weist darauf hin, dass lange Textinhalte in state gekürzt werden. Stellen Sie sicher, dass die für die Entscheidung notwendigen Fakten erhalten bleiben, bevor Sie diese Grenze erreichen.
Wenn Vorhersagen falsch erscheinen, untersuchen Sie einen Fall vollständig: die genau übermittelten Informationen, die Schemaversion, die vollständige Verteilung und die abschließende Anwendungsregel. Wenn Sie zuerst das Modell ändern, bleibt der ursprüngliche Daten- oder Regelfehler möglicherweise bestehen.
Den Workflow bewerten und einführen
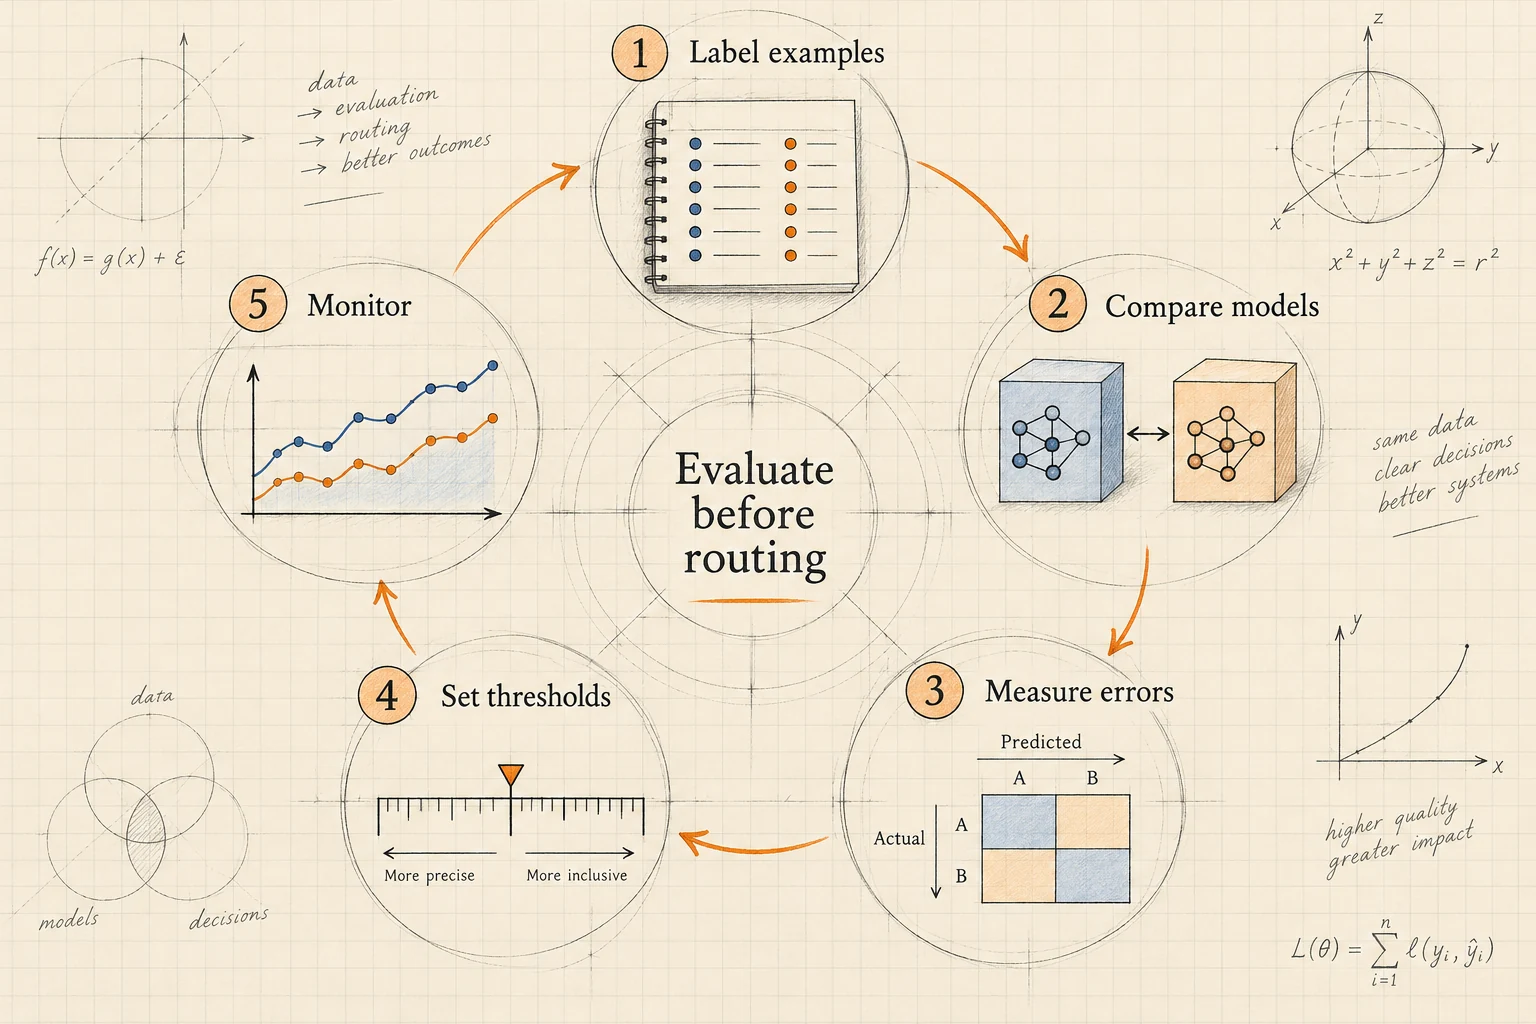
Beginnen Sie mit historischen Tickets, die die erwarteten Zuordnungen, Sprachen und Muster fehlender Informationen widerspiegeln. Kennzeichnen Sie das wichtigste ungelöste Problem unabhängig von der Modellausgabe. Klären Sie Meinungsverschiedenheiten zwischen Prüfenden, bevor Sie diese Kennzeichnungen als verlässliche Referenz verwenden.
Teilen Sie die Sammlung in Entwicklungs-, Validierungs- und zurückgehaltene Testdatensätze auf. Verwenden Sie Entwicklungsfälle, um das Schema zu verbessern, Validierungsfälle, um Schwellenwerte festzulegen, und den zurückgehaltenen Testdatensatz für die abschließende Freigabeentscheidung. Verteilen Sie keine nahezu identischen Tickets aus derselben Unterhaltung auf verschiedene Datensätze.
Erfassen Sie mindestens die Zuordnungskorrektheit, den Prüfungsanteil, Fehler je Zuordnungsziel, die Antwortlatenz, Inferenzfehler und die Kosten pro akzeptierter Entscheidung. Untersuchen Sie seltene Zuordnungen separat. Ein hoher Gesamtdurchschnitt kann wiederkehrende Fehler in einer kleinen, aber wichtigen Kategorie verbergen.
Führen Sie ein kleines Fehlerprotokoll mit einer Ursache für jeden überprüften Fehler: fehlende Informationen, mehrdeutige Bewertungsvorgaben, Modellfehler oder Fehler in den Anwendungsregeln. Aus diesen Kategorien ergeben sich unterschiedliche Korrekturen. Nehmen Sie den korrigierten Fall in eine Sammlung für Regressionstests auf, passen Sie Ihre Lösung aber nicht wiederholt an den abschließenden zurückgehaltenen Testdatensatz an. Ein einfacher deterministischer Vergleichsansatz ist ebenfalls wertvoll: Er zeigt Ihnen, ob der neue Inferenzschritt den Workflow ausreichend verbessert, um seine Komplexität zu rechtfertigen.
Führen Sie vor der automatischen Zuordnung einen Schattenbetrieb durch: Protokollieren Sie, was Clef auswählen würde, während die bestehenden Abläufe weiterlaufen. Vergleichen Sie diese Empfehlungen mit den tatsächlichen Ergebnissen. Aktivieren Sie anschließend die automatische Verarbeitung für einen kleinen, reversibel umstellbaren Anteil der Anfragen und halten Sie eine sofort verfügbare Ausweichlösung bereit.
Speichern Sie mit jedem Ergebnis die Modellkennung, die Schemaversion, die Entscheidungsregeln und die Herkunft der Eingaben. Prüfen Sie auf Veränderungen der Datenverteilung, wenn sich Produkte, Supportkategorien oder die Sprache der Kunden ändern. Die Jev-Dokumentationsübersicht bietet verwandte Inhalte für Anwendungen, die auf typisierten Entscheidungen aufbauen.
Häufig gestellte Fragen
Kann ich Cloudflare Clef ohne Bereitstellung eines Workers verwenden?
Ja. Verwenden Sie den kontobezogenen REST-Endpunkt mit einem Workers-AI-Token. Ein Worker ist hilfreich, wenn der Entscheidungsaufruf direkt bei der Anfrageverarbeitung und den Anwendungsregeln stattfinden soll.
Sollte ich choice oder mehrere noul-Fragen verwenden?
Verwenden Sie choice, wenn die Anwendung ein Ziel aus konkurrierenden Optionen auswählen muss. Verwenden Sie separate noul-Fragen, wenn mehrere unabhängige Bedingungen gleichzeitig wahr sein können. Definieren Sie vor der Interpretation der Ergebnisse, ob sich diese Bedingungen überschneiden dürfen.
Ist Clef ein Ersatz für ein Chatmodell?
Verwenden Sie es für Entscheidungen mit vorgegebenen Antworten. Wenn der nächste Schritt das Verfassen einer E-Mail ist, kombinieren Sie die ausgewählte Zuordnung und den überprüften Kontext mit einem geeigneten Generierungsworkflow. Dessen Ausgabe sollte denselben Anwendungsregeln unterliegen.
Bedeutet ein hoher Score, dass das Modell sicher ist?
Nein. Ein hoher Auswirkungs-Score bedeutet, dass die Wahrscheinlichkeitsmasse höhere Stufen der Bewertungsskala bevorzugt. Konfidenz beschreibt eine andere Eigenschaft der Verteilung. Prüfen Sie die tatsächlichen Wahrscheinlichkeiten und bewerten Sie genau die Kennzahl, die Ihre Aktion steuert.
Was sollte ich zuerst umsetzen?
Implementieren Sie eine Entscheidung, eine ausdrückliche Ausweichlösung und einen kleinen beschrifteten Evaluierungsdatensatz. Sobald Sie Fehler erklären und eine akzeptable Abdeckung messen können, erweitern Sie das Schema oder ergänzen einen weiteren Workflow.