Produkt & Konzepte
Was ist Jev AI? Ein praktischer Leitfaden zu System One und ausführbaren Entscheidungen
Jev AI ist ein Entscheidungsmodell für Software: Übermitteln Sie den Geschäftskontext und typisierte Fragen und erhalten Sie strukturierte Ergebnisse, Wahrscheinlichkeiten und Konfidenzsignale für Klassifizierung, Weiterleitung, Bewertung und Sicherheitsprüfungen.
Was ist Jev AI? Ein praktischer Leitfaden zu System One und ausführbaren Entscheidungen
Wenn Sie einem Agenten, Supportsystem, Workflow oder SaaS-Produkt KI hinzufügen, ist die schwierigste Aufgabe oft nicht, ein Modell um einen Absatz zu bitten. Schwieriger ist es, kleine Entscheidungen über viele Anfragen hinweg konsistent zu treffen: Welches Team soll dieses Ticket erhalten? Benötigt diese Aktion eine menschliche Freigabe? Wie dringend ist die Aufgabe? Welches Modell oder Tool soll als Nächstes laufen?
Jev AI wurde dafür entwickelt, solche Bewertungen in strukturierte Entscheidungen umzuwandeln, die Software direkt verarbeiten kann. Die Jev-AI-Website positioniert Jev als Entscheidungswerkzeug für Softwareteams. In der offiziellen TypeSafe-Dokumentation wird es als Flaggschiffmodell und erstes System-One-Modell beschrieben: Sie übermitteln State und typisierte Fragen und erhalten anschließend Auswahlmöglichkeiten, Bewertungen, Ja/Nein-Urteile und Wahrscheinlichkeitssignale.
Dieser Leitfaden erklärt, was Jev AI ist, wie es funktioniert, wo es neben generativen LLMs sinnvoll ist, wie Sie die API anbinden und welche Einschränkungen die Planung für den Produktiveinsatz beeinflussen sollten.
Kurz gesagt: Jev AI ersetzt nicht jedes dialogorientierte KI-System. Es ist eine Entscheidungsebene innerhalb Ihrer Anwendung für schnelle, wiederholbare Klassifizierung, Weiterleitung, Bewertung und Sicherheitsprüfungen in einem definierten Antwortbereich.
Inhaltsverzeichnis
- Was ist Jev AI?
- Wie Jev AI funktioniert
- Die drei Fragetypen
- Warum ein LLM nicht einfach nach JSON fragen?
- Wo Jev AI sinnvoll ist
- Erste Schritte
- Wahrscheinlichkeit, Konfidenz und Grenzen
- Preise von Jev AI
- Häufig gestellte Fragen
Was ist Jev AI?
Ein System-One-Modell für Software
Große Sprachmodelle sind in erster Linie darauf ausgelegt, Texte für Menschen zu erzeugen. Wenn Software ein eng umrissenes Urteil benötigt, ergänzen Entwickler oft drei Schritte: Sie beschreiben das Ausgabeformat in einem Prompt, parsen eine natürlichsprachliche oder JSON-Antwort und entscheiden anschließend, ob eine Aktion ausgeführt wird. Das ist flexibel, bringt aber Formatierungsfehler, zusätzliche Texte und Unsicherheit in die Anwendungsschicht.
Jev AI bietet eine andere Schnittstelle:
- State: Senden Sie ein Ticket, eine Nachricht, Formularfelder oder ein JSON-Objekt als Entscheidungskontext.
- Typisierte Fragen: Legen Sie genau fest, welche Art von Urteil die Anwendung benötigt.
- Strukturiertes Ergebnis: Erhalten Sie ein Resultat, anhand dessen Code verzweigen, sortieren, weiterleiten oder Daten speichern kann.
Informationen zur Produktpositionierung finden Sie auf der Jev-AI-Startseite. Die offizielle TypeSafe-Einführung erläutert das System-One-Modell und seine Grundbausteine.
Jev AI im Vergleich zu generativen LLMs
Jev AI und generative LLMs sind nicht einfach konkurrierende Varianten desselben Produkts. Sie eignen sich für unterschiedliche Aufgaben: LLMs sind stark bei offenen Texten, Erklärungen und kreativen Arbeiten; Jev ist für wiederholte, begrenzte Entscheidungen gedacht, auf die Software reagieren muss.
| Dimension | Jev AI | Generatives LLM | Regelbasierter Code |
|---|---|---|---|
| Hauptausgabe | Auswahl, Bewertungen, Ja/Nein-Urteile, Wahrscheinlichkeiten und Konfidenz | Text, Code oder offene strukturierte Inhalte | Deterministische Werte aus expliziten Bedingungen |
| Besonders geeignet für | Klassifizierung, Weiterleitung, Priorität, Risikoprüfung, Tool-Freigabe | Schreiben, Zusammenfassen, Fragen und Antworten, komplexes Schlussfolgern | Stabile Bedingungen ohne semantische Interpretation |
| Schnittstelle | State + typisierte Fragen | Prompt + Kontext | If/else, Regel-Engine oder Abfrage |
| Unsicherheit | Durch Wahrscheinlichkeits- und Konfidenzsignale sichtbar | Erfordert meist benutzerdefinierte Validierung | In der Regel keine Modellwahrscheinlichkeit |
| Rolle im System | Entscheidungsebene in der Anwendungslogik | Zentrum für Generierung oder Schlussfolgerungen | Deterministische Ausführungsebene |
Jev legt Ihre Geschäftsrichtlinien nicht fest. Ihr Team bestimmt weiterhin den Antwortbereich, die Bewertungsrubrik, die Schwellenwerte und das Verfahren zur menschlichen Prüfung.
Wie Jev AI funktioniert
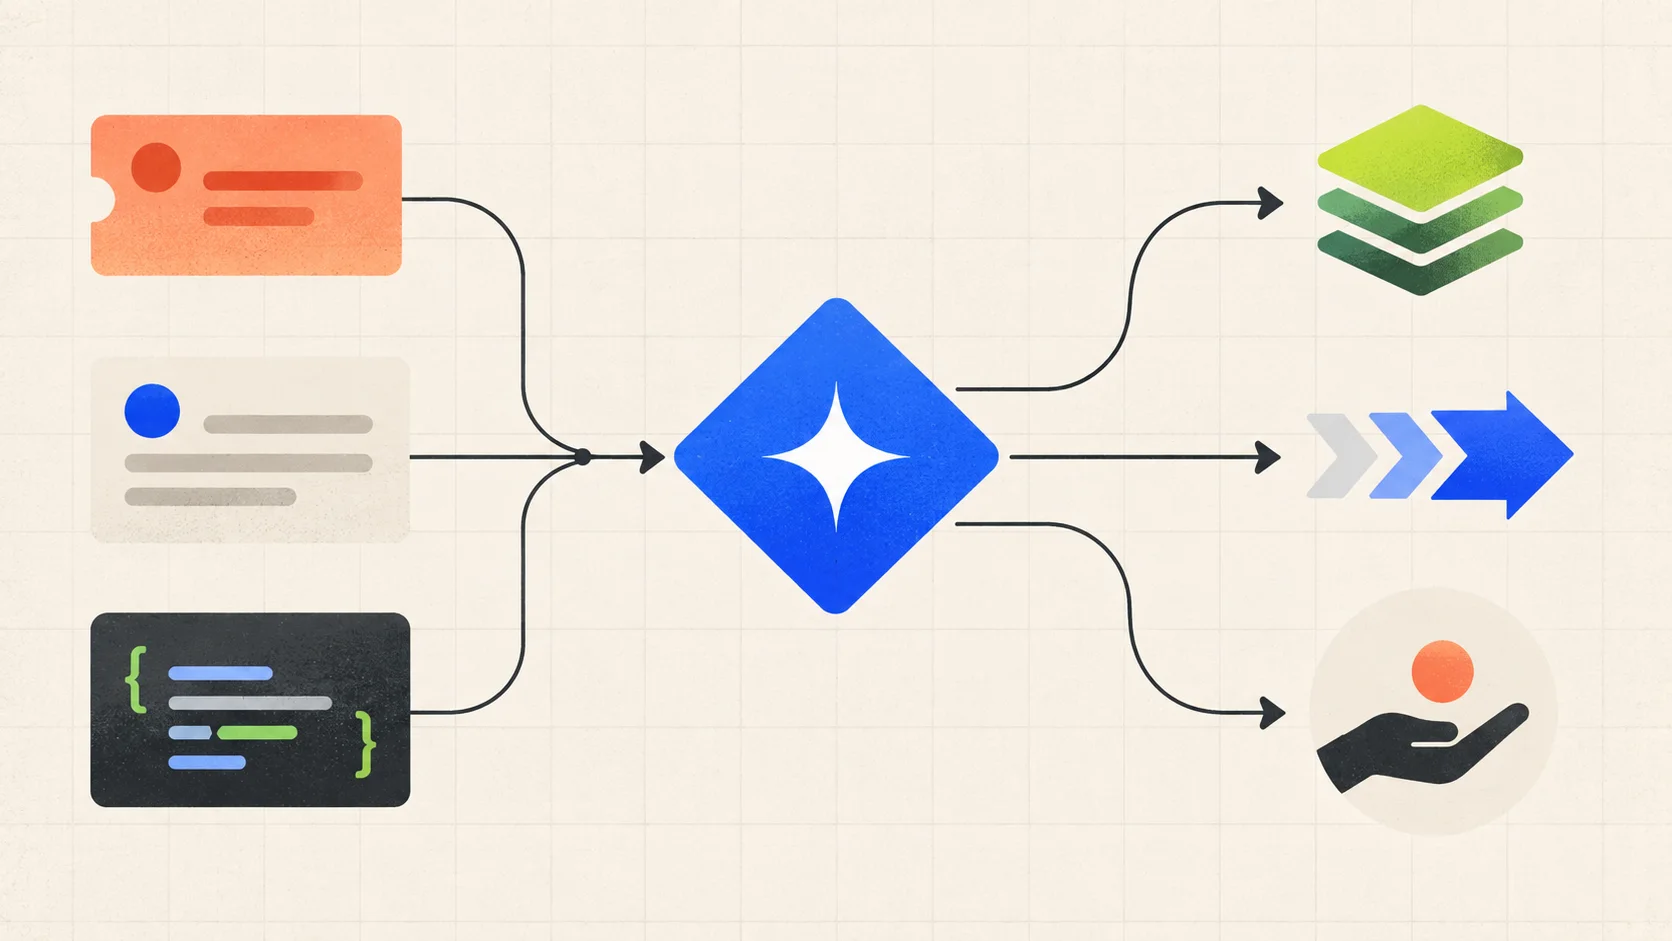
Bild: Mehrere kleine Fragen können denselben State auswerten; der Anwendungscode entscheidet, was als Nächstes geschieht.
Der in der offiziellen Dokumentation beschriebene Workflow lässt sich in vier Schritte gliedern.
1. State vorbereiten
State ist der Kontext, den alle Fragen auswerten. Er kann Folgendes sein:
- ein natürlichsprachlicher String wie eine Supportnachricht, Warnung oder Nutzermeldung;
- ein JSON-Objekt mit einem Ticket, einer Bestellung, einer Nutzerstufe und Richtlinienfeldern;
- ein Textarray mit zusammengehörigen Nachrichten oder abgerufenen Ausschnitten.
Fragen sollten sich normalerweise auf einen gemeinsamen State beziehen, statt einen ganzen Geschäftsprozess in einen übergroßen Prompt zu packen. Laut aktueller Dokumentation akzeptiert Jev Texte, JSON-Objekte und Textarrays; Bilder, Audio und Video werden derzeit nicht direkt unterstützt.
2. Typisierte Fragen festlegen
Jede Frage sollte ein bestimmtes Urteil abdecken. Fragen Sie nicht: „Sollen wir diesen Kunden halten und welches Team soll nachfassen?“ Teilen Sie das auf in „Welches Team soll sich darum kümmern?“ und „Ist ein Kundenbindungs-Workflow erforderlich?“ Kleinere Fragen lassen sich einfacher testen und im Code kombinieren.
3. Die strukturierte Antwort lesen
Jev gibt Antworten anhand der von Ihnen gesendeten Fragen-IDs zurück. Die Felder hängen vom Fragetyp ab: Choice kann eine ausgewählte Option, Wahrscheinlichkeiten und Konfidenz liefern; Score kann eine Bewertung, Legende, Wahrscheinlichkeiten und Konfidenz ausgeben; Noul liefert eine Ja-Wahrscheinlichkeit.
Antworten können auch Laufzeitinformationen wie usage und elapsedMs enthalten. elapsedMs bezeichnet die Ende-zu-Ende-Anfragezeit und nicht unbedingt die reine Inferenzzeit des Modells.
4. Den nächsten Schritt dem Code überlassen
Das Modell trifft das Urteil, Ihre Anwendung führt die Aktion aus. Der Code kann route(), queue(), block(), request_review() oder ein anderes LLM aufrufen. So bleiben Schwellenwerte, Berechtigungen, Audit-Protokolle und Rückfallpfade für Hochrisikofälle unter der Kontrolle Ihrer Anwendung.
Den vollständigen Ablauf können Sie im Jev-AI-Playground mit einem realistischen, aber risikoarmen Geschäftskontext ausprobieren.
Die drei Fragetypen
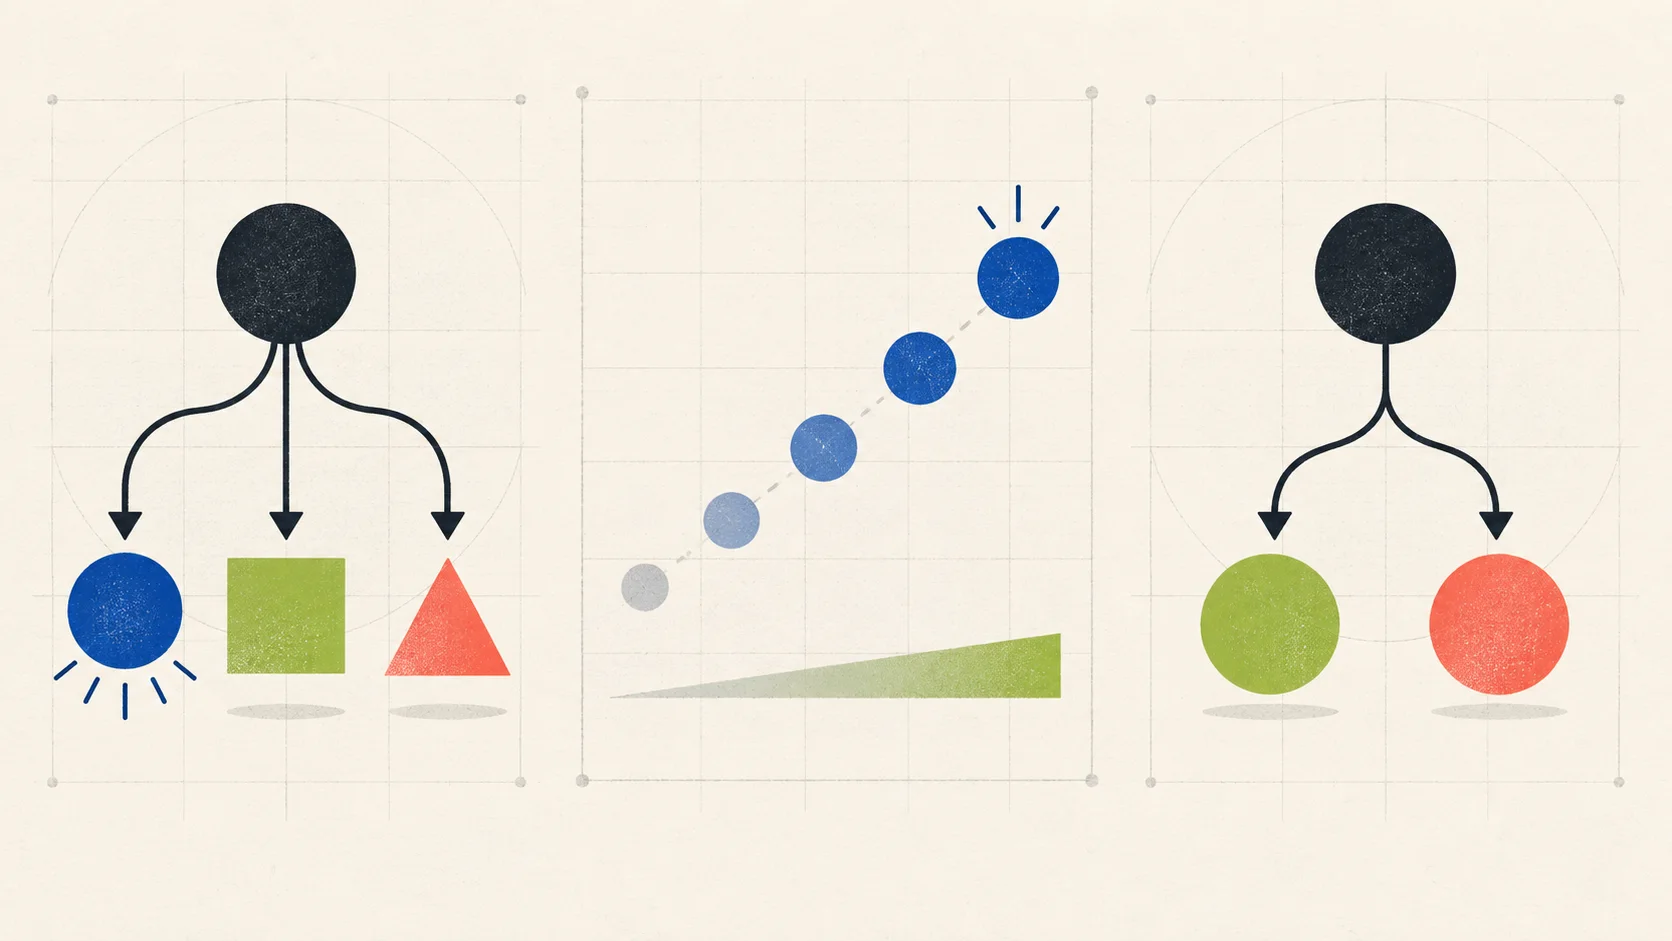
Bild: Die drei Grundbausteine stehen für Auswahl, Bewertung und die Prüfung, ob eine Aussage wahr ist.
Choice: aus einer festgelegten Auswahl wählen
Choice ist für Klassifizierung und Weiterleitung vorgesehen. Beispiele:
- Soll diese Supportanfrage an die Abrechnung, den technischen Support oder ein anderes Team gehen?
- Handelt es sich bei diesem Inhalt um ein Tutorial, ein Produktupdate oder eine Kundengeschichte?
- Soll die Anfrage ein schnelles Modell, ein leistungsfähigeres Modell oder einen menschlichen Workflow nutzen?
Definieren Sie die Optionen und ihre Beschreibungen im Voraus. Wenn unbekannte Fälle möglich sind, behalten Sie eine Option wie other oder none-of-the-above bei, damit das Modell nicht zu einer schlechten Zuordnung gezwungen wird.
Score: anhand einer geordneten Rubrik bewerten
Score eignet sich für Schweregrad, Zufriedenheit, Priorität und Risikostufen. Sie können Stufen von „keine Aktion erforderlich“ bis „sofort eskalieren“ definieren und mit dem wahrscheinlichkeitsgewichteten Ergebnis von Jev eine Warteschlange sortieren.
Die Bewertungsrubrik sollte konkret sein. Beschreiben Sie für jede Stufe nicht nur, dass die Dringlichkeit bewertet werden soll, sondern auch die zeitlichen Anforderungen, die Auswirkungen auf Kunden und die betrieblichen Folgen. Dadurch wird die Bewertung für SLAs und Priorisierungslogik nützlicher.
Noul: prüfen, ob eine Aussage wahr ist
Noul eignet sich für binäre Urteile wie „Bittet der Kunde ausdrücklich um eine Rückerstattung?“ oder „Soll dieser Tool-Aufruf eine menschliche Bestätigung erfordern?“ Es liefert eine Ja-Wahrscheinlichkeit zwischen 0 und 1 und kein zweites Konfidenzfeld.
Wenn eine Schlussfolgerung mehrere unabhängige Bedingungen enthält, teilen Sie sie in mehrere Noul-Fragen auf und kombinieren Sie die Ergebnisse im Code. Das lässt sich besser bewerten, als eine einzige Frage gleichzeitig Fakten, Risiko und Aktion behandeln zu lassen.
Aktuelle Felder und Beispiele finden Sie in der Jev-AI-Fragedokumentation und der TypeSafe-API-Dokumentation.
Warum ein LLM nicht einfach nach JSON fragen?
Ein LLM um JSON zu bitten, ist weiterhin ein nützliches Entwicklungsmuster. Jev AI bietet zusätzlichen Nutzen, wenn die Entscheidung selbst eine bekannte Form hat und zuverlässig wiederholt werden muss.
Die Antwortgrenze ist explizit
Choice, Score und Noul stehen für unterschiedliche Entscheidungssemantiken. Entwickler definieren zuerst den Antwortbereich, sodass die Anwendungslogik keine Absicht aus einem Absatz ableiten muss.
Ein State kann mehrere Fragen unterstützen
Ein Support-Ticket kann in derselben Anfrage nach zuständiger Abteilung, Dringlichkeit und Rückerstattungsabsicht ausgewertet werden. Laut offizieller Dokumentation werden mehrere Fragen parallel anhand desselben State bewertet. So sind keine aufeinanderfolgenden Einzelaufrufe nötig, nur um eine Entscheidung aufzuteilen.
Wahrscheinlichkeitssignale können in den Kontrollfluss einfließen
Ist das Ergebnis eindeutig genug, kann der Code automatisch weiterleiten. Liegt es nahe am Schwellenwert oder ist die Aktion riskant, kann das System eine menschliche Prüfung anfordern, weitere Informationen einholen oder ein leistungsfähigeres Modell aufrufen. Der Automatisierungsgrad kann sich so nach dem Signal richten, statt jede Ausgabe gleich sicher zu behandeln.
Richtlinien bleiben im Code
Jev beantwortet eine definierte Frage zum aktuellen State. Ihre Anwendung bleibt für Schwellenwerte, Berechtigungen, Wiederholungsversuche, Audit-Trails und die endgültige Aktion zuständig. Ändern sich Richtlinien, können Sie die Fragendefinition oder den Code aktualisieren, statt einen riesigen dialogorientierten Prompt neu aufzubauen.
Jev ist nicht für jede Aufgabe gedacht. Offene Recherche, ausführliche Erklärungen und kreative Textgenerierung gehören weiterhin zu einem generativen Modell oder einer Person.
Wo Jev AI sinnvoll ist
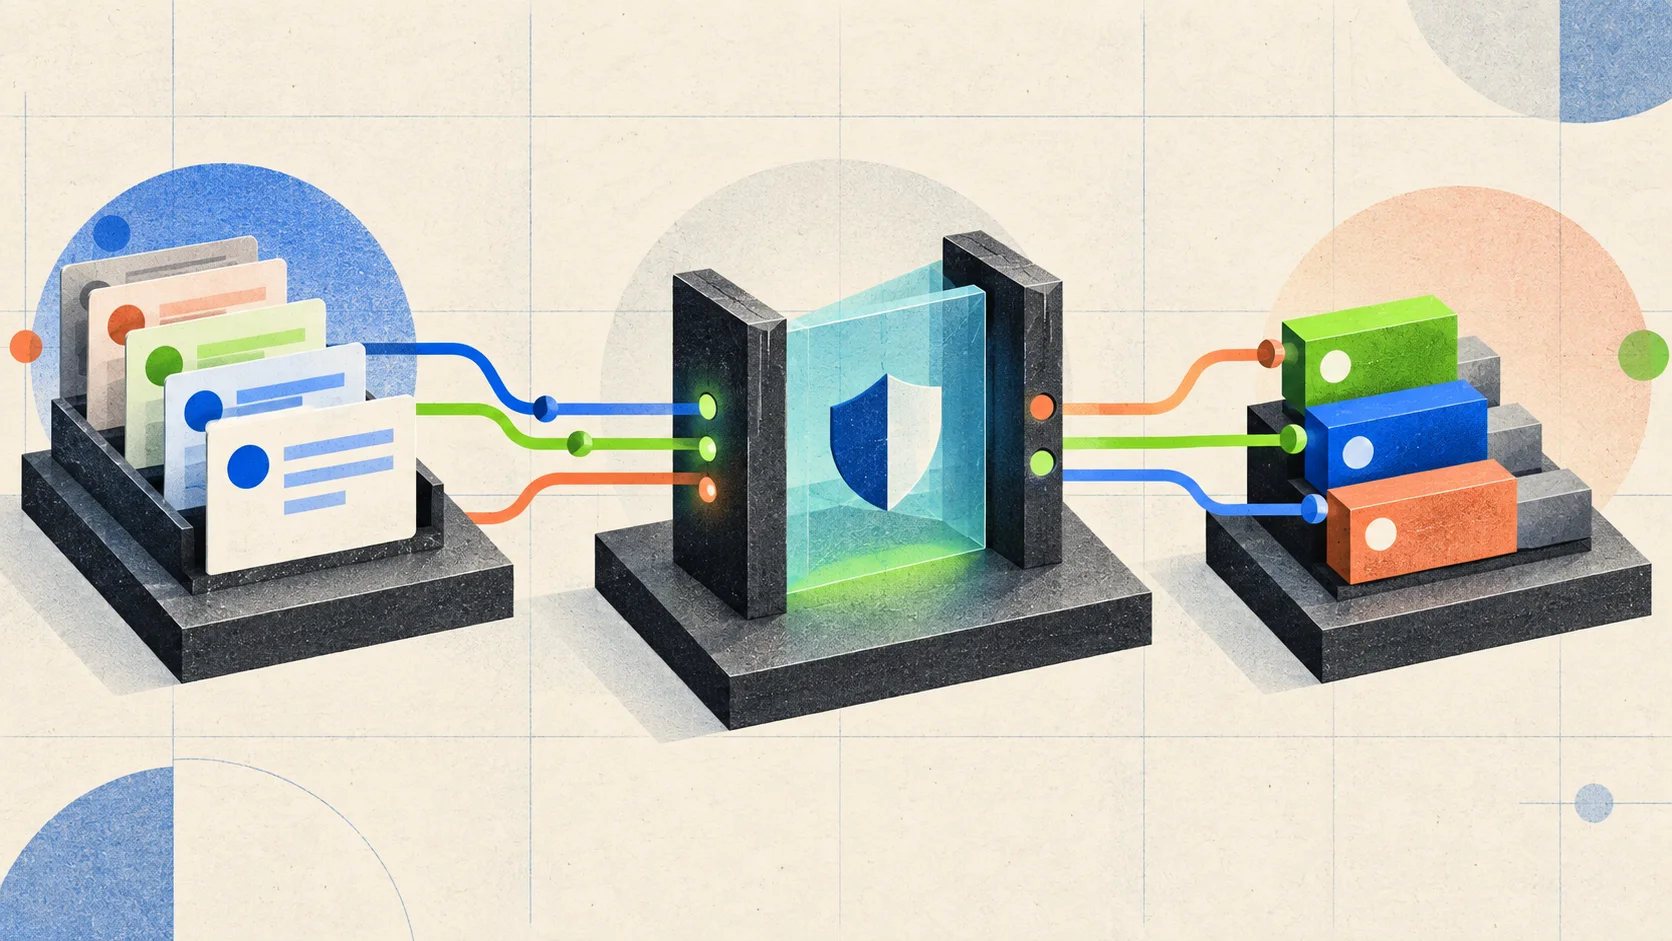
Bild: Jev kann als Entscheidungsknoten zwischen Eingabe, Schutzmaßnahmen und Ausführungswarteschlangen dienen.
Support-Tickets klassifizieren und weiterleiten
Nutzen Sie den Tickettext, die Kundenstufe und den relevanten Verlauf als State. Verwenden Sie Choice zur Teamwahl und Score zur Einschätzung der Dringlichkeit. Anschließend kann die Warteschlange nach Team, Bewertung und Wahrscheinlichkeit sortiert werden, während Fälle mit niedriger Konfidenz zur menschlichen Prüfung gehen.
Modelle für KI-Agenten auswählen
Klassifizieren Sie Aufgabenschwierigkeit, Tool-Bedarf und Risiko, bevor Sie ein schnelles Modell, ein leistungsfähigeres Modell oder einen menschlichen Workflow wählen. Jev bestimmt den Pfad; die Agenten-Orchestrierung verwaltet weiterhin Modellaufrufe, Kontext und Tools.
Tool-Aufrufe auf Sicherheit prüfen
Prüfen Sie vor dem Löschen von Daten, dem Belasten einer Karte, einer Berechtigungsänderung oder dem Senden einer externen Nachricht mit Noul, ob die Absicht explizit ist und die Anfrage die erforderliche Bedingung erfüllt. Aktionen mit hohem Risiko sollten zusätzlich feste Regeln, Autorisierungsprüfungen und Audit-Protokolle verwenden.
Warteschlangen priorisieren und an Menschen eskalieren
Teilen Sie Auswirkungen, Zeitvorgaben und Kundenstatus in separate Score- oder Noul-Fragen auf und kombinieren Sie sie anschließend in einer Rangfolgeformel im Code. So können Betriebsteams Gewichtungen ändern, ohne einen einzigen großen Prompt neu schreiben zu müssen.
Strukturierte Informationen extrahieren
Wenn Zielfelder und mögliche Werte im Voraus definiert werden können, kann Jev einfache Klassifizierung und Validierung unterstützen. Bei unbekannten Feldern, langen Extraktionstexten oder komplexen Entitätsbeziehungen sollten Sie zuerst ein generatives Modell verwenden und Jev anschließend zur Validierung oder Weiterleitung einsetzen.
Erste Schritte
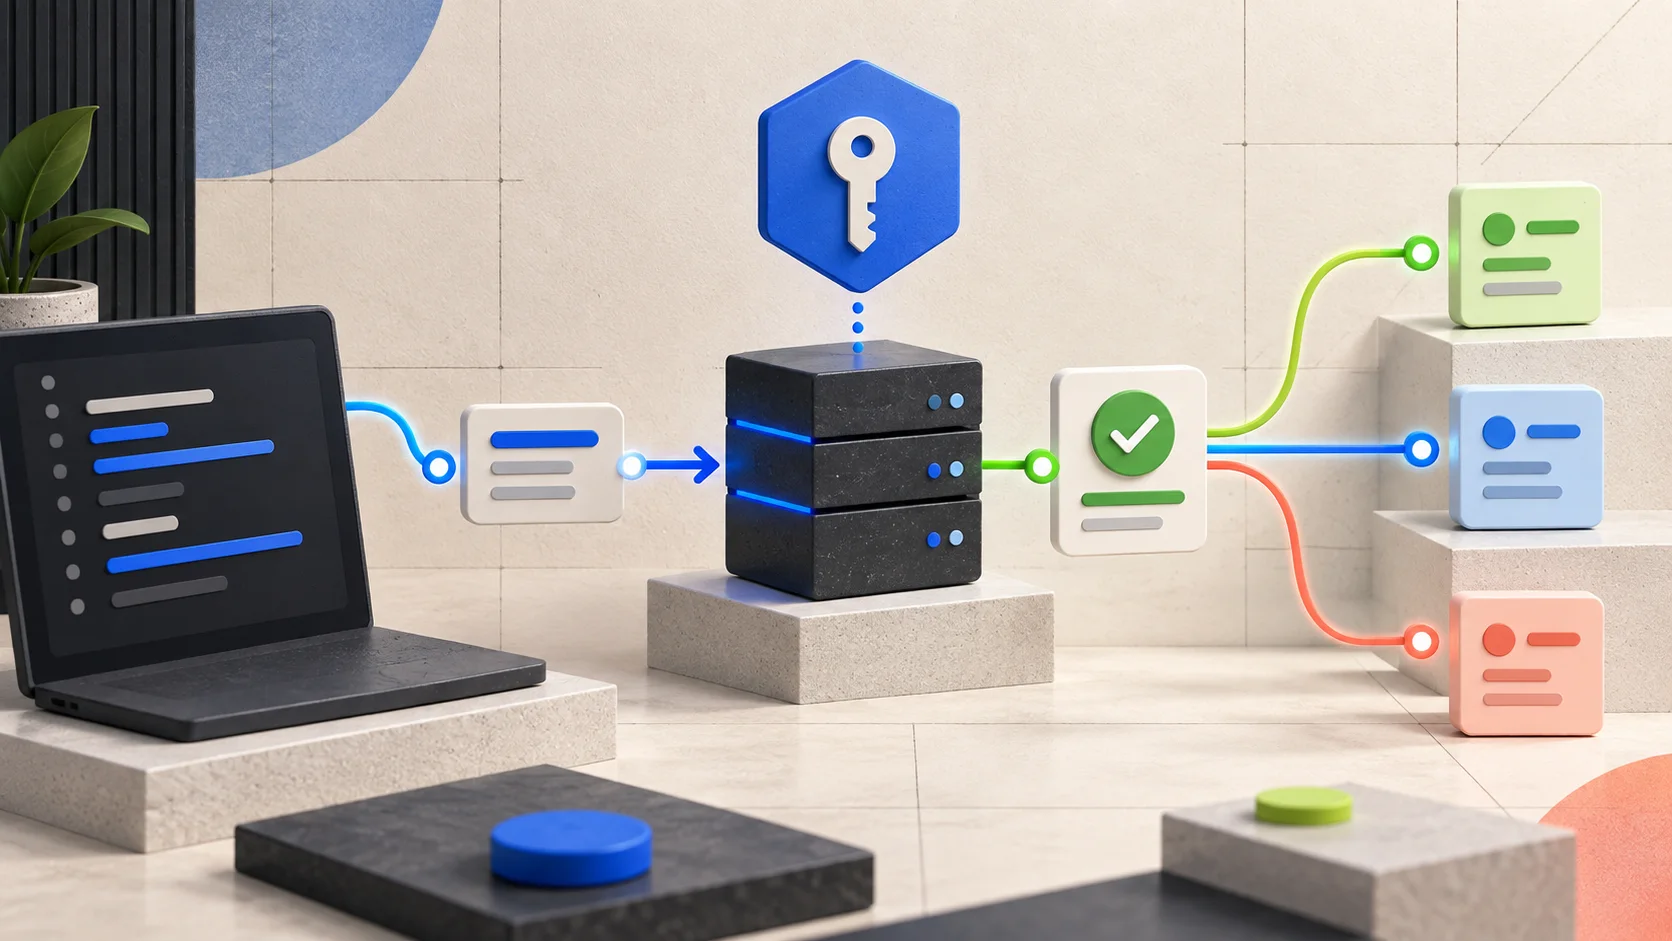
Bild: Führen Sie den API-Aufruf auf dem Server aus und übergeben Sie das strukturierte Ergebnis an den Anwendungscode zurück.
Schritt 1: Eine Entscheidung im Playground validieren
Wählen Sie eine risikoarme Entscheidung mit messbarem Ergebnis und klar definiertem Antwortbereich. Verlagern Sie nicht gleich einen gesamten Workflow in den ersten Test. Prüfen Sie, ob ein einzelnes Urteil tatsächlich manuellen Aufwand oder wiederholte Anwendungslogik reduziert.
Schritt 2: Serverseitig einen API-Schlüssel erstellen
Nachdem Sie den Workflow validiert haben, erstellen Sie gemäß dem Jev-AI-API-Leitfaden einen API-Schlüssel. Speichern Sie ihn in einer serverseitigen Umgebungsvariable. Fügen Sie ihn niemals in Browsercode, ein echtes Markdown-Beispiel oder ein Git-Repository ein.
Schritt 3: Den systemone-Endpunkt aufrufen
Die aktuelle Website-Dokumentation verwendet POST https://thejevai.com/v1/systemone. Dies ist ein minimales Noul-Beispiel auf Grundlage des dokumentierten Anfrageformats:
curl -X POST https://thejevai.com/v1/systemone \
  -H "Authorization: Bearer $JEV_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "typesafe/jev-1.13",
    "state": "A customer has tried to connect Stripe for three days.",
    "questions": {
      "urgent": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }'
Konzeptionell enthält answers Ergebnisse, die nach Fragen-ID sortiert sind, usage Nutzungsinformationen und elapsedMs die Ende-zu-Ende-Anfragezeit. Produktivcode sollte sich für alle Felder, Validierung und Fehlerbehandlung an der offiziellen API-Referenz orientieren, statt optionale Parameter aus einem kurzen Beispiel abzuleiten.
Schritt 4: Das Ergebnis mit dem Kontrollfluss verbinden
Ein robuster Produktivablauf umfasst normalerweise:
- Länge, Berechtigungen und sensible Daten prüfen, bevor State gesendet wird.
- Eine kleine, klar abgegrenzte Gruppe von Fragen senden.
- Antwortformat und Anfragestatus validieren.
- Wahrscheinlichkeit, Konfidenz, Geschäftsrisiko und Schwellenwerte nutzen, um Automatisierung oder Prüfung auszuwählen.
- Eingabeversion, Fragendefinition, Modellversion und endgültige Aktion für erneute Wiedergabe und Evaluation protokollieren.
Aktuelle Kontingente, API-Schlüsselverwaltung und Tarifdetails finden Sie auf der Jev-AI-Preisseite.
Wahrscheinlichkeit, Konfidenz und Grenzen
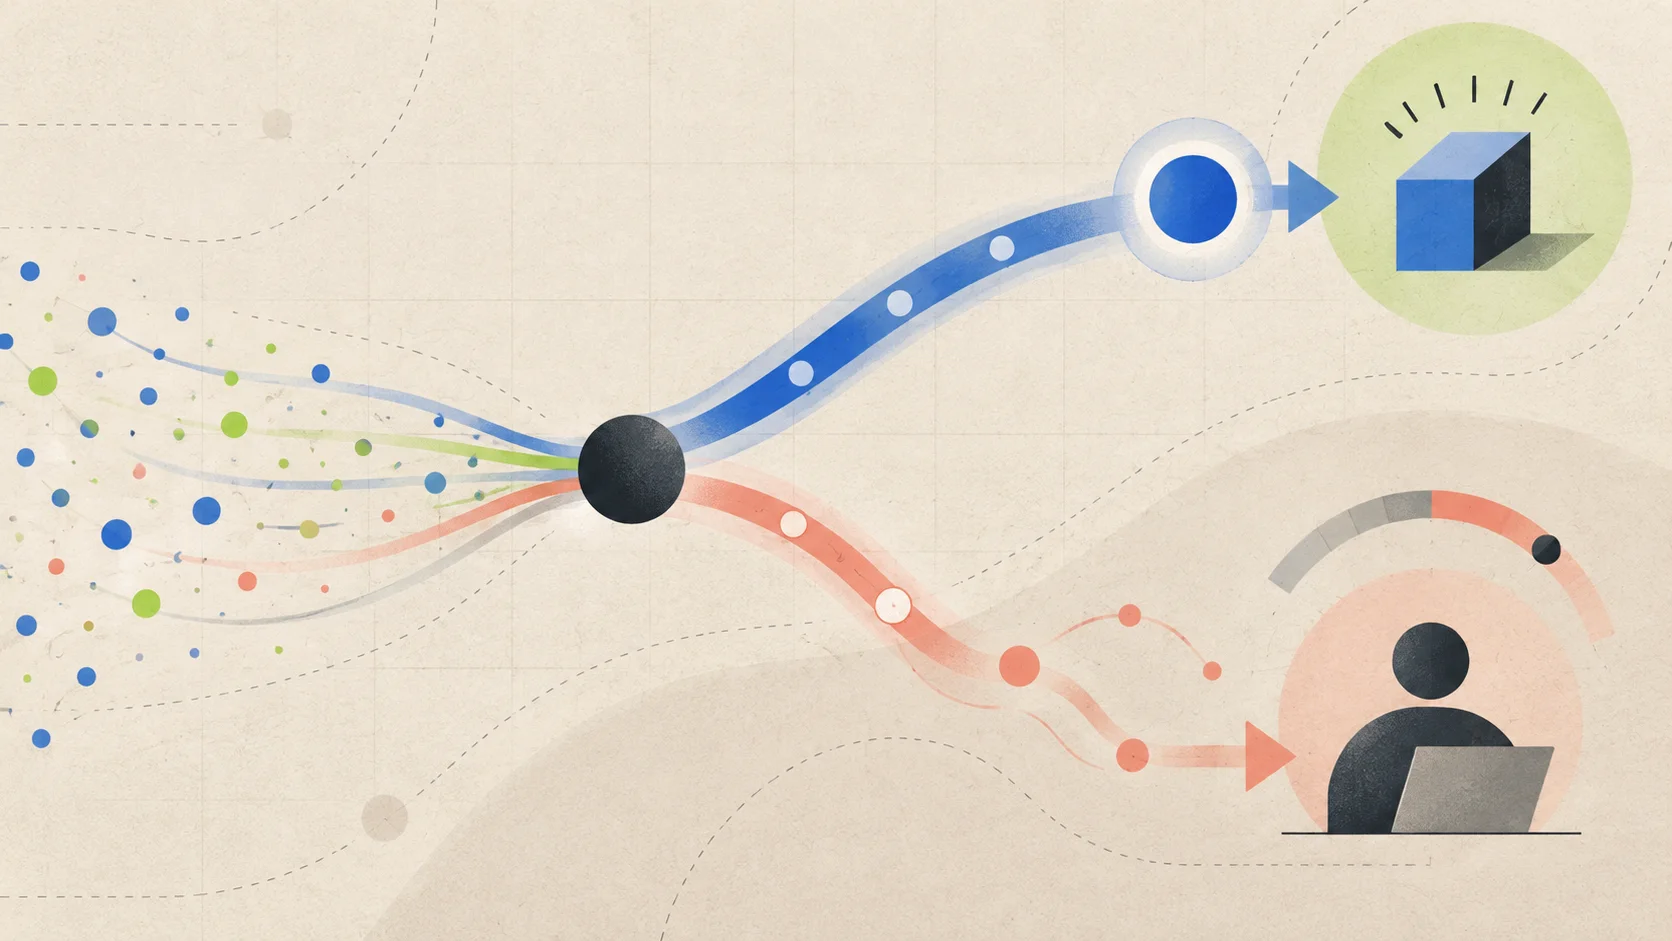
Bild: Wahrscheinlichkeit sollte dem System bei der Wahl des Automatisierungsgrads helfen und keine Risikokontrollen ersetzen.
Wahrscheinlichkeit ist keine Garantie für geschäftliche Genauigkeit
Die offizielle Dokumentation weist ausdrücklich darauf hin, dass Wahrscheinlichkeit und Konfidenz Signale für Automatisierung sind und keine Garantie für geschäftliche Genauigkeit darstellen. Auch ein Ergebnis mit hoher Konfidenz kann für Ihre Domäne, Sprache, Datenverteilung oder Richtlinie falsch sein.
Verwenden Sie je nach Aktion unterschiedliche Strategien:
- Bei risikoarmer Klassifizierung kann ein niedrigerer Schwellenwert mit Korrekturmöglichkeit ausreichen.
- Aktionen mit mittlerem Risiko sollten Wiederholungen, Gegenbeispiele und menschliche Stichprobenkontrollen umfassen.
- Löschungen, Zahlungen und Berechtigungsänderungen sollten Modellsignale mit festen Regeln, Autorisierung und menschlicher Bestätigung kombinieren.
Fragen eng umrissen halten
Eine gute Frage verlangt ein einziges Urteil und gibt jeder Antwort eine klare Bedeutung. Wenn eine Frage langes Kontextdenken, mehrere unabhängige Faktoren, eine Richtlinienauslegung und eine Handlungsempfehlung erfordert, teilen Sie sie in kleinere Fragen auf und kombinieren Sie diese im Code.
Nicht-Text-Eingaben vorverarbeiten
Die aktuelle Website-Dokumentation nennt Texte, JSON-Objekte und Textarrays als unterstützte State-Eingaben. Bilder, Audio und Video werden derzeit nicht direkt angenommen. Erstellen Sie für Chinesisch, Fachbegriffe oder domänenspezifische Daten einen eigenen Evaluationsdatensatz und testen Sie Choice, Score und Noul getrennt.
Latenz in Ihrer Umgebung validieren
Die Jev-AI-Startseite nennt eine Antwortzeitspanne von 70–500 ms. Die tatsächliche Latenz hängt jedoch von Netzwerkstandort, Anfragegröße, Parallelität, Warteschlangen und Dienstbedingungen ab. Betrachten Sie die Angabe als Produktpositionierung, nicht als Ihr SLA. Führen Sie vor dem Produktiveinsatz Benchmarks mit realen Anfragen und der erwarteten Parallelität durch.
Preise von Jev AI
Die folgende Übersicht entspricht der Preisseite vom 20. September 2026. Tarife und Leistungen können sich ändern. Prüfen Sie sie vor dem Kauf auf der offiziellen Preisseite.
| Tarif | Preis | Credits und vorgesehene Nutzung |
|---|---|---|
| Starter | $10 | 100.000 Credits ohne Ablaufdatum; zur Validierung eines realen Workflows |
| Pro | $100 | 1.000.000 Credits, mehrere Arbeitsbereiche und produktive API-Nutzung |
| Enterprise | $1.000 | 11.000.000 Credits einschließlich 10 % zusätzlicher Credits, Teamzusammenarbeit und Unterstützung bei benutzerdefinierten Integrationen |
Vergleichen Sie nicht nur die Credit-Anzahl. Schätzen Sie die Größe jedes State, die Zahl der Fragen pro Anfrage, ob Entscheidungen parallel ausgewertet werden und wie viele Fälle mit geringer Konfidenz menschliche Prüfung erfordern.
Häufig gestellte Fragen
Ist Jev AI ein Chatbot?
Nein. Jev AI ist dafür vorgesehen, strukturierte Entscheidungen an Software statt dialogische Antworten zu liefern. Es kann in einem Chatbot, Agenten oder SaaS-Workflow als Urteilsknoten eingesetzt werden.
Kann ich Jev AI ohne Entwicklungserfahrung verwenden?
Mit dem Playground können Sie State, Fragetypen und Ergebnisse kennenlernen. Entscheidungen in ein Produkt einzubinden und API-Schlüssel, Berechtigungen, Wiederholungen und menschliche Prüfung zu verwalten, erfordert weiterhin grundlegende Backend-Entwicklung.
Kann Jev AI ein großes Sprachmodell ersetzen?
In der Regel nicht allein. Jev eignet sich für begrenzte Entscheidungen, ein generatives LLM für offene Texte, Erklärungen und tiefergehendes Schlussfolgern. In einem praktischen System kann Jev Anfragen weiterleiten und riskante Aktionen prüfen, während ein LLM Texte erzeugt oder komplexe Schlussfolgerungen übernimmt.
Wie wähle ich zwischen Choice, Score und Noul?
- Verwenden Sie Choice, wenn Sie eine Option aus einer Auswahl benötigen.
- Verwenden Sie Score, wenn Sie eine geordnete Einschätzung von Schweregrad, Priorität oder Qualität benötigen.
- Verwenden Sie Noul, wenn Sie prüfen möchten, ob eine einzelne Aussage zutrifft.
Ist Konfidenz dasselbe wie Genauigkeit?
Nein. Konfidenz und Wahrscheinlichkeit helfen der Anwendung, den Automatisierungsgrad zu wählen. Evaluieren Sie das Modell mit Ihren eigenen Daten, Ihrer Sprache, Domäne und Ihrem Risikoniveau und behalten Sie für Aktionen mit großen Auswirkungen einen Pfad zur menschlichen Prüfung bei.
Wo finde ich die aktuellen Dokumente und Beispiele?
Beginnen Sie mit der offiziellen Dokumentation und sehen Sie sich anschließend in der Showcase-Sammlung Workflows aus der Community an. Wenn Sie eine konkrete Integration entwickeln, validieren Sie zuerst ein kleines Beispiel im Playground.
Fazit: Zuerst eine kleine Entscheidung zuverlässig machen
Bei Jev AI geht es nicht darum, alle KI-Fähigkeiten in ein Modell zu packen. Der Mehrwert besteht darin, die kleinen, bereits in Software verborgenen Urteile explizit zu machen: State definieren, typisierte Fragen stellen, Wahrscheinlichkeitssignale auswerten und den Code entscheiden lassen, ob weitergeleitet, eingereiht, blockiert oder eine menschliche Bestätigung angefordert wird.
Für Teams, die KI-Agenten, Supportautomatisierung, Entwicklertools und Geschäftsworkflows entwickeln, ist eine risikoarme, messbare Entscheidung ein sinnvoller Start. Validieren Sie sie im Jev-AI-Playground und binden Sie sie anschließend serverseitig mithilfe der API-Dokumentation an. Planen Sie Grenzen, Schwellenwerte und Fehlerpfade gemeinsam mit dem Modellaufruf, damit Jev zu einer wartbaren Softwarekomponente und nicht zu einer einmaligen Demo wird.
Recherche-Datum: 2026-09-20
Primärquellen: thejevai.com, Jev-AI-Dokumentation, Jev-AI-Preise, TypeSafe-Einführung