Entwicklerleitfaden
Jev AI TypeSafe AI: Ein praktischer Leitfaden für typisierte Entscheidungen in der Produktion
Verstehen Sie Jev AI, TypeSafe AI und typisierte Entscheidungen: State und Fragen entwerfen, Antworten validieren und sichere KI-Workflows bauen.
Jev AI TypeSafe AI: Ein praktischer Leitfaden für typisierte Entscheidungen in der Produktion
Wer nach jev ai typesafe ai sucht, versucht wahrscheinlich, drei Begriffe miteinander zu verbinden: Jev AI, TypeSafe AI und den Bedarf an KI-Ergebnissen, die Software sicher verarbeiten kann. Der entscheidende Unterschied ist: Eine typisierte Entscheidung ist nicht einfach eine Chat-Antwort, die in JSON verpackt wurde. Sie ist eine begrenzte Beurteilung mit einem definierten Antwortbereich, einer prüfbaren Antwortstruktur und einem klaren Platz im Kontrollfluss Ihrer Anwendung.
Jev wird als Entscheidungstool für Softwareteams positioniert. Sie senden einen Zustand und eine oder mehrere typisierte Fragen und erhalten strukturierte Antworten – zum Beispiel eine ausgewählte Option, einen Score oder eine Ja-Wahrscheinlichkeit. Die offizielle Jev-AI-Startseite beschreibt das Produkt rund um Klassifikation, Routing, Bewertung und Sicherheitsprüfungen, nicht rund um die freie Textgenerierung. Die Website weist außerdem darauf hin, dass Jev AI unabhängig betrieben wird und weder mit TypeSafe verbunden ist noch von TypeSafe betrieben oder unterstützt wird. Diese Abgrenzung ist wichtig: Verwenden Sie „TypeSafe AI“ als Such- und Ökosystembegriff, aber setzen Sie nicht jedes TypeScript-Typprojekt mit dem Jev-Produkt gleich.
Dieser Leitfaden zeigt Jev AI TypeSafe AI als Produktionsmuster. Sie erfahren, wie Sie den Entscheidungsvertrag entwerfen, zwischen Choice, Score und Noul wählen, eine entfernte Antwort zur Laufzeit validieren, Jev mit einem generativen LLM kombinieren und sichere Fallbacks für unsichere oder nicht verfügbare Ergebnisse bauen.
Inhaltsverzeichnis
- Was bedeutet Jev AI TypeSafe AI
- Warum typisierte Entscheidungen etwas anderes sind als generiertes JSON
- Der Entscheidungsvertrag: State, Fragen und Richtlinie
- Die drei Jev-Fragetypen
- TypeScript-Typen sind keine Laufzeitvalidierung
- Eine Produktionsarchitektur für Jev AI
- Wertvolle Anwendungsfälle
- Wahrscheinlichkeit und Konfidenz richtig verwenden
- Sicherheit, Datenschutz und Betriebsgrenzen
- Rollout-Plan und Checkliste
- Wann Jev nicht das richtige Werkzeug ist
- Häufige Fragen
Was bedeutet Jev AI TypeSafe AI?
Die Suchphrase deutet meist auf den Wunsch nach einer typisierten KI-Schnittstelle hin, nicht nach einem allgemeinen Chatbot. Bei einer klassischen LLM-Integration sendet die Anwendung einen Prompt und erhält Text. Man kann zusätzlich JSON verlangen, es parsen und hoffen, dass das Modell das Schema eingehalten hat. Für risikoarme Anreicherung kann das ausreichen, aber mehrere Verantwortlichkeiten bleiben vermischt: die Frage formulieren, den Antwortbereich beschreiben, die Antwort extrahieren und entscheiden, ob daraus eine Aktion folgen darf.
Jev trennt diese Aufgaben. Ihr Code liefert den State und definiert die Fragen. Jev bewertet den State gegen diese Fragen und gibt für jede Frage-ID eine Antwort zurück. Danach wendet Ihre Anwendung deterministische Regeln, Berechtigungen, Schwellenwerte und einen Human-Review-Prozess an.
„Typisiert“ bedeutet hier praktisch drei Dinge:
- Die Frage hat eine erklärte Form. Sie ist eine Choice-, Score- oder Noul-Entscheidung statt einer offenen Bitte um Prosa.
- Die Antwort passt zu dieser Form. Choice liefert die gewählte Option, Wahrscheinlichkeiten und Konfidenz. Score liefert einen wahrscheinlichkeitsgewichteten Score, eine Legende, Wahrscheinlichkeiten und Konfidenz. Noul liefert eine Ja-Wahrscheinlichkeit.
- Das Ergebnis hat eine Rolle in der Anwendung. Es kann eine Queue routen, ein Modell auswählen, eine Bestätigung anfordern oder einen Fall zur Prüfung weiterleiten.
Typisiert bedeutet nicht fehlerfrei. Es bedeutet, dass die Grenze zwischen Modell und Code explizit genug ist, um sie zu validieren, zu evaluieren und zu beobachten.
Warum typisierte Entscheidungen etwas anderes sind als generiertes JSON
Generiertes JSON und typisierte Entscheidungen können in einem Log ähnlich aussehen, haben aber unterschiedliche Engineering-Verträge. Bei einer Ticket-Zuordnung könnte ein generatives Modell Folgendes zurückgeben:
{
  "team": "technical",
  "reason": "The customer mentions a failed integration"
}
Das Objekt ist nützlich, sagt aber nicht, ob technical zu den erlaubten Teams gehört, wie nahe billing liegt oder ob der Fall mehrdeutig ist. Schema, Parser und Richtlinienebene müssen Sie selbst hinzufügen.
Bei einer typisierten Entscheidung beginnt die Definition mit dem erlaubten Antwortbereich. Eine Choice-Frage kann etwa billing, technical, sales und needs_review mit präzisen Kriterien definieren. Das Ergebnis kann die Verteilung über diese Optionen erhalten. Die Anwendung routet automatisch nur dann, wenn die Option auf der Allowlist steht und die Konfidenz den risikobasierten Schwellenwert erfüllt.
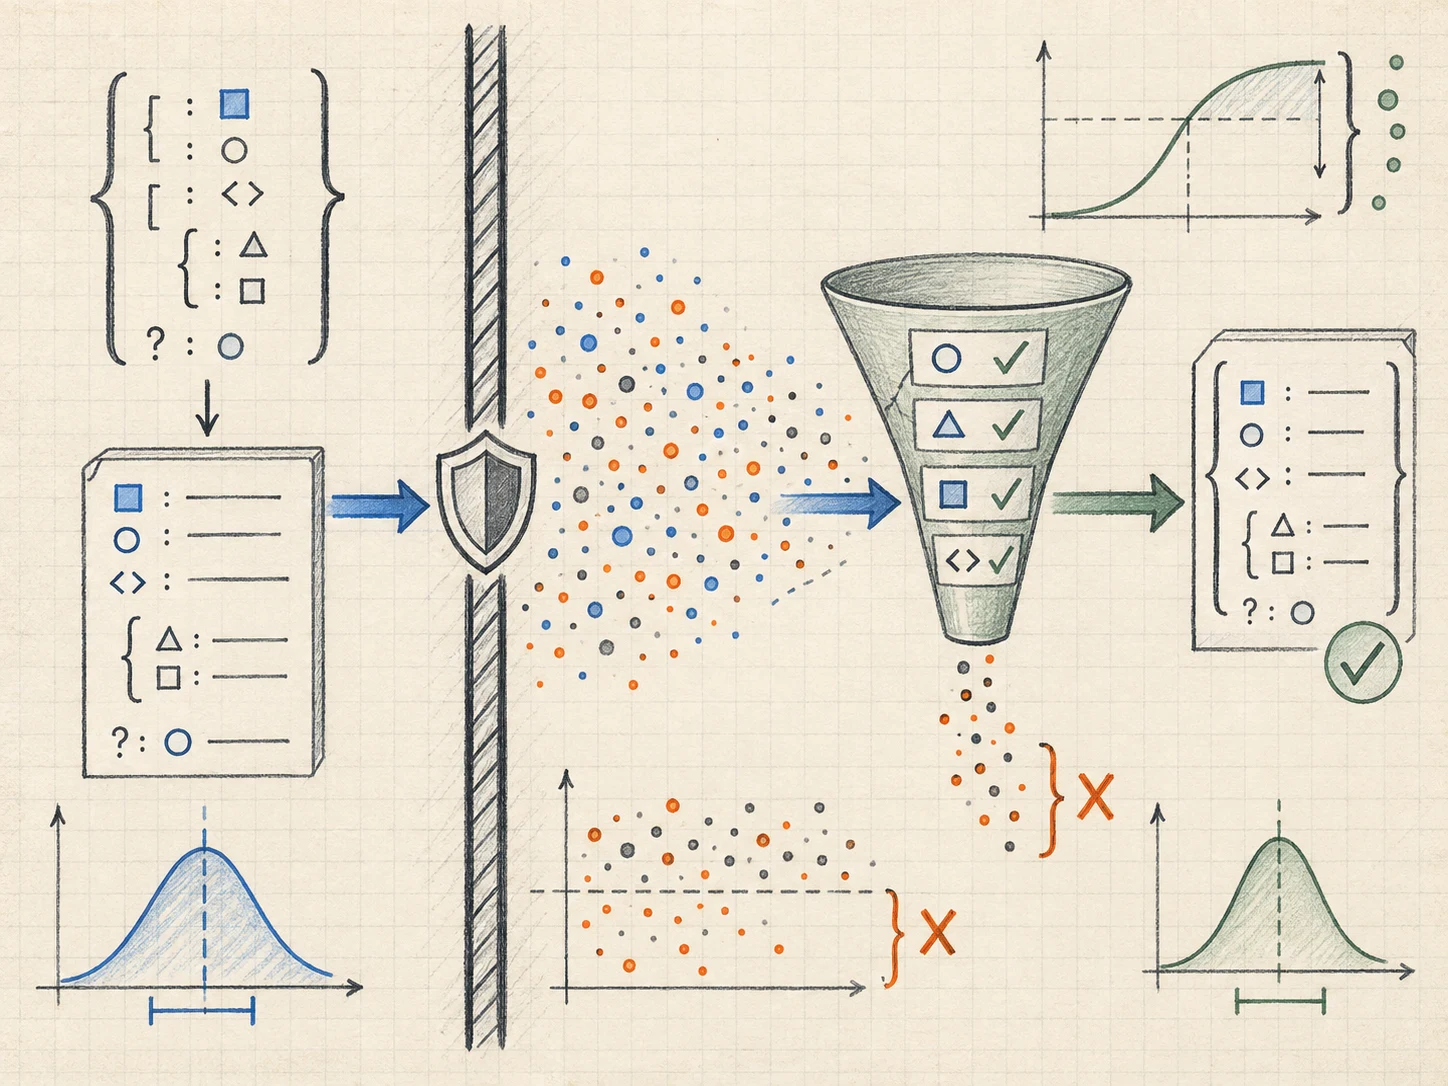
Ein weiterer Vorteil: Mehrere Fragen können gegen denselben State parallel ausgewertet werden. Statt drei Anfragen für Intent, Dringlichkeit und Human Review zu orchestrieren, beschreiben Sie die unabhängigen Entscheidungen gemeinsam. Das macht die Entscheidungsfläche sichtbar und reduziert unnötige Aufrufe.
Das Grundprinzip lautet: Verwenden Sie ein Modell für begrenzte semantische Beurteilungen und lassen Sie die endgültige Aktion in normalem Anwendungscode stattfinden.
Der Entscheidungsvertrag: State, Fragen und Richtlinie
Definieren Sie vor dem API-Aufruf einen kleinen Entscheidungsvertrag. Er sollte vier Fragen beantworten:
- Welchen State braucht das Modell?
- Welche konkrete Frage soll beantwortet werden?
- Welche Ergebnisse sind gültig?
- Was tut die Anwendung bei Unsicherheit, ungültiger Antwort oder Nichtverfügbarkeit?
1. Nur relevanten State vorbereiten
Die öffentliche Jev-Dokumentation nennt Text, JSON-Objekte und Arrays aus Text als Eingabegrenze. Eine einfache Supportnachricht kann ein String sein. Ein Workflow mit Ticket, Kontostufe, Produktbereich und Richtlinienausschnitt passt besser als JSON-Objekt. Senden Sie nicht den gesamten Datenbankdatensatz, nur weil mehr Kontext verfügbar ist.
Kleiner State ist leichter zu prüfen und reduziert das Risiko, irrelevante personenbezogene oder vertrauliche Daten zu übertragen. Außerdem werden Evaluationen stabiler: Sie sehen, welche Felder tatsächlich für eine geänderte Entscheidung verantwortlich sind.
2. Eine Entscheidung pro Frage-ID
Verwenden Sie stabile Schlüssel wie department, urgency oder needs_human. Fragen Sie nicht in einem Satz: „Welches Team ist zuständig, wie dringend ist es und sollen wir erstatten?“ Das sind drei Entscheidungen mit unterschiedlichen Antwortformen und Verantwortlichen.
Die Frage-ID ist Teil des Anwendungskontrakts. Ein Label in einem Admin-Panel darf sich ändern; ein Code-Schlüssel sollte nur im Rahmen einer geplanten Versionierung geändert werden.
3. Den Antwortbereich beschreiben
Criteria sind keine Dekoration. Sie sind das Bewertungsraster, das aus einer vagen Klassifikation eine nachvollziehbare Entscheidung macht. Beschreiben Sie, was zu jeder Option gehört, definieren Sie niedrige und hohe Score-Stufen und ergänzen Sie einen Auffangwert für Fälle, die nicht sauber in die Hauptkategorien passen.
4. Die Richtlinie außerhalb des Modells halten
Das Modell sollte nicht entscheiden, ob ein Nutzer ein Konto löschen darf, ob eine Zahlung autorisiert ist oder ob ein Rate Limit überschritten wurde. Das sind deterministische Pflichten der Anwendung. Jev kann vor dem Gate ein Risiko- oder Intent-Signal liefern, aber der Service muss Authentifizierung, Autorisierung und harte Geschäftsregeln weiterhin selbst durchsetzen.
Die drei Jev-Fragetypen
Die offizielle Jev-Dokumentation beschreibt drei Kern-Fragetypen. Wählen Sie den Typ, der zur Form der Entscheidung passt.

Choice: aus bekannten Alternativen auswählen
Verwenden Sie Choice, wenn die Ausgabe eine Option aus einer definierten Menge ist: Support-Routing, Lead-Segmentierung, Dokumenttyp, Modellauswahl oder Content-Status.
const questions = {
  department: {
    type: "choice",
    instructions: "Which team should handle this request?",
    criteria: {
      billing: "Payments, invoices, refunds, or payouts",
      technical: "Bugs, outages, or integration failures",
      sales: "Pricing, upgrades, or new accounts",
      needs_review: "The request does not clearly fit another option"
    }
  }
} as const;
Die Option needs_review ist wichtig. Ohne sie muss das Modell die am wenigsten falsche Kategorie wählen, wenn keine wirklich passt. Ein vollständiger Antwortbereich ist oft wertvoller als ein längerer Prompt.
Score: eine geordnete Eigenschaft bewerten
Score passt zu einer Skala von niedrig bis hoch, etwa Dringlichkeit, Schweregrad, Relevanz oder Frustration. Die Kriterien sind geordnete Stufen. Weil der Score wahrscheinlichkeitsgewichtet ist, kann er zwischen benannten Stufen liegen.
Definieren Sie die Stufen über beobachtbare Hinweise und die Aktion, die sie beeinflussen sollen. Ein Wert von 2,7 kann eine Eskalation empfehlen, aber niemals eine Incident-Richtlinie umgehen.
Noul: eine Ja/Nein-Aussage beurteilen
Noul ist für eine einzelne Aussage gedacht: „Fordert diese Nachricht ausdrücklich eine Erstattung?“ oder „Enthält dieser Tool-Aufruf eine irreversible Aktion?“ Der Wert noul ist die Wahrscheinlichkeit für Ja, kein zweites Konfidenzfeld.
Wenn der Workflow Kategorie, Dringlichkeit und Sicherheitsprüfung benötigt, senden Sie drei klar benannte Fragen über denselben State. Die Anwendung kombiniert die Ergebnisse mit normaler Logik und ihren eigenen Richtlinien.
TypeScript-Typen sind keine Laufzeitvalidierung
Hier scheitern viele „TypeSafe AI“-Integrationen. TypeScript prüft den Code zur Compile-Zeit, aber nicht die Bytes einer entfernten Antwort. Diese Zeile ist keine Validierung:
const payload = (await response.json()) as JevResponse;
Die Typassertion verändert nur die Vorstellung des Compilers. Sie beweist nicht, dass payload.answers.department.choice existiert, ein String ist oder in Ihrer Allowlist steht.
Beginnen Sie an der Netzwerkgrenze mit unknown und validieren Sie anschließend jedes Feld, das Ihre Policy verwendet:
type Decision = {
  team: "billing" | "technical" | "sales" | "needs_review";
  confidence: number;
  probabilities: Record<string, number>;
};

function asRecord(value: unknown): Record<string, unknown> | null {
  return typeof value === "object" && value !== null && !Array.isArray(value)
    ? (value as Record<string, unknown>)
    : null;
}

function parseDecision(value: unknown): Decision {
  const root = asRecord(value);
  const answers = asRecord(root?.answers);
  const answer = asRecord(answers?.department);
  const team = answer?.choice;
  const confidence = answer?.confidence;
  const probabilities = asRecord(answer?.probabilities);
  const allowed = ["billing", "technical", "sales", "needs_review"];

  if (
    typeof team !== "string" ||
    !allowed.includes(team) ||
    typeof confidence !== "number" ||
    !Number.isFinite(confidence) ||
    confidence < 0 ||
    confidence > 1 ||
    !probabilities
  ) {
    throw new Error("Unexpected Jev response shape");
  }

  const values = Object.values(probabilities);
  if (!values.every((item) => typeof item === "number" && item >= 0 && item <= 1)) {
    throw new Error("Invalid probability map");
  }

  return {
    team: team as Decision["team"],
    confidence,
    probabilities: probabilities as Record<string, number>
  };
}
Behandeln Sie eine Validierungsabweichung als nicht verfügbare Entscheidung, nicht als negative Entscheidung mit niedriger Konfidenz. Prüfen Sie Typ, Pflichtfelder, Wertebereiche, Wahrscheinlichkeitssumme und erlaubte IDs.
Eine Produktionsarchitektur für Jev AI
Jev funktioniert am besten als schmale Entscheidungsebene in einem größeren System:
- Ein generatives LLM oder ein Anwendungsservice sammelt Kontext und formuliert eine begrenzte Frage.
- Jev bewertet den State gegen typisierte Fragen, möglichst parallel.
- Eine deterministische Policy prüft Antwort, Berechtigungen und Schwellenwerte.
- Die Anwendung führt eine Aktion aus, fordert Bestätigung an oder sendet den Fall zur Prüfung.
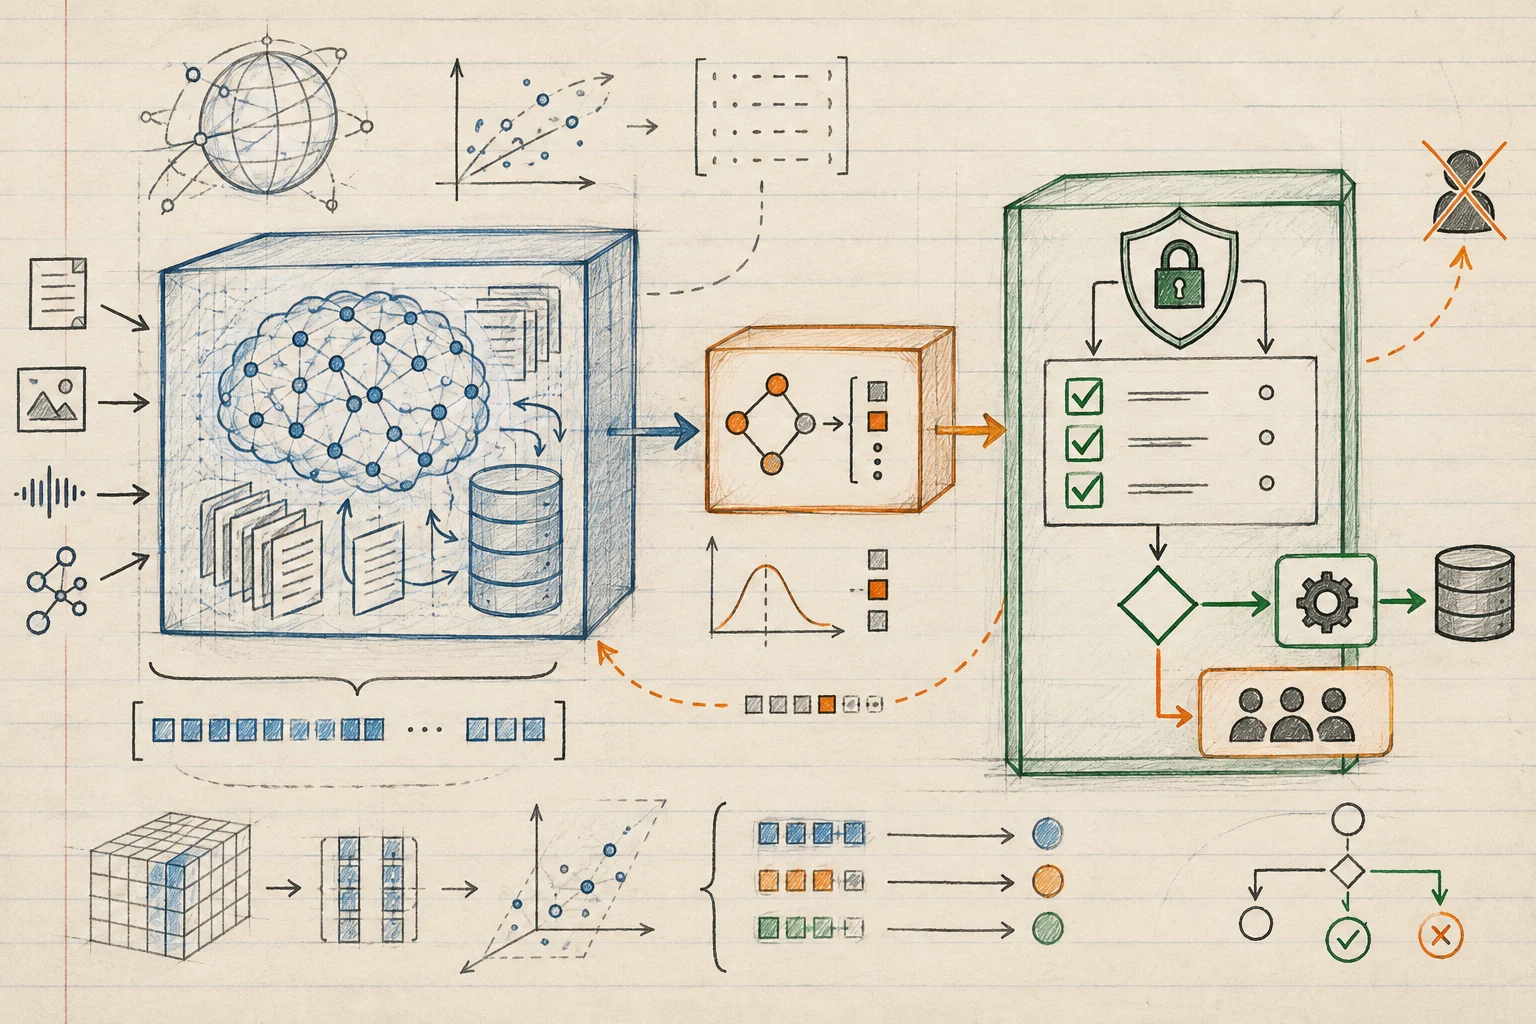
Diese Trennung verhindert, dass ein allgemeines Sprachmodell eine Anfrage interpretiert und zugleich eine sensible Aktion ausführt. Das LLM kann Kontext halten, Jev kann das Risiko eines Tool-Aufrufs beurteilen, aber API-Key, Autorisierung, Idempotenz, Rate Limit, Bestätigung und Ausführung bleiben bei der Anwendung.
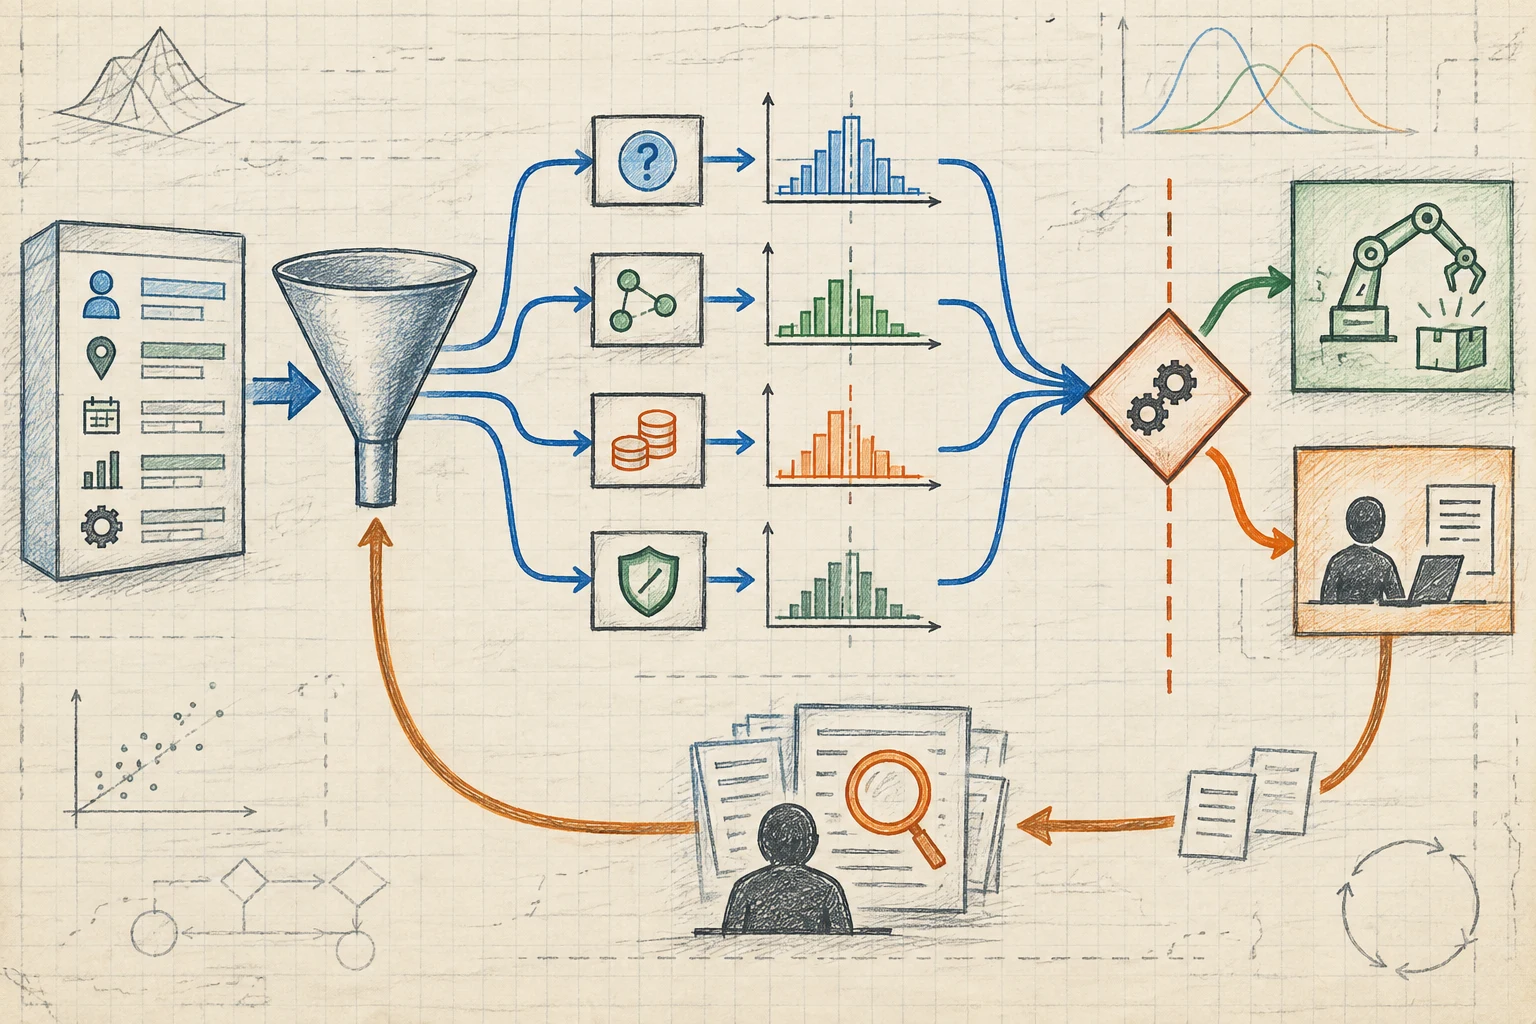
Die REST-Grenze ist einfach: POST https://thejevai.com/v1/systemone mit Bearer-API-Key, model wie jev-latest, state und einer questions-Map. Führen Sie den Aufruf auf dem Server aus. JEV_API_KEY gehört nicht in Browser-Code oder Agent-Transkripte.
Modellieren Sie das Ergebnis intern nicht als bloßes Boolean:
type WorkflowResult<T> =
  | { kind: "decision"; value: T; confidence?: number }
  | { kind: "review"; reason: string }
  | { kind: "unavailable"; reason: string };
Ein Timeout ist nicht dasselbe wie die Entscheidung „billing“, und ein nicht bewerteter Tool-Aufruf ist nicht automatisch sicher. Explizite Zustände machen Fallbacks in Metriken sichtbar.
Wertvolle Anwendungsfälle
Support- und Operations-Routing
Bestimmen Sie Team, Dringlichkeit und Human Review in einem Request. Validieren Sie die Route gegen eine serverseitige Allowlist und halten Sie Eskalationsregeln unabhängig vom Modell.
Modellauswahl
Führen Sie eine kleine Entscheidung vor dem teuren generativen Modell aus. Choice kann fast, balanced oder reasoning auswählen; Score kann die Aufgabenschwierigkeit schätzen. Die Anwendung kontrolliert Anbieter, Budget und Protokollierung.
Sicherheit von Tool-Aufrufen
Fragen Sie vor einem Agent-Tool-Aufruf, ob eine irreversible Aktion enthalten ist. Bei Ja folgt eine Bestätigung oder Human Review. Authentifizierung, Autorisierung, Ressourcenbesitz und Eingabevalidierung bleiben deterministisch.
Content- und Lead-Workflows
Sortieren Sie Inhalte in bekannte Redaktions-Queues, bewerten Sie Lead-Dringlichkeit oder markieren Sie Nachrichten zur Prüfung. Versionieren Sie Kriterien und messen Sie Ergebnisse nach Segment statt nur über einen globalen Durchschnitt.
Kontextkomprimierung und Memory-Auswahl
In langen Agent-Sitzungen kann eine Choice- oder Score-Frage helfen, wichtige Tool-Ergebnisse zu priorisieren. Speichern Sie Quelle und Begründung, damit ein Signal nicht die einzige Kopie eines kritischen Fakts löscht.
Wahrscheinlichkeit und Konfidenz richtig verwenden
Wahrscheinlichkeit und Konfidenz sind Signale, keine Korrektheitsgarantie. Der Jev-Playground eignet sich, um repräsentative States und die Antwortform vor der Produktion zu prüfen.
Wählen Sie Schwellenwerte aus einem gelabelten Evaluationssatz. Nehmen Sie normale, mehrdeutige, seltene und adversariale Fälle auf, ebenso Beispiele für needs_review. Messen Sie die Kosten der Fehler: Fehlende Eskalationen können einen Ausfall vergrößern; falsche Eskalationen kosten Review-Zeit; falsche Modellwahl erhöht Kosten; unsichere Tool-Aktionen können irreversibel sein.
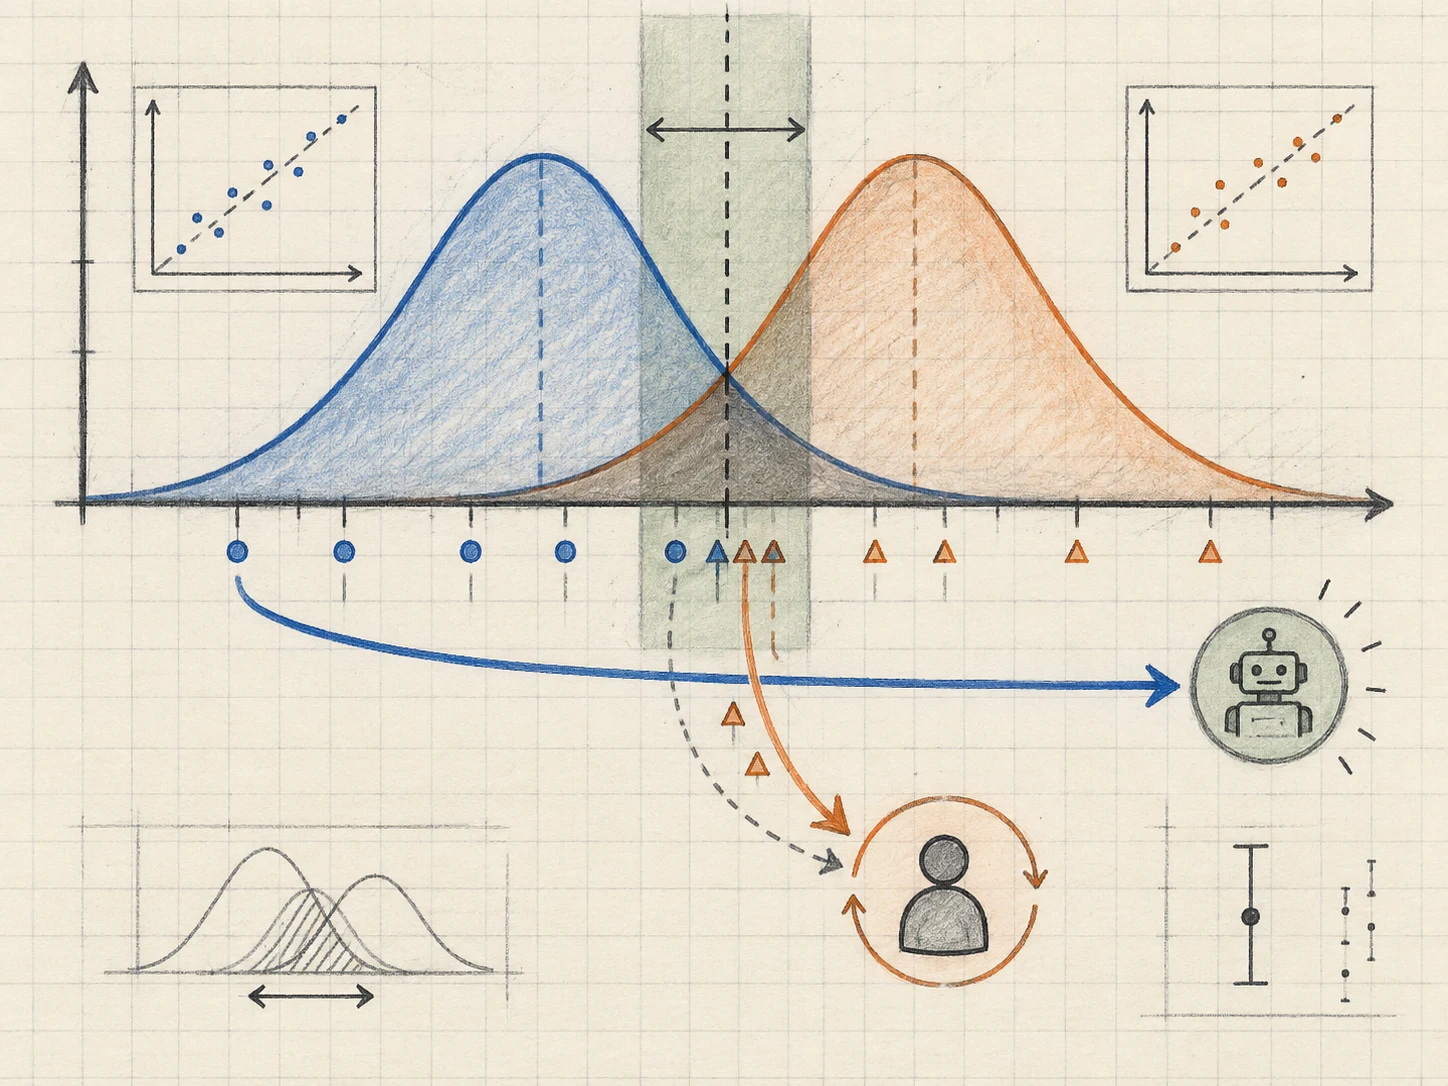
Verwenden Sie für unterschiedliche Aktionen unterschiedliche Schwellen. Ein risikoarmes Content-Tag darf früher automatisiert werden. Zahlung, Kontosperre, Löschung oder Produktionsdeployment brauchen stärkere Evidenz und deterministische Gates, auch bei hoher Konfidenz.
Überwachen Sie Auswahl, Wahrscheinlichkeitsabstand, Eingabesegment, Korrekturen, Eskalationen, Downstream-Ergebnis, Latenz und Nichtverfügbarkeit – nicht nur Konfidenz.
Sicherheit, Datenschutz und Betriebsgrenzen
Speichern Sie API-Keys serverseitig in Umgebungsvariablen oder einem Secret Manager. Schreiben Sie Keys nicht in Logs, Fehlermeldungen, Browser-Bundles oder Analytics. Senden Sie nur den für die Frage nötigen State. Für personenbezogene oder vertrauliche Daten müssen Aufbewahrung, Zugriff, Verschlüsselung und Löschung definiert sein.
Setzen Sie begrenzte Timeouts. Wiederholen Sie nur plausible temporäre Fehler, beachten Sie Retry-Hinweise und begrenzen Sie Versuche. Eine fehlgeschlagene Schema-Prüfung ist kein Netzwerkfehler. Nach dem Retry-Budget geht der Fall in eine sichere Regel- oder Review-Schiene.
Versionieren Sie Fragen und Criteria zusammen mit dem Code, der Antworten interpretiert. Wenn Sie „critical“ neu definieren, eine Kategorie umbenennen oder einen Review-Pfad ergänzen, aktualisieren Sie die Evaluation und vergleichen Sie die Versionen.
Die öffentlichen Dokumente beschreiben derzeit Text, JSON-Objekte und Text-Arrays als Eingabe und nennen Bild, Audio und Video als noch nicht unterstützte direkte Eingaben. Multimodale Daten müssen daher zunächst begründet in Text oder Struktur überführt und separat evaluiert werden.
Rollout-Plan und Checkliste
Starten Sie mit einer häufigen, klar begrenzten und reversiblen Entscheidung:
- Erkunden: Testen Sie anonymisierte reale Beispiele im Playground.
- Offline evaluieren: Erstellen Sie einen Satz mit normalen, mehrdeutigen, seltenen und teuren Fehlerfällen.
- Shadow Mode: Lassen Sie den bisherigen Workflow autoritativ und vergleichen Sie Jevs Vorschlag.
- Assistenz: Zeigen Sie Vorschläge einem Operator und sammeln Sie Korrekturen.
- Selektiv automatisieren: Aktivieren Sie nur gemessene, risikoarme Pfade mit Pause-Schalter.
- Fortlaufend prüfen: Beobachten Sie Drift, Nichtverfügbarkeit, Korrekturen und Kosten.
Vor dem Start sollte gelten:
- State enthält keine irrelevanten Secrets oder personenbezogenen Daten;
- jede Frage hat eine stabile ID und genau einen Zweck;
- der Antwortbereich enthält einen sicheren Fallback;
- Remote-JSON wird aus
unknownvalidiert; - Policy kontrolliert Berechtigungen und irreversible Aktionen;
- Schwellenwerte sind an Fehlerkosten gebunden;
- Netzwerk- und Validierungsfehler haben unterschiedliche Ergebnisse;
- API-Keys bleiben serverseitig;
- Fragen- und Criteria-Versionen sind beobachtbar.
Für aktuelle Pläne, Zugriff und Nutzungslimits konsultieren Sie direkt die Jev-AI-Preisseite, statt ältere Artikelwerte zu übernehmen.
Wann Jev nicht das richtige Werkzeug ist
Ein generatives LLM passt besser zu langen Erklärungen, Entwürfen, Übersetzungen oder offenen Dialogen. Deterministische Regeln sind besser, wenn eine Bedingung vollständig bekannt und exakt sein muss. Ein lokales Modell oder klassischer Klassifikator kann sinnvoller sein, wenn Offline-Betrieb, Datenresidenz oder vollständige Infrastrukturkontrolle im Vordergrund steht.
Jev ist besonders hilfreich dazwischen: Die Eingabe ist zu semantisch für starre Regeln, aber die Ausgabe ist begrenzt genug für eine Geschäftsentscheidung. So entsteht Nutzen, ohne dass das Modell Berechtigungen oder Seiteneffekte Ihres Produkts übernimmt.
Häufige Fragen
Sind Jev AI und TypeSafe AI dasselbe?
Behandeln Sie die Begriffe als verwandt, aber nicht austauschbar. Jev AI ist das auf der Website beschriebene Entscheidungsprodukt. Die Website erklärt ausdrücklich, dass Jev unabhängig betrieben wird und nicht mit TypeSafe verbunden ist. Für Branding und Integration sollten Sie die aktuellen offiziellen Seiten prüfen.
Garantiert „typisiert“ eine korrekte Antwort?
Nein. Typisierte Antworten erleichtern Validierung und Evaluation, garantieren aber weder semantische Genauigkeit noch Geschäftskorrektheit. Evaluation, Schwellenwerte, deterministische Checks und Human Review bleiben notwendig.
Kann Jev ein großes Sprachmodell ersetzen?
Nicht für jede Aufgabe. Jev ist auf begrenzte Entscheidungen wie Klassifikation, Routing, Scoring und Sicherheitsprüfungen ausgerichtet. Für offene Texte verwenden Sie ein generatives Modell und ergänzen bei Bedarf eine typisierte Entscheidungsebene.
Sollte der gesamte Nutzer-Datensatz als State gesendet werden?
In der Regel nein. Senden Sie das kleinste Text- oder Strukturformat, das die Frage beantworten kann. Das verbessert Datenschutz, Prüfbarkeit und Reproduzierbarkeit.
Was passiert bei Nichtverfügbarkeit?
Modellieren Sie sie ausdrücklich. Je nach Workflow pausiert die Aktion, die bestehende Regelroute bleibt aktiv oder der Fall wird an eine Person gegeben. Ein Timeout darf nicht stillschweigend als „Nein“ gelten.
Was ist ein gutes erstes Jev-AI-TypeSafe-AI-Projekt?
Wählen Sie eine häufige, begrenzte, reversible Entscheidung mit messbarem Ergebnis: Support-Routing, Lead-Priorisierung, Modellauswahl oder Tool-Review. Beginnen Sie im Shadow Mode und automatisieren Sie erst nach Laufzeitvalidierung und Kostenmessung.
Fazit
Der praktische Kern von jev ai typesafe ai ist nicht „LLM-Ausgabe in JSON“, sondern eine disziplinierte Grenze: relevanten State senden, klare typisierte Fragen stellen, strukturierte Signale prüfen und Policy sowie Ausführung in Anwendungscode halten.
So kann TypeScript den internen Vertrag beschreiben, Laufzeitvalidierung die Netzwerkgrenze schützen und Evaluation zeigen, ob die Entscheidung in der echten Arbeitslast nützlich ist. Das Ergebnis ist leichter zu testen, zu überwachen und weiterzuentwickeln als ein undurchsichtiger Prompt, der nur zufällig wie ein Schema aussieht.