Modellvergleiche
Jev vs. Laya: Gehostete API oder offene Gewichte? (2026)
Jev und Laya im Vergleich: Benchmark, Fine-Tuning, Kalibrierung, Kontext, Latenz, Sprachen und Gesamtkosten für die Wahl eines Entscheidungsmodells.
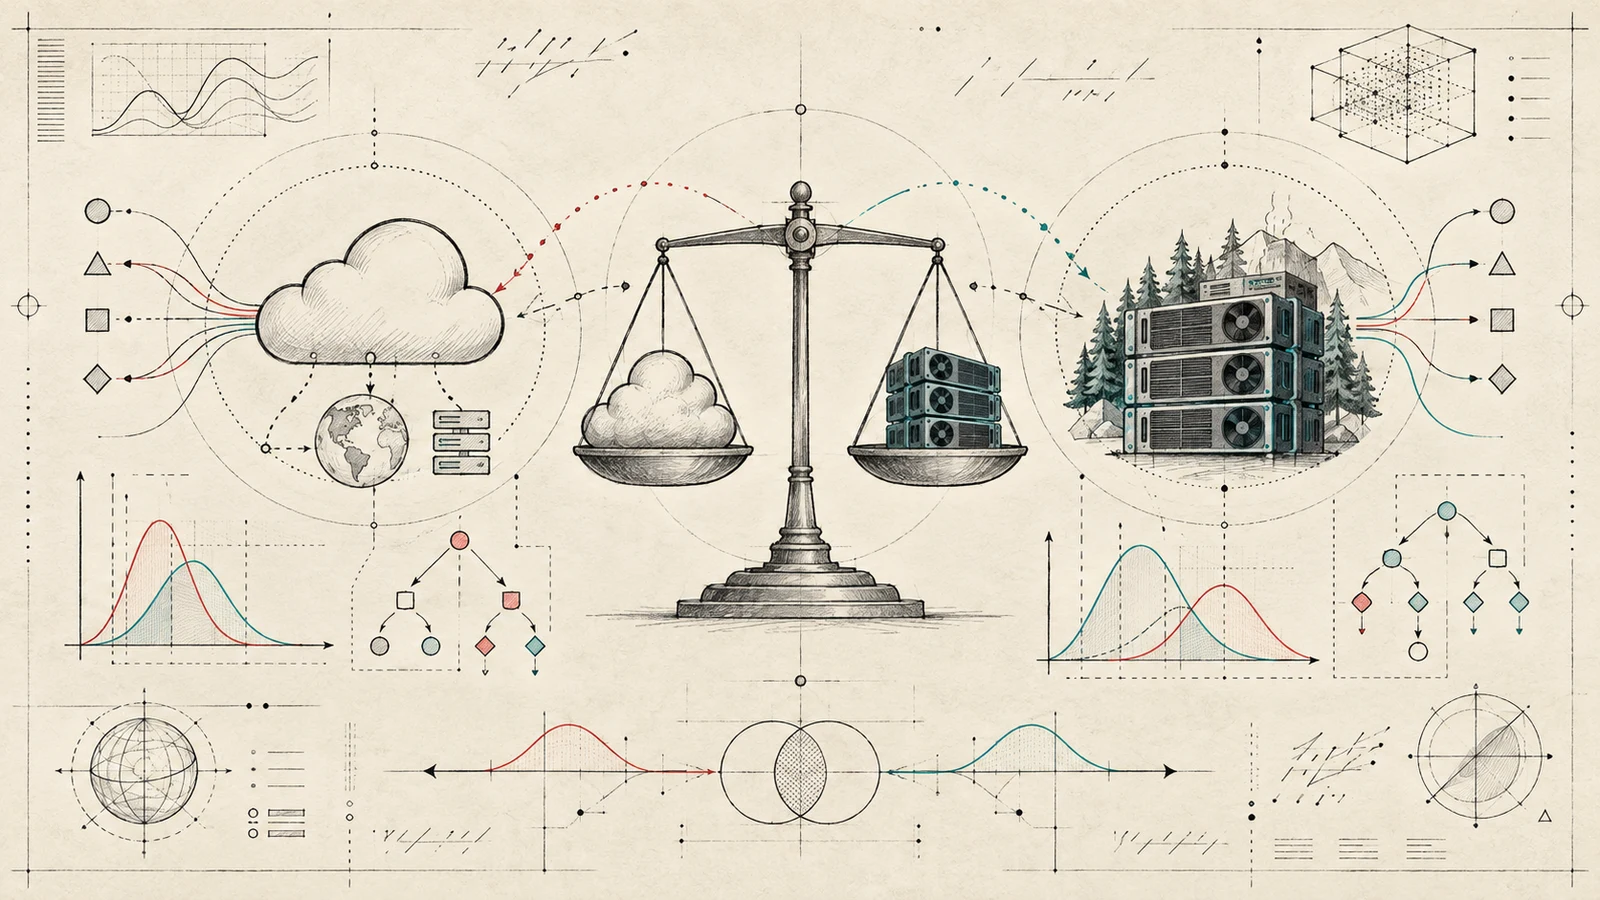
Beim Vergleich von Laya und Jev zählt vor allem die Betriebsgrenze Ihres Produkts. Jev ist eine sofort nutzbare, gehostete Entscheidungs-API. Laya bietet offene Gewichte, die Sie selbst betreiben und anpassen können. Gelabelte Daten, Datenschutz, Sprachen, Kontextlänge und Betriebskapazität bestimmen die Wahl.
Die Zahlen unten stammen aus JevBench v1.3.0, geprüft am 22. September 2026. Sie beschreiben einen Benchmark und sind keine Garantie für jeden Arbeitsablauf.
Kurzantwort
AnforderungZuerst prüfenWarumKeine Labels oder kein Fine-Tuning-TeamJevFür sofortige Zero-Shot-Entscheidungen über eine Managed API ausgelegt.Daten müssen im eigenen Netzwerk bleibenLayaOffene Gewichte lassen sich lokal betreiben und anpassen.Lange Tickets, Dokumente oder TracesJevDer Vergleich nennt 64k Tokens Kontext pro Anfrage.Mehrsprachiges RoutingMehrsprachiger Laya-CheckpointEine mehrsprachige Variante ist verfügbar; jede Sprache muss getestet werden.Kein GPU-BetriebsteamJevKeine GPU-Bereitstellung, Checkpoint-Updates oder Inferenzüberwachung nötig.
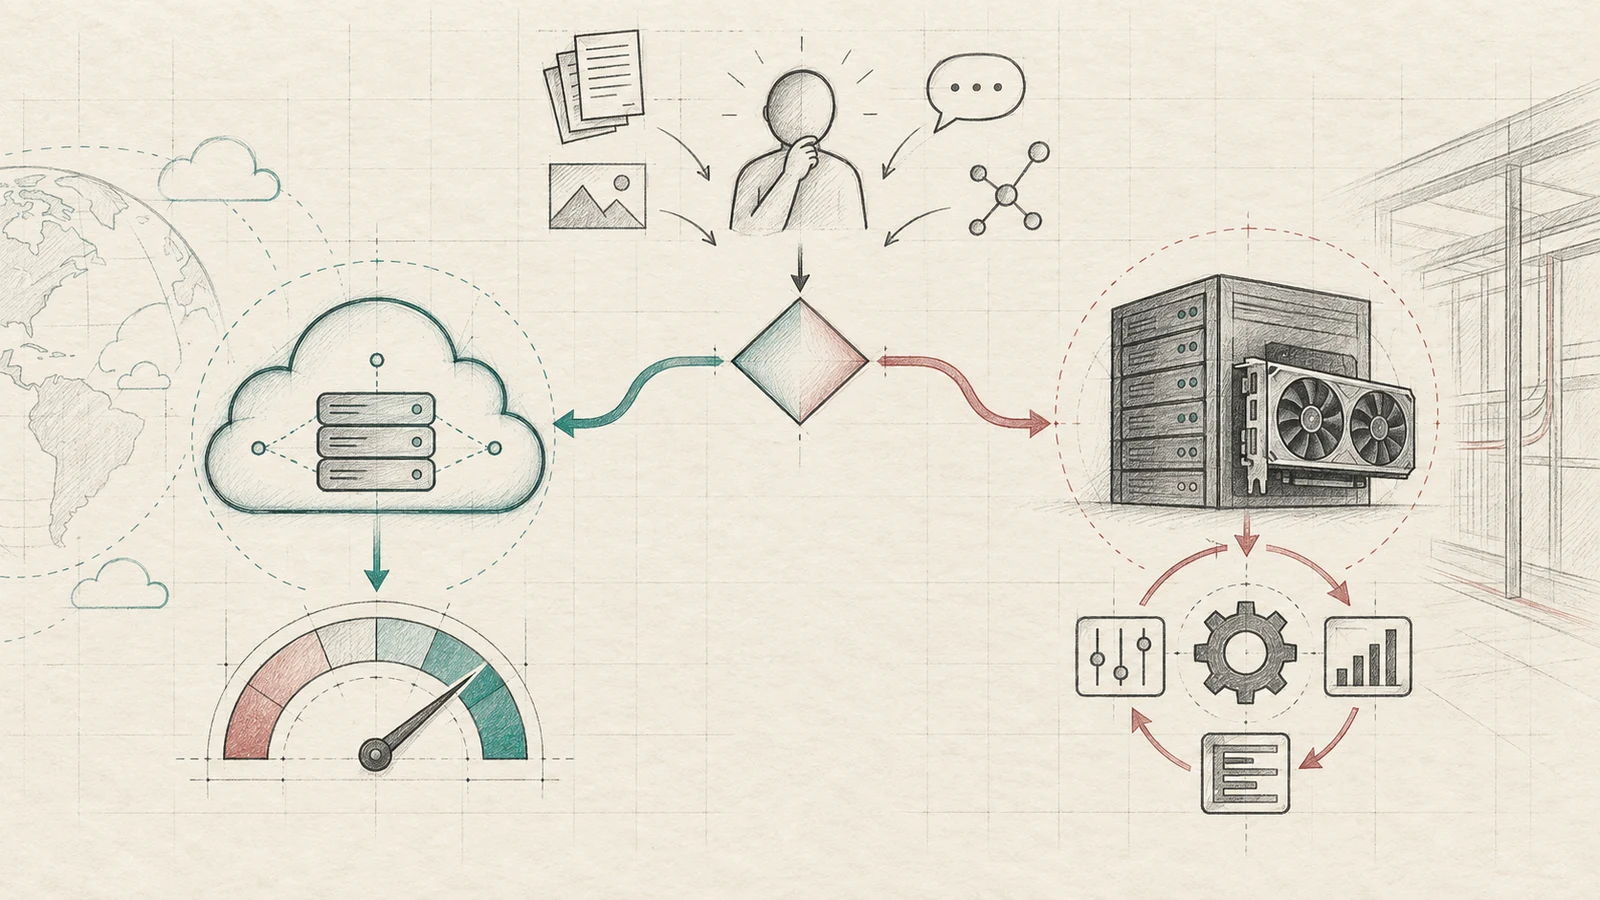
Was die beiden Systeme bieten
Beide beantworten strukturierte Fragen wie „welche Warteschlange?“, „ist das erlaubt?“ oder „welche Bewertung gilt?“. Sie können Freitextgenerierung mit nachfolgendem Parsing ersetzen.
-
Jev ist TypeSafes gehostete System-One-API. Der Vergleich nennt Zero-Shot-Nutzung, bis zu 64k Tokens Kontext pro Anfrage und maximal 255 Choice-Optionen. Sie rufen eine API auf, ohne eine GPU zu betreiben.
-
Laya ist ein offenes Entscheidungsmodell auf Basis eines Encoders. Die Apache-2.0-Implementierung kann lokal laufen und feinabgestimmt werden. Der getestete Checkpoint im Vergleich nutzt 512 Tokens pro Frage. Die Laya-Projektseite nennt je nach Checkpoint unterschiedliche Grenzen; prüfen Sie die konkrete Version.
Keines der Systeme ist ein allgemeiner Chatbot. Beide benötigen ein klares Schema, stabile Labels und Regeln für unsichere Antworten.
JevBench v1.3.0 lesen
Der Benchmark verglich 52 Systeme mit denselben 534 strukturierten Entscheidungen: 72 einfache, 96 standardisierte, 146 bewertungsartige und 220 schwierige Fälle. Jev erreichte 74,4 Punkte und Rang eins; Laya erzielte 54,4 Punkte und Rang 33.
MesswertJev 1.13.0LayaGesamtwert74,454,4Intelligenzwert85,745,8Kalibrierungswert82,762,5Genauigkeit bei schwierigen Fällen74,1 %34,1 %Genauigkeit bei Standardfällen99,0 %72,9 %
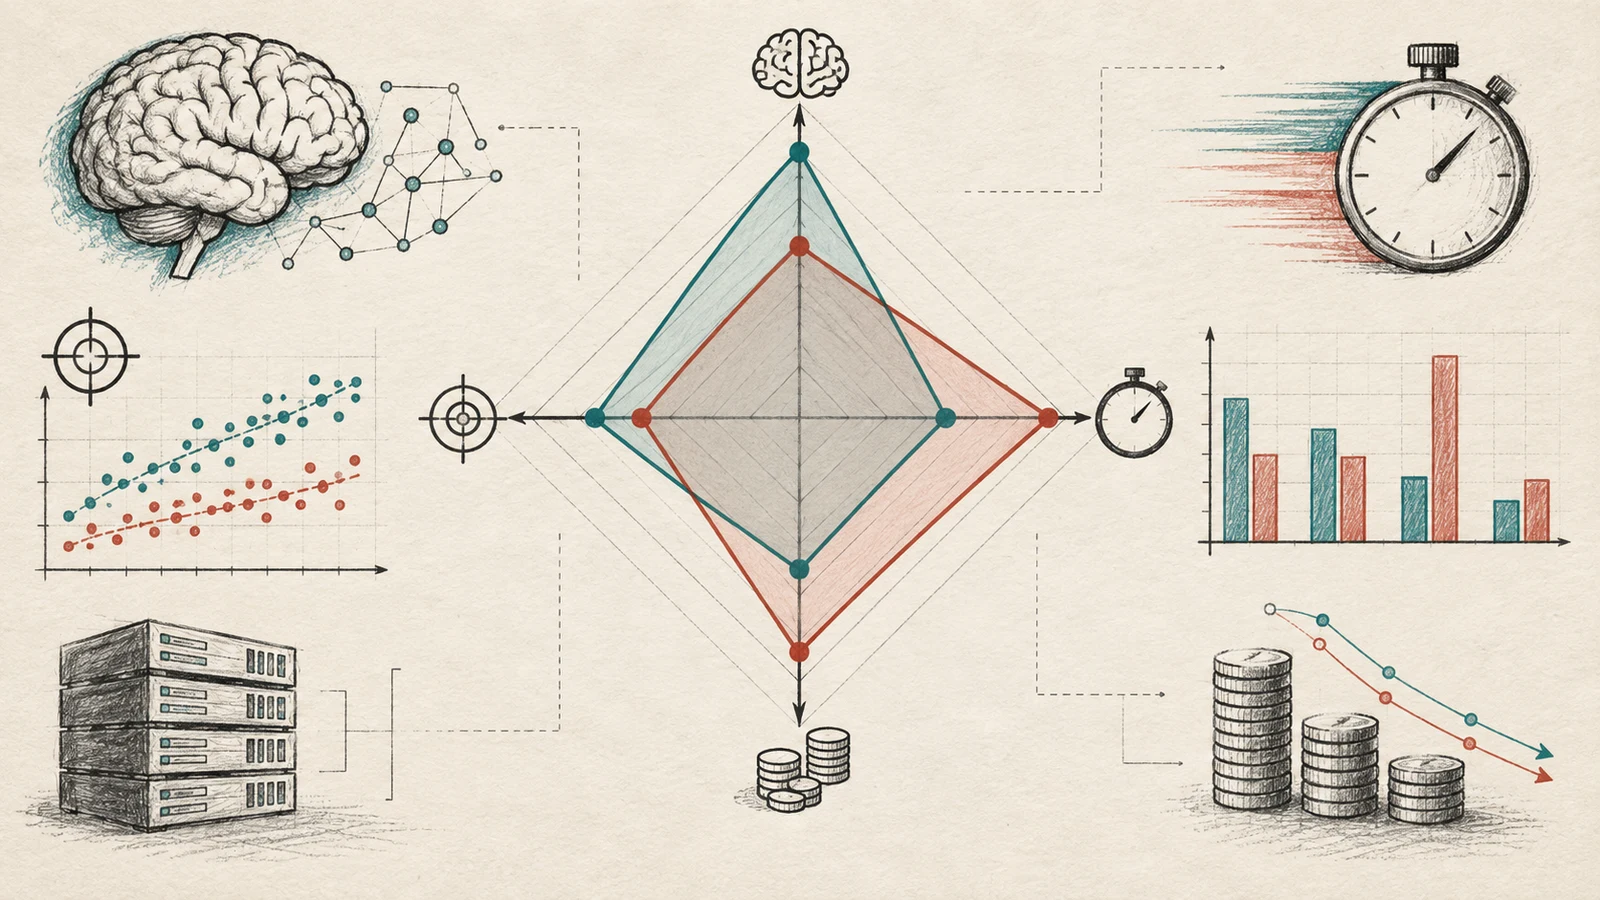
Diese Werte sind keine universelle Produktreihung. Sie spiegeln einen bestimmten Testsatz und eine nicht feinabgestimmte Laya-Konfiguration wider. Wenn Sie Laya mit stabilen Labels feinabstimmen, prüfen Sie den trainierten Checkpoint separat mit zurückgehaltenen Testdaten.
Kontext und Sprachen
Lange Eingaben enthalten oft genau die Passage, die eine Entscheidung verändert. Der Vergleich nennt für Jev 64k Tokens und für den getesteten Laya-Checkpoint 512 Tokens pro Frage. Die offizielle Laya-Seite unterscheidet englische und mehrsprachige Checkpoints; die Kontextlänge hängt daher von der Version ab. Messen Sie die Tokenisierung mit dem konkreten Modell und Eingabeformat.
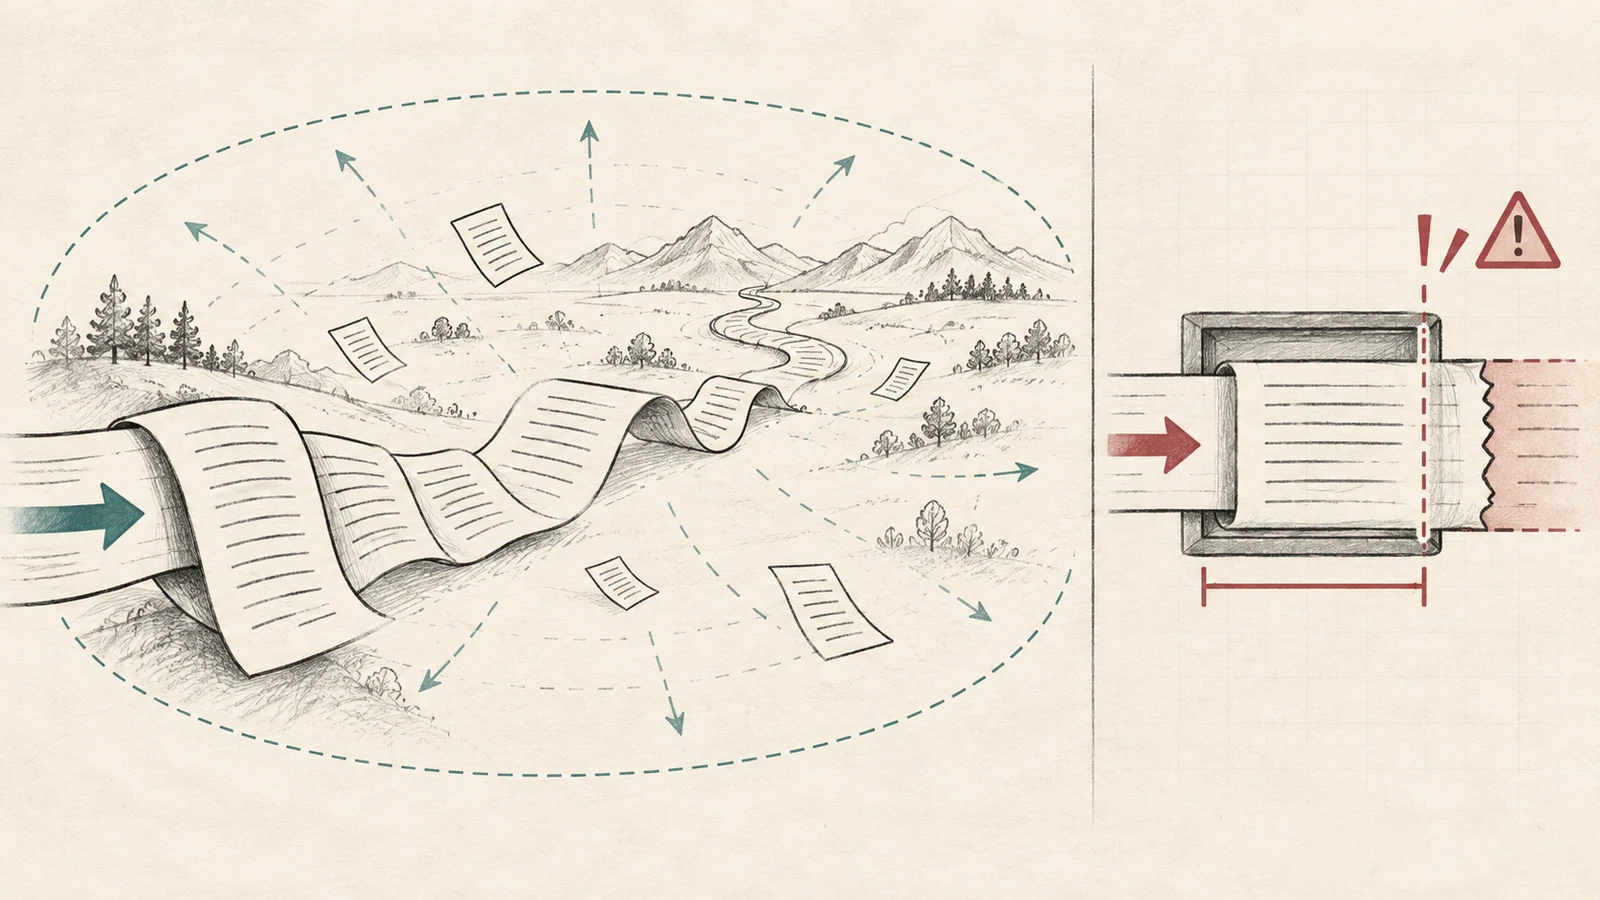
Der mehrsprachige Laya-Checkpoint ist interessant, wenn Englisch nicht genügt. Sprachabdeckung garantiert jedoch keine gleiche Qualität. Testen Sie Namen, Schriftsysteme, Sprachwechsel und Fachbegriffe pro Sprache.
Genauigkeit, Konfidenz und Latenz
Genauigkeit zählt richtige Labels. Kalibrierung prüft, ob eine Konfidenz von 0,8 bei ähnlichen Fällen ungefähr 80 Prozent Korrektheit bedeutet. Der Expected Calibration Error fasst für Konfidenzgruppen die Abweichung zwischen mittlerer Konfidenz und Genauigkeit zusammen.
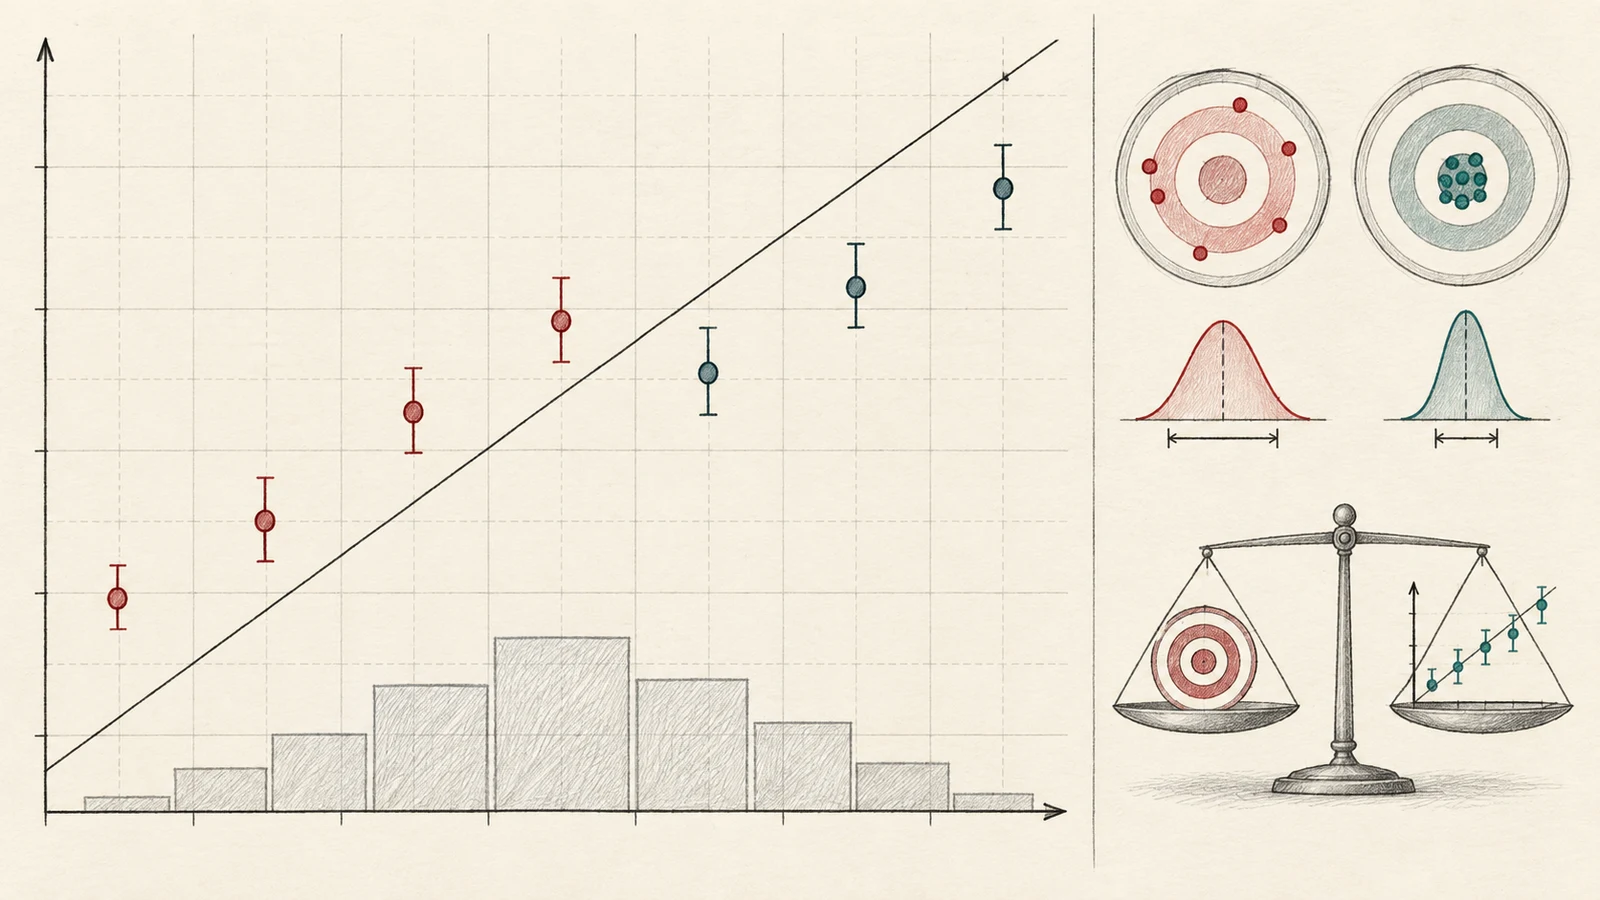
Im getesteten JevBench-Setup erzielt Jev den höheren Kalibrierungswert. Laya beschreibt Temperatur-Fitting zur aufgabenspezifischen Kalibrierung. Legen Sie Schwellenwerte anhand produktionsnaher Validierungsdaten fest und berichten Sie Genauigkeit gemeinsam mit Abdeckung: Mehr Enthaltungen können die Genauigkeit der beantworteten Fälle erhöhen.
Laya meldet Inferenzzeiten im zweistelligen Millisekundenbereich auf einer Tesla T4. Die Vergleichsseite nennt für den Laya-CPU-Lauf von JevBench 0,79 Sekunden roh und 1,72 Sekunden angepasst; Jevs gehosteter Median beträgt 0,65 Sekunden. Hardware und Serving-Pfad unterscheiden sich, daher ist das kein Direktvergleich. Messen Sie Netzwerk, Parallelität, Kaltstarts und P95 selbst.
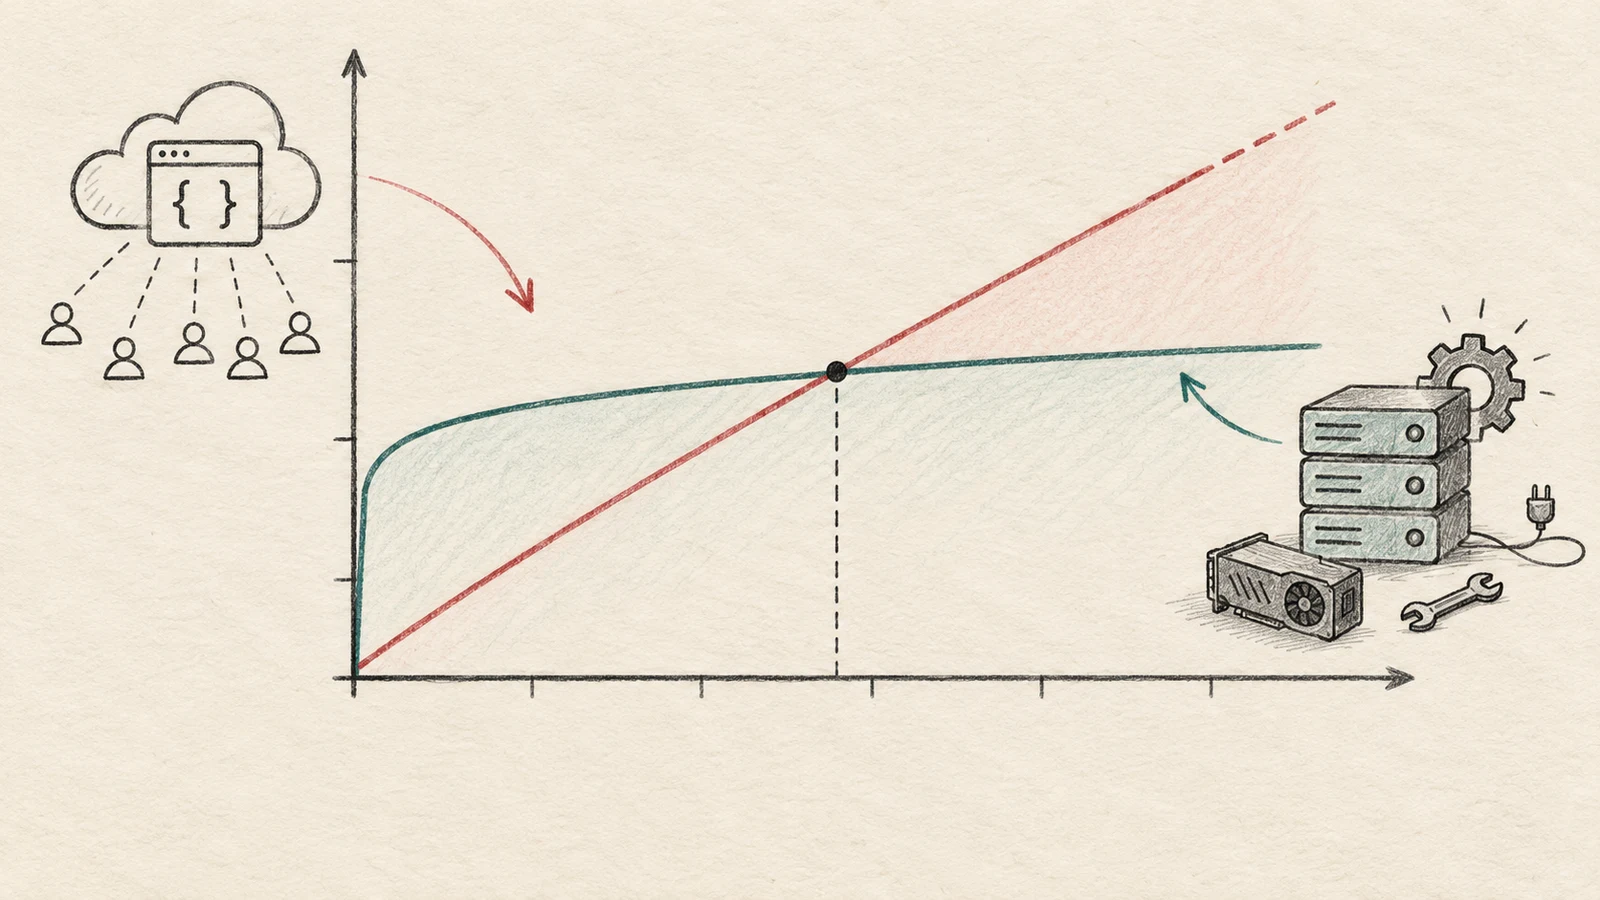
Bei den Kosten zählen API-Nutzung, GPU-Kapazität, Betrieb, Monitoring, Fine-Tuning und Leerlauf. Self-Hosting kann bei einer bereits ausgelasteten GPU günstig sein; dedizierte Kapazität und Wartung verändern die Gesamtrechnung.
Praktischer Evaluierungsplan
-
Eingabeschema, Labels, Gleichstandsregeln und „unbekannt“ festlegen.
-
Einen Holdout mit Routine-, Grenz-, Mehrsprachen-, Langkontext- und Hochrisikofällen erstellen.
-
F1 je Klasse, Verwechslungen, Kalibrierung, Abdeckung pro Schwelle und Enthaltungsrate vergleichen.
-
P50/P95-Latenz, Durchsatz, Kaltstart, Fehler und Abschneidungen messen.
-
Annotation, GPU-Auslastung, Hosting, Monitoring, Wartung und API-Kosten einrechnen.
-
Beide Systeme im Shadow-Betrieb mit menschlich geprüften Ergebnissen vergleichen, bevor folgenreiche Aktionen freigegeben werden.
Jev eignet sich als schnelle Baseline für Zero-Shot-Entscheidungen und Managed Serving. Prüfen Sie Laya, wenn offene Gewichte, Datenresidenz, Mehrsprachenrouting oder Fine-Tuning wichtig sind. Weitere Vergleiche: Jev vs. Laya, Jev vs. OpenJev und Jev vs. djev.
Häufige Fragen zu Jev vs. Laya
Kann Laya Jev direkt ersetzen?
Nicht in jedem Ablauf. Bei Laya wählen und betreiben Sie den Checkpoint selbst; Fine-Tuning und Kalibrierung können die Produktionsqualität beeinflussen. Jev ist eine Managed API mit anderer Datengrenze und Betriebsform.
Welches Modell ist schneller?
Das hängt von Hardware und Anfrageort ab. CPU-Benchmarks sind nicht direkt mit einer Tesla-T4-Angabe vergleichbar. Messen Sie Netzwerkzeit und P95-Latenz mit.
Welches Modell eignet sich besser für mehrere Sprachen?
Laya bietet einen mehrsprachigen Checkpoint. Die Jev-Vergleichsseite nennt ebenfalls über 100 Sprachen, aber geringere Zuverlässigkeit außerhalb des Englischen. Testen Sie Sprache und Domäne konkret.
Kann eine Konfidenzschwelle Entscheidungen auslösen?
Erst nach Prüfung von Kalibrierung und Fehlerkosten auf zurückgehaltenen Daten. Erfassen Sie Fehlfreigaben, Fehlablehnungen, Abdeckung und menschliche Prüfbelastung.
Quellen
Benchmarkzahlen stammen aus dem Jev-vs.-Laya-Vergleich und JevBench v1.3.0, geprüft am 22. September 2026. Checkpoint-Informationen bietet das Laya-Projekt und sein GitHub-Repository. Prüfen Sie vor dem Produktionseinsatz aktuelle Versionen, Grenzen und Preise.