API-Integration
Was ist die Decisions API? OpenAIs schnelle Entscheidungsschicht erklärt
Was ist die Decisions API? Erfahren Sie, wie OpenAIs Limited Preview begrenzte Klassifikation, Routing und nächste Agent-Schritte verarbeitet und wie man sie sicher evaluiert.
Was ist die Decisions API? OpenAIs schnelle Entscheidungsschicht erklärt
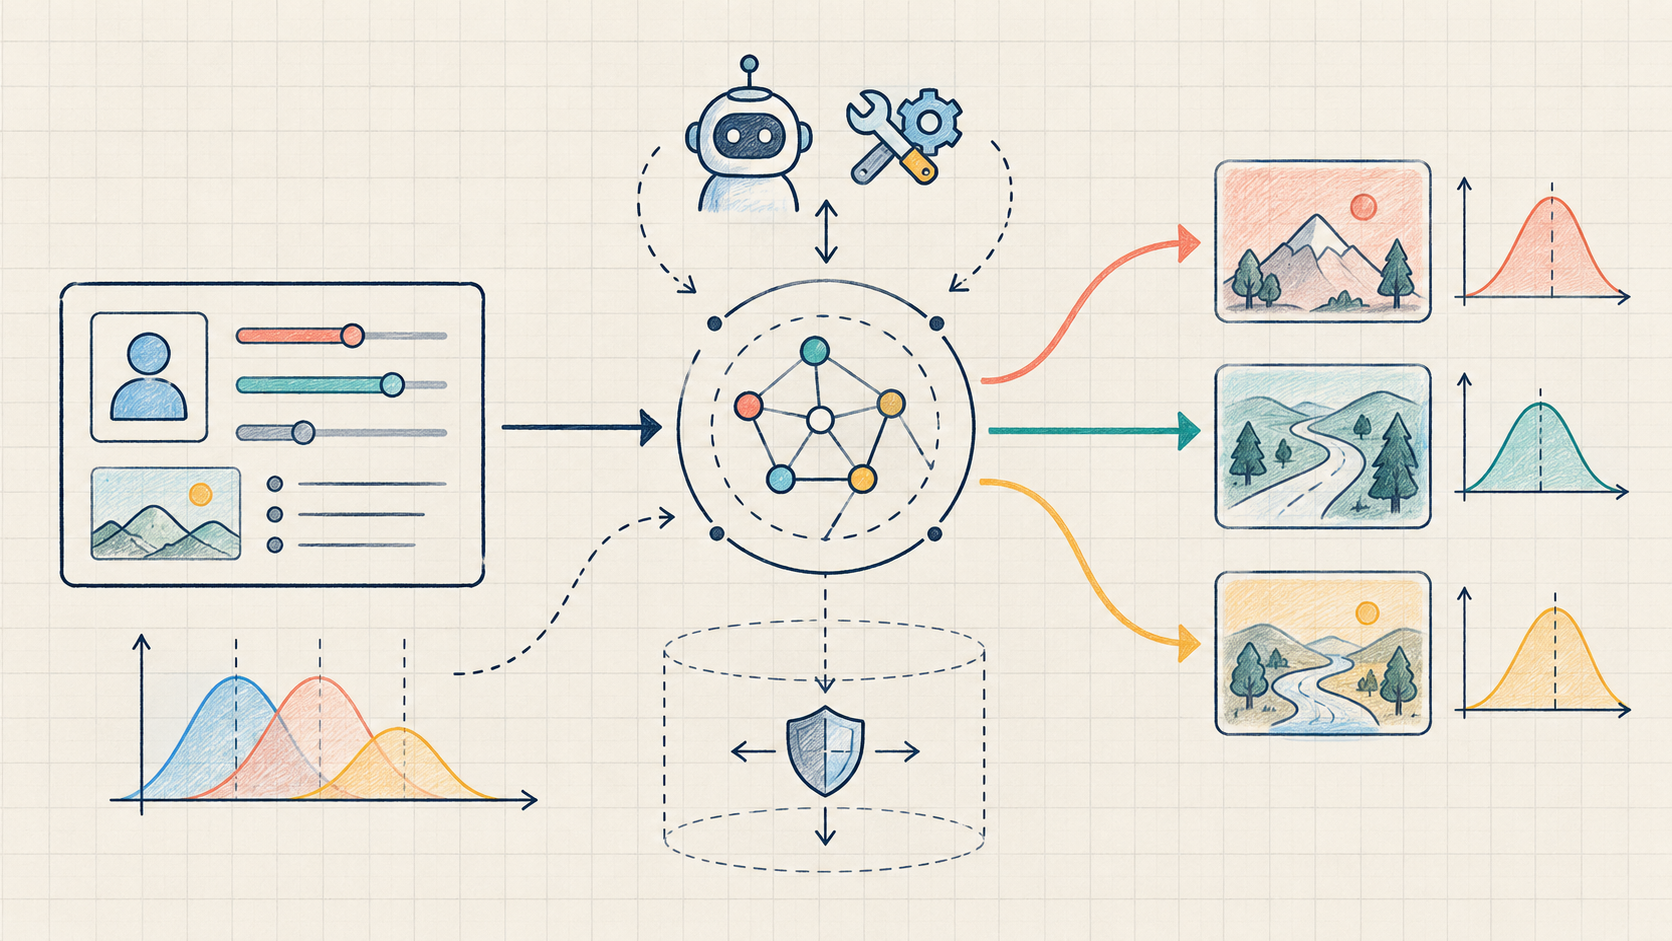
Wenn Sie nach was ist Decisions API suchen, lautet die kurze Antwort: Die OpenAI Decisions API ist eine Limited Preview für kleine, begrenzte Urteile innerhalb von Software. Statt ein allgemeines Modell einen Absatz schreiben zu lassen und diesen anschließend zu parsen, definiert ein Entwickler eine Frage, übergibt Kontext und lässt das System aus einer endlichen Menge von Antworten auswählen.
Dadurch eignet sich die API für Klassifikation, Request-Routing, Tool-Call-Gates und die Auswahl des nächsten Schritts in einer Agent-Schleife. Sie ersetzt kein allgemeines Chat- oder Reasoning-Modell. Sie ist eine schmalere Schicht zwischen Anwendungszustand und deterministischem Code.
OpenAI hat die Decisions API auf dem DevDay 2026 vorgestellt. Die zeitnahe Berichterstattung beschreibt eine spezialisierte Version von GPT-6 Luna, Text- oder Bildkontext, vordefinierte Antworten und einen Start als Limited Preview. Außerdem werden etwa 150 Millisekunden Antwortzeit und ein ungefähr zehnfacher Geschwindigkeitsvorteil gegenüber einem regulären GPT-6-Luna-Aufruf genannt. Das sind veröffentlichte Angaben aus der Launch-Berichterstattung, keine Service-Level-Garantie.
Dieser Leitfaden erklärt das Konzept, behandelt Berichte aus der Startphase aber nicht als stabile API-Referenz. Preview-Vertrag, Preise, Limits und Zugangsregeln können sich ändern. Vor dem Einsatz in einem kritischen Workflow sollten Sie die aktuelle OpenAI-Dokumentation und Ihr Dashboard prüfen und die Architektur- und Evaluationsprinzipien dieses Artikels als Ausgangspunkt nutzen.
Inhaltsverzeichnis
- Die Decisions API in einem Satz
- Wie unterscheidet sich eine Decision API von einer Chat API?
- Wie funktioniert die Entscheidungsschleife?
- Wofür kann man die Decisions API einsetzen?
- Wie könnte eine Integration aussehen?
- OpenAI Decisions API im Vergleich zu Jev
- Wo gehört sie in einen KI-Agenten?
- Latenz, Kosten und Confidence
- Was sollte vor dem Produktionseinsatz geprüft werden?
- Häufige Fragen
Die Decisions API in einem Satz
Die Decisions API ist eine entscheidungsorientierte Modellschnittstelle. Sie nimmt Anwendungskontext und eine begrenzte Frage entgegen und gibt eine strukturierte Auswahl zurück, die Software verwenden kann.
Das Wort begrenzt ist entscheidend. „Schreibe eine hilfreiche Antwort an diesen Kunden“ ist eine offene Generierungsaufgabe. „Welche freigegebene Warteschlange soll dieses Ticket bearbeiten?“ hat einen endlichen Antwortbereich. Auch „Benötigt dieser konkrete Tool-Aufruf eine menschliche Bestätigung?“ ist begrenzt, wenn die Anwendung definiert, was „Bestätigung erforderlich“ bedeutet.
Eine nützliche Abstraktion lautet:
decision = f(state, question, allowed_answers)
Die Ausgabe ist kein fertiger Aufsatz für Leser, sondern ein Signal für das umgebende Programm. Das Programm muss die Antwort weiterhin validieren, Berechtigungen prüfen, Geschäftsregeln anwenden, das Ergebnis protokollieren und entscheiden, ob eine Aktion zulässig ist.
Die öffentliche Launch-Berichterstattung beschreibt die Preview als Lösung für schnelle Klassifikation, Routing und die Auswahl des nächsten Agent-Schritts. Sie soll Text- oder Bildkontext und eine begrenzte, vom Entwickler festgelegte Antwortliste verarbeiten. Das konkrete Request- und Response-Schema sollte als vorläufig gelten, bis OpenAI die offizielle Referenz aktualisiert.
Wie unterscheidet sich eine Decision API von einer Chat API?
Die meisten Modellintegrationen sind chatförmig: Nachrichten gehen hinein und freier Text kommt heraus. Diese Flexibilität ist wertvoll, wenn ein Produkt Erklärungen, Entwürfe, Synthese oder offenes Reasoning benötigt. Sie ist weniger praktisch, wenn das Modell in einer Kontrollschleife steckt, die tausende Male pro Tag läuft.
Nehmen wir an, ein Supportsystem erhält dieses Ticket:
Der Kunde wurde doppelt belastet, und Auszahlungen sind seit drei Tagen fehlgeschlagen.
Ein allgemeines Modell kann einen brauchbaren Absatz schreiben, der Billing, Zahlungen und Dringlichkeit erwähnt. Die Anwendung muss daraus anschließend eine Route extrahieren, das Label validieren, zusätzliche Formulierungen behandeln und auf Formatabweichungen reagieren. Eine begrenzte Frage beginnt stattdessen mit dem Softwarevertrag:
Frage: Welche freigegebene Warteschlange ist für dieses Ticket zuständig?
Antworten: billing, technical, account, none_of_the_above
Kontext: <Ticketzustand>
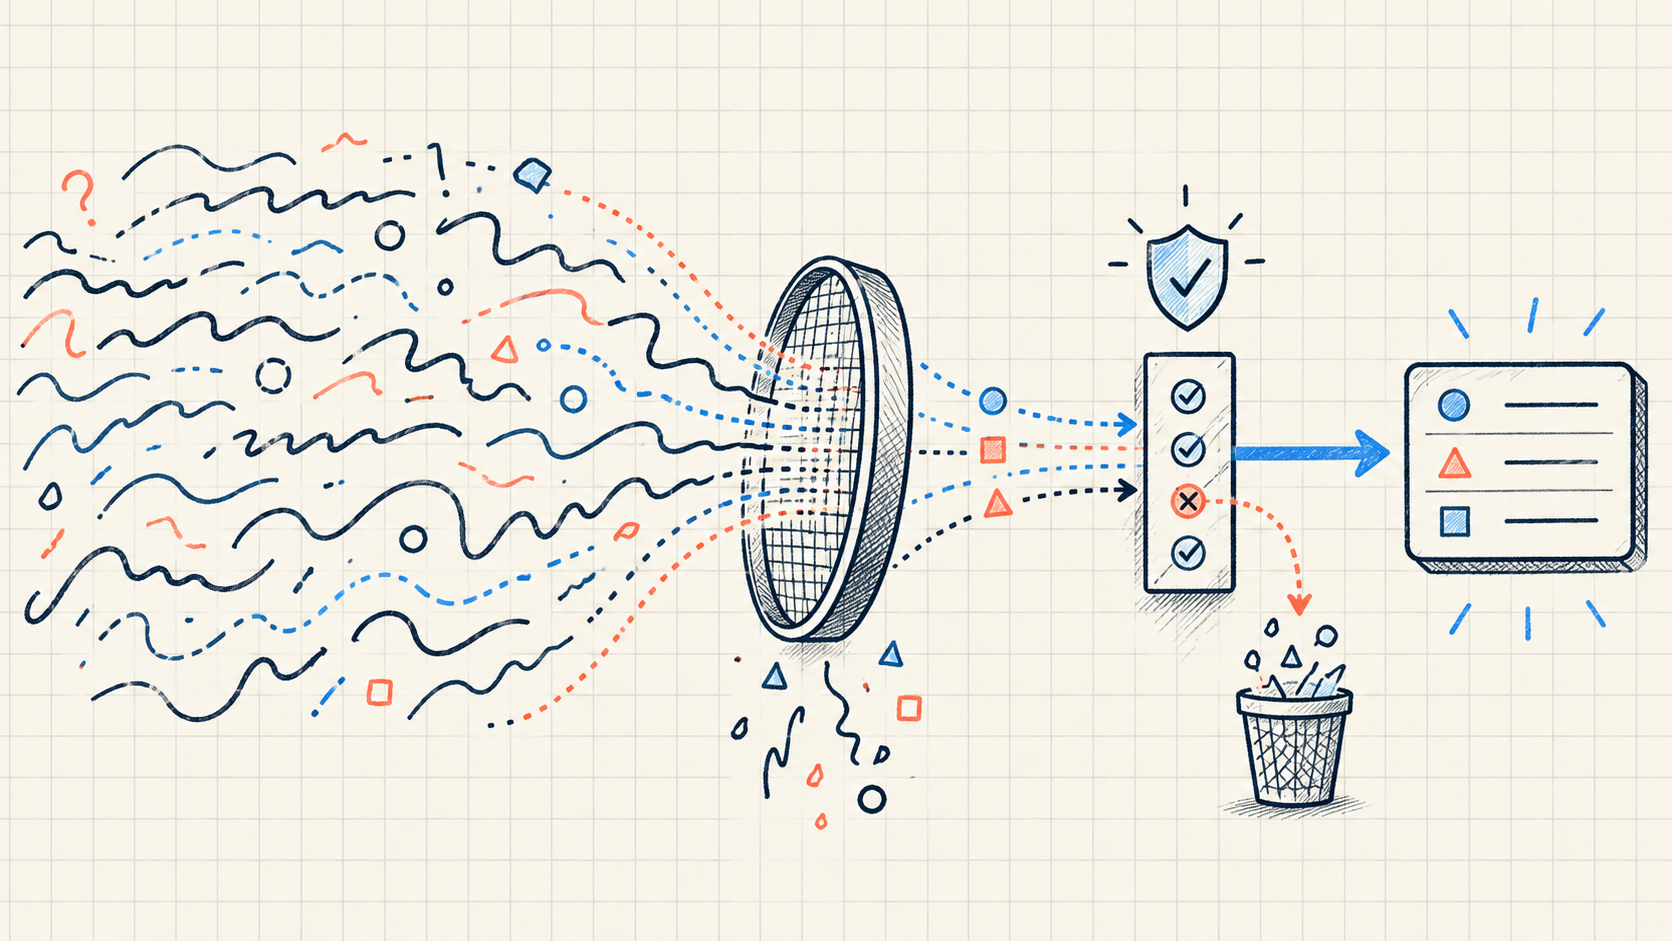
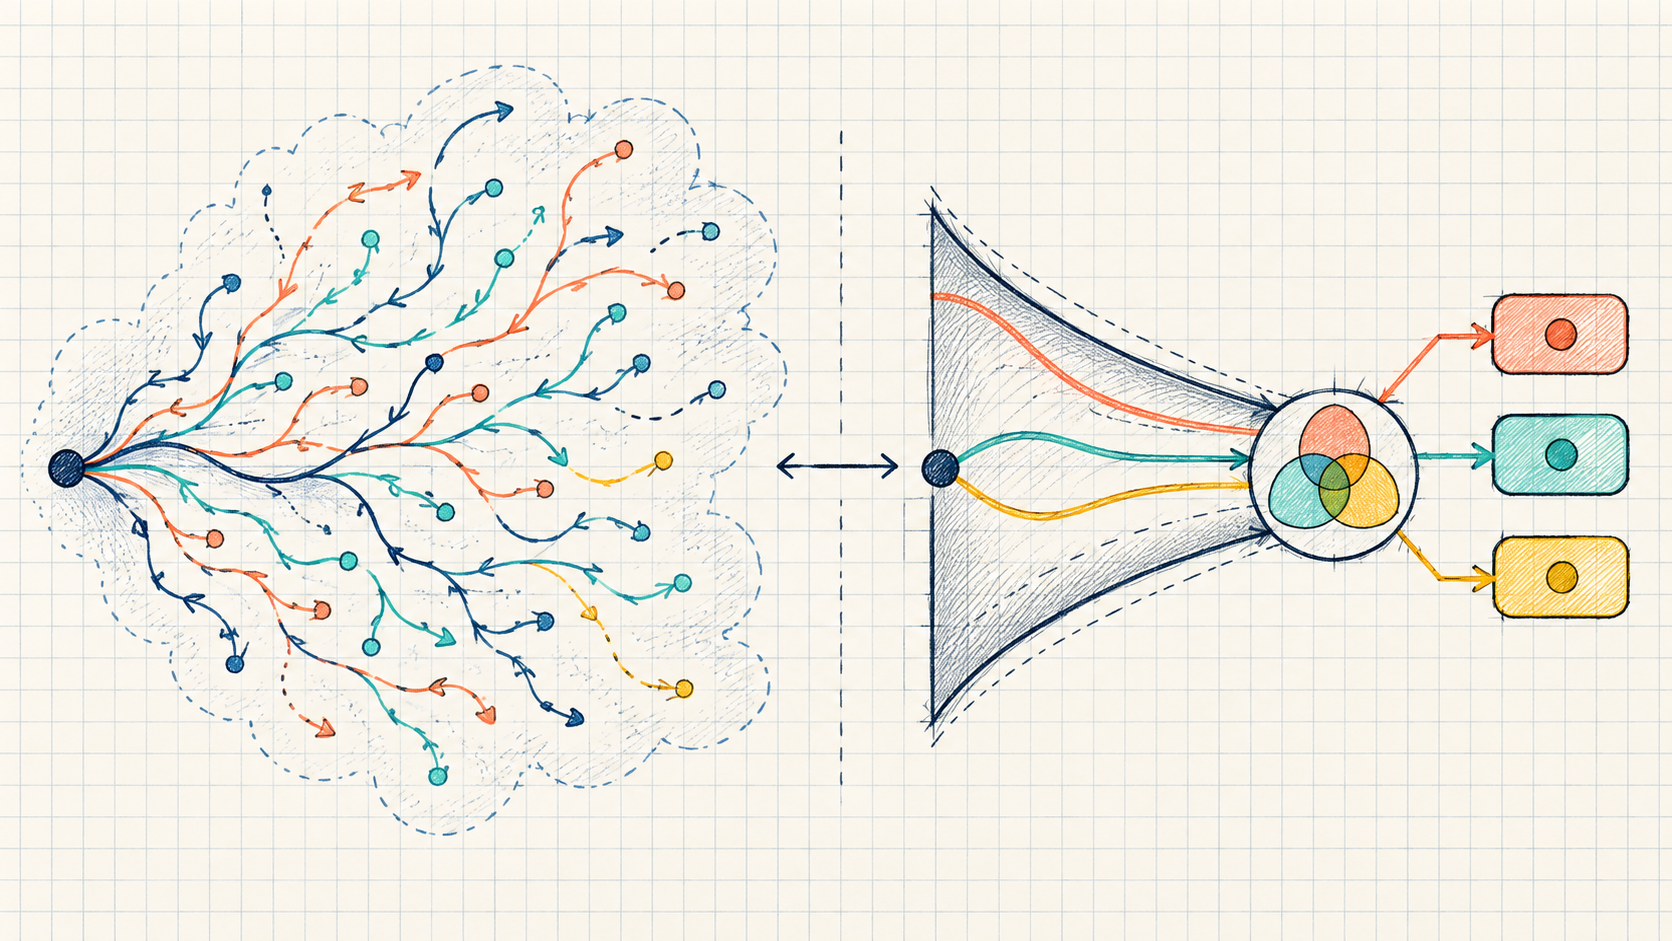
Der Unterschied ist nicht nur „JSON gegen Text“. Structured Output kann ein generatives Modell auffordern, mehrere Felder als JSON zu formatieren. Eine Decision API ist um die semantische Auswahl herum gebaut: Der Antwortbereich wird vor der Inferenz festgelegt, und das Ergebnis soll als Entscheidungssignal verwendet werden.
Die beiden Wege lassen sich so zusammenfassen:
Chatmodell:       Prompt -> Prosa -> Parser -> Validierung -> Retry -> Aktion
Entscheidungsmodell: Zustand + begrenzte Frage -> Entscheidung -> Policy -> Aktion
Der zweite Weg ist kürzer, aber nicht automatisch sicher. Eine formal gültige Antwort kann falsch sein. Eine Confidence-Zahl kann schlecht kalibriert sein. Ein Modell darf keine Berechtigung erhalten, nur weil es „sicher“ ausgewählt hat. Der Vorteil ist die klarere Grenze: Modellurteil auf der einen, deterministische Autorität auf der anderen Seite.
Die praktische Designregel
Verwenden Sie eine Decision API, wenn die Anwendung den Antwortbereich vor dem Aufruf aufschreiben kann. Verwenden Sie ein allgemeines Modell, wenn Sprache erzeugt, Möglichkeiten erkundet oder ein Plan erstellt werden muss, der sich nicht auf wenige freigegebene Ergebnisse reduzieren lässt.
Wie funktioniert die Entscheidungsschleife?
Eine zuverlässige Integration lässt sich in vier Schritte zerlegen.
1. Nur den für eine Entscheidung nötigen Zustand erfassen
Der Zustand ist die Evidenz, die für die Entscheidung verfügbar ist: ein Ticket, eine E-Mail, ein geplanter Tool-Aufruf, ein Screenshot, ein kompaktes Objekt aus mehreren Diensten oder eine kurze Liste abgerufener Fakten.
Halten Sie ihn fokussiert. Wenn ein Routing nur Ticket, Kontostufe und die letzten Ereignisse benötigt, fügt ein vollständiges Gesprächsarchiv Rauschen, Latenz, Datenschutzrisiken und Kosten hinzu. Fragen Sie, was ein menschlicher Prüfer für diese eine Frage sehen müsste.
2. Eine begrenzte Frage formulieren
Die Frage sollte genau ein Urteil beschreiben. „Klassifizieren, priorisieren, erstatten und den Kunden benachrichtigen“ versteckt mehrere Policies. Teilen Sie es in einzelne Fragen oder Anwendungsschritte auf:
- Welches freigegebene Team ist zuständig?
- Wie hoch ist die betriebliche Auswirkung auf einer definierten Skala?
- Erfordert die nächste Aktion menschliche Freigabe?
Jede Frage braucht einen Antwortbereich, den ein Prüfer verstehen kann. Fügen Sie mit none_of_the_above einen ausdrücklichen Ausweg hinzu, wenn die Realität nicht vollständig in die Kategorien passt.
3. Zulässige Antworten definieren
Die Anwendung sollte die Optionen besitzen. Für Routing können es billing, technical, account und manual_review sein; für ein Tool-Gate allow, confirm und block. Für Prioritäten sollte ein Rubric mit operativen Definitionen verwendet werden, nicht nur „niedrig“ und „hoch“.
Das Fragendesign ist Teil der Produkt-Policy. Wenn sich Optionen ändern, ändern sich auch die Bedeutungen historischer Ergebnisse. Versionieren Sie deshalb Frage, Rubric und Policy gemeinsam mit der Modellkennung.
4. Vor der Ausführung die Policy anwenden
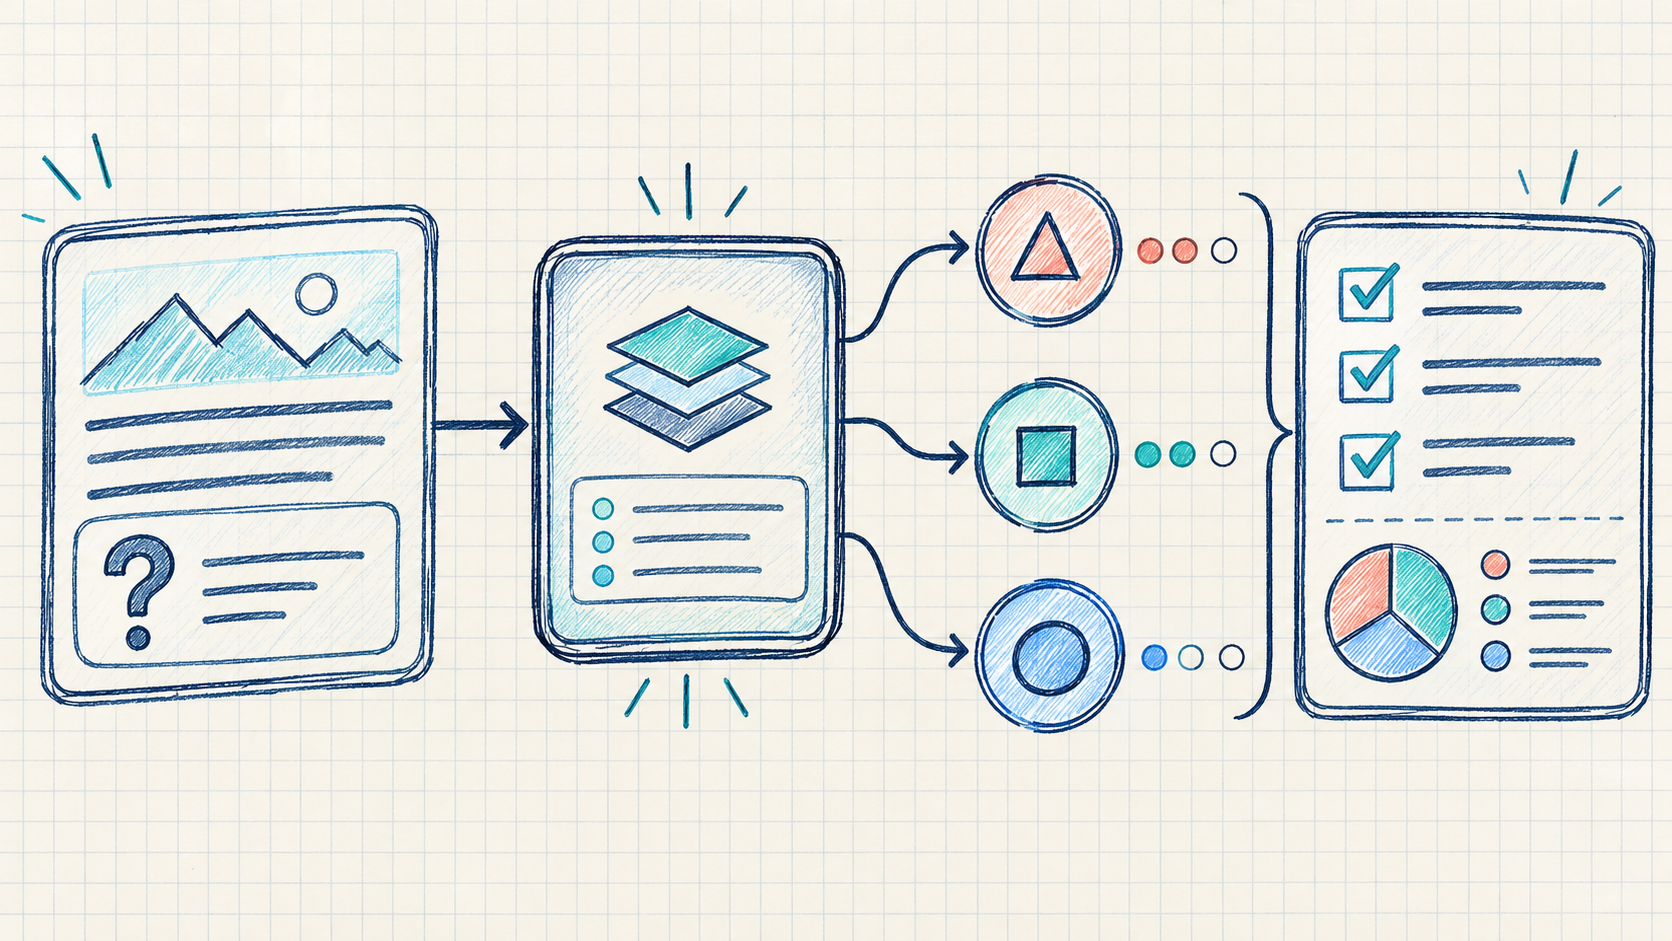
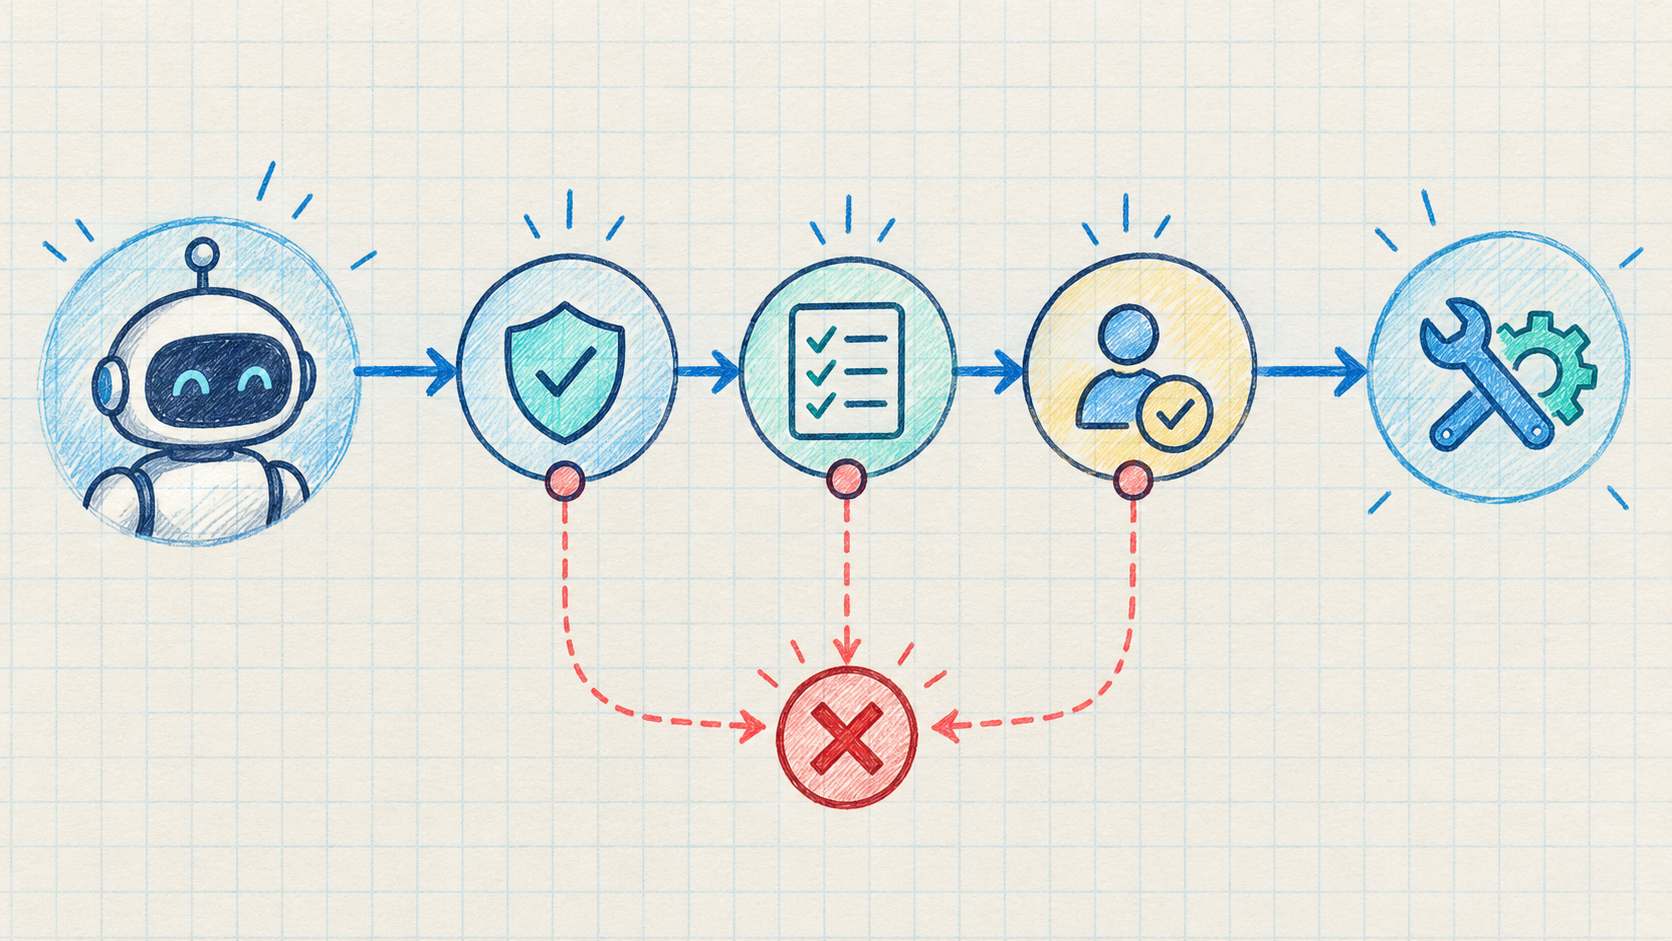
Die Antwort ist ein Signal. Die Anwendung muss weiterhin Berechtigungen, Ressourcenumfang, Datenvalidität und Regeln für Seiteneffekte prüfen. Ein Modell darf refund_review empfehlen; eine Rückerstattung darf nur ein autorisierter Dienst oder Mensch freigeben.
Die sichere Formel lautet:
ausführbarer Pfad = Modellurteil ∩ deterministische Policy
Der Schnitt ist der entscheidende Punkt. Das Entscheidungsmodell verarbeitet ein semantisches Urteil; der Code behält die Autorität.
Wofür kann man die Decisions API einsetzen?
Die besten Einsatzfälle sind wiederholte, schmale Entscheidungen, bei denen das umgebende System die nächste Aktion bereits kennt.
Klassifikation und Routing
Routen Sie Tickets, Leads, Dokumente, Vorfälle oder Moderationsereignisse in eine freigegebene Warteschlange. Die Route kann von Intent, Produktbereich, Schweregrad, Kundengruppe oder einer Kombination von Zustandsdaten abhängen. Ein Fallback verhindert, dass unbekannte Fälle in eine irreführende Kategorie gezwungen werden.
Den nächsten Agent-Schritt wählen
Ein Agent kann ein stärkeres Modell zum Verstehen des Ziels und Planen verwenden und anschließend eine schnelle Entscheidungsschicht für den nächsten Schritt nutzen: suchen, öffnen, ausfüllen, verifizieren, wiederholen, Hilfe anfordern oder abschließen. Die Host-Anwendung prüft weiterhin Verfügbarkeit und sichere Argumente.
Tool-Call- und Transaktions-Gates
Vor dem Versand einer E-Mail, einer Kontenänderung, einer Löschung, einer Zahlung oder einer Veröffentlichung kann eine enge Frage zur geplanten Aktion gestellt werden. Kombinieren Sie das Ergebnis mit Allowlist, Benutzerberechtigungen, Bestätigungsregeln und Audit-Logs. Das Modell hilft beim Interpretieren des Intents, ist aber nicht die einzige Autorisierungsschicht.
Modellrouting und Kostenkontrolle
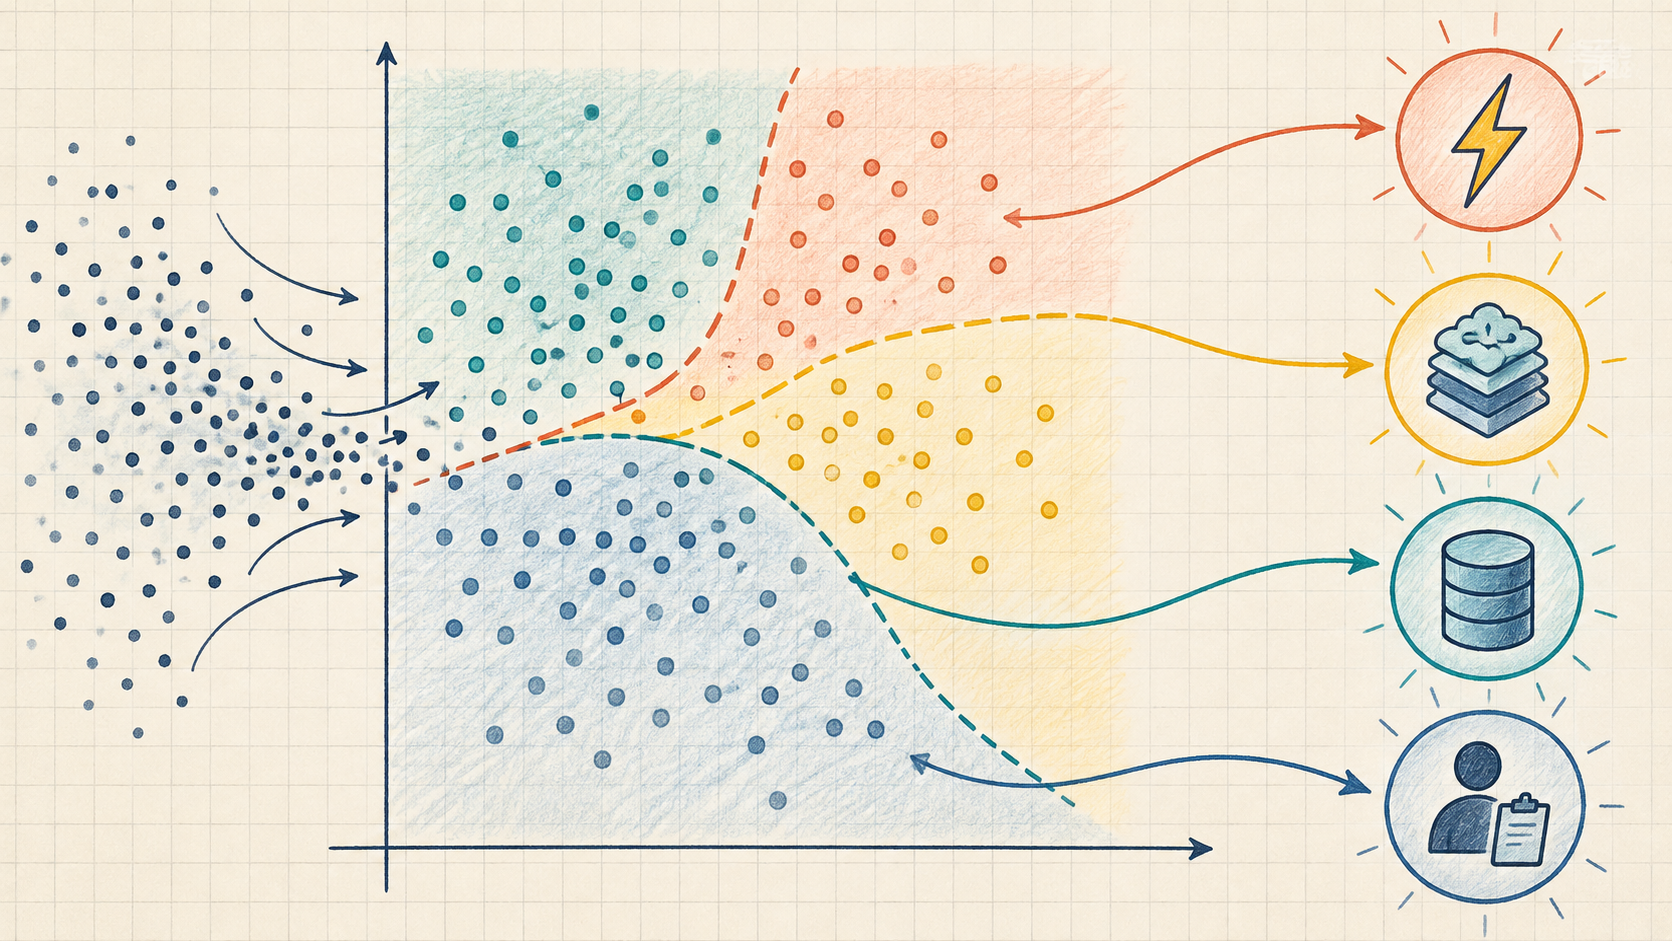
Nicht jede Anfrage benötigt ein Frontier-Modell. Eine Entscheidungsschicht kann einfache Aufgaben an einen schnellen Klassifikator, schwierige an ein stärkeres Modell, unsichere an Retrieval und sensible an einen Menschen routen. Geroutet werden sollten Fähigkeiten mit bekannten Eingaben, Latenzbereichen, Kosten und Fallbacks, nicht beliebige Modellnamen in einem Prompt.
Triage und Priorisierung
Queues benötigen oft ein konsistentes Prioritätssignal statt einer Zusammenfassung. Ein Score ist nützlich, wenn das Rubric die operative Bedeutung jeder Stufe erklärt. „Service blockiert“ und „geringe Auswirkung“ sind besser testbar als undefiniertes „dringend“.
Visuelle Entscheidungen
Die Launch-Berichterstattung nennt Bildkontext als Preview-Funktion. Damit könnten etwa bekannte UI-Zustände in Screenshots erkannt oder bildbasierte Meldungen geroutet werden. Verifizieren Sie Formate, Größenlimits, Datenschutz und Genauigkeit an eigenen gelabelten Beispielen, bevor Sie daraus eine Produktionsannahme machen.
Wie könnte eine Integration aussehen?
Da sich der Preview-Vertrag ändern kann, sollte kein inoffizielles Payload direkt in die Produktion kopiert werden. Kapseln Sie den Anbieter hinter einem kleinen Adapter. Das folgende Beispiel ist konzeptionelles Pseudocode:
{
  "context": {
    "ticket": "The customer was charged twice.",
    "account_tier": "business",
    "recent_events": ["payment_succeeded", "payment_succeeded"]
  },
  "question": {
    "name": "route",
    "prompt": "Which approved workflow owns this case?",
    "answers": ["refund_review", "technical_support", "account_security"]
  }
}
Der Adapter sollte die Antwort als unknown validieren, Optionen außerhalb der Allowlist ablehnen und Unsicherheit von Transportfehlern trennen. Ein Timeout ist kein selbstsicheres „Nein“.
const decision = await decisionsApi.evaluate(request);

if (!allowedRoutes.includes(decision.choice)) {
  return sendToManualReview('Unknown route');
}

if (decision.score < ROUTE_THRESHOLD || !policyAllows(decision.choice)) {
  return sendToManualReview('Uncertain or disallowed route');
}

return dispatch(decision.choice, { auditId, source: 'decisions-api' });
Die Feldnamen sind illustrativ. Nehmen Sie nicht an, dass score oder confidence eine kalibrierte Wahrscheinlichkeit ist. Protokollieren Sie Rohresultat, Frageversion, Policy-Version, Modellkennung, finale Aktion und späteres menschliches Ergebnis, um den Schwellenwert zu messen.
OpenAI Decisions API im Vergleich zu Jev
OpenAIs Preview und Jev gehören zu einer ähnlichen Kategorie: schnelle, strukturierte Entscheidungen in Software. Es handelt sich nicht um denselben Dienst, und die verfügbaren Informationen beschreiben unterschiedliche Verträge.
| Dimension | OpenAI Decisions API | Jev AI |
|---|---|---|
| Status laut aktueller Berichterstattung | Limited Preview seit DevDay 2026 | Öffentlicher Playground und API-Workflow |
| Berichtete Engine | Spezialisierte Version von GPT-6 Luna | Jev-Entscheidungsmodell |
| Öffentlich beschriebener Input | Text- oder Bildkontext | Text, JSON-Objekte und Textarrays auf der Produktseite |
| Ausgabeidee | Auswahl aus Entwicklerantworten, in Berichten mit Score | Typisierte Choice-, Score- und Noul-Ergebnisse mit Wahrscheinlichkeiten und Confidence |
| Beispiele | Klassifikation, Routing, nächster Agent-Schritt | Klassifikation, Routing, Scoring, Sicherheitschecks und Review-Gates |
| Vertragsreife | Endpoint, Limits, Preise und Zugriff in der Preview prüfen | Öffentliche Dokumentation und interaktiver Playground |
Die nützliche Frage lautet nicht „Welche Marke ist besser?“, sondern „Welchen Vertrag kann mein Team evaluieren und betreiben?“ OpenAI kann attraktiv sein, wenn Kontenkonsolidierung, Bildkontext oder Preview-Zugang zählen. Ein öffentliches typed-decision System kann attraktiver sein, wenn sofortiges Ausprobieren wichtig ist. In beiden Fällen: kleiner Antwortbereich, gelabelte Beispiele und Code als letzte Autorität.
Wo gehört sie in einen KI-Agenten?
Ein Produktionsagent hat meist mehrere getrennte Schichten:
- Orchestrator: verwaltet Aufgabe, Kontext, Retries und Schleifenstatus.
- Generatives Modell: interpretiert Intent, plant, schreibt Sprache oder fasst Evidenz zusammen.
- Entscheidungsschicht: beantwortet enge Fragen zu Route, Risiko, Priorität oder Abschluss.
- Policy und Berechtigungen: erzwingen, was Benutzer, Agent und Tool tun dürfen.
- Aktions- und Audit-Schicht: führt freigegebene Calls aus und protokolliert das Ergebnis.
Die Decisions API gehört in Schicht drei und darf nicht stillschweigend Schicht vier werden. Das Modell kann sagen, dass ein Tool-Aufruf risikoarm wirkt; es darf keine Berechtigung vergeben, die der Policy-Engine fehlt.
Wählen Sie für den ersten Versuch eine reversible Entscheidung mit geringem Risiko:
historische Beispiele
        ↓
Frage + erlaubte Antworten
        ↓
Offline-Evaluation
        ↓
Shadow Traffic
        ↓
von Menschen freigegebene Automatisierung
        ↓
überwachter Produktionspfad
Für Geldbewegungen, Zugriff, Löschung, Sicherheit und Reputation ist Shadow Mode besonders wichtig. Vergleichen Sie die Modellentscheidung zunächst mit Human Labels oder einer vertrauenswürdigen Regel.
Latenz, Kosten und Confidence
Latenz
Die Launch-Berichte nennen etwa 150 Millisekunden und ungefähr die zehnfache Geschwindigkeit eines regulären GPT-6-Luna-Aufrufs. Für häufige Agent-Schleifen ist das interessant, aber die Anwendung sollte p50, p95 und p99 selbst messen. Netzwerk, Kontextgröße, Parallelität, Retries und Queueing können die Modellzeit übertreffen.
Kosten
Ein Decision Endpoint kann Kosten senken, wenn er lange Erklärungen vermeidet und einfache Aufgaben von teuren Modellen fernhält. Für die Wirtschaftlichkeit zählen aber auch Kontext, Retries, Observability, nachgelagerte Aufrufe und Human Review. Preview-Preise müssen im aktuellen OpenAI-Konto geprüft werden.
Confidence und Kalibrierung
Ein Score ist Evidenz, keine Berechtigung. 0.92 kann für eine bestimmte Sprache, Kundengruppe oder adversariale Eingabe trotzdem falsch sein. Messen Sie mindestens:
- Übereinstimmung mit geprüften Labels;
- False Positives und False Negatives für teure Aktionen;
- Automatisierungsabdeckung je Schwellenwert;
- Kalibrierung nach Klasse, Sprache, Inputtyp und Kundengruppe;
- Umfang und Lösungszeit menschlicher Reviews;
- Drift nach Modell-, Frage-, Policy- oder Produktänderungen.
Wenn die beste und die zweitbeste Option eng beieinanderliegen, kann das Top-Label fragil sein. Behalten Sie eine Abstention- oder Review-Route. Bei wichtigen Aktionen sollte das Entscheidungsmodell empfehlen, während Policy oder Mensch autorisiert.
Was sollte vor dem Produktionseinsatz geprüft werden?
Öffentliche Quellen beschreiben die Decisions API als Limited Preview. Prüfen Sie deshalb vor einer tiefen Integration:
- offiziellen Endpoint, Authentifizierungsumfang und aktuelles Request-Schema;
- ob Bildinput für Ihr Konto und Ihren Anwendungsfall aktiviert ist;
- Definition des Antwortsets und Unterstützung mehrerer Fragen;
- Bedeutung des Scores und seine Kalibrierung;
- Limits, Latenzerwartungen, Rate Limits, Retries und Fehlercodes;
- Datenaufbewahrung, Datenschutzkontrollen und regionale Verfügbarkeit;
- Abrechnung einschließlich fehlgeschlagener, wiederholter oder gebündelter Aufrufe;
- Modell-Pinning und Prozess für Preview-Änderungen.
Halten Sie die Integration hinter einem kleinen Provider-Adapter. Versionieren Sie Fragen und Policies, entfernen Sie sensible Zustände aus Logs und behandeln Sie Benutzerinhalte als Daten, nicht als Policy. Wenn der Anbieter nicht verfügbar ist, routen Sie in eine sichere Queue oder zu einem Menschen, statt zu raten.
Häufige Fragen
Ist die Decisions API ein Ersatz für ChatGPT oder eine allgemeine Responses API?
Nein. Sie ist eine spezialisierte Entscheidungsschicht. Generation, Planung, Tool-Orchestrierung, Erklärung und Benutzertext gehören in ein allgemeines Modell; ein Decision Endpoint passt für ein enges Urteil aus einer freigegebenen Menge.
Gibt die Decisions API Text zurück?
Die öffentliche Beschreibung betont die Auswahl aus Entwicklerantworten statt freie Absätze. Selbst wenn der Transport JSON nutzt, braucht die Anwendung vor allem den Entscheidungswert und Metadaten, nicht einen Text für Leser.
Kann sie den nächsten Agent-Schritt wählen?
Das ist einer der klarsten beschriebenen Anwendungsfälle. Begrenzen Sie die Aktionen und validieren Sie Tool, Argumente, Berechtigungen, Ressourcenumfang und Bestätigung vor der Ausführung.
Ist Confidence dasselbe wie Genauigkeit?
Nein. Confidence kann beim Ranking und Routing helfen, muss aber an realen Ergebnissen evaluiert werden. Für teure Entscheidungen gehören Schwellenwerte, Abstention, Human Review, deterministische Regeln und Monitoring dazu.
Sollten Entwickler sie jetzt einsetzen?
Wenn Ihr Konto Preview-Zugriff hat und der Workflow Vertragsänderungen toleriert, können Sie ein kontrolliertes Experiment starten. Beginnen Sie mit Offline- oder Shadow-Evaluation, nicht mit irreversibler Automatisierung. Untersuchen Sie zuerst das Muster typisierter Entscheidungen.
Was ist die wichtigste Erkenntnis?
Die Decisions API steht für den Wechsel von „Lass das Modell etwas schreiben“ zu „Lass das Modell ein kleines, typisiertes Urteil abgeben“. Das kann Klassifikation, Routing und Agent-Schleifen schneller und leichter integrierbar machen. Zuverlässigkeit entsteht weiterhin durch einen klaren Antwortbereich, echte Evaluation, Code als Autorität und Confidence als Evidenz statt als Berechtigung.
Quellen
- Offizielle OpenAI-DevDay-2026-Ankündigung
- The Decoder: OpenAI expands Codex and its API at DevDay.
- Pasquale Pillitteri: OpenAI launches Decisions API to take on Jev.