Agentes de IA
Cómo crear agentes de IA más fiables con Jev AI: enrutamiento, protecciones y revisión humana
Un agente de IA no debería dejar todas las decisiones en manos de un solo modelo de lenguaje. Aprende cómo Jev AI puede gestionar el enrutamiento de modelos, las comprobaciones de seguridad antes de usar herramientas, la puntuación de riesgos y la revisión humana, mientras el código conserva el control de la ejecución.
Cómo crear agentes de IA más fiables con Jev AI: enrutamiento, protecciones y revisión humana
El problema difícil de un agente de IA a menudo no es «¿puede responder el modelo?», sino si el agente debe actuar en el estado actual. Puede que tenga que elegir un modelo, llamar a una herramienta, pedir más información, detenerse o transferir la tarea a una persona.
Cuando todas las decisiones recaen en un LLM generativo, la planificación, la ejecución y la revisión de seguridad se mezclan. El modelo puede producir una explicación convincente sin ofrecer una señal de control estable, y resulta difícil saber si el fallo se debió a la comprensión, los permisos, una herramienta o un umbral.
Jev AI puede actuar como una capa de decisión independiente para un agente: recibe el State actual, evalúa preguntas breves de tipo Choice, Score o Noul y devuelve señales de probabilidad y confianza al código de orquestación. El agente ejecuta, Jev evalúa y las reglas junto con las personas forman la red de seguridad.
Esta guía presenta una arquitectura práctica de agentes para el enrutamiento de modelos, las protecciones previas al uso de herramientas, la puntuación de riesgos, la revisión humana y la evaluación en producción.
Principio básico: No dejes que un mismo modelo controle a la vez la comprensión, la decisión, la autorización y la ejecución. Divide el juicio en preguntas comprobables y reserva la acción final para código restringido.
Índice
- Por qué los agentes necesitan una capa de decisión
- Qué lugar ocupa Jev AI
- Patrón 1: enrutar el modelo antes de llamarlo
- Patrón 2: proteger las llamadas a herramientas
- Patrón 3: activar revisiones con probabilidades
- Diseñar el State y las preguntas del agente
- Lista de seguridad y evaluación
- Preguntas frecuentes
Por qué los agentes necesitan una capa de decisión
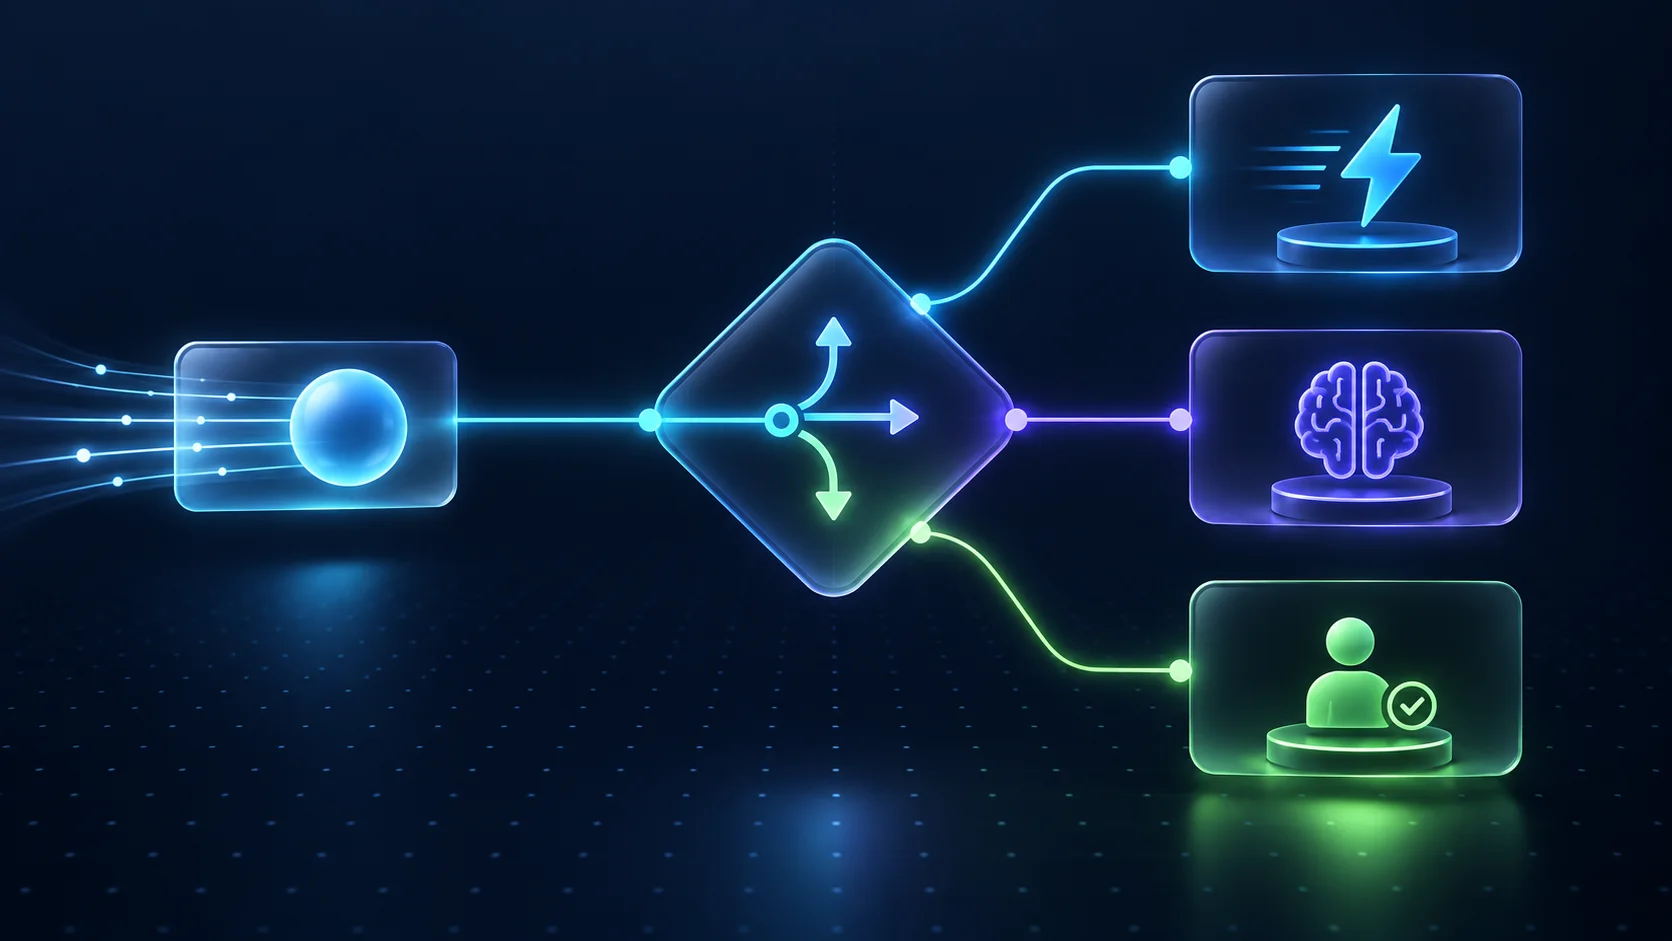
Imagen: Separar el juicio de la ejecución facilita probar el enrutamiento, las protecciones y las políticas de revisión.
El texto generado no es una autorización
Un LLM puede generar la frase «Voy a borrar este archivo», pero esa frase no debe otorgar permiso para borrarlo. La acción real debe pasar por el código de la aplicación, los permisos y la validación de los parámetros de la herramienta.
Tampoco debes tratar el resultado de Jev como una autorización. Puede evaluar si el usuario pidió explícitamente eliminar algo o si una solicitud parece arriesgada, pero las reglas deterministas y los sistemas de permisos deben decidir si se permite ejecutar la acción.
Los agentes toman muchas decisiones pequeñas
Un único turno del agente puede requerir:
- Clasificar el tipo y la dificultad de la tarea.
- Elegir un modelo rápido o uno más potente.
- Decidir si hace falta una herramienta externa.
- Validar el nombre de la herramienta, los argumentos y el recurso de destino.
- Puntuar el riesgo y decidir si se necesita confirmación.
- Continuar, reintentar, degradar el flujo o detenerse.
- Registrar el resultado y actualizar el contexto.
No todas estas tareas requieren razonamientos extensos. A menudo es más fácil mantenerlas si se dividen en preguntas atómicas, en vez de ampliar continuamente un prompt de sistema.
Qué lugar ocupa Jev AI
Una arquitectura clara por capas podría ser así:
user request
     ↓
state builder  ──► permissions and hard rules
     ↓
Jev decision layer
     ├─ route model
     ├─ score risk
     ├─ check intent
     └─ request human review
     ↓
orchestrator
     ├─ call LLM
     ├─ call tool
     └─ ask user
     ↓
validator + audit log
Jev no necesita conocer toda la implementación interna del agente. Solo necesita el State y las preguntas relevantes para el juicio actual. Los modelos, las herramientas y las políticas de negocio pueden evolucionar de forma independiente.
Si State, Choice, Score y Noul son nuevos para ti, empieza por el tutorial de la API de Jev AI. Para entender cómo se reparten el trabajo Jev y los LLM generativos, lee Jev AI frente a los LLM.
Patrón 1: enrutar el modelo antes de llamarlo
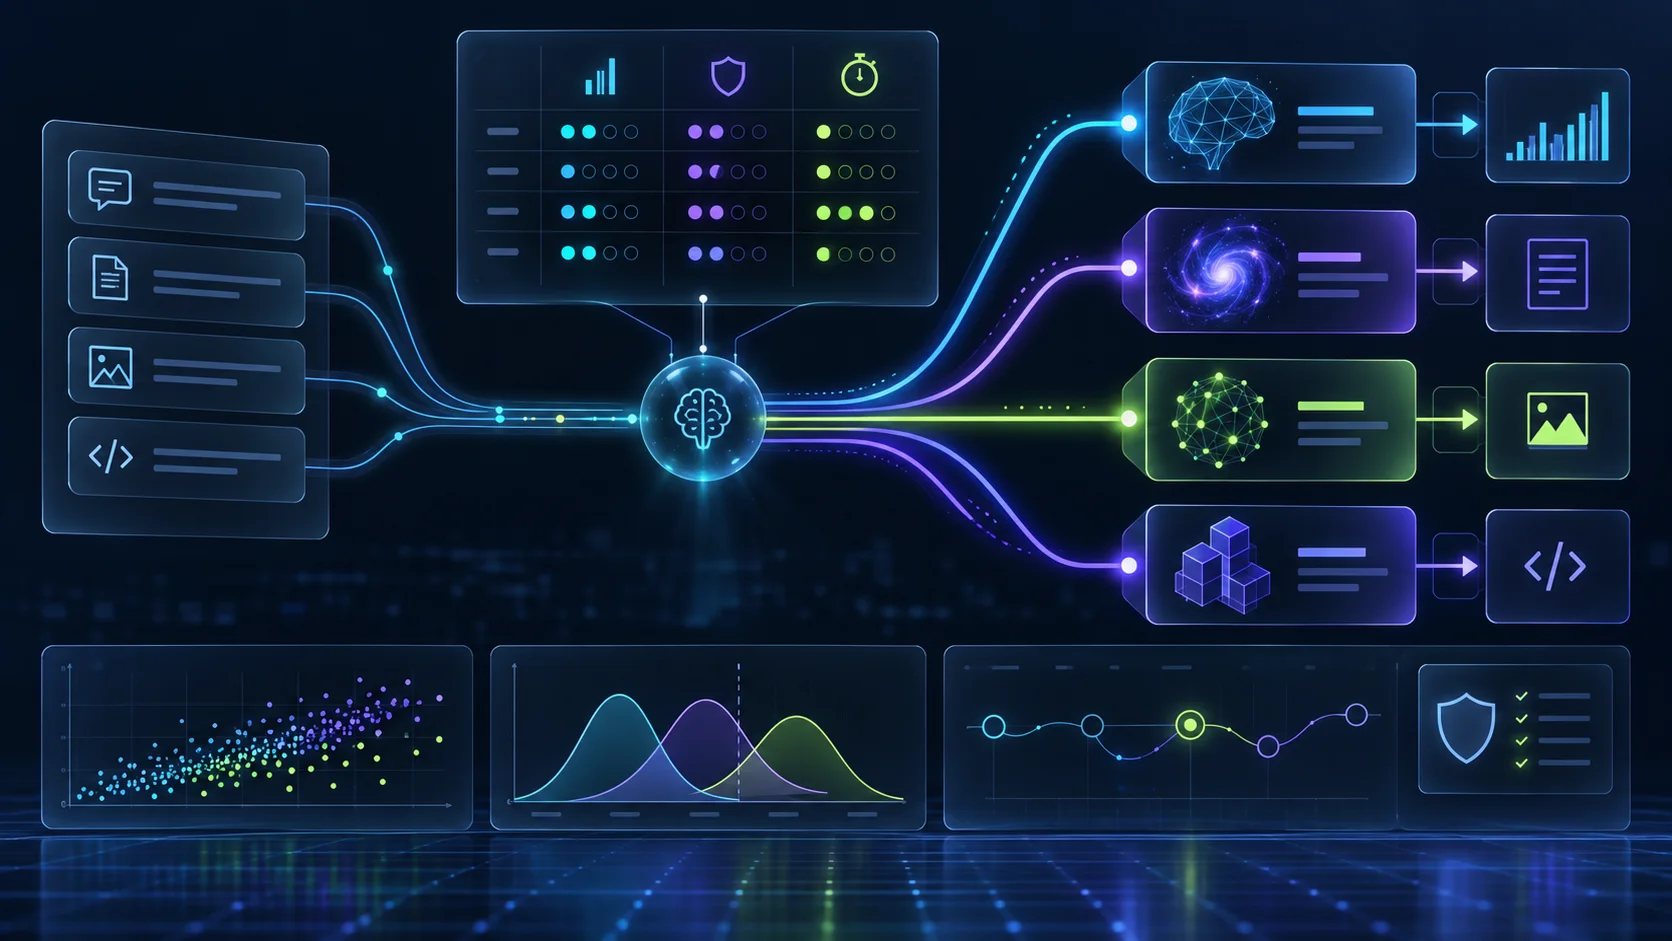
Un agente no debería enviar todas las solicitudes al modelo más caro y lento. Usa Jev para resolver preguntas concretas, como estas:
- ¿La tarea requiere razonamiento complejo?
- ¿Hace falta llamar a una herramienta?
- ¿Implica datos sensibles o una acción de gran impacto?
- ¿Bastaría con una respuesta breve?
Una estrategia práctica de enrutamiento
decision = jev.system_one(
    state={
        "request": user_message,
        "conversation_summary": summary,
        "available_tools": tool_catalog,
    },
    questions={
        "difficulty": Score(rubric=["simple", "moderate", "complex"]),
        "needs_tool": Noul("Does this request require a tool call?"),
        "sensitive": Noul("Does this request involve sensitive data or action?"),
    },
)
El orquestador puede enviar las tareas sencillas a un modelo rápido, las complejas a uno más potente y las sensibles a un flujo con protecciones. Jev propone una ruta, pero no concede el permiso final.
Errores de enrutamiento que conviene evitar
- No dejes que una sola puntuación decida todas las elecciones de modelo.
- No trates un umbral de probabilidad como una prueba de seguridad.
- No incluyas sin probar todo el catálogo de herramientas en cada State.
- No omitas la comprobación de permisos porque un juicio tenga mucha confianza.
Patrón 2: proteger las llamadas a herramientas
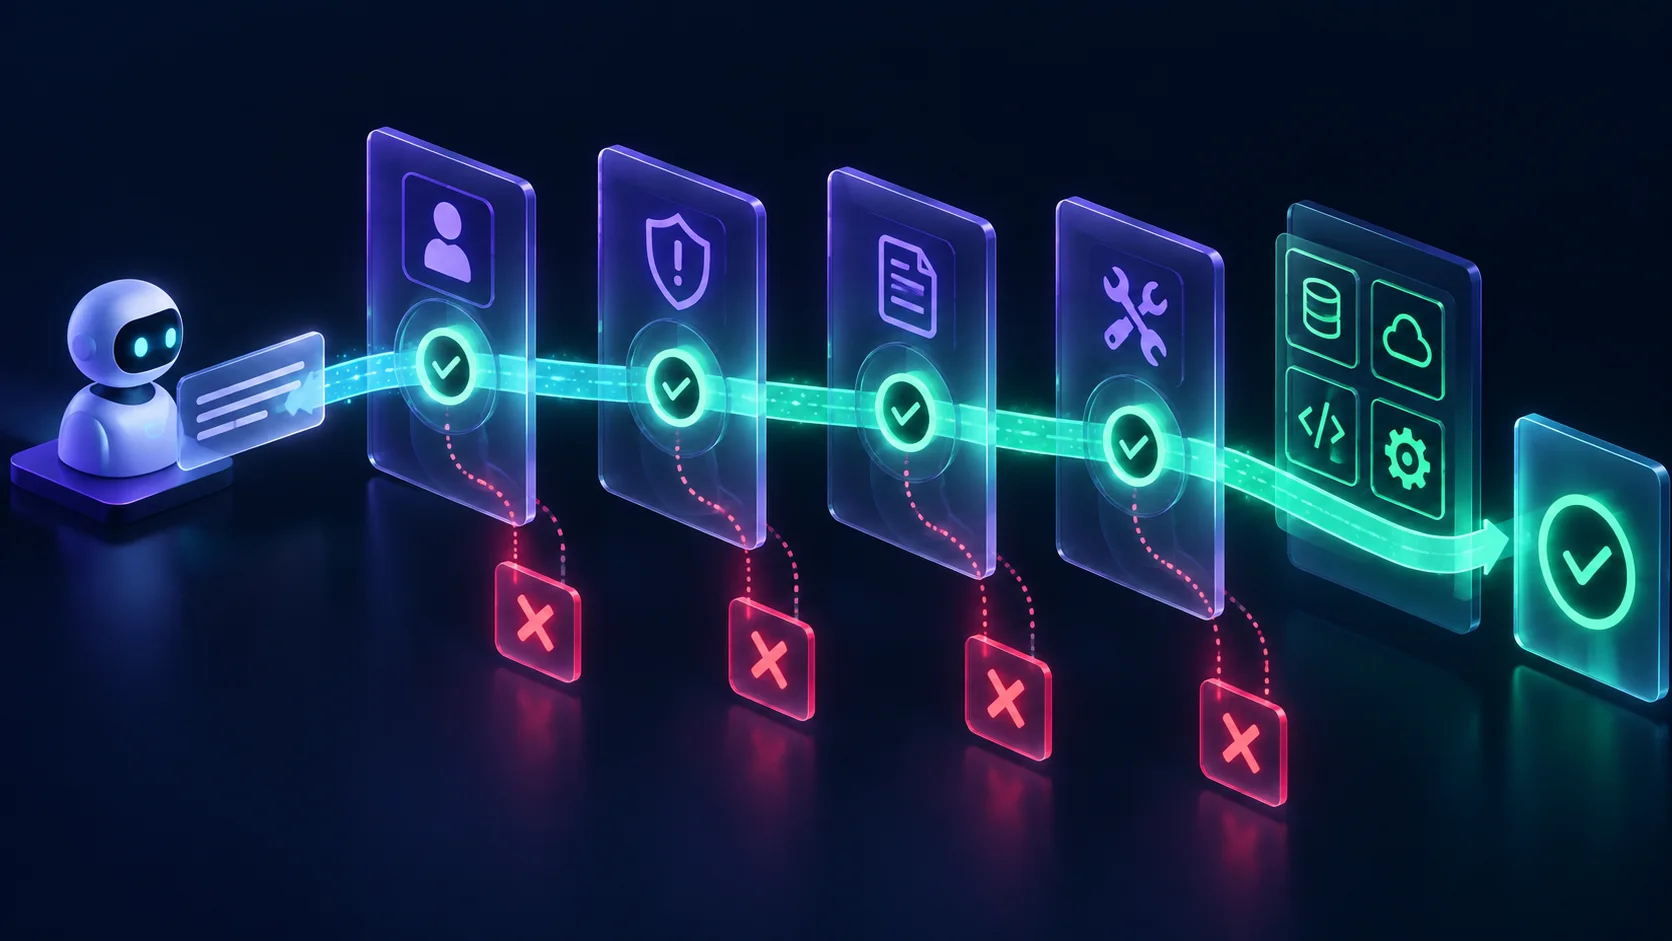
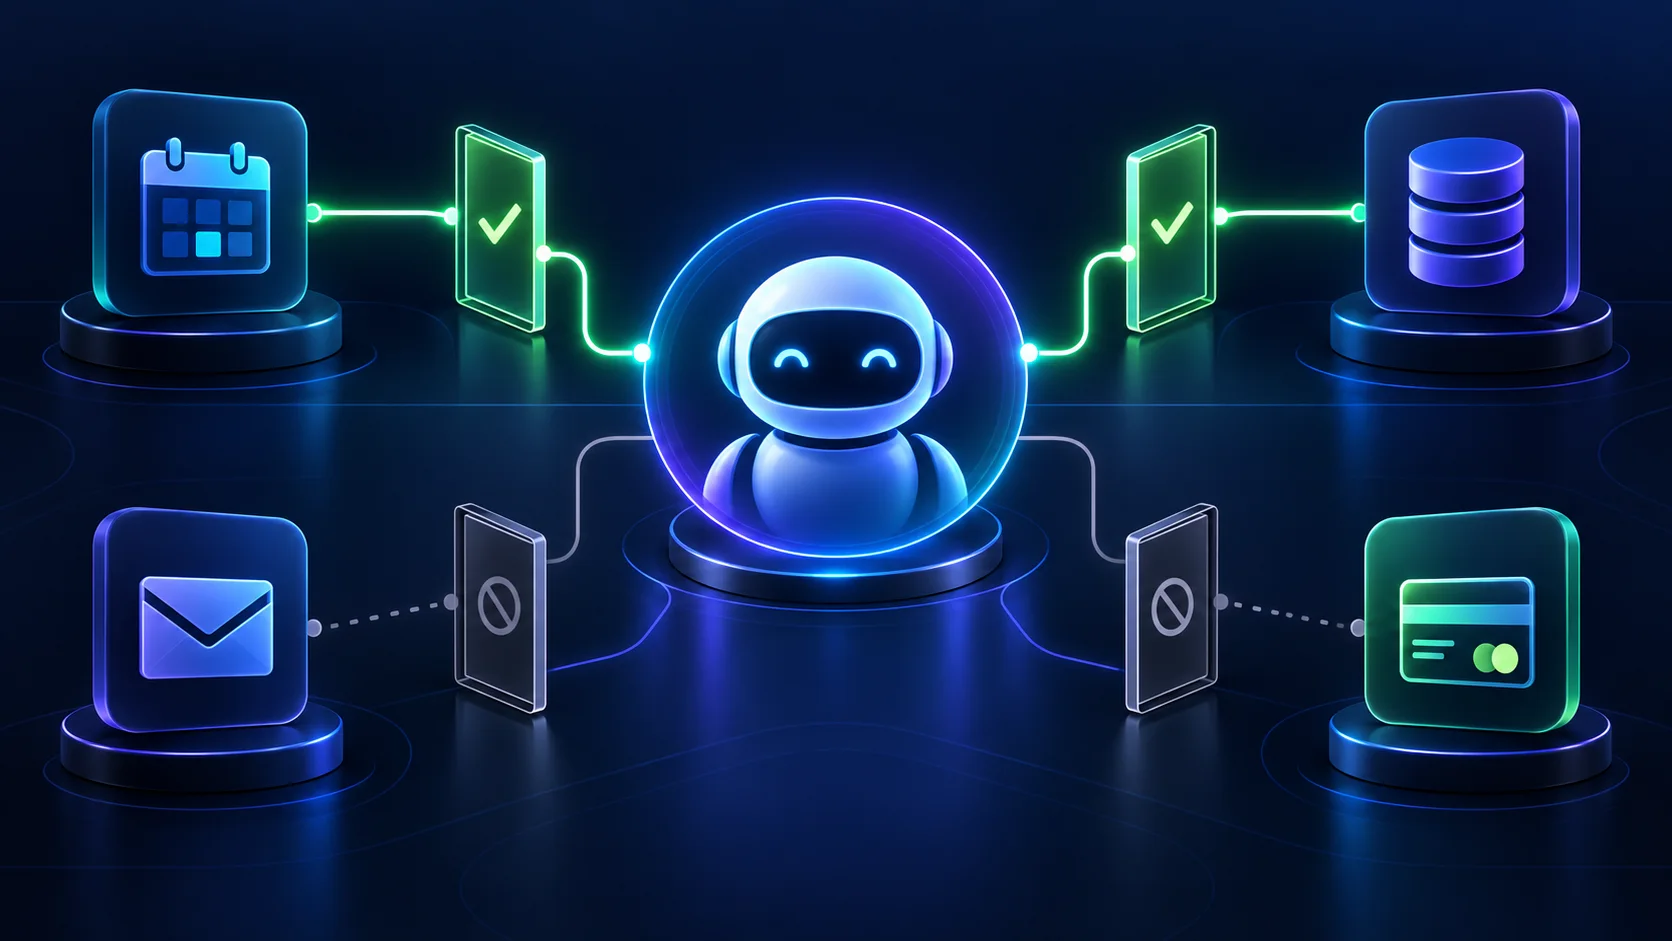
Imagen: Antes de ejecutarse, las llamadas a herramientas deben superar comprobaciones de intención, validación de parámetros, permisos y riesgo.
Para un agente, la protección más importante no siempre consiste en «rechazar todo contenido peligroso». Se trata de asegurar que las acciones con efectos secundarios tengan contexto suficiente, parámetros válidos y confirmación explícita.
Cuatro capas de defensa
Capa 1: reglas estrictas
Comprueba primero el usuario, el rol, la titularidad del recurso, los límites de importe, las herramientas autorizadas y los tipos de parámetros. Si falla una regla estricta, no llames a Jev ni a un LLM: rechaza la acción o pásala a una persona.
Capa 2: juicio de intención
Usa Noul para evaluar si el usuario solicitó explícitamente la acción. «¿Pidió el usuario que se eliminara este proyecto?» no es lo mismo que «¿Preguntó cómo funciona la eliminación?».
Capa 3: puntuación del riesgo
Usa Score para valorar el alcance del impacto, la reversibilidad, la sensibilidad y la visibilidad externa. Los pagos, los cambios de permisos, las eliminaciones masivas y los mensajes externos deben tener umbrales de revisión más altos.
Capa 4: confirmación y auditoría
Las acciones de alto riesgo deben mostrar al usuario el destino, los parámetros y las consecuencias, pedir confirmación explícita y registrar la decisión, la versión, el actor y el resultado de la herramienta. Vuelve a validar los parámetros después de confirmar; una confirmación antigua no es una autorización permanente.
Patrón 3: activar revisiones con probabilidades
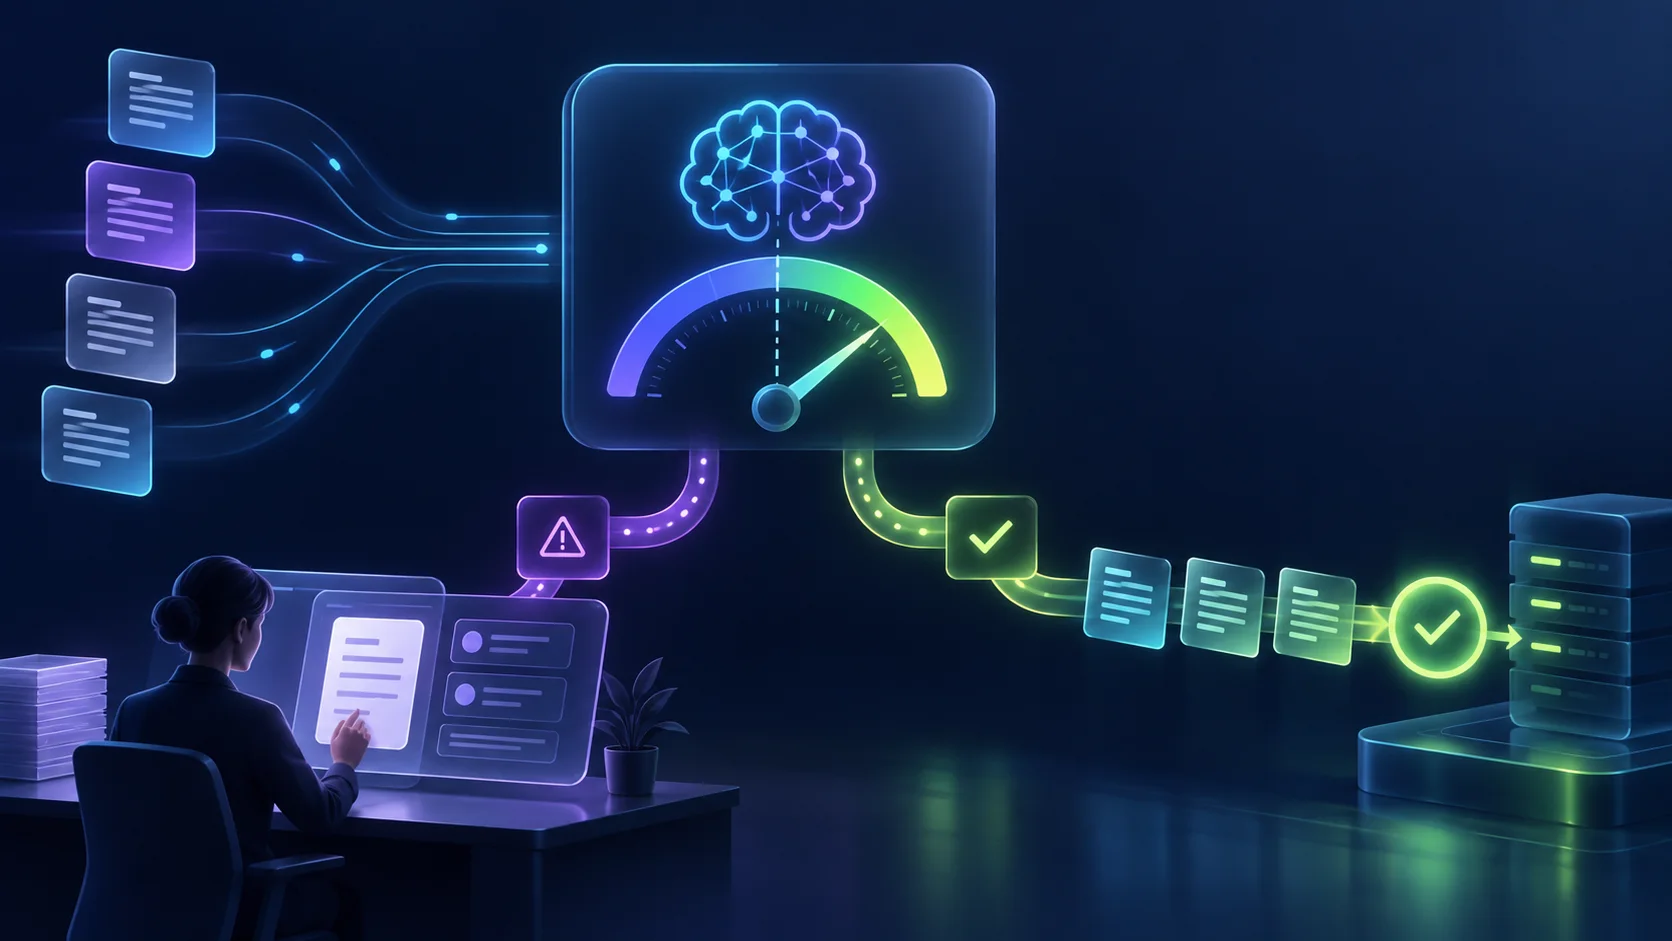
La probabilidad y la confianza de Jev son más útiles para elegir el nivel de automatización que para sustituir el criterio humano. Un sistema puede ofrecer tres rutas:
| Resultado | Tratamiento |
|---|---|
| Confianza alta y riesgo bajo | Continuar automáticamente y registrar el resultado |
| Cerca del umbral o falta contexto | Pedir más información o enviar el caso a revisión |
| Riesgo alto o confianza baja | Pausar el agente y derivarlo a una persona |
Define los umbrales por acción, no de forma global por modelo. La clasificación automática de tickets puede tolerar un umbral menor; los reembolsos, las eliminaciones, los cambios de permisos y las comunicaciones externas requieren umbrales más altos y confirmación explícita.
¿Qué debería ver la persona revisora?
Una interfaz de revisión útil debería mostrar:
- el State original o un resumen con los datos sensibles ocultos;
- la acción que pretende realizar el agente y los parámetros de la herramienta;
- las preguntas, opciones, probabilidades y confianza de Jev;
- los resultados de las reglas estrictas y las comprobaciones de permisos;
- controles para aprobar, rechazar, editar o pedir más información.
No muestres solo «Recomendación de la IA: aprobar». Quien revisa necesita conocer los hechos y los límites que sustentan el juicio.
Diseñar el State y las preguntas del agente
Incluye en el State solo los datos relevantes para la decisión
Una conversación larga del agente puede contener mucho historial, pero cada pregunta de Jev rara vez necesita todo. Extrae mediante código un resumen de la tarea, la herramienta actual, los detalles del recurso, los permisos del usuario y el último resultado; después construye un State mínimo.
Un State pequeño reduce el coste, limita la exposición de datos sensibles y facilita reproducir el juicio.
Una pregunta, un juicio
No escribas una pregunta gigantesca como:
«¿Es seguro, necesita confirmación, qué modelo deberíamos usar y son válidos los parámetros?»
Divídela en preguntas, por ejemplo:
intent_explicit: ¿El usuario pidió explícitamente esta acción?parameter_valid: ¿Los argumentos cumplen el contrato de la herramienta?risk_level: ¿Cuál es el nivel de riesgo de la acción?needs_human: ¿Hace falta una revisión humana ahora?
El código puede gestionar cada resultado por separado, y cada pregunta puede tener sus propios contraejemplos.
Versiona las decisiones
Registra las definiciones de las preguntas, las descripciones de las opciones, la rúbrica, la versión del modelo y la versión del umbral. Sin esos datos, el equipo no podrá explicar por qué una acción anterior se permitió o se bloqueó después de cambiar las políticas.
Lista de seguridad y evaluación
Antes de pasar a producción, verifica que:
- El agente no puede saltarse las reglas estrictas para llamar a una herramienta de gran impacto.
- Todas las herramientas con efectos secundarios tienen una lista de autorización, validación de parámetros y comprobación de permisos.
- Las probabilidades de Jev son señales; las acciones críticas conservan una alternativa determinista o humana.
- Los flujos de revisión no pierden tareas por un tiempo de espera agotado o una interrupción del servicio.
- Cada acción queda vinculada a la entrada, las preguntas, el modelo, los umbrales y el actor.
- Las pruebas incluyen entradas normales, ambiguas, no autorizadas, con inyección de prompts y engañosas.
- Se contemplan el chino, el inglés, los términos especializados y la falta de contexto.
- Las preguntas de enrutamiento o protección pueden cambiarse sin reescribir todo el agente.
- Las alternativas están definidas: pausar, pedir confirmación, transferir o aplicar una regla estática.
- Los ejemplos de la galería Jev AI Showcase se tratan como inspiración, no como prueba de seguridad.
Actualmente Jev acepta como entradas directas texto, objetos JSON y arrays de texto. No admite directamente imágenes, audio ni vídeo. Evalúa los datos en otros idiomas o de dominios especializados con muestras propias; no des por hecho que están cubiertos por el posicionamiento del producto.
Preguntas frecuentes
¿Puede Jev garantizar que un agente no se equivocará?
No. Jev proporciona señales de probabilidad y confianza, no una garantía de precisión empresarial ni de seguridad. Los agentes fiables siguen necesitando permisos, reglas estrictas, validación de parámetros, revisión humana y registros de auditoría.
¿Por qué no dejar que el LLM decida si algo es seguro?
Un LLM puede ayudar a comprender y explicar, pero no debería ser el único responsable de la autorización final. Separar los juicios en partes pequeñas permite probar de manera independiente los umbrales, los contraejemplos y las rutas de fallo.
¿Una confianza alta puede evitar la confirmación humana?
Quizá en acciones de bajo riesgo. Para acciones de gran impacto, la confianza no basta. Los pagos, las eliminaciones, los cambios de permisos y las comunicaciones externas deben combinar señales del modelo con reglas, permisos y confirmación explícita.
¿Jev sirve para cualquier agente?
No necesariamente. Si un agente se dedica sobre todo a escribir y conversar, un LLM seguirá siendo el centro. Si necesita enrutar, elegir herramientas, puntuar riesgos y escalar casos con frecuencia, Jev es una buena opción para la capa de decisión.
¿Cómo debería empezar?
Prueba un juicio de bajo riesgo en el entorno de pruebas de Jev AI y después sigue el tutorial de la API para integrarla en el servidor. Cuando funcione el flujo básico, añade el enrutamiento y las protecciones al orquestador.
Conclusión: haz que las acciones del agente sean explicables
Los agentes fiables no necesitan más permisos, sino límites mejores. Jev AI puede hacer explícitas las decisiones ocultas sobre enrutamiento, uso de herramientas, escalado y continuación, mientras el código y las personas mantienen el control de la acción final.
Empieza con una herramienta de bajo riesgo, registra cada juicio y acción final, y mejora las preguntas y los umbrales a partir de fallos reales. Así Jev AI se convierte en una capa de decisión estable, en vez de otro prompt difícil de auditar.
Fecha de investigación: 2026-09-20
Fuentes primarias: Página de Jev AI, documentación de Jev AI, galería Jev AI Showcase, presentación de TypeSafe