Comparativas de modelos
Jev AI frente a los LLM: ¿cuándo conviene usar un modelo de decisión en vez de uno de chat?
Jev AI y los grandes modelos de lenguaje no son sustitutos directos. Compara el formato de salida, la latencia, la incertidumbre, la complejidad de ingeniería y los límites de seguridad para saber cuándo encaja mejor un modelo de decisión.
Jev AI frente a los LLM: ¿cuándo conviene usar un modelo de decisión en vez de uno de chat?
Cuando los equipos conocen Jev AI por primera vez, suelen plantear una pregunta práctica: ¿en qué se diferencia Jev de ChatGPT, Claude u otro gran modelo de lenguaje? Si un LLM ya puede devolver JSON, ¿por qué añadir un modelo de decisión aparte?
La respuesta no es que «Jev AI siempre sea mejor». Los sistemas están optimizados para trabajos distintos. Los LLM son buenos en generación abierta, explicaciones y razonamiento complejo. Jev AI está diseñado para convertir un State en una opción, una puntuación o un juicio de sí/no dentro de un espacio de respuestas definido, y después devolver el resultado al código de la aplicación.
Esta guía compara Jev AI con los LLM generativos desde una perspectiva de ingeniería, ofrece un marco práctico de selección y explica cómo pueden colaborar en un mismo agente o flujo SaaS.
Respuesta rápida: si puedes definir de antemano el espacio de respuestas y el código debe reutilizar, clasificar, enrutar o bloquear el resultado, evalúa primero Jev AI. Si la tarea requiere redacción, explicación, creatividad o razonamiento abierto, sigue usando un LLM generativo.
Tabla de contenidos
- La diferencia fundamental
- Cinco dimensiones de comparación
- Cuándo preferir Jev AI
- Cuándo un LLM sigue siendo la opción adecuada
- Cómo pueden colaborar Jev AI y los LLM
- Cómo diseñar una evaluación
- Preguntas frecuentes
La diferencia fundamental
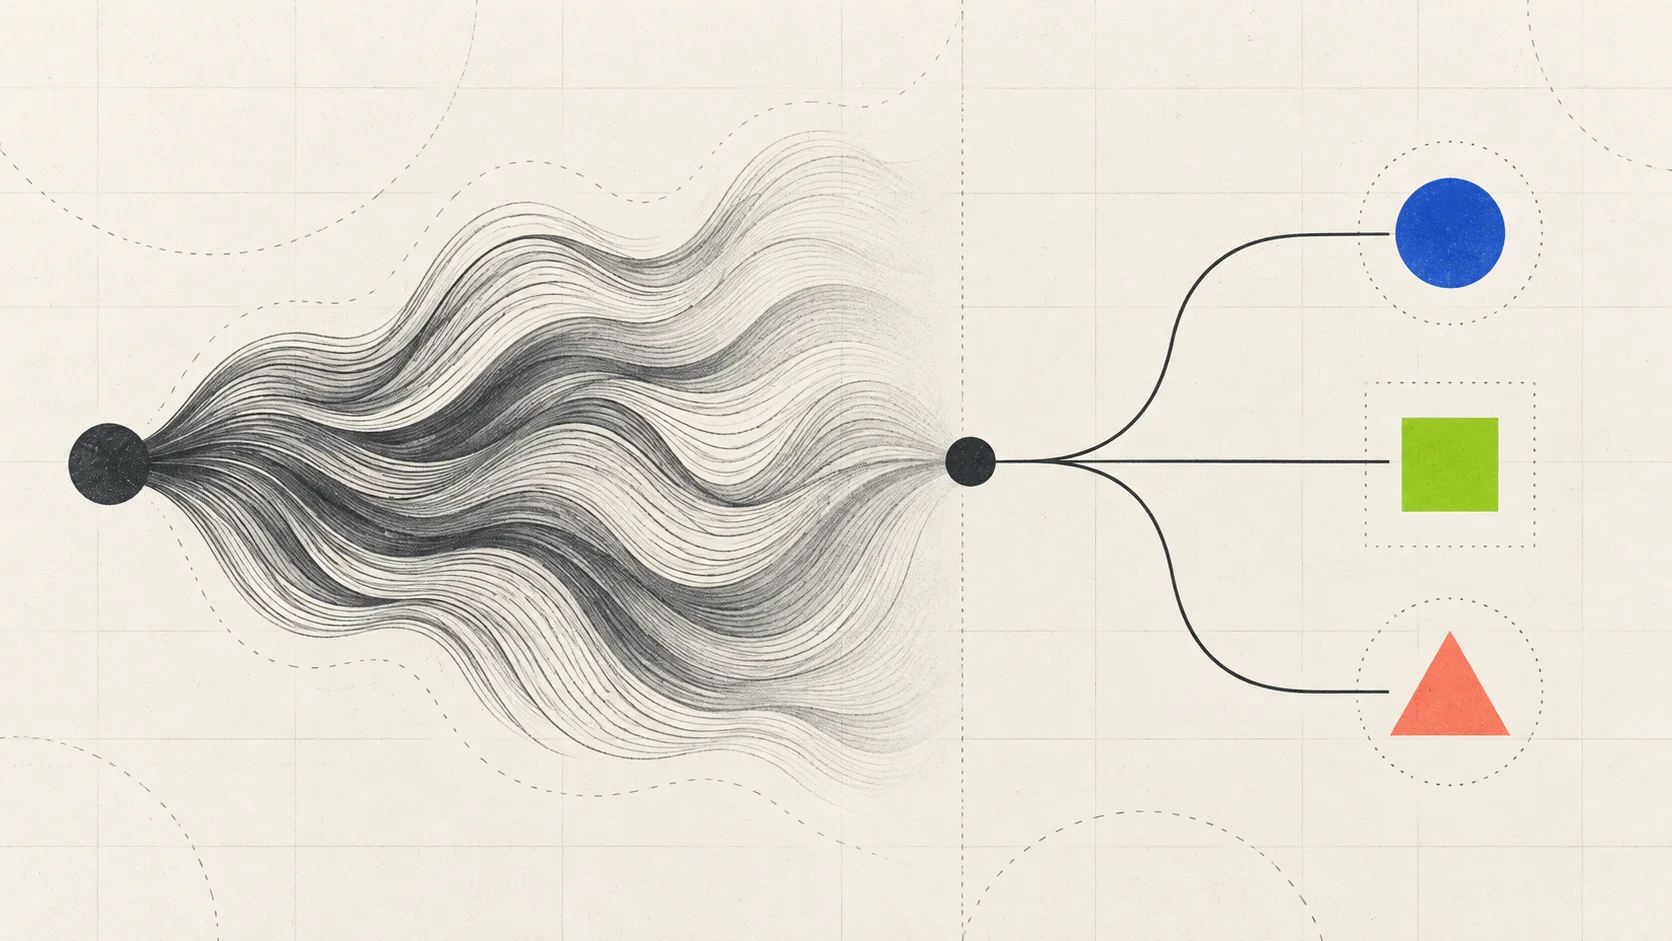
Imagen: un LLM genera principalmente contenido para las personas, mientras que Jev AI devuelve principalmente decisiones para el software.
Un LLM genera; Jev es una capa de decisión
Los LLM generativos producen el siguiente token a partir del contexto. Pueden escribir un correo, explicar código, resumir un informe o generar JSON mediante un prompt. Pero ese JSON sigue siendo el resultado de generar texto. La aplicación debe validar los campos, gestionar valores ausentes y tener en cuenta las variaciones de formato.
Jev AI empieza por el tipo de pregunta. Defines si la aplicación necesita un juicio Choice, Score o Noul y, después, proporcionas el State. La respuesta se organiza en torno a opciones, puntuaciones, juicios de sí/no, probabilidades y confianza. Jev no es simplemente un modelo de chat más pequeño: trata el juicio del software como una interfaz de primer nivel.
¿El resultado debe volver al código?
Si una persona va a leer la salida y decidir qué hacer, el texto suele ser adecuado. Si la salida debe entrar en una instrucción if, una cola, un enrutador, una comprobación de permisos o una llamada a herramienta, importa más que la forma de la decisión sea estable.
Esta es la idea central de la introducción a Jev AI: Jev evalúa y el código de la aplicación actúa.
Cinco dimensiones de comparación
| Dimensión | Jev AI | LLM generativo |
|---|---|---|
| Salida principal | Choice, Score, Noul, probabilidades y confianza | Texto, código, explicaciones o contenido estructurado abierto |
| Espacio de respuestas | Definido por el desarrollador | Normalmente abierto y dependiente del prompt |
| Flujo de control más adecuado | Clasificación, enrutamiento, ordenación, bloqueo y escalado | Generación, resumen, explicación, planificación y creación |
| Incertidumbre | Señales explícitas de probabilidad y confianza | Suele requerir validación adicional o un segundo juicio |
| Función en el sistema | Nodo de decisión dentro de la lógica del negocio | Centro de contenido o razonamiento |
1. ¿La salida debe ser ejecutable?
El enrutamiento del soporte, la selección de modelos, el escalado por riesgo y las comprobaciones previas a las herramientas no requieren prosa elegante. Necesitan un resultado que indique al programa qué ruta seguir. Analizar lenguaje natural en cada solicitud añade complejidad a medida que crece el tráfico.
Jev AI está diseñado para mantener esta capa cerca de las entradas de la aplicación. Un LLM también puede usar llamadas a funciones y JSON Schema, pero el equipo sigue teniendo que validar la salida y gestionar los reintentos, el texto adicional y los cambios de versión del modelo.
2. ¿Se puede definir de antemano el espacio de respuestas?
Imagen: cuanto más claro sea el espacio de respuestas, más útil resulta una interfaz de decisión dedicada.
Si la respuesta es «facturación, técnico u otro» o un nivel de gravedad de 0 a 3, define explícitamente ese límite. Choice y Score están diseñados para este tipo de trabajo.
Si no se puede definir la respuesta de antemano —por ejemplo, «escribe un anuncio de lanzamiento convincente»—, encaja mejor la generación abierta. No fuerces una tarea creativa a una lista de etiquetas solo para usar Jev.
3. ¿La incertidumbre debe controlar la automatización?
Muchos sistemas necesitan algo más que sí o no. Necesitan saber si un resultado es lo bastante seguro para automatizarlo. Un ticket de bajo riesgo con una probabilidad alta puede enrutarse automáticamente, mientras que una solicitud de pago dudosa debe revisarla una persona.
Las probabilidades y la confianza de Jev pueden servir como señales para el flujo de control, pero no garantizan la precisión empresarial. Los sistemas de producción siguen necesitando umbrales, contraejemplos, muestreo humano y políticas de auditoría.
4. ¿Necesitas varios juicios sobre el mismo State?
Una solicitud de soporte puede requerir un departamento, una evaluación de urgencia, la intención de obtener un reembolso y una decisión de escalado. La interfaz de Jev permite evaluar varias preguntas tipadas sobre el mismo State y devolver las respuestas mediante el ID de cada pregunta.
Un LLM también puede incluir varios campos en una respuesta JSON. Pero si los juicios tienen distintos perfiles de riesgo y criterios de evaluación, separarlos suele facilitar la observación y el ajuste del sistema.
5. ¿La capa de decisión necesita baja latencia y composición?
La página principal de Jev AI muestra un intervalo de respuesta de 70–500 ms. Puede resultar útil si hay decisiones pequeñas dentro de un flujo de alta frecuencia, pero no es tu SLA. La latencia real depende de la red, el tamaño de la petición, la concurrencia y las condiciones del servicio.
La latencia de los LLM suele verse afectada por la longitud del contexto y los tokens generados. Para una respuesta extensa, el valor de un LLM puede compensar unos cientos de milisegundos. Para una capa de enrutamiento que toma muchas decisiones pequeñas por segundo, merece la pena evaluar un modelo de decisión dedicado.
Cuándo preferir Jev AI
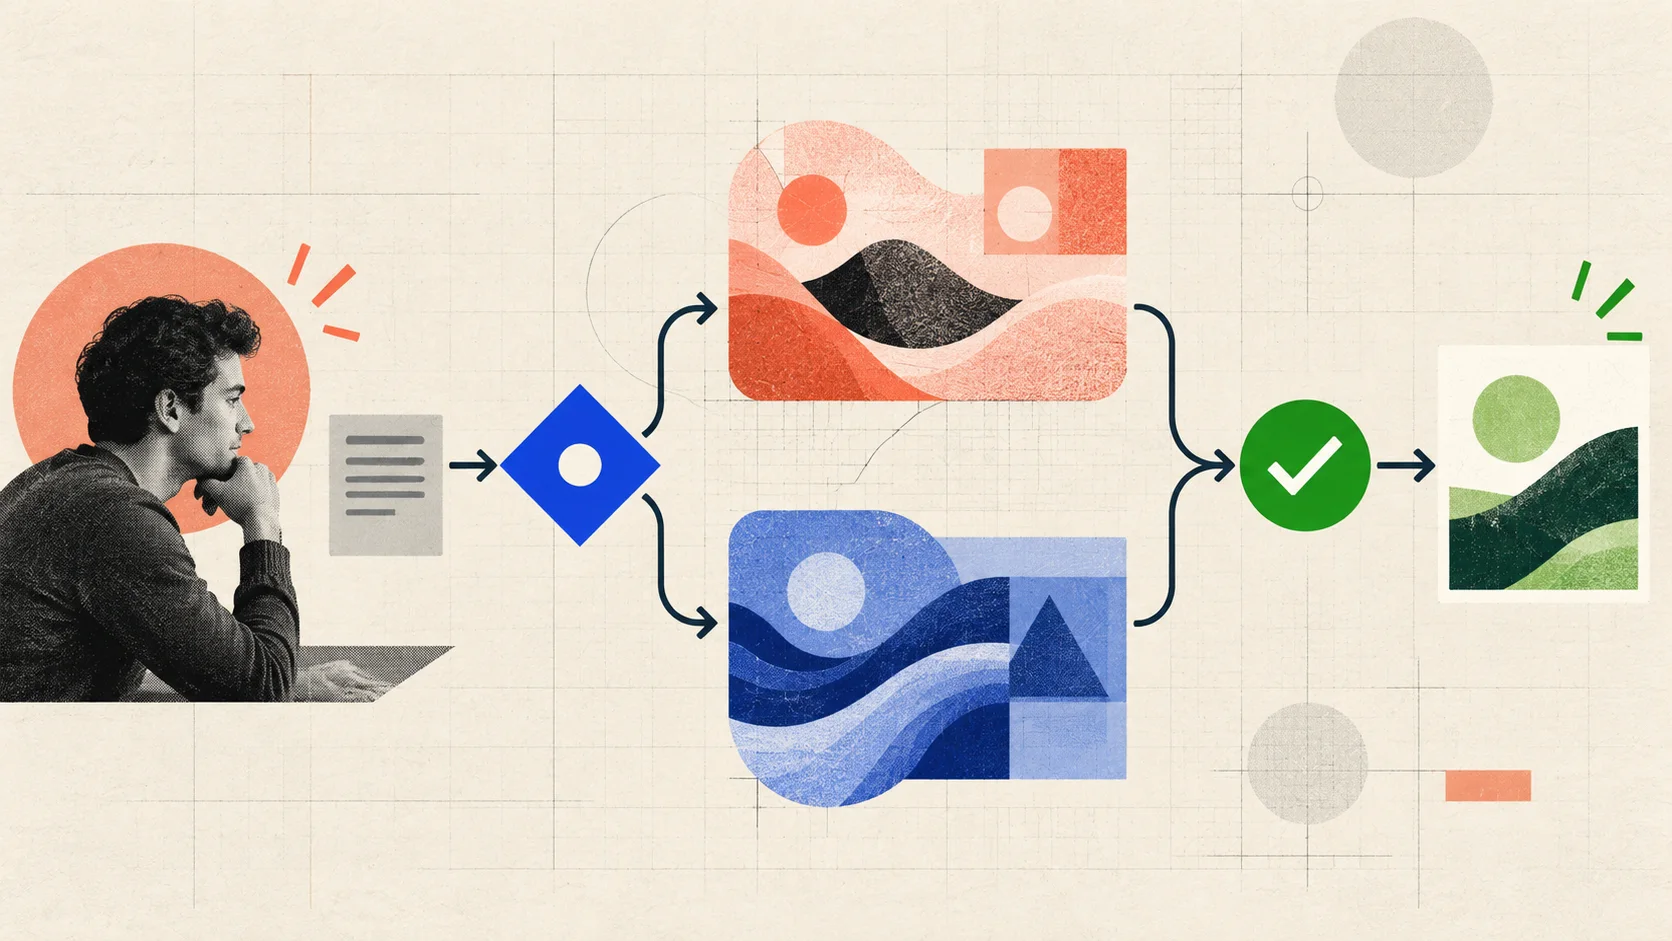
Cuantas más de estas condiciones se cumplan, más razones tendrás para probar Jev AI:
La salida pertenece a un conjunto finito
Puedes enumerar las respuestas candidatas en los requisitos del producto o en el código y definir qué significa cada opción. Normalmente esto corresponde a Choice.
La pregunta solicita un único juicio claro
Por ejemplo: «¿Este mensaje solicita explícitamente un reembolso?» y «¿Qué nivel de gravedad se aplica?». Las preguntas atómicas son más fáciles de probar y reproducir.
El resultado controla el código
El resultado afecta a una cola, un permiso, la selección de un modelo, una llamada a herramienta, un campo de base de datos o un escalado humano, en lugar de limitarse a mostrarse a una persona.
El sistema necesita automatización consciente de la incertidumbre
Quieres que los resultados de alta confianza continúen automáticamente, que los casos dudosos se revisen y que los resultados de baja confianza soliciten más información. Aquí son útiles las señales de probabilidad de Jev.
La política de negocio debe permanecer en la aplicación
Tu equipo es responsable de los umbrales, las ponderaciones, las reglas de revisión y las acciones finales. Jev emite un juicio sin ocultar toda la política en un prompt largo.
Cuándo un LLM sigue siendo la opción adecuada
Sigue usando un modelo generativo para tareas como:
- generar textos de marketing, correos, explicaciones de productos o código;
- resumir documentos extensos y explicar las pruebas;
- explorar investigaciones abiertas con varias respuestas posibles;
- razonar sobre un problema cuyo espacio de respuestas no se puede enumerar;
- mantener una conversación y reescribir contenido a partir de comentarios.
En esos flujos, Jev puede clasificar, puntuar, filtrar o revisar el trabajo del LLM antes o después de la generación.
Cómo pueden colaborar Jev AI y los LLM
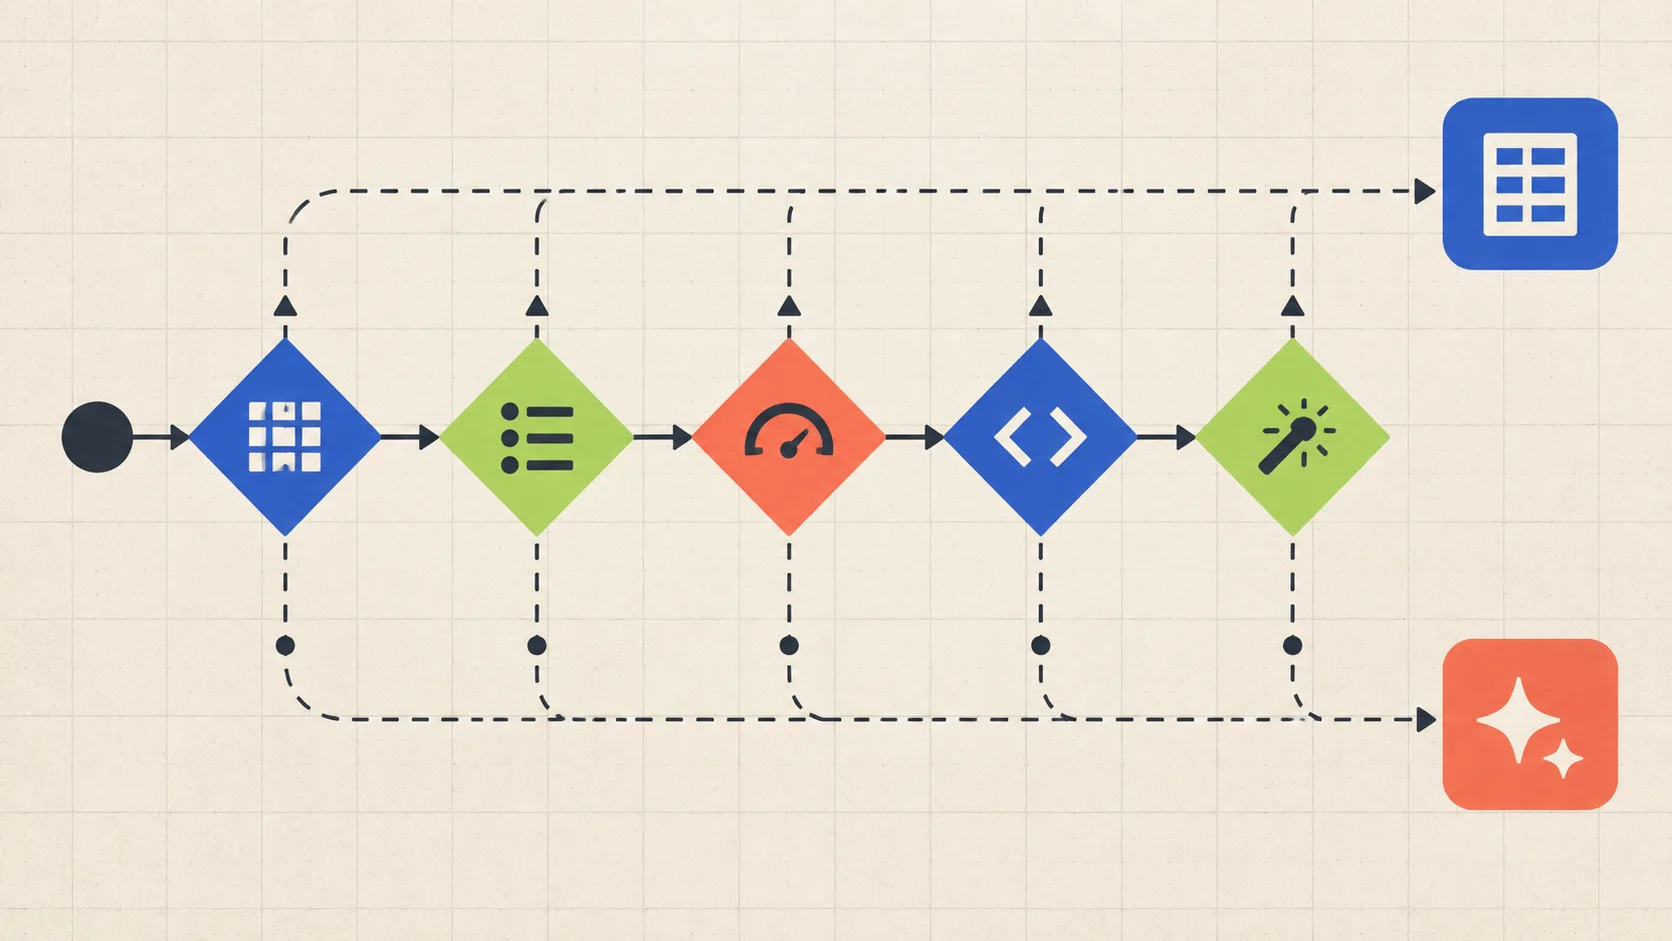
Imagen: Jev puede gestionar el enrutamiento, la validación y las ramas de riesgo alrededor de un LLM.
Una arquitectura combinada y práctica puede ser la siguiente:
- Recibir una solicitud y construir el State.
- Usar Jev para clasificar el tipo de tarea, la dificultad, la sensibilidad y las herramientas necesarias.
- Enviar las tareas sencillas a un modelo rápido y las complejas a otro más potente.
- Dejar que el LLM genere una respuesta o realice un razonamiento abierto.
- Usar Jev o reglas estrictas para comprobar si se puede enviar la salida o si necesita revisión.
- Dejar que el código de la aplicación registre el resultado y elija la siguiente acción.
El objetivo no es añadir llamadas a modelos porque sí, sino dejar que cada modelo se ocupe de la parte para la que está mejor preparado. Para ver el formato de la API, consulta el tutorial de la API de Jev AI.
Pseudocódigo simplificado
decision = jev.classify(
    state=request,
    questions={
        "risk": Score(rubric=["low", "medium", "high"]),
        "needs_tool": Noul("Does this request require a tool call?"),
    },
)

if decision.risk == "high" or decision.needs_tool > 0.9:
    return request_human_review(request)

return call_selected_llm(request, route=decision.risk)
Esto ilustra una arquitectura, no un contrato completo de SDK. Consulta la documentación oficial de Jev para conocer los campos y clientes actuales.
Cómo diseñar una evaluación
No compares diez ejemplos para decidir qué sistema «suena más humano». Una evaluación útil mide el flujo de control final.
Crea un conjunto de datos representativo
Recopila entradas normales, dudosas, ambiguas y adversariales. Toma muestras según el tráfico real y evalúa por separado el chino, el inglés, los términos especializados y la falta de contexto.
Mide el coste de cada error
Separa los falsos escalados, los escalados omitidos, el enrutamiento incorrecto, la ejecución insegura y el coste de la revisión humana. Para las acciones de gran impacto, aceptar más revisiones puede ser mejor que optimizar la precisión media.
Compara métricas de extremo a extremo
Registra la latencia, el coste, la tasa de reintentos, los fallos de análisis, la tasa de intervención humana y el éxito final de la tarea. La baja latencia de Jev solo importa si mejora el flujo completo.
Evalúa la facilidad de mantenimiento
Comprueba si los espacios de respuestas son claros, si las preguntas pueden cambiarse de forma independiente, si las decisiones se pueden reproducir y si los umbrales permanecen en el código. Un sistema que parece barato pero no se puede explicar puede costar más con el tiempo.
Preguntas frecuentes
¿Jev AI es simplemente un LLM más rápido?
Esa descripción es demasiado simplista. Jev está diseñado como un modelo de decisión System One que devuelve juicios tipados utilizables por el software, en lugar de texto extenso. La velocidad forma parte de la experiencia, pero debes validarla en tu entorno.
¿Sigo necesitando Jev si mi LLM admite JSON Schema?
No siempre. JSON Schema resuelve muchos problemas de formato. Merece la pena comparar Jev cuando necesitas varios juicios atómicos, enrutamiento basado en probabilidades o una interfaz de decisión estable dentro de un flujo de control de alta frecuencia.
¿Jev sustituye las reglas de negocio?
No. Las reglas estrictas, los permisos, las auditorías y los controles de pago deben seguir siendo deterministas. Jev resulta más útil para juicios semánticos difíciles de cubrir con reglas, pero cuyo espacio de respuestas sí se puede definir.
¿Puedo usar Jev sin un LLM?
Sí, si tu producto solo necesita clasificación, puntuación, enrutamiento y juicios de sí/no. Si también requiere generar contenido o explicaciones abiertas, combina Jev con un LLM.
¿Por dónde debería empezar a probar?
Abre el Playground de Jev AI, prueba una decisión medible y de bajo riesgo y lee después la documentación de la API. Cuando la interfaz funcione, incorpora Jev a la capa de enrutamiento o de guardarraíles de tu agente.
Conclusión
Elegir entre Jev AI y un LLM no consiste realmente en decidir qué modelo es «más inteligente». La cuestión es si tu software necesita generación o un juicio ejecutable. Deja la generación abierta a un LLM, las decisiones acotadas y frecuentes a una capa de decisión, y mantén los umbrales y las acciones finales en el código.
Fecha de investigación: 2026-09-20
Fuentes primarias: Página principal de Jev AI, Documentación de Jev AI, Introducción de TypeSafe, Showcase de Jev AI