Comparativas de modelos
Jev frente a djev, Laya, OpenJev y SemIf: ¿qué modelo de decisión deberías usar?
Compara Jev, djev, Laya, OpenJev y SemIf según la calidad de los benchmarks, la calibración, la velocidad, las entradas multimodales, el autoalojamiento, los pesos abiertos y las concesiones para producción.
Jev frente a djev, Laya, OpenJev y SemIf: ¿qué modelo de decisión deberías usar?
Si estás comparando Jev, djev, Laya, OpenJev y SemIf, la pregunta más útil no es «¿qué modelo obtiene la puntuación más alta?», sino «¿qué modelo operativo encaja con mi producto, mis límites de datos, mi objetivo de latencia y mi disposición a realizar trabajo de calibración?».
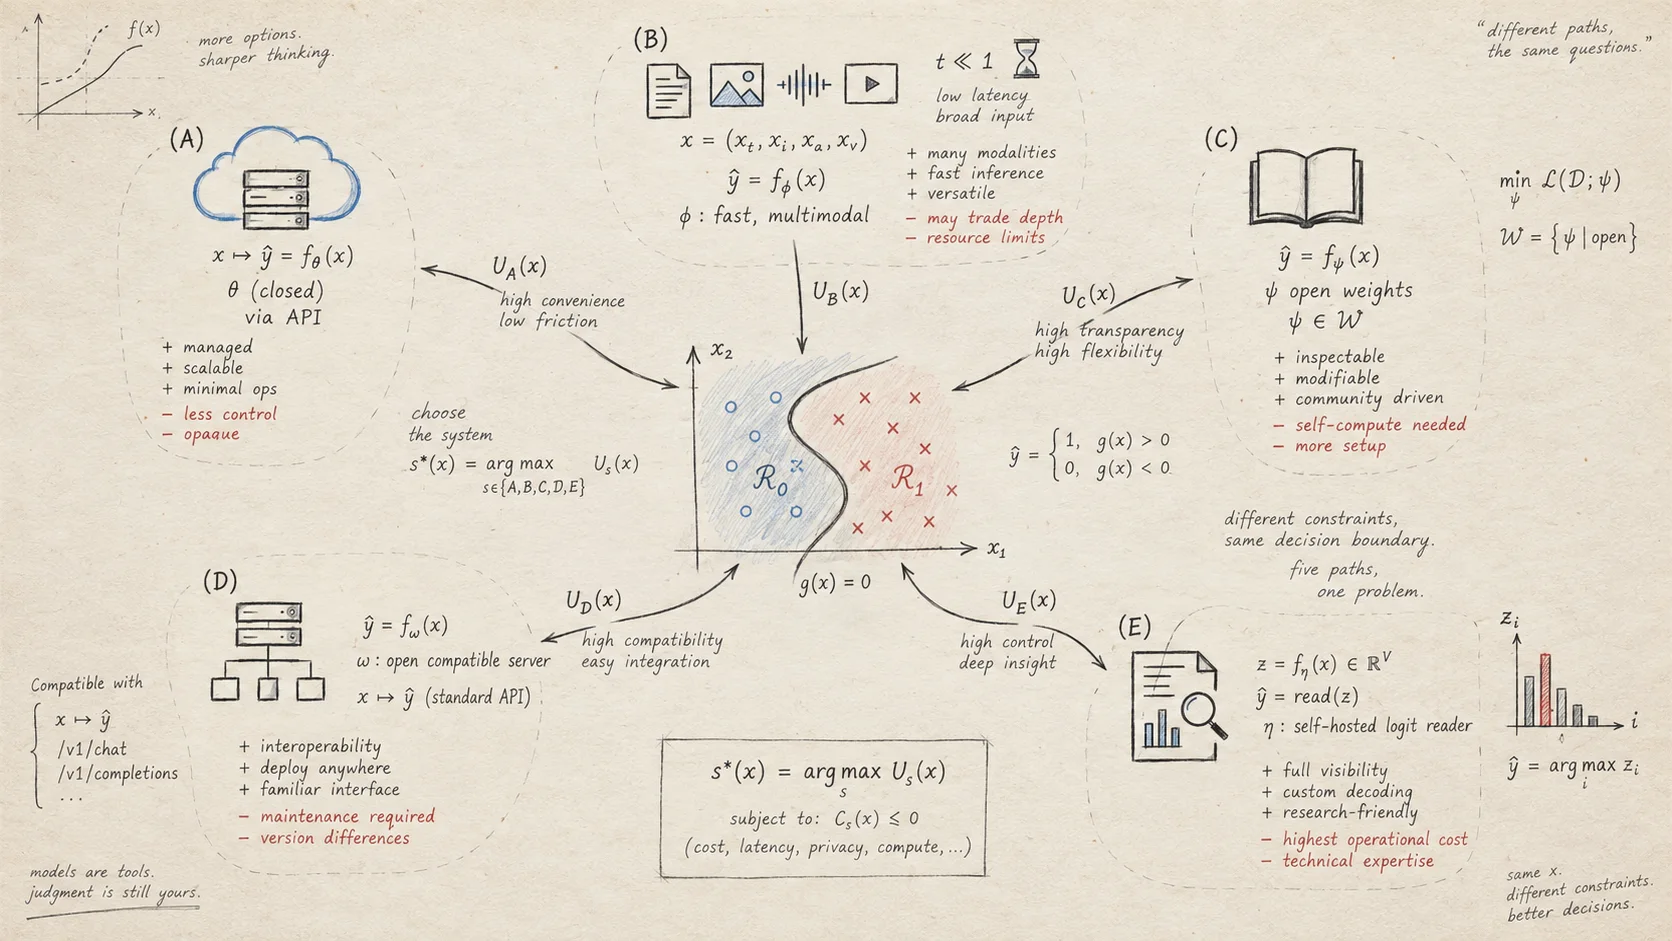
Todos estos sistemas se orientan a decisiones estructuradas en lugar de completar conversaciones normales, pero hacen concesiones distintas. Jev es un modelo System One alojado que se centra en decisiones tipadas y calibradas. djev prioriza la velocidad y la entrada nativa de imágenes o cámaras. Laya ofrece pesos abiertos, autoalojamiento y ajuste fino. OpenJev proporciona un servidor compatible y autoalojado con opciones multimodales y de razonamiento. SemIf lee los logits de modelos abiertos y se acerca a Jev en el benchmark agregado, a la vez que mantiene la infraestructura bajo tu control.
Esta guía utiliza las páginas oficiales de comparación y la instantánea publicada de JevBench v1.3.0, actualizada en septiembre de 2026. Considera las cifras una ayuda para decidir, no un sustituto de las pruebas con tu propia carga de trabajo.
Tabla de contenidos
- La respuesta breve
- Cómo leer el benchmark
- Los cinco sistemas de un vistazo
- Jev frente a djev
- Jev frente a Laya
- Jev frente a OpenJev
- Jev frente a SemIf
- Elegir según la restricción
- Cómo realizar tu propia evaluación
- Preguntas frecuentes
La respuesta breve
Elige Jev cuando tu aplicación necesite una API alojada, respuestas tipadas y probabilidades útiles para enrutar o escalar, sin tener que operar una GPU ni ajustar primero una capa de calibración.
Elige djev cuando la velocidad y la entrada nativa de imágenes o de cámara en directo importen más que la calibración para producción, especialmente mientras siga siendo práctica su vista previa alojada.
Elige Laya cuando los pesos abiertos, el despliegue sin conexión, la cobertura multilingüe y el ajuste fino importen más que la calidad sin ejemplos en decisiones difíciles.
Elige OpenJev cuando quieras un formato de petición compatible con Jev y autoalojado, con entrada de imágenes o un modo de razonamiento, y estés dispuesto a operar el entorno de ejecución.
Elige SemIf cuando quieras una implementación abierta que lea logits de decisión de modelos bajo tu control, mantenga los datos dentro de tu red y dispongas de GPU y de un proceso de evaluación para calibrarlos.
Cómo leer el benchmark
La comparación de JevBench v1.3.0 utilizada aquí presenta un método de evaluación compartido para 52 sistemas y 534 decisiones: 72 casos fáciles, 96 estándar, 146 de tipo evaluativo y 220 difíciles. La puntuación compuesta combina inteligencia, calibración, velocidad y coste.
La instantánea compuesta publicada es la siguiente:
| Sistema | Puesto | Puntuación compuesta | Modelo operativo principal |
|---|---|---|---|
| Jev 1.13.0 | #1 | 74.4 | API de producción alojada |
| SemIf | #2 | 73.1 | Lector de logits de modelos abiertos autoalojado |
| djev | #3 | 73.0 | API alojada con entrada multimodal |
| OpenJev | #11 | 66.4 | Servidor de decisiones compatible y autoalojado |
| Laya | #33 | 54.4 | Pesos abiertos autoalojados |
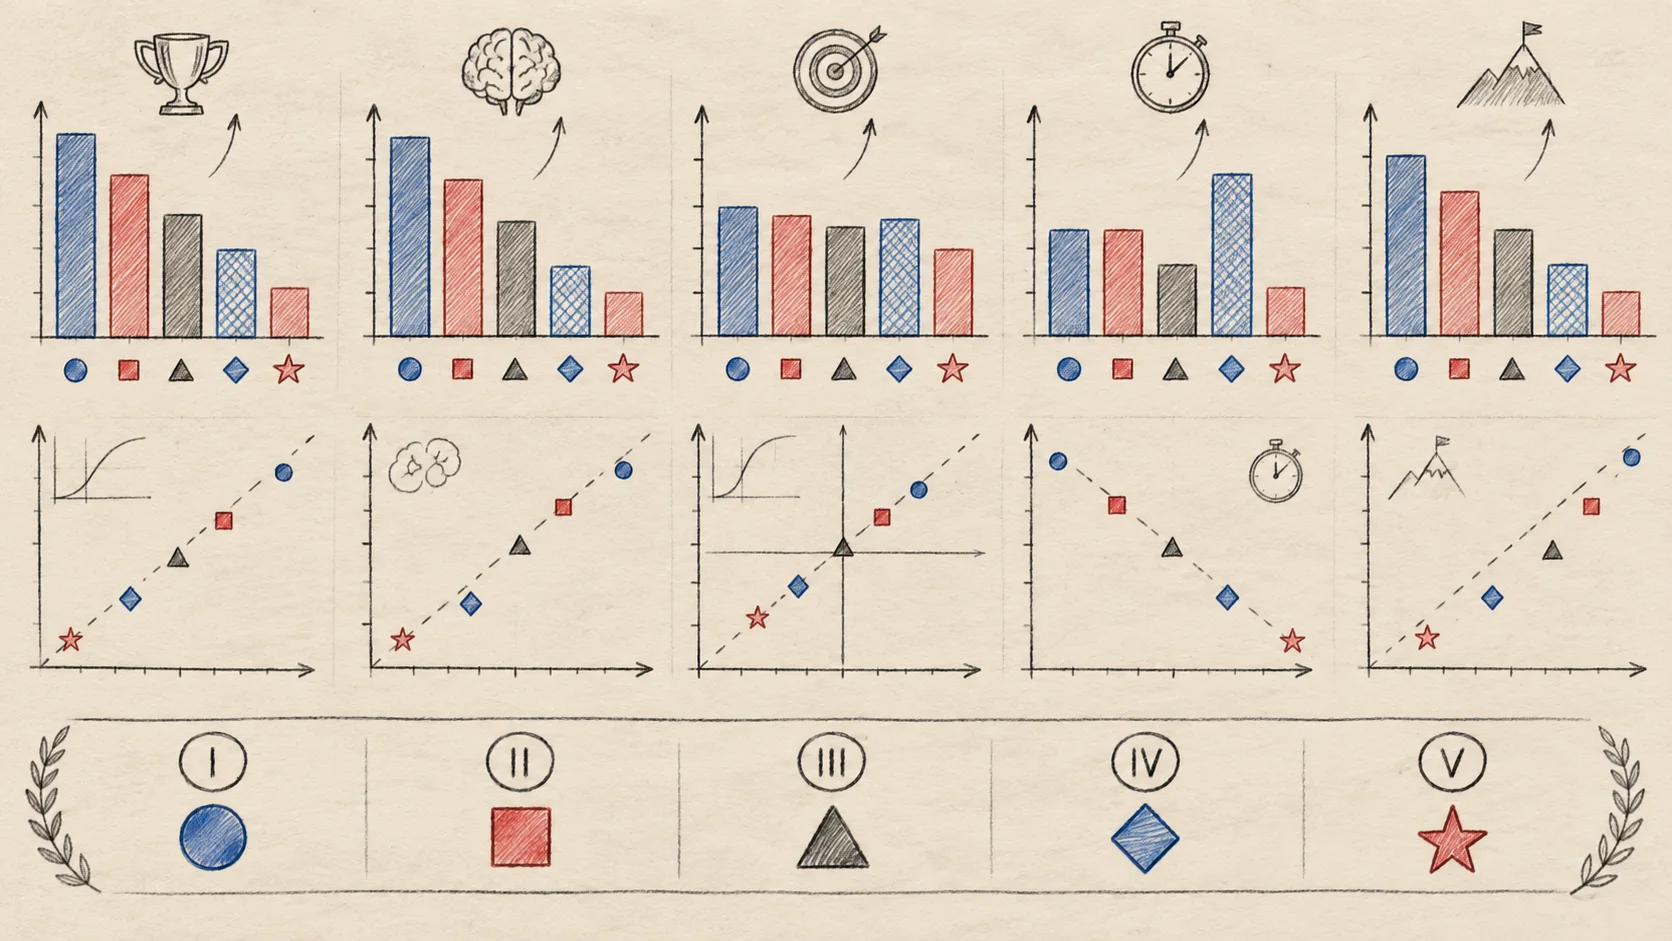
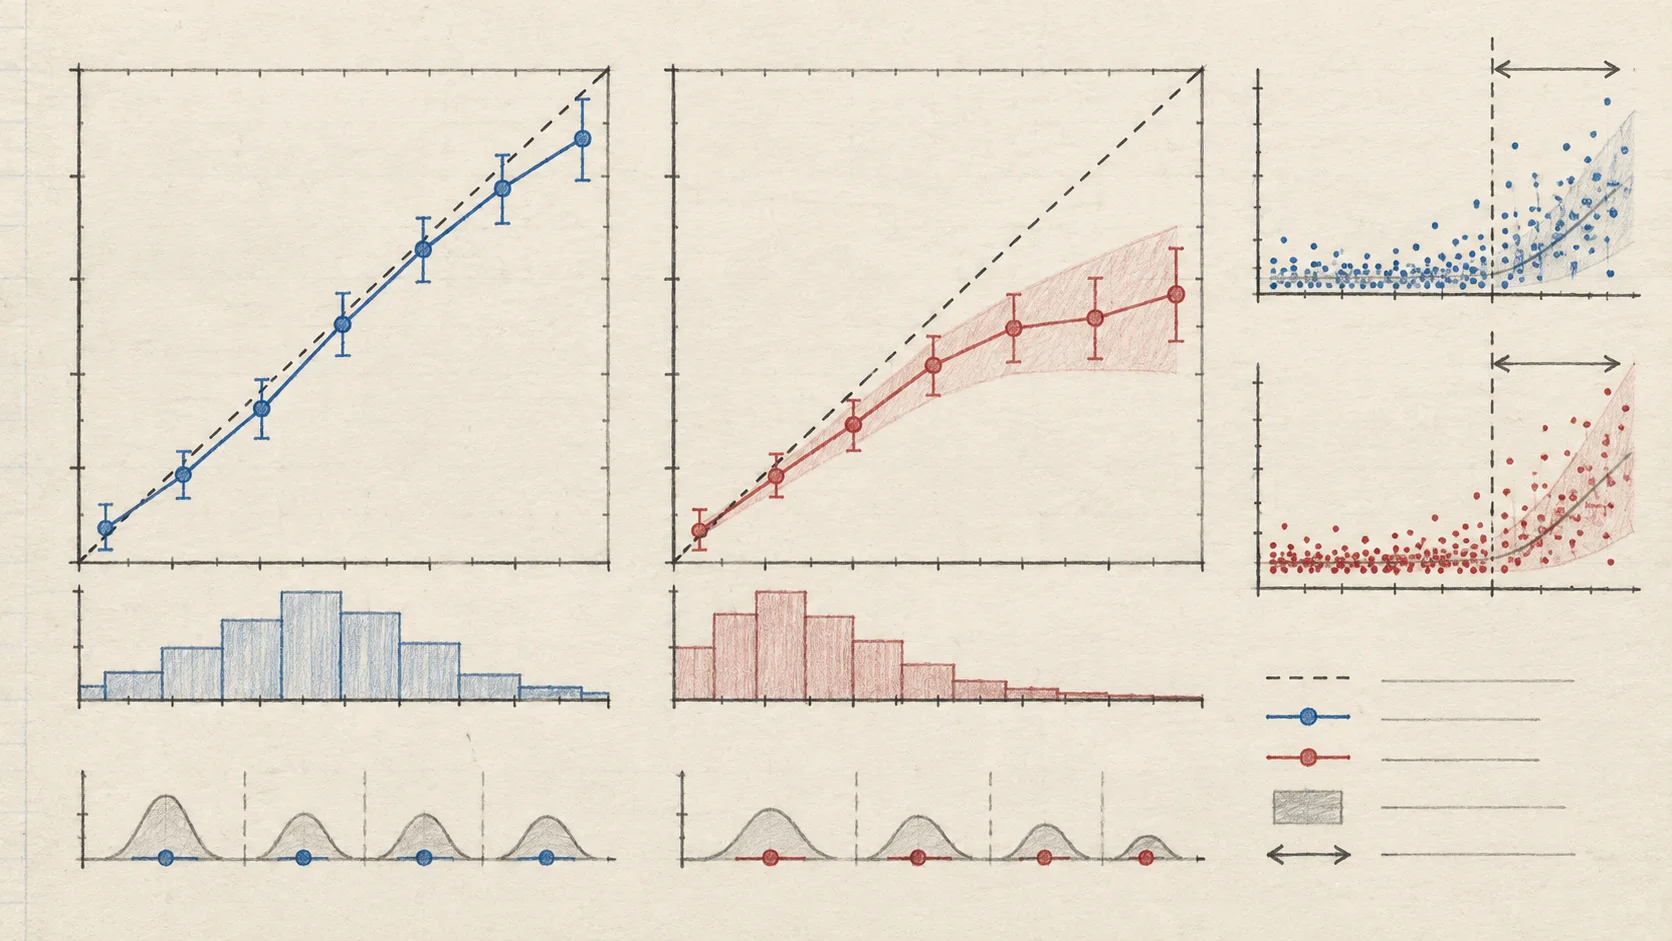
Una puntuación compuesta oculta diferencias importantes. Un sistema puede ser más rápido, pero estar peor calibrado; más barato, pero ser más difícil de operar; o más preciso en una categoría de evaluación, pero más débil en casos realmente ambiguos. En un agente o flujo que utiliza umbrales de probabilidad, la calibración puede importar más que una pequeña variación en la precisión bruta.
Los cinco sistemas de un vistazo
| Sistema | Ventaja | Concesión | Mejor para |
|---|---|---|---|
| Jev | Decisiones tipadas alojadas y probabilidades calibradas | Entrada solo de texto y API de pago por uso | Enrutamiento, puntuación y guardarraíles en producción |
| djev | Velocidad, imágenes y fotogramas de cámara nativos | Las probabilidades se documentan como experimentales | Prototipos multimodales rápidos y decisiones visuales |
| Laya | Pesos Apache-2.0, autoalojamiento en CPU/GPU y ajuste fino | Necesita datos de la tarea y ajustes para una calidad fiable en producción | Sistemas sin conexión o multilingües con capacidad de entrenamiento |
| OpenJev | API compatible con Jev, imágenes y modo de razonamiento | Operación y configuración de GPU o Apple Silicon | Equipos que quieren autoalojarse con un formato conocido |
| SemIf | Implementación abierta, logits sin conexión y fuerte puntuación agregada | GPU, servicio y calibración por carga propios | Redes controladas y equipos cómodos con la operación de modelos |
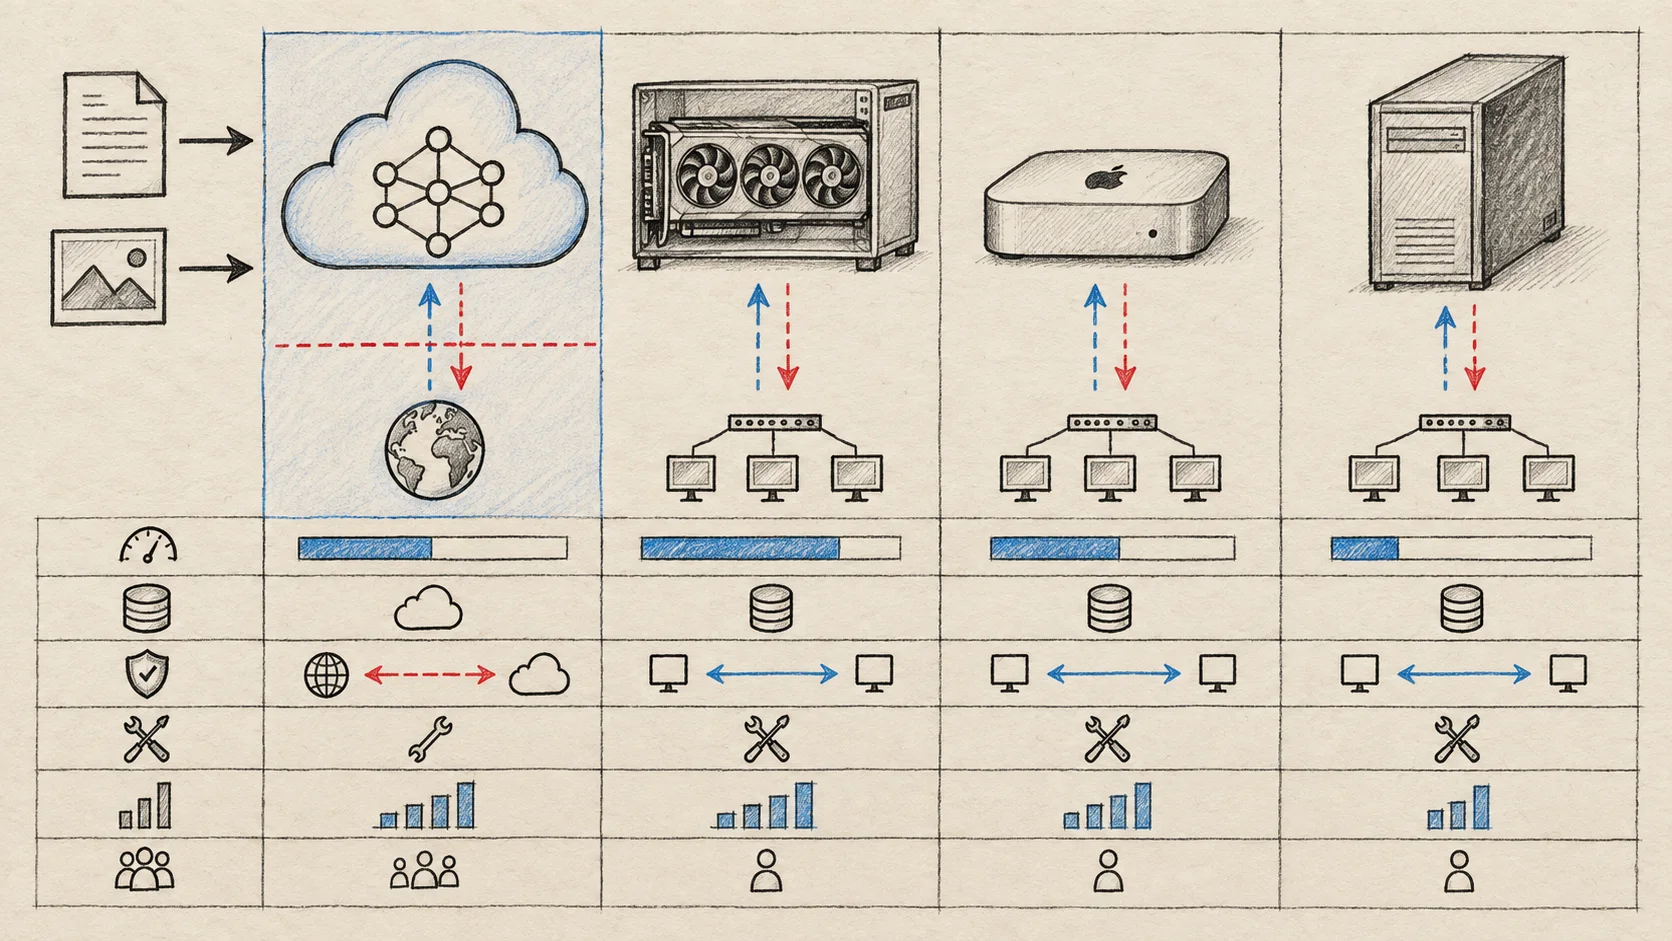
El límite de despliegue suele ser más importante que la clasificación. Una API alojada reduce el trabajo de infraestructura, pero envía las solicitudes a un proveedor. Un modelo autoalojado mantiene los datos más cerca de tu sistema, pero te hace responsable de planificar la capacidad, supervisar, actualizar y calibrar.
Jev frente a djev
La comparación entre Jev y djev describe una competición reñida con prioridades operativas claramente distintas.
Jev lidera la puntuación de calibración publicada con 82.7 frente a 65.4 de djev, y la comparación de precisión en casos difíciles es del 74.1 % frente al 69.5 %. djev lidera el eje de velocidad con 91.4 frente a 83.3 de Jev. En los casos fáciles y estándar, ambos sistemas están lo bastante próximos como para que la elección de despliegue importe más que la precisión bruta.
El límite de entrada es decisivo:
- Jev se centra en texto, objetos JSON y arrays de texto.
- djev admite texto, entrada nativa de imágenes, opciones de imagen y fotogramas de cámara en directo.
- Ambos admiten formas de decisión tipadas como Noul, Choice y Score.
Usa Jev cuando la aplicación emplee la probabilidad para aprobar automáticamente, escalar, ponderar o enrutar y quieras una opción alojada orientada a producción. Usa djev cuando el contexto visual o una latencia muy baja sean prioritarios y puedas considerar experimental su salida de probabilidad hasta que tu propia evaluación la valide.
El modelo de costes también es distinto. La página de comparación describe Jev como una API de producción alojada con un modelo previsto basado en el uso, mientras que djev está disponible como vista previa gratuita con precios anunciados. La disponibilidad de la vista previa y los precios pueden cambiar, así que verifica las condiciones actuales antes de comprometerte con una arquitectura.
Jev frente a Laya
La comparación entre Jev y Laya enfrenta principalmente un modelo alojado listo para usar con otro de pesos abiertos que puedes ajustar por tu cuenta.
La precisión publicada en casos difíciles es del 74.1 % para Jev y del 34.1 % para Laya en las configuraciones comparadas. La puntuación de inteligencia de Jev es 85.7 frente a 45.8 de Laya, mientras que Laya está diseñado para inferencias locales mucho más rápidas en hardware adecuado. El mayor atractivo de Laya no es la calidad sin ejemplos, sino la propiedad, el ajuste fino, el funcionamiento sin conexión y un bajo coste marginal cuando ya tienes una GPU ocupada.
Diferencias importantes:
- En la comparación, Jev admite hasta 64k tokens por petición; el contexto de Laya está limitado a 512 tokens por pregunta.
- Laya ofrece pesos Apache-2.0 y checkpoints en inglés o multilingües.
- Laya necesita ejemplos etiquetados y ajuste fino para estabilizar la calidad de una tarea en producción.
- Jev funciona tal cual mediante una API alojada, sin necesidad de gestionar una GPU inactiva ni un proceso de entrenamiento.
Laya puede ser mejor si los datos no pueden salir de tu red y tienes una taxonomía fija, ejemplos etiquetados y un equipo capaz de encargarse del servicio del modelo. Jev es una primera opción más sencilla si quieres validar un flujo de decisiones sin construir esa infraestructura.
Jev frente a OpenJev
La comparación entre Jev y OpenJev tiene menos que ver con el formato de la petición y más con lo que ocurre después de que la solicitud salga de tu aplicación.
OpenJev está diseñado como un servidor de decisiones compatible. Puede aceptar el formato general /v1/systemone, ejecutarse en una GPU NVIDIA de 24 GB o en Apple Silicon, aceptar hasta ocho imágenes por petición y ofrecer un modo de razonamiento que intercambia calidad por latencia. Jev es una API de producción alojada centrada en decisiones a partir de texto.
En la comparación predeterminada publicada, Jev obtiene 82.7 en calibración frente a 64.8 de OpenJev y un 74.1 % frente al 65.5 % en casos difíciles. Sus puntuaciones de velocidad son muy parecidas: 83.3 frente a 83.2. La configuración de razonamiento de OpenJev representa un punto operativo distinto: su página de comparación informa de 88.0 en inteligencia y 78.2 % en la categoría difícil, así que no debe mezclarse con una afirmación de comparación predeterminada frente a predeterminada.
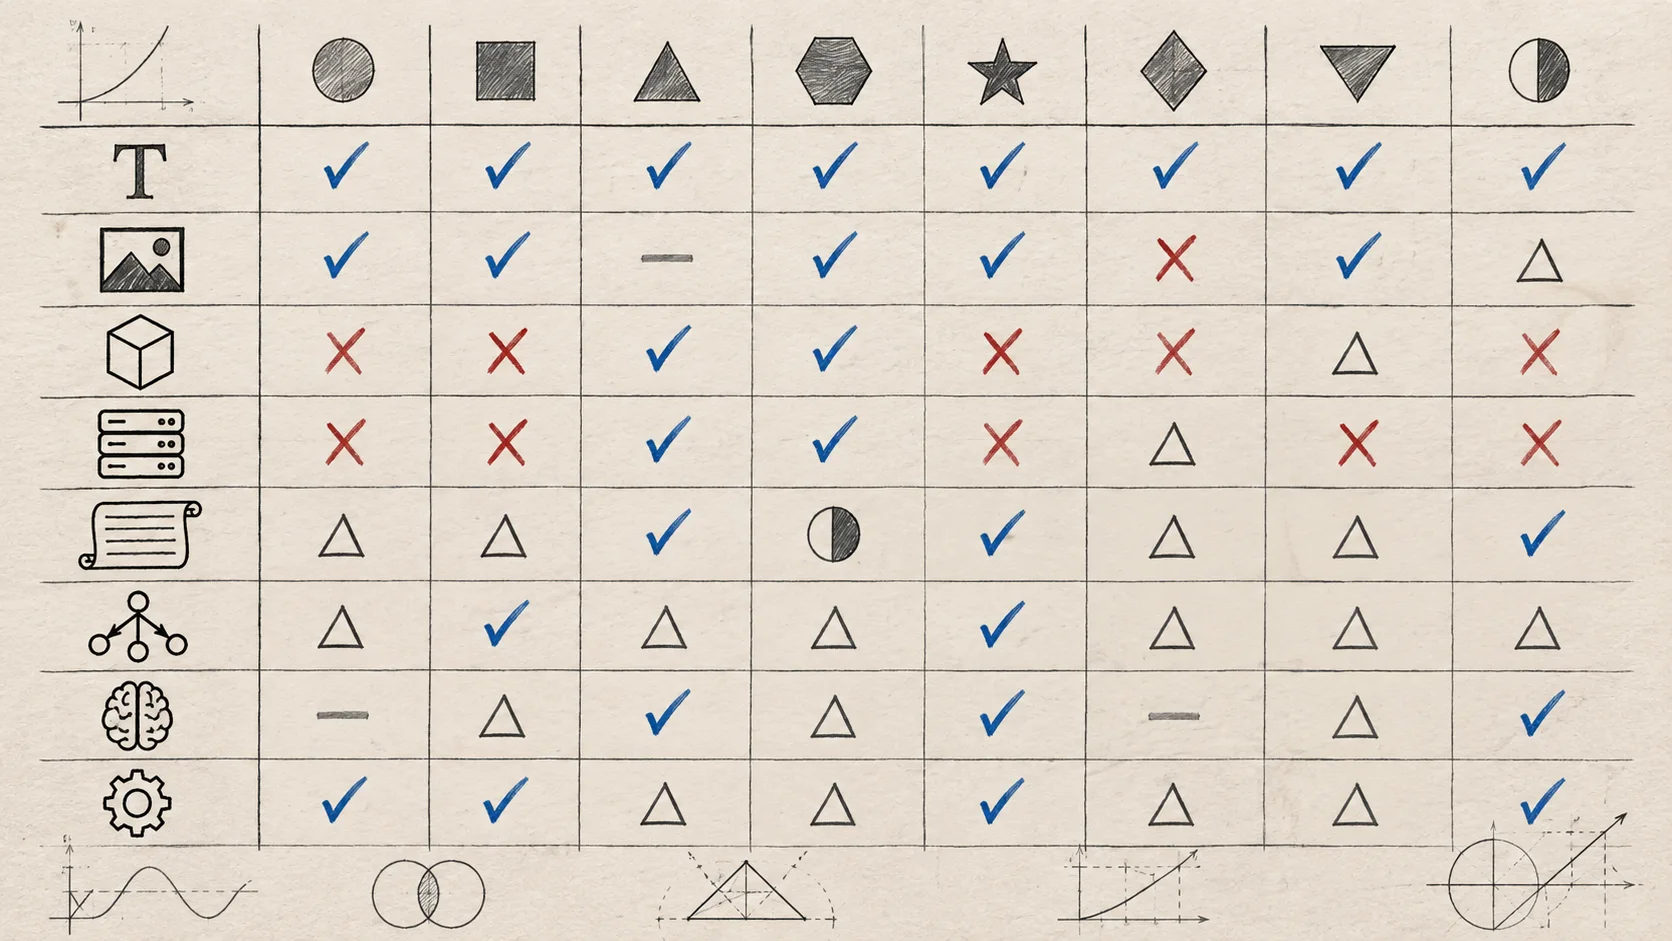
Elige OpenJev si necesitas entradas de imagen, autoalojamiento, código y pesos Apache-2.0 o una API compatible que se ejecute dentro de tu red. Elige Jev si la probabilidad calibrada, la operación gestionada y una vía rápida a producción importan más que ser propietario del entorno de ejecución.
Jev frente a SemIf
La comparación entre Jev y SemIf muestra la alternativa abierta más cercana en la clasificación compuesta publicada: SemIf obtiene 73.1 frente a 74.4 de Jev y ocupa el puesto #2 frente al #1.
La diferencia se concentra en aspectos concretos, no es universal:
- SemIf lidera en la categoría evaluativa: 95.2 % frente al 94.5 % de Jev.
- Jev lidera en casos difíciles: 74.1 % frente al 59.5 % de SemIf.
- La puntuación de calibración de Jev es 82.7 frente a 72.6 de SemIf.
- Las puntuaciones de velocidad están casi empatadas: 83.3 para Jev y 83.7 para SemIf.
SemIf utiliza un enfoque abierto de lectura de logits; la configuración principal del benchmark usa Qwen3.5-4B. Su código tiene licencia MIT, pero los pesos de los modelos de origen conservan sus propias licencias. La inferencia se mantiene en tu entorno, pero tú te encargas de la GPU, la pila de servicio, la planificación de capacidad y la calibración para tu carga de trabajo.
Jev encaja bien cuando la señal de probabilidad debe funcionar desde el primer momento y el tráfico es lo bastante irregular como para que resulte ineficiente pagar por una GPU inactiva. SemIf resulta atractivo cuando ya hay una GPU muy utilizada, se necesita operar sin conexión y el equipo está preparado para ajustar y supervisar los umbrales.
Elegir según la restricción
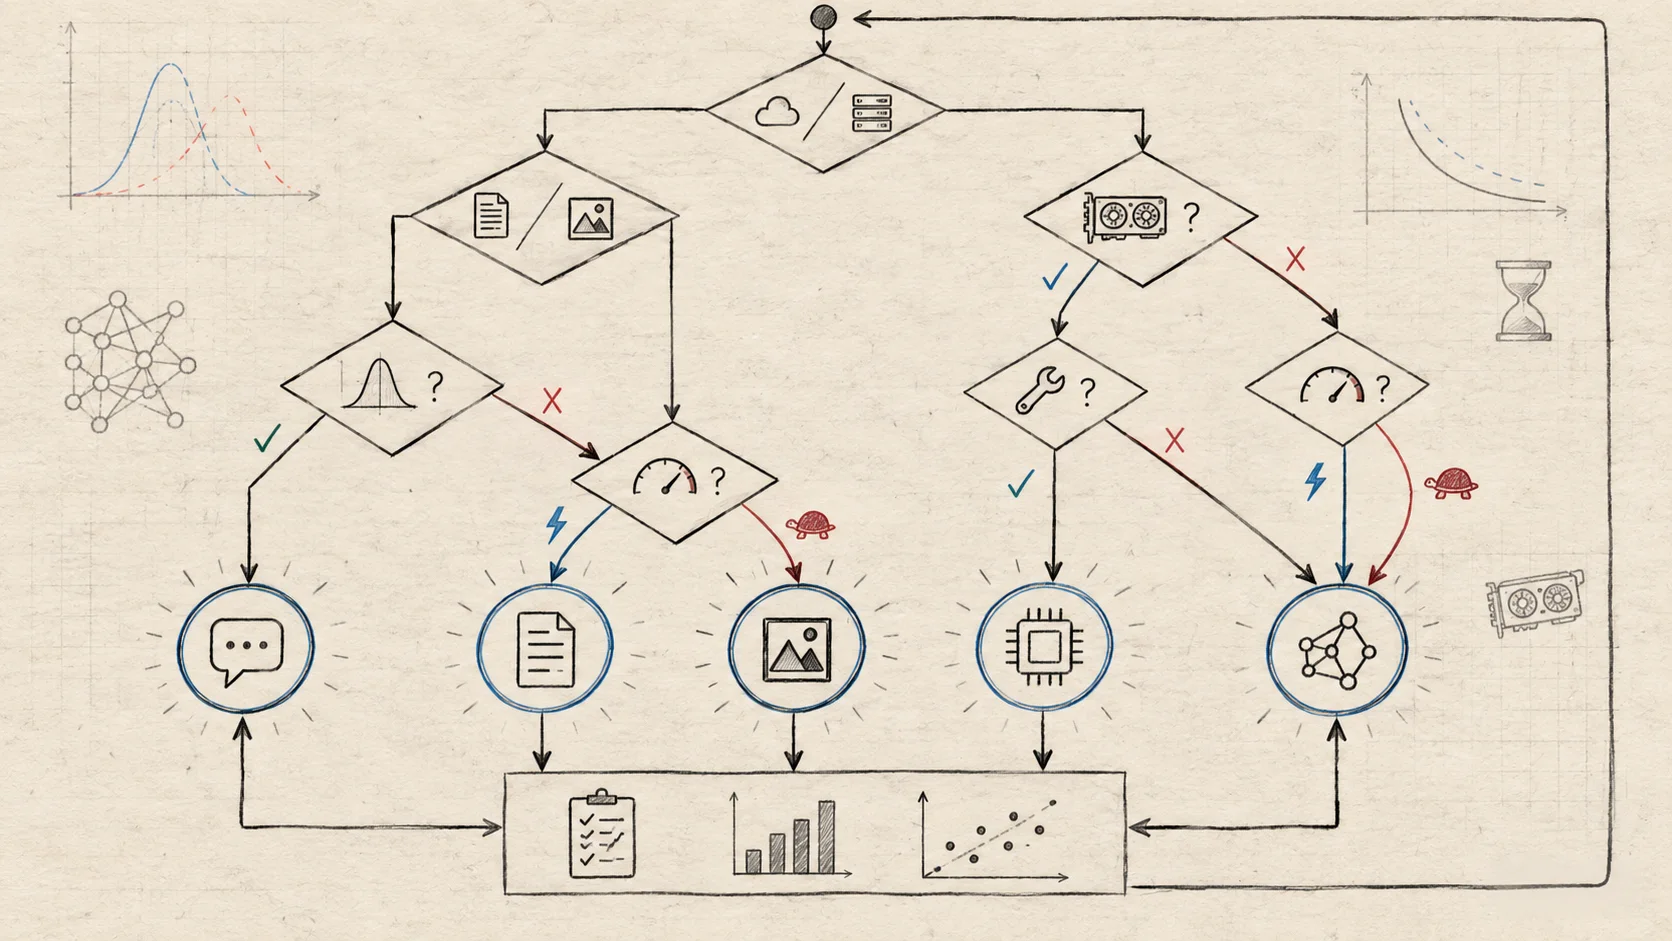
Empieza por la restricción que sería más costosa de cambiar más adelante:
| Restricción principal | Primeros sistemas que conviene evaluar | Motivo |
|---|---|---|
| API de producción gestionada | Jev, djev | Sin pila de servicio en GPU; compara calibración y necesidades multimodales |
| Entrada nativa de imágenes o cámara | djev, OpenJev | Ambas páginas destacan las entradas multimodales |
| Los datos deben permanecer en tu red | Laya, OpenJev, SemIf | El autoalojamiento mantiene bajo tu control el límite del servicio |
| Probabilidades calibradas para enrutamiento | Primero Jev y luego SemIf | Compara los umbrales con tus casos difíciles |
| Ajuste fino y pesos abiertos | Laya, OpenJev, SemIf | Puedes inspeccionar, modificar u operar el entorno de ejecución |
| Formato de petición compatible con Jev | Jev, OpenJev | OpenJev está diseñado en torno a una API compatible |
| Tráfico irregular sin GPU inactiva | Jev | El acceso alojado evita planificar la capacidad de un acelerador local |
| Latencia local muy baja | Laya, SemIf, OpenJev | Mide la latencia de extremo a extremo, no solo la inferencia del modelo |
Cómo realizar tu propia evaluación
El resultado más valioso no es un ganador universal, sino elegir un modelo que funcione con tus ejemplos reales.
1. Congela la interfaz de decisión
Usa el mismo State, la misma redacción de preguntas, las mismas opciones de respuesta y la misma política de salida para todos los sistemas. Si uno recibe un prompt más completo o una taxonomía distinta, la comparación no es justa.
2. Construye un conjunto de pruebas representativo
Incluye casos normales, ambiguos, contextos largos, entradas adversariales y ejemplos que deberían escalarse. Separa la clasificación sencilla de las decisiones en las que la probabilidad controlará una acción real.
3. Mide más que la precisión
Registra al menos:
- precisión exacta de las decisiones por nivel de dificultad;
- calibración o error de calibración esperado;
- latencia de extremo a extremo p50 y p95;
- coste con tráfico realista, incluido el tiempo de GPU inactiva;
- calidad multimodal cuando la tarea incluya imágenes;
- esfuerzo operativo de despliegues, actualizaciones e incidentes;
- requisitos de privacidad, retención y límites de red.
4. Prueba la política de umbrales
Si el código va a aprobar automáticamente, enrutar, bloquear o escalar usando una probabilidad, evalúa también el umbral. Un modelo que gane en promedio puede seguir siendo una mala elección si su señal de incertidumbre no es estable donde actúa tu aplicación.
5. Vuelve a probar después de los cambios
Los modelos abiertos, las vistas previas alojadas, los precios, los entornos de ejecución y las capas de calibración cambian. Guarda la versión del modelo, la configuración del entorno de ejecución, la fecha y el conjunto de pruebas junto con cada resultado del benchmark.
Preguntas frecuentes
¿Jev es siempre la opción de mayor calidad?
No. El benchmark de referencia sitúa a Jev en primer lugar en el resultado compuesto y en los casos difíciles, pero SemIf lidera la categoría evaluativa, djev la velocidad, Laya la propiedad de pesos abiertos y la latencia local, y OpenJev ofrece una vía compatible y autoalojada con imágenes y modo de razonamiento.
¿Qué sistema es mejor para un despliegue privado?
Evalúa primero Laya, OpenJev y SemIf, ya que sus páginas describen opciones autoalojadas. La elección adecuada depende de tu GPU, la política de datos, las necesidades de ajuste fino y la capacidad para calibrar probabilidades.
¿Qué modelo debería usar un agente de IA para la seguridad de herramientas?
Empieza por el sistema cuyas señales de probabilidad y límites operativos puedas validar. Para herramientas de gran impacto, conserva en el código de la aplicación los permisos deterministas y la aprobación humana, independientemente del modelo elegido.
¿Se pueden considerar los resultados del benchmark garantías actuales del producto?
No. La comparación es una instantánea fechada, medida sobre un conjunto definido de decisiones. Úsala para decidir qué probar y después ejecuta la misma carga de trabajo y política de umbrales en las versiones y modos de despliegue que planeas publicar.
Conclusión
Elegir entre Jev, djev, Laya, OpenJev y SemIf es una decisión de sistemas, no solo una competición por la calidad del modelo. Jev prioriza el acceso gestionado y las decisiones calibradas. djev prioriza la velocidad y la entrada visual nativa. Laya prioriza los pesos abiertos, el autoalojamiento y el ajuste fino. OpenJev prioriza un despliegue compatible con opciones multimodales y de razonamiento. SemIf prioriza los logits abiertos y el control del entorno de ejecución.
Elige la restricción más importante, prueba los casos difíciles donde los sistemas divergen y mide la política de probabilidad que realmente utilizará tu código. Así, una comparación se convierte en una decisión fiable para producción.