モデル比較
Jev・djev・Laya・OpenJev・SemIfを比較:どの判断モデルを使うべきか?
ベンチマーク品質、キャリブレーション、速度、マルチモーダル入力、セルフホスティング、オープンウェイト、本番運用上のトレードオフを基準に、Jev、djev、Laya、OpenJev、SemIfを比較します。
Jev・djev・Laya・OpenJev・SemIfを比較:どの判断モデルを使うべきか?
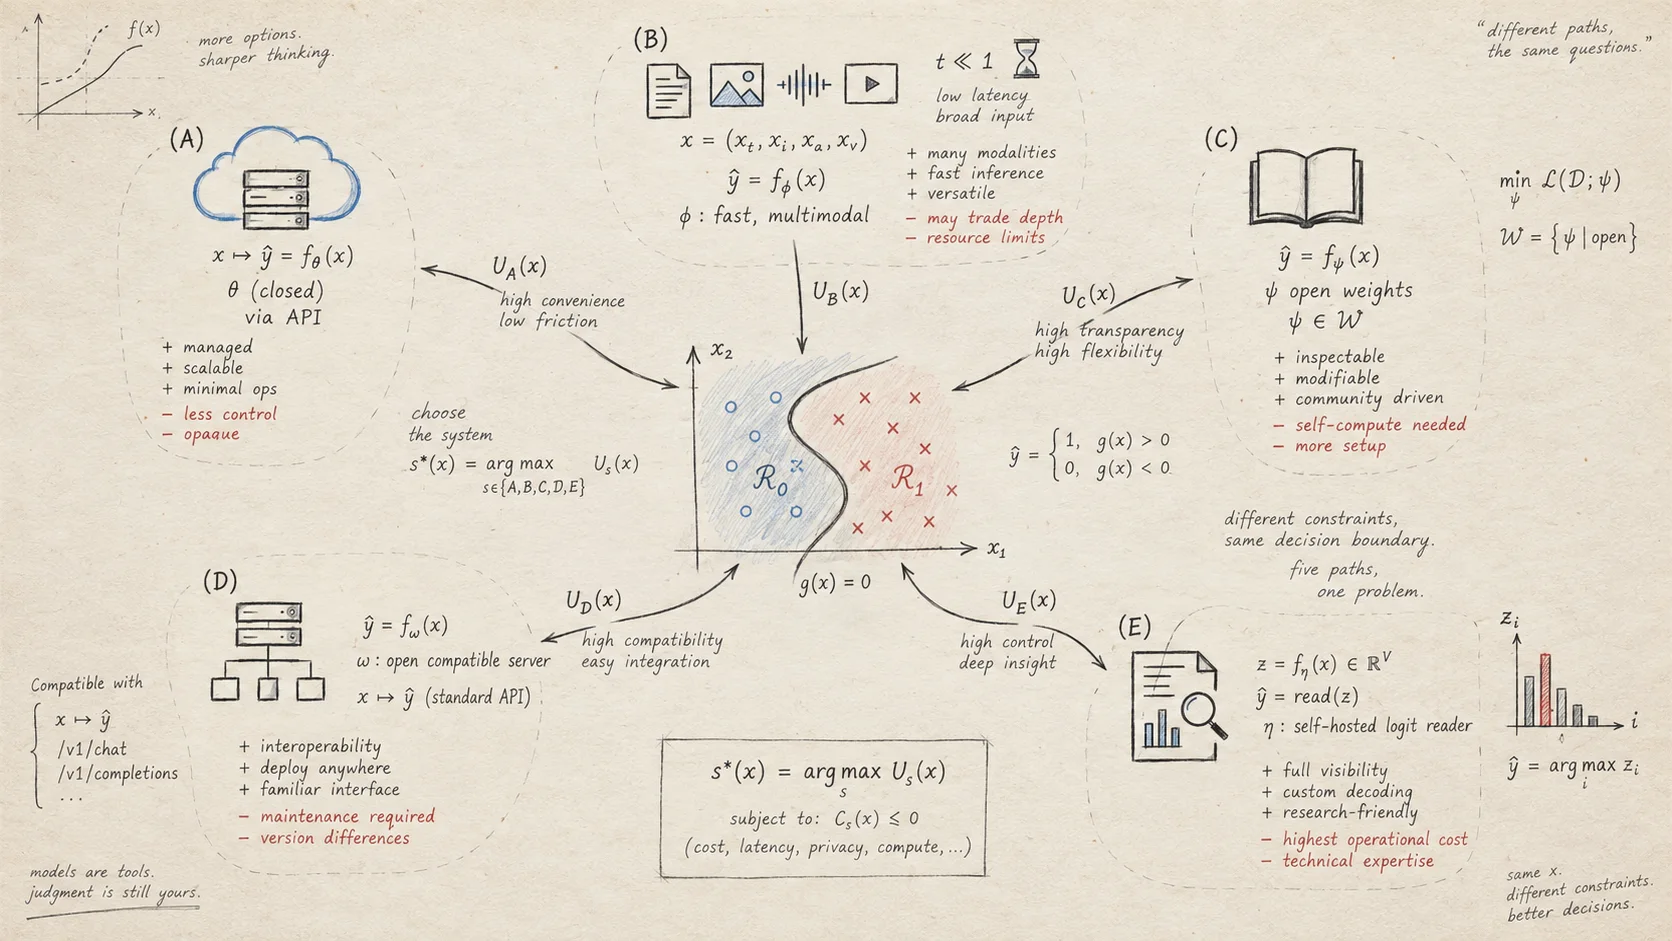
Jev、djev、Laya、OpenJev、SemIfを比べるとき、最も役立つ問いは「どのモデルが最高スコアか」ではありません。「自分の製品、データ境界、レイテンシー目標、キャリブレーション作業への許容度に合う運用モデルはどれか」です。
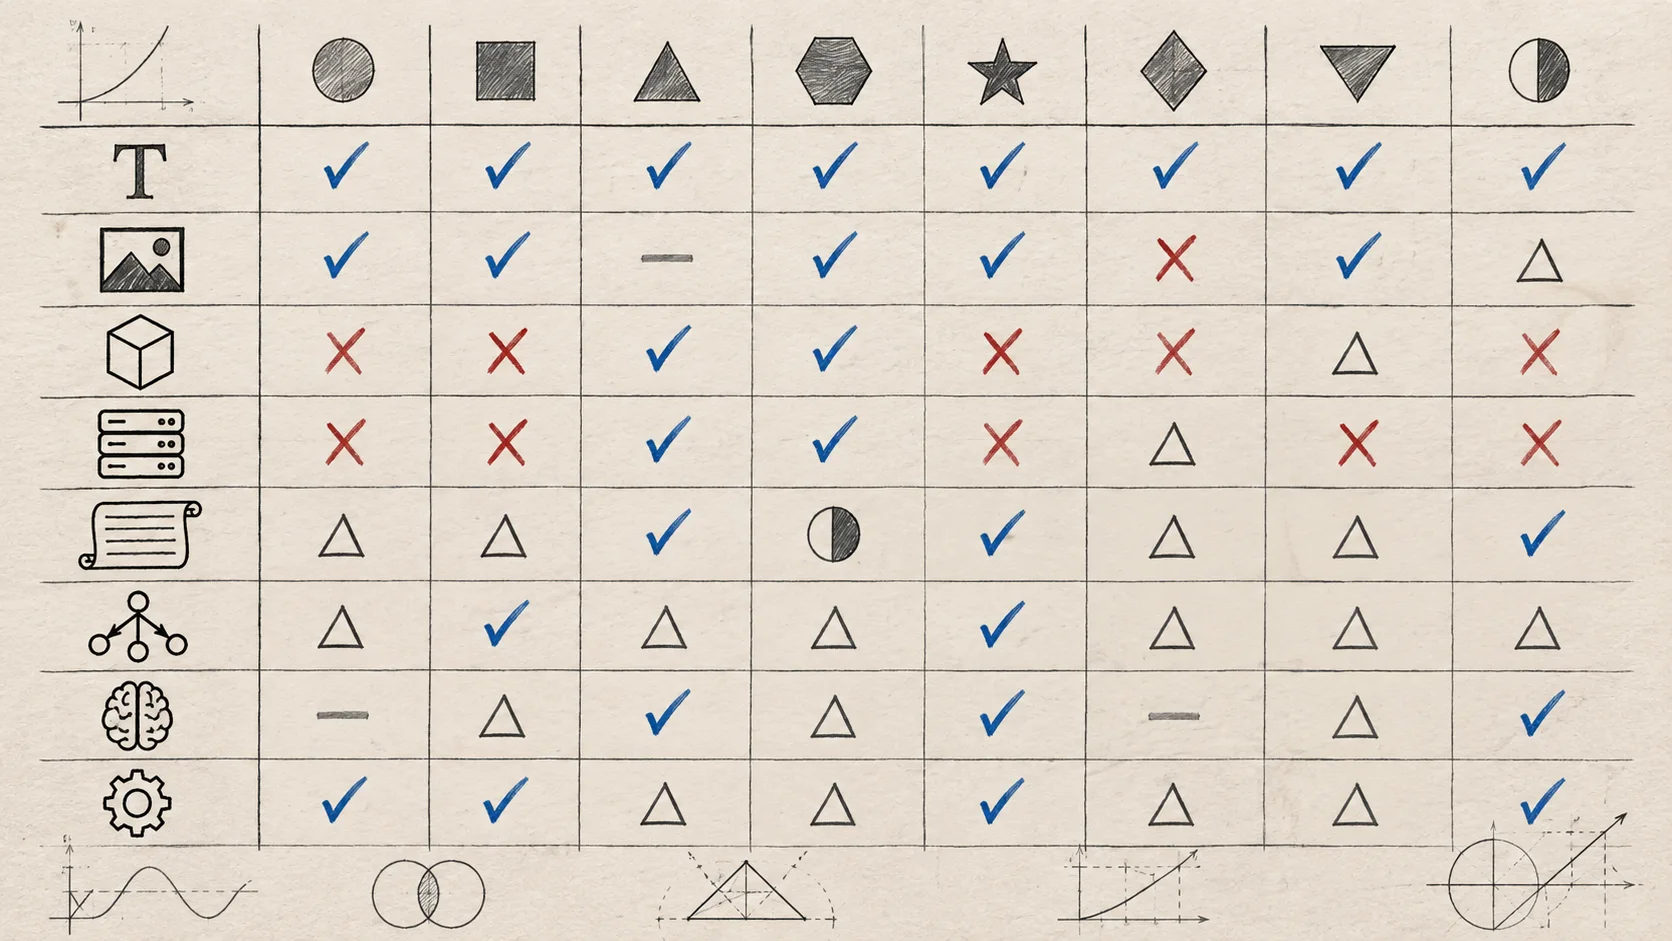
これらのシステムはいずれも通常のチャット補完ではなく構造化された判断を対象にしていますが、異なるトレードオフを選んでいます。Jevは、キャリブレーションされた型付き判断に重点を置くホスト型System Oneモデルです。djevは速度と画像・カメラ入力のネイティブ対応を重視します。Layaはオープンウェイト、セルフホスティング、ファインチューニングを提供します。OpenJevはマルチモーダル入力やThinkingオプションを備える、互換性のあるセルフホスト型サーバーを提供します。SemIfはオープンモデルのロジットを読み取り、データを自社インフラの管理下に置きながら、総合ベンチマークでJevに迫ります。
この記事では、公式比較ページと、2026年9月に更新されたJevBench v1.3.0の公開スナップショットを利用します。数値は判断材料として扱い、自分のワークロードでのテストに置き換わるものではないと考えてください。
目次
先に結論
GPUを運用したり、最初にキャリブレーション層を適合させたりせず、ホスト型API、型付き回答、振り分けやエスカレーションに利用できる確率が必要なら、Jevを選びます。
本番向けキャリブレーションより速度と画像・ライブカメラ入力のネイティブ対応が重要なら、特にホスト型プレビューが便利な間はdjevを選びます。
難しい判断のゼロショット品質より、オープンウェイト、オフライン展開、多言語対応、ファインチューニングを重視するなら、Layaを選びます。
画像入力やThinkingモードに対応した、セルフホスト可能でJev互換のリクエスト形式が必要で、実行環境を運用できるなら、OpenJevを選びます。
自分で管理するモデルから判断用ロジットを読み取るオープン実装を求め、データをネットワーク内に保持し、キャリブレーション用のGPU容量と評価プロセスを用意できるなら、SemIfを選びます。
ベンチマークの読み方
参照するJevBench v1.3.0の比較では、52システム、534件の判断に対して共通の評価方法を適用しています。内訳は簡単なケース72件、標準96件、判定形式146件、難しいケース220件です。総合スコアは知能、キャリブレーション、速度、コストを組み合わせています。
公開された総合スナップショットは次のとおりです。
| システム | 順位 | 総合スコア | 主な運用形態 |
|---|---|---|---|
| Jev 1.13.0 | #1 | 74.4 | ホスト型の本番API |
| SemIf | #2 | 73.1 | オープンモデルのセルフホスト型ロジット読み取り |
| djev | #3 | 73.0 | マルチモーダル入力対応のホスト型API |
| OpenJev | #11 | 66.4 | 互換性のあるセルフホスト型判断サーバー |
| Laya | #33 | 54.4 | セルフホスト型オープンウェイト |
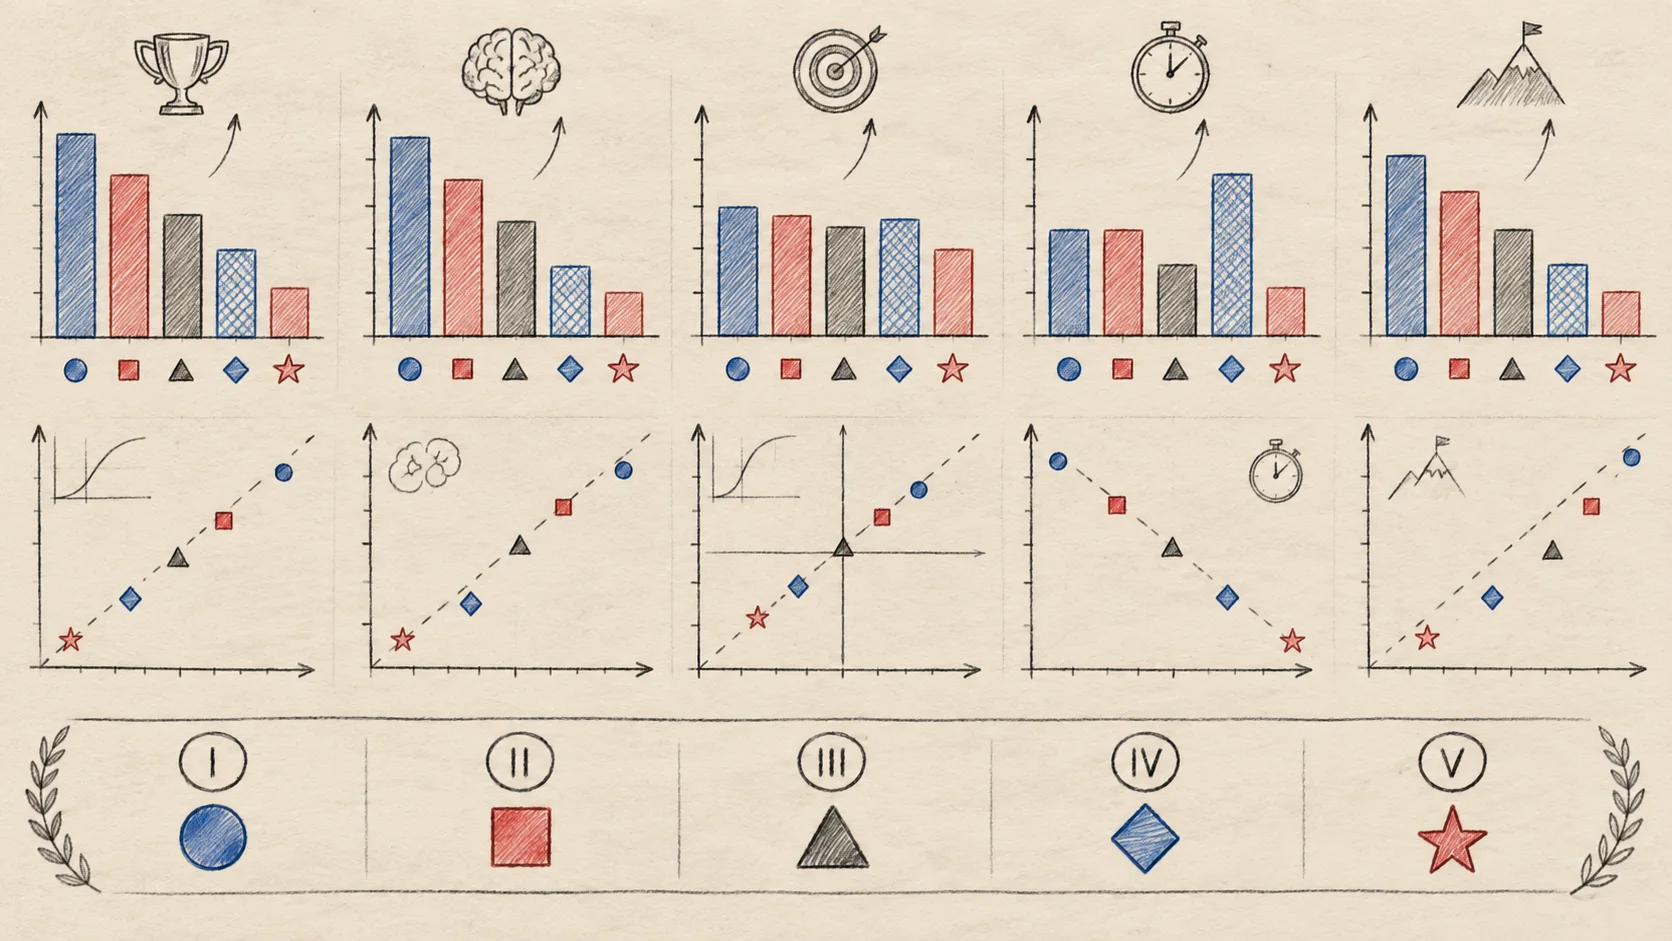
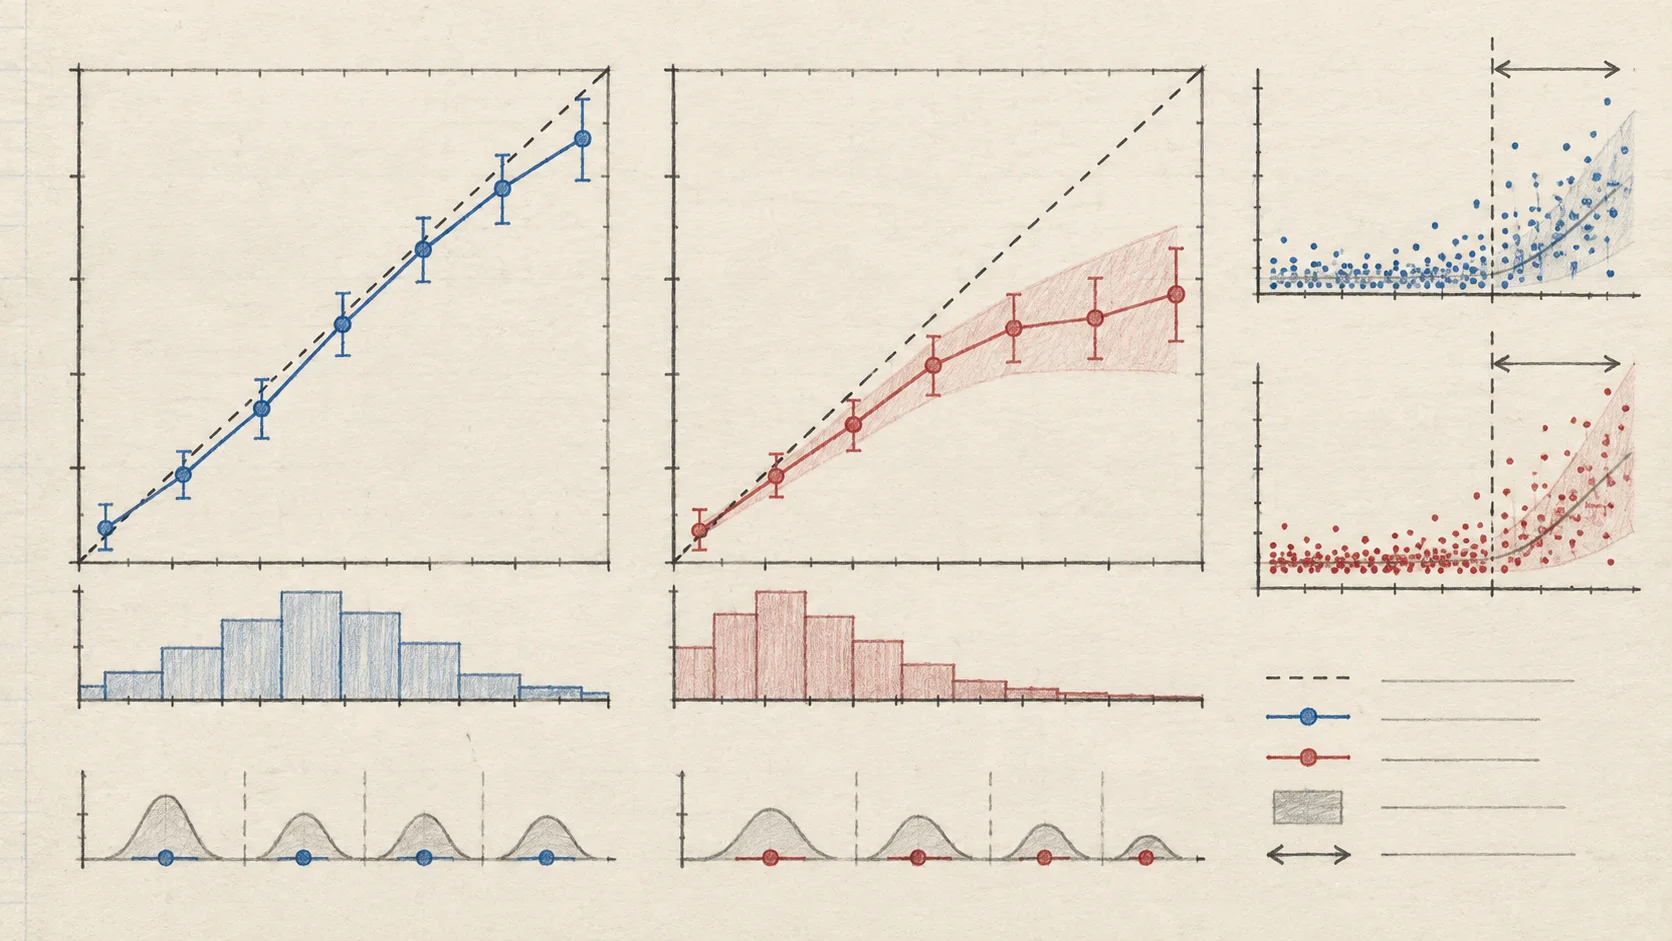
総合スコアだけでは重要な違いが隠れてしまいます。速度は速くてもキャリブレーションが弱い、低コストでも運用が難しい、判定タスクでは正確でも実際の曖昧なケースに弱いシステムもあります。確率しきい値を使うエージェントやワークフローでは、生の精度がわずかに変わることよりキャリブレーションの方が重要な場合があります。
5つのシステムの概要
| システム | 強み | トレードオフ | 得意な用途 |
|---|---|---|---|
| Jev | ホスト型の型付き判断とキャリブレーション済み確率 | テキストのみの入力、従量制API | 本番環境での振り分け、スコアリング、ガードレール |
| djev | 高速で、画像やカメラフレームをネイティブ処理 | 確率は実験的な機能として説明されている | 高速なマルチモーダル試作、視覚判断 |
| Laya | Apache-2.0のウェイト、CPU/GPUセルフホスト、ファインチューニング | 本番品質の安定にはタスクデータと調整が必要 | 学習リソースのあるオフラインまたは多言語システム |
| OpenJev | Jev互換API、画像、Thinkingモード | GPUまたはApple Siliconの運用と設定 | 慣れた形式を求めるセルフホストチーム |
| SemIf | オープン実装、オフラインのロジット処理、強い総合スコア | 自前のGPU、サービング、ワークロードごとの調整 | モデル運用に慣れたチーム、管理されたネットワーク |
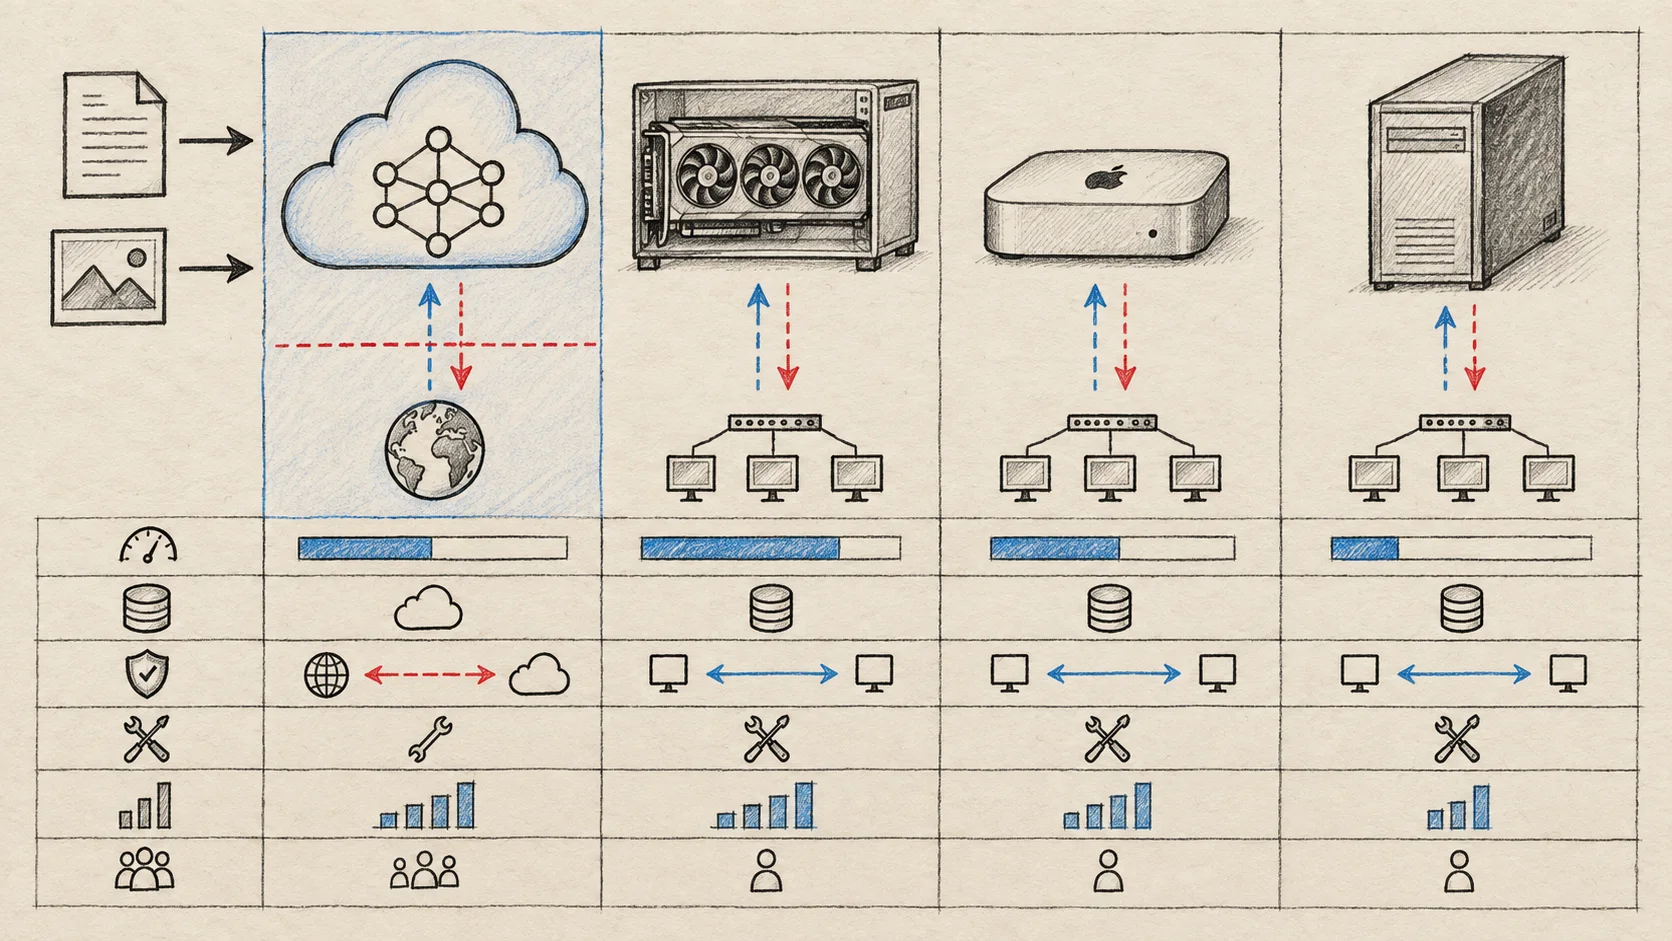
デプロイ境界は、リーダーボードより重要なことがよくあります。ホスト型APIはインフラ作業を減らしますが、リクエストを外部ベンダーに送信します。セルフホスト型モデルはデータを自社システムに近い場所に保てる一方、容量計画、監視、アップグレード、キャリブレーションが自分たちの責任になります。
Jevとdjev
Jevとdjevの比較では、接戦ながら運用上の優先事項が明確に異なると説明されています。
公開されているキャリブレーションスコアではJevが82.7で、djevの65.4を上回ります。難しいケースでの精度比較も74.1%対69.5%でJevが優位です。速度の軸ではdjevが91.4、Jevが83.3です。簡単なケースと標準ケースでは両システムの差が小さく、生の精度よりデプロイ方法の選択が重要になる場合があります。
入力の境界が決め手になります。
- Jevはテキスト、JSONオブジェクト、テキスト配列を中心に扱います。
- djevはテキスト、画像のネイティブ入力、画像オプション、ライブカメラフレームを受け付けます。
- どちらもNoul、Choice、Scoreのような型付き判断形式をサポートします。
確率を自動承認、エスカレーション、重み付け、振り分けに使い、本番向けのホスト型経路を希望する場合はJevを選びます。視覚コンテキストや非常に低いレイテンシーが最優先で、独自評価で確認できるまでは確率出力を実験的なものとして扱える場合はdjevを選びます。
料金モデルも異なります。比較ページでは、Jevは利用量ベースのモデルを予定するホスト型本番API、djevは料金発表済みの無料プレビューとして説明されています。プレビューの提供状況と料金は変わる可能性があるため、アーキテクチャを決める前に最新条件を確認してください。
JevとLaya
JevとLayaの比較は、すぐ使えるホスト型モデルと、自分で調整できるオープンウェイトモデルの比較が中心です。
比較対象となった構成で、難しいケースの公開精度はJevが74.1%、Layaが34.1%です。知能スコアはJevが85.7、Layaが45.8です。一方、Layaは適切なハードウェア上でのローカル推論を大幅に高速化するよう設計されています。Layaの最大の強みはゼロショット品質ではなく、所有権、ファインチューニング、オフライン運用、そして高稼働のGPUをすでに利用できる場合の低い限界費用です。
主な違いは次のとおりです。
- 比較ではJevは1リクエストあたり最大64kトークンを受け付けますが、Layaの質問ごとのコンテキストは512トークンです。
- LayaはApache-2.0のウェイトと、英語または多言語のチェックポイントを提供します。
- Layaで本番タスクの品質を安定させるには、ラベル付きの例とファインチューニングが必要です。
- Jevはホスト型APIですぐ利用でき、アイドル状態のGPUや学習ジョブを管理する必要がありません。
データをネットワーク外に出せず、固定タクソノミー、ラベル付きの例、モデルサービングを担当できるチームがある場合はLayaが適することがあります。インフラを構築せずに判断ワークフローを検証したい場合は、Jevが取り組みやすい最初の選択肢です。
JevとOpenJev
JevとOpenJevの比較では、リクエスト形式より、リクエストがアプリケーションを離れた後に何が起きるかが焦点になります。
OpenJevは互換性のある判断サーバーとして設計されています。一般的な /v1/systemone 形式のリクエストを受け付け、24GBのNVIDIA GPUまたはApple Silicon上で動作し、1リクエストあたり最大8枚の画像を受け取り、品質とレイテンシーのトレードオフがあるThinkingモードを提供できます。Jevはテキスト判断を中心とするホスト型本番APIです。
公開されたデフォルト構成同士の比較では、キャリブレーションはJevが82.7、OpenJevが64.8、難しいケースの精度は74.1%対65.5%です。速度スコアは83.3対83.2でほぼ同じです。OpenJevのThinking構成は別の運用ポイントで、比較ページでは知能スコア88.0、難しいケースで78.2%とされています。したがって、デフォルト構成同士の比較に混ぜるべきではありません。
画像入力、セルフホスティング、Apache-2.0のコードとウェイト、またはネットワーク内で実行できる互換APIが必要ならOpenJevを選びます。キャリブレーション済みの確率、運用管理、迅速な本番導入がランタイム所有権より重要ならJevを選びます。
JevとSemIf
JevとSemIfの比較では、公開された総合ランキングで最も近いオープンな代替候補として、SemIfが73.1、Jevが74.4で、それぞれ2位と1位です。
差は全般的というより、特定の項目に集中しています。
- 判定ケースではSemIfが95.2%で、Jevの94.5%を上回ります。
- 難しいケースではJevが74.1%で、SemIfの59.5%を上回ります。
- キャリブレーションスコアはJevが82.7、SemIfが72.6です。
- 速度スコアはJevが83.3、SemIfが83.7でほぼ同等です。
SemIfはオープンモデルのロジット読み取り方式を採用し、ベンチマークの主な構成ではQwen3.5-4Bを使っています。コードはMITライセンスですが、上流のモデルウェイトはそれぞれのライセンスに従います。推論を自分の環境に置けますが、GPU、サービング基盤、容量計画、自分のワークロード向けのキャリブレーションは自分たちで担当します。
確率シグナルをすぐに使いたく、トラフィックの変動が大きくアイドルGPUの費用が無駄になりそうな場合はJevが有力です。高稼働GPUをすでに利用でき、オフライン運用が必要で、しきい値の調整と監視に対応できるチームにはSemIfが魅力的です。
制約を基準に選ぶ
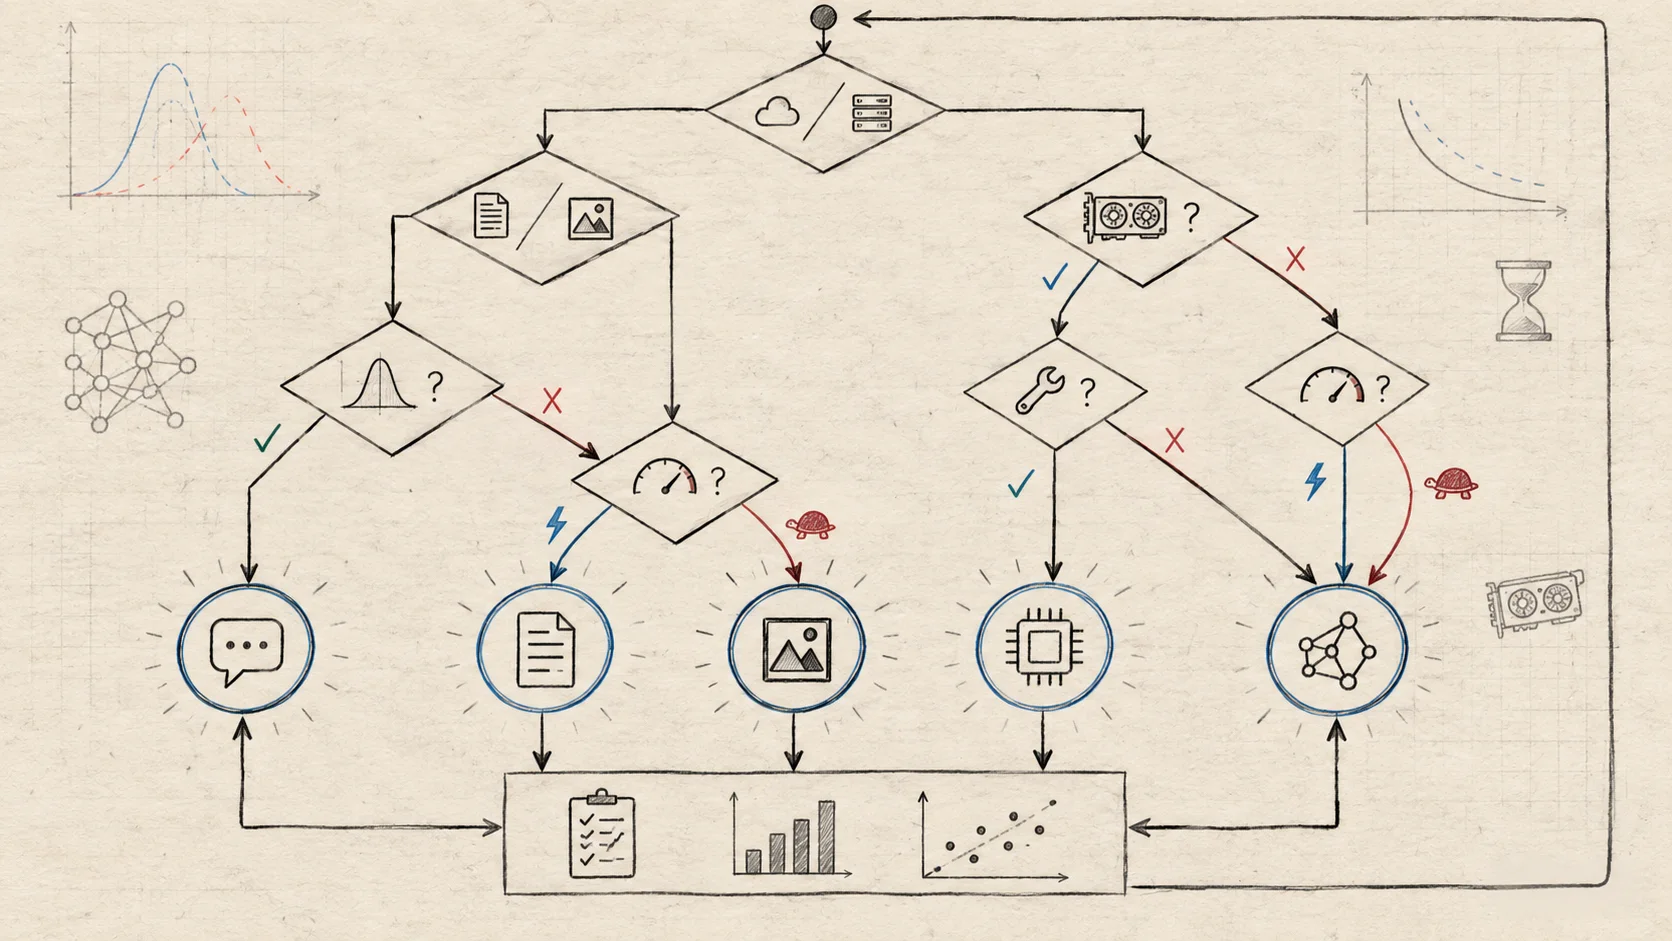
後から変更するコストが最も高くなる制約を起点にします。
| 主な制約 | 最初に評価するシステム | 理由 |
|---|---|---|
| 運用管理された本番API | Jev、djev | GPUサービング基盤が不要。キャリブレーションとマルチモーダル要件を比較できる |
| 画像またはカメラのネイティブ入力 | djev、OpenJev | どちらの比較ページもマルチモーダル入力を強調している |
| データを自社ネットワーク内に保持 | Laya、OpenJev、SemIf | セルフホストによりサービング境界を管理できる |
| 振り分け用のキャリブレーション済み確率 | まずJev、次にSemIf | 自社の難しいケースでしきい値を比較する |
| ファインチューニングとオープンウェイト | Laya、OpenJev、SemIf | ランタイムを調査、変更、運用できる |
| Jev互換のリクエスト形式 | Jev、OpenJev | OpenJevは互換性のあるAPI形式を中心に設計されている |
| アイドルGPUなしの変動するトラフィック | Jev | ホスト型アクセスではローカルアクセラレーターの容量計画が不要 |
| 非常に低いローカルレイテンシー | Laya、SemIf、OpenJev | モデル推論時間だけでなく、エンドツーエンドのレイテンシーを測定する |
独自の評価を実施する
最も価値のある結果は、どの環境でも通用する勝者ではありません。実際の例で期待どおり動作するモデル選択です。
1. 判断インターフェースを固定する
すべてのシステムで同じState、質問文、回答選択肢、出力ポリシーを使います。あるシステムだけに詳しいプロンプトや別のタクソノミーを与えると、公平な比較にはなりません。
2. 代表的なテストセットを作る
通常のケース、曖昧なケース、長いコンテキスト、敵対的な入力、エスカレーションすべき例を含めます。簡単な分類と、確率が実際のアクションを制御する判断を分けてください。
3. 精度以外も測る
最低限、次を記録します。
- 難易度別の正確な判断精度。
- キャリブレーションまたは期待キャリブレーション誤差。
- p50とp95のエンドツーエンドレイテンシー。
- アイドルGPU時間を含む、現実的なトラフィックでのコスト。
- 画像を含むタスクでのマルチモーダル品質。
- デプロイ、アップグレード、インシデント対応の運用負荷。
- プライバシー、データ保持、ネットワーク境界に関する要件。
4. しきい値ポリシーをテストする
確率に基づいてコードが自動承認、振り分け、ブロック、エスカレーションを行うなら、しきい値自体を評価します。平均スコアで勝つモデルでも、アプリケーションが実際に動作する領域で不確実性シグナルが安定していなければ、適切な選択とは限りません。
5. 変更後に再テストする
オープンモデル、ホスト型プレビュー、料金、ランタイム、キャリブレーション層は変化します。各ベンチマーク結果とともにモデルのバージョン、ランタイム設定、日付、テストセットを記録してください。
よくある質問
Jevは常に品質面で最善ですか?
いいえ。参照したベンチマークでは総合評価と難しいケースでJevが1位ですが、判定ケースはSemIf、速度はdjev、オープンウェイト所有とローカルレイテンシーはLayaが強く、OpenJevは画像とThinkingモードに対応する互換セルフホスト経路を提供します。
プライベート環境へのデプロイに適したシステムは?
比較ページでセルフホスト経路が説明されているLaya、OpenJev、SemIfをまず評価します。適切な選択はGPU、データポリシー、ファインチューニング要件、確率を調整する能力によって異なります。
AIエージェントのツール安全性にはどのモデルを使えばよいですか?
確率シグナルと運用境界を検証できるシステムから始めます。影響の大きいツールでは、どのモデルを選んでも、アプリケーションコード内で決定論的な権限チェックと人の承認を維持してください。
ベンチマークスコアを現在の製品保証として扱えますか?
いいえ。この比較は、定義された判断セットで測定した特定日時のスナップショットです。テスト候補を選ぶ参考にし、実際にリリースする予定のバージョンとデプロイ方式で同じワークロードとしきい値ポリシーを実行してください。
最後に
Jev、djev、Laya、OpenJev、SemIfの選択は、単なるモデル品質コンテストではなく、システムの選択です。Jevは運用管理されたアクセスとキャリブレーション済み判断を重視します。djevは速度と画像のネイティブ入力を重視します。Layaはオープンウェイト、セルフホスティング、ファインチューニングを優先します。OpenJevはマルチモーダルやThinkingの選択肢を備えた互換デプロイを目指します。SemIfはオープンなロジットとランタイム制御を重視します。
最も重要な制約を選び、システム間で差が出る難しいケースをテストし、コードが実際に使用する確率ポリシーを測定してください。そうすることで、比較結果を信頼できる本番判断につなげられます。