モデル比較
JevとLayaを比較:ホステッドAPIとオープンウェイトの選び方【2026】
JevとLayaをベンチマーク、微調整、確率校正、コンテキスト、レイテンシ、対応言語、総コストで比較し、用途に合う判断モデルを選びます。
LayaとJevを比べるとき、最初の問いは「常にどちらが勝つか」ではありません。製品に必要な運用境界です。Jevはすぐ使えるホステッド型の意思決定API、Layaは自分で運用・調整できるオープンウェイトのモデルです。ラベル付きデータ、データ保管場所、言語、コンテキスト長、推論を運用するチームの有無が選択を左右します。
以下のJevBenchデータはv1.3.0に基づき、2026年9月22日に確認しました。特定のベンチマーク結果であり、すべての業務での性能を保証するものではありません。
まず結論
要件先に評価する候補理由ラベルや微調整チームがないJev事前の微調整なしで使うホステッドAPIです。データを自社ネットワーク内に保持Layaオープンウェイトをローカルで運用・調整できます。長いチケット、文書、実行記録Jev比較ページでは1リクエスト64kトークンです。多言語ルーティングLaya多言語チェックポイント多言語モデルがありますが、言語ごとの検証が必要です。GPU運用チームがないJevGPU準備やモデル更新、推論監視を避けられます。
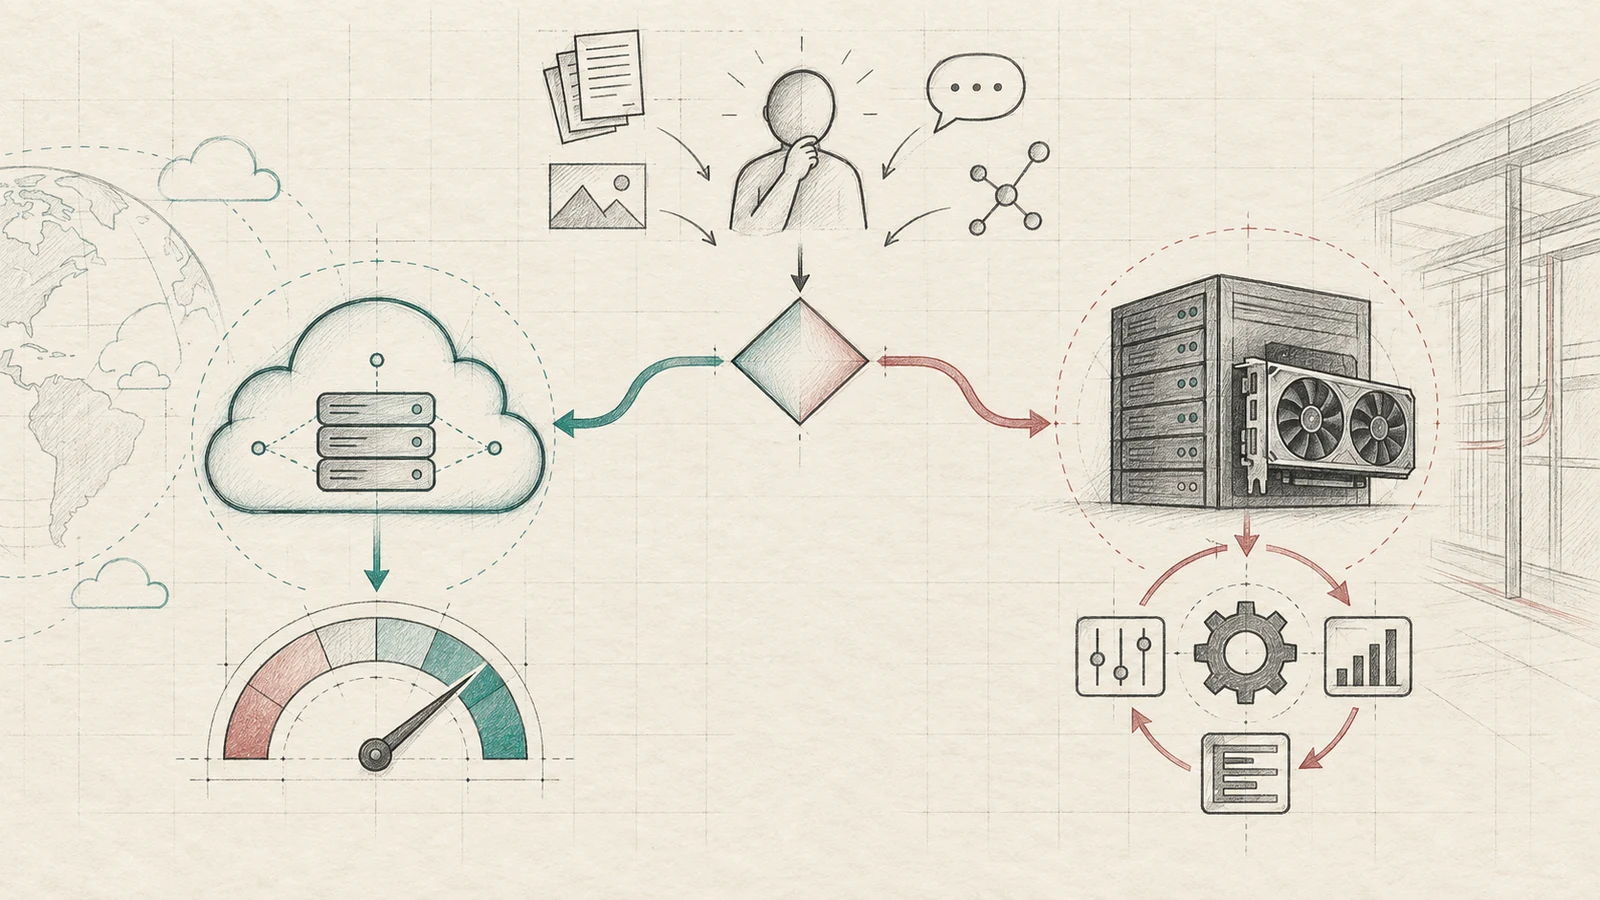
JevとLayaの提供形態
どちらも「どのキューか」「許可するか」「何点か」のような構造化された判断に使えます。自由文を生成して後から解析する方式の代替です。
-
JevはTypeSafeのホステッドSystem One APIです。比較ページでは事前学習なしで利用でき、1リクエスト64kトークン、Choiceの選択肢は最大255個とされています。GPUを自社運用せずにAPIを呼び出せます。
-
Layaはエンコーダー上に構築されたオープンな判断モデルです。Apache-2.0実装をローカルで実行し、タスクに合わせて微調整できます。比較で評価されたチェックポイントは1問512トークンですが、公式ページではモデルごとに異なる上限が示されています。導入するバージョンを確認してください。
どちらも汎用チャットボットではありません。明確なスキーマ、安定したラベル、不確実な回答を扱うルールが必要です。
JevBench v1.3.0の結果
同じ534件の構造化判断で52システムを評価しました。簡単なケース72件、標準96件、判定型146件、難しいケース220件です。Jevは総合74.4点で1位、Layaは54.4点で33位でした。
指標Jev 1.13.0Laya総合スコア74.454.4Intelligenceスコア85.745.8Calibrationスコア82.762.5難しいケースの正答率74.1%34.1%標準ケースの正答率99.0%72.9%
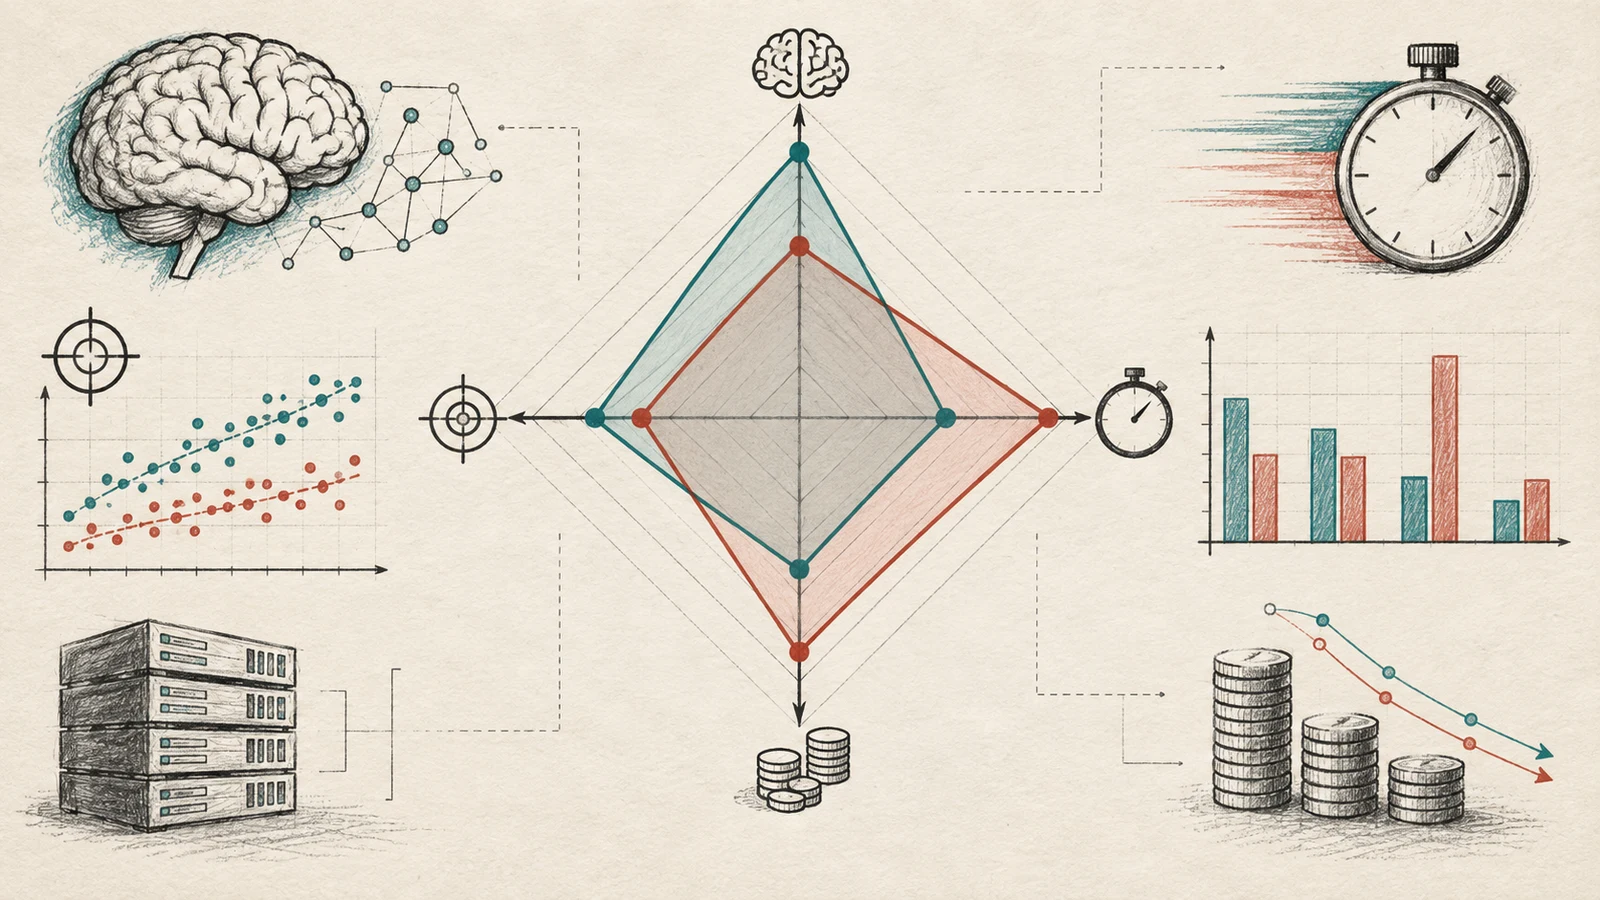
これは普遍的な製品ランキングではありません。一つの問題セットと、微調整前のLaya構成による結果です。Layaを安定したラベルで微調整する場合は、学習に使っていないデータで別に評価しましょう。
コンテキスト長と言語
長文には判断を変える重要な一文が含まれることがあります。比較ページではJevが64kトークン、評価対象のLayaが1問512トークンです。Laya公式ページは英語と多言語のチェックポイントを区別しているため、実際の上限はバージョンによって異なります。導入するモデルと入力形式でトークン数を測ってください。
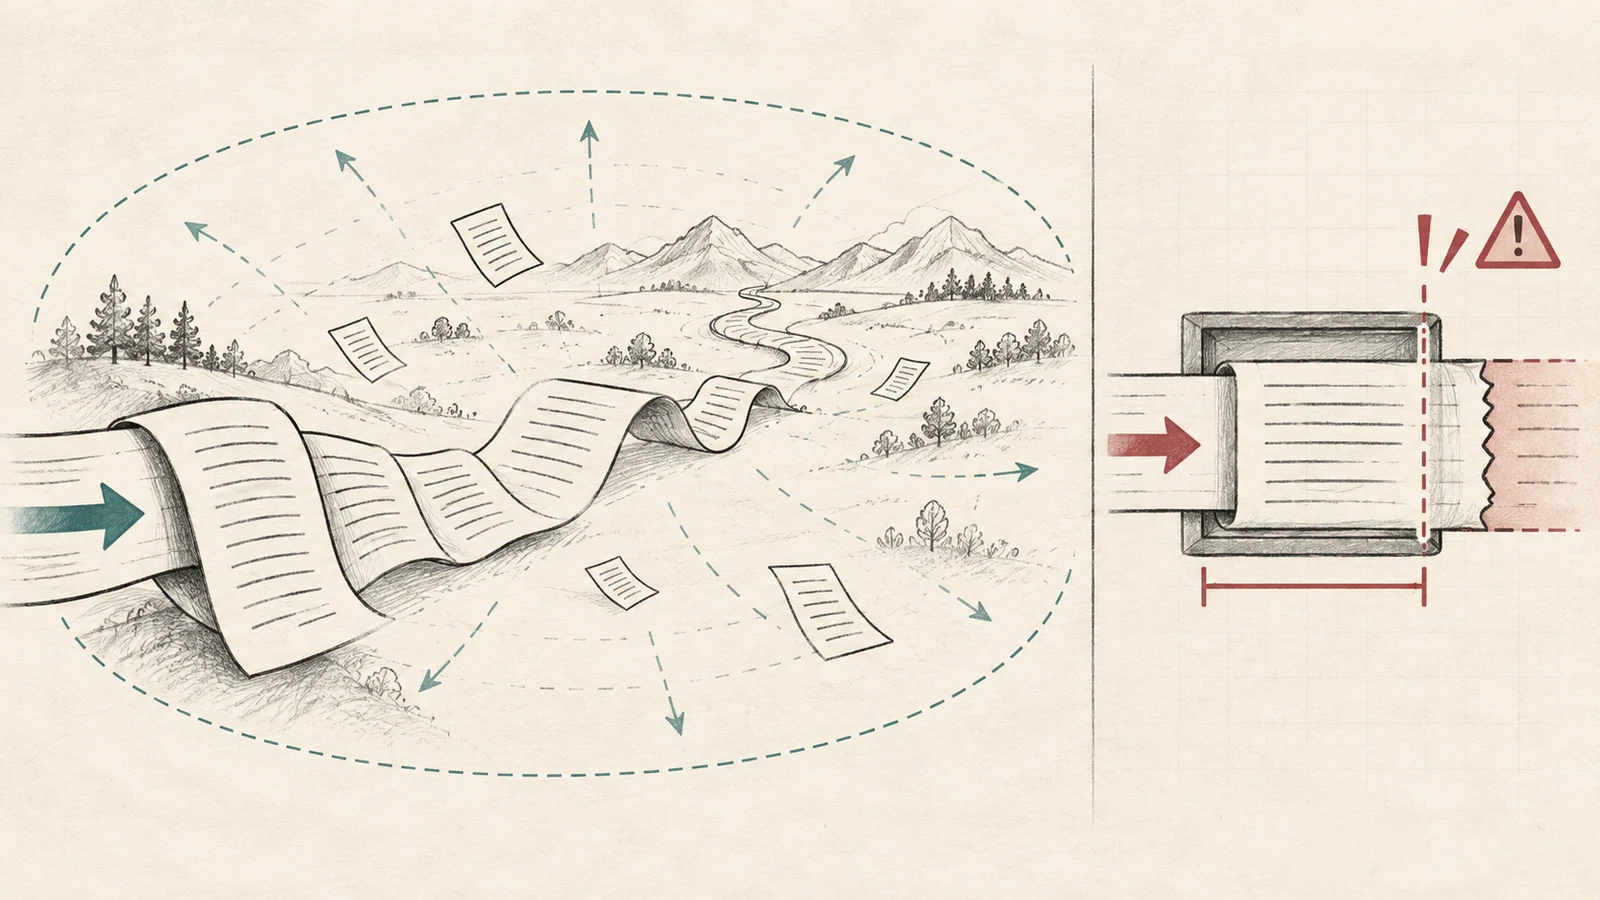
英語以外が必要ならLayaの多言語チェックポイントを評価する価値があります。ただし言語対応は品質の均一性を保証しません。人名、文字体系、言語の切り替え、専門用語を含むテストを言語ごとに用意します。
正答率、信頼度、レイテンシ
正答率はラベルが合っている割合です。校正は、信頼度0.8が似たケースでおよそ80%の正答率を示すかを測ります。期待校正誤差は、信頼度ごとのグループで平均信頼度と正答率の差をまとめる指標です。
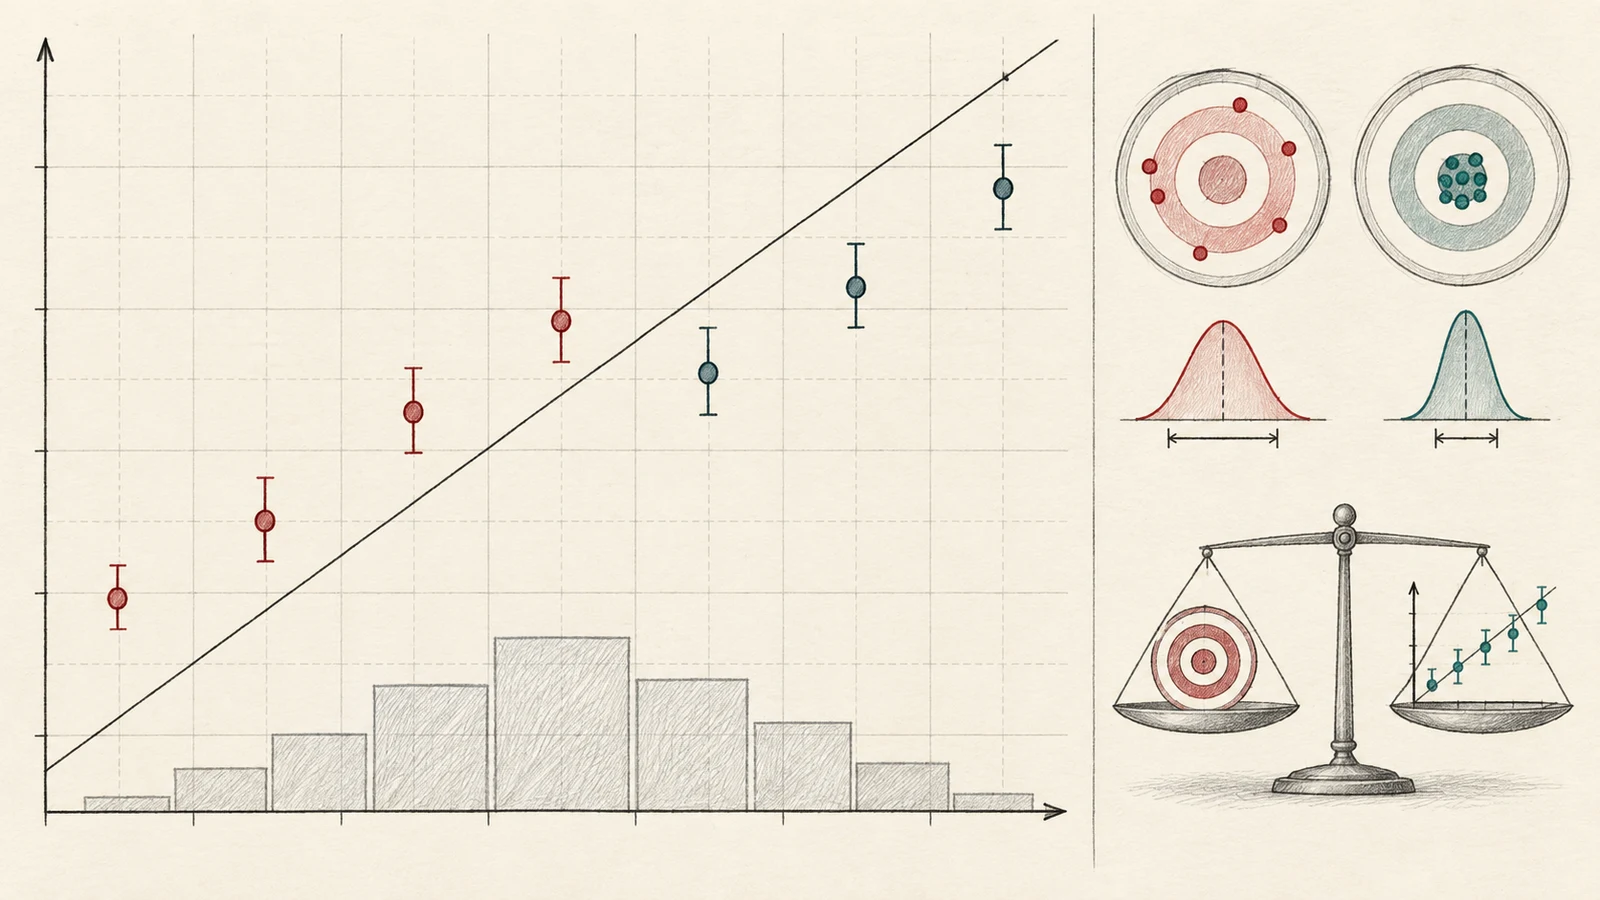
今回のJevBench設定ではJevの校正スコアが高くなっています。Layaの資料ではタスクに合わせた温度調整が説明されています。どちらの場合も本番に近いデータでしきい値を選び、正答率とカバレッジを一緒に報告しましょう。回答を控えるほど、回答したケースだけの正答率が上がることがあるためです。
LayaはTesla T4上で数十ミリ秒の推論を報告しています。一方、比較ページではJevBenchのCPU計測が生0.79秒、調整後1.72秒、JevのホステッドAPI中央値が0.65秒とされています。ハードウェアや配信経路が異なるため直接比較できません。自社のネットワーク、同時実行数、コールドスタート、P95を測定してください。
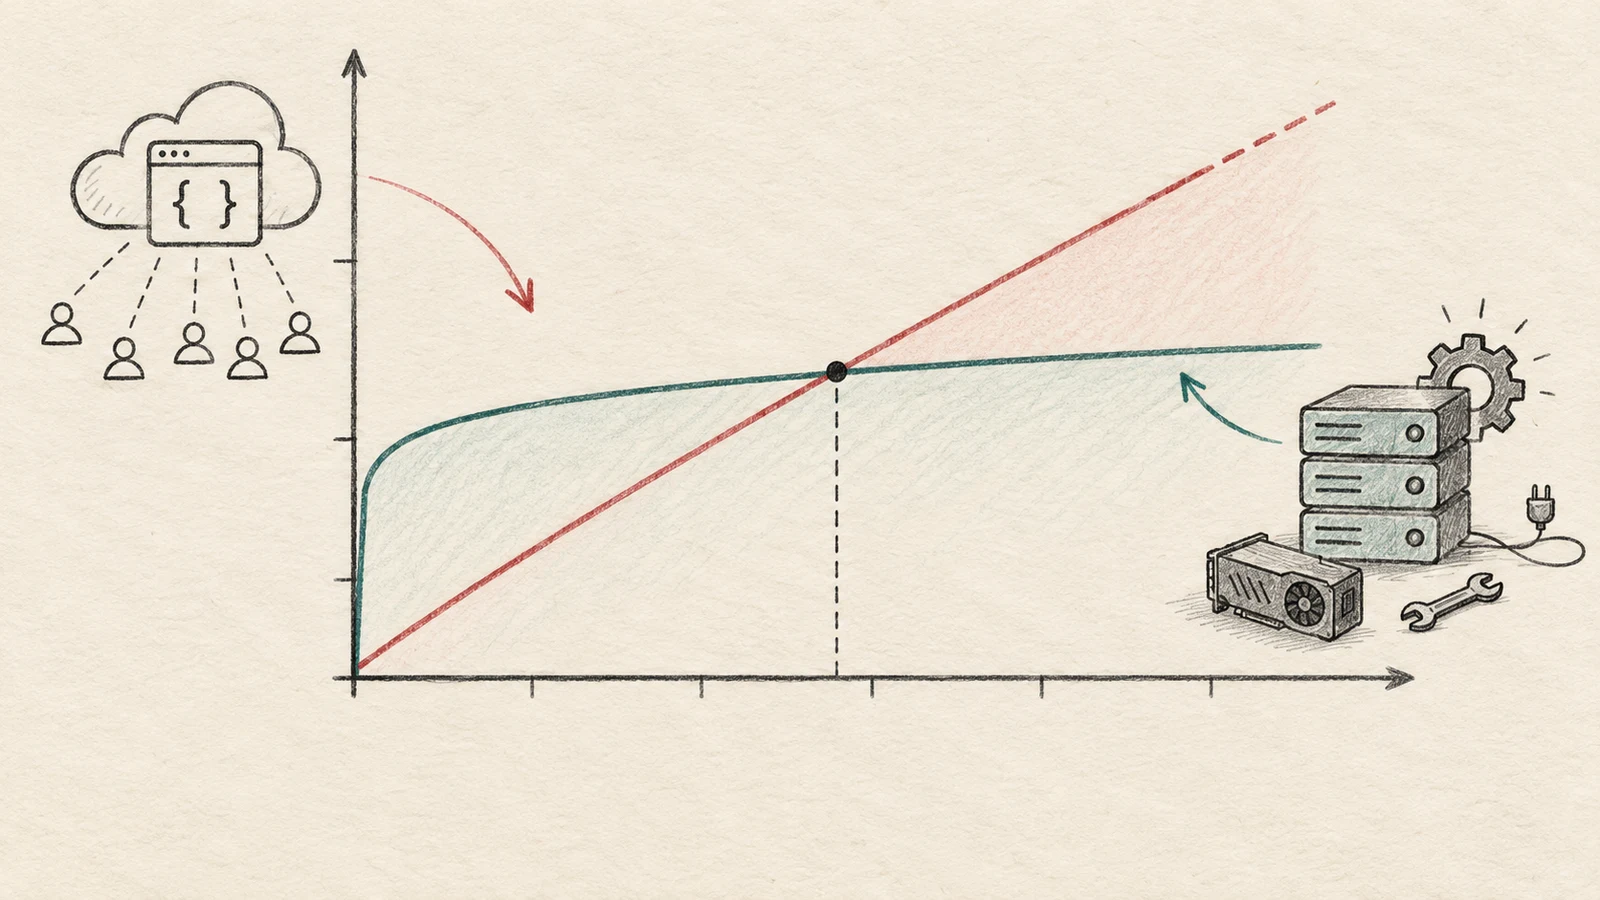
コストはAPI料金だけでなく、GPU容量、運用、監視、微調整、アイドル時間を含めて比較します。既存GPUの利用率が高ければ自社運用の追加費用は低くなる可能性がありますが、専用容量や保守で総額は変わります。
実務向けの評価手順
-
入力スキーマ、ラベル、同点処理、「不明」の定義を固定する。
-
通常、曖昧、多言語、長文、高リスクのケースを含むテスト用データを分ける。
-
クラス別F1、誤分類、校正、しきい値別カバレッジ、棄権率を比べる。
-
P50/P95レイテンシ、処理量、コールドスタート、失敗、切り捨てを測る。
-
アノテーション、GPU利用率、ホスティング、監視、保守、API料金を総費用に含める。
-
重大な操作を許可する前に、両モデルをシャドー運用し人の判断と比べる。
Zero-shot判断とマネージド運用が必要ならJevを基準にし、オープンウェイト、データ所在地、多言語ルーティング、微調整が重要ならLayaを評価しましょう。関連ガイド:JevとLaya、JevとOpenJev、Jevとdjev。
Jev vs Laya よくある質問
LayaはJevをそのまま置き換えられますか?
すべての用途で置き換えられるわけではありません。Layaではチェックポイント選択と運用が必要で、微調整や校正が本番品質に影響します。Jevはデータ境界と運用形態が異なるホステッドAPIです。
どちらが速いですか?
ハードウェアとリクエスト場所によります。CPU測定をTesla T4の値と直接比較できません。ネットワーク時間とP95も測りましょう。
多言語にはどちらが向いていますか?
Layaには多言語チェックポイントがあります。Jevの比較ページも100以上の言語に触れていますが、英語以外では信頼性が低いとしています。実際の言語と業務領域で評価してください。
信頼度しきい値で自動化できますか?
ホールドアウトデータで校正とエラーコストを確認してからです。誤承認、誤拒否、カバレッジ、人による確認負荷を記録します。
出典
ベンチマーク値はJevとLayaの比較およびJevBench v1.3.0に基づき、2026年9月22日に確認しました。チェックポイント情報はLayaプロジェクトとGitHubリポジトリを参照しています。本番利用前にバージョン、上限、料金を再確認してください。