KI-Agenten
Zuverlässigere KI-Agenten mit Jev AI: Routing, Schutzmechanismen und menschliche Prüfung
Ein KI-Agent sollte nicht eine einzige Sprachmodellinstanz über alles entscheiden lassen. Erfahre, wie Jev AI Modell-Routing, Sicherheitsprüfungen vor Tool-Aufrufen, Risikobewertung und menschliche Prüfung unterstützt, während der Code die Ausführung kontrolliert.
Zuverlässigere KI-Agenten mit Jev AI entwickeln: Routing, Schutzmechanismen und menschliche Prüfung
Die schwierige Frage bei einem KI-Agenten lautet oft nicht: „Kann das Modell antworten?“, sondern ob der Agent im aktuellen Zustand handeln sollte. Ein Agent muss vielleicht ein Modell auswählen, ein Tool aufrufen, weitere Informationen anfordern, pausieren oder die Aufgabe an einen Menschen übergeben.
Wenn jede Entscheidung bei einem generativen LLM liegt, vermischen sich Planung, Ausführung und Sicherheitsprüfung. Das Modell kann eine plausible Erklärung liefern, ohne ein verlässliches Steuersignal zu geben. Dann ist schwer zu erkennen, ob ein Fehler auf Verständnis, Berechtigungen, ein Tool oder einen Schwellenwert zurückgeht.
Jev AI kann als eigenständige Entscheidungsebene für einen Agenten dienen: Es erhält den aktuellen State, beantwortet gezielte Choice-, Score- oder Noul-Fragen und gibt Wahrscheinlichkeits- und Konfidenzsignale an den Orchestrierungscode zurück. Der Agent führt aus, Jev beurteilt, und Regeln sowie Menschen bilden das Sicherheitsnetz.
Dieser Leitfaden stellt eine praktische Agent-Architektur für Modell-Routing, Schutzprüfungen vor Tool-Aufrufen, Risikobewertung, menschliche Prüfung und Evaluierung im Produktivbetrieb vor.
Grundprinzip: Lass nicht ein einziges Modell gleichzeitig Verständnis, Entscheidung, Berechtigung und Ausführung verantworten. Zerlege die Beurteilung in testbare Fragen und überlass die finale Aktion eingeschränktem Code.
Inhaltsverzeichnis
- Warum Agents eine Entscheidungsebene brauchen
- Wo Jev AI passt
- Muster 1: Das Modell vor dem Aufruf routen
- Muster 2: Tool-Aufrufe absichern
- Muster 3: Prüfungen anhand von Wahrscheinlichkeiten auslösen
- State und Fragen für Agents gestalten
- Sicherheits- und Evaluierungscheckliste
- Häufige Fragen
Warum Agents eine Entscheidungsebene brauchen
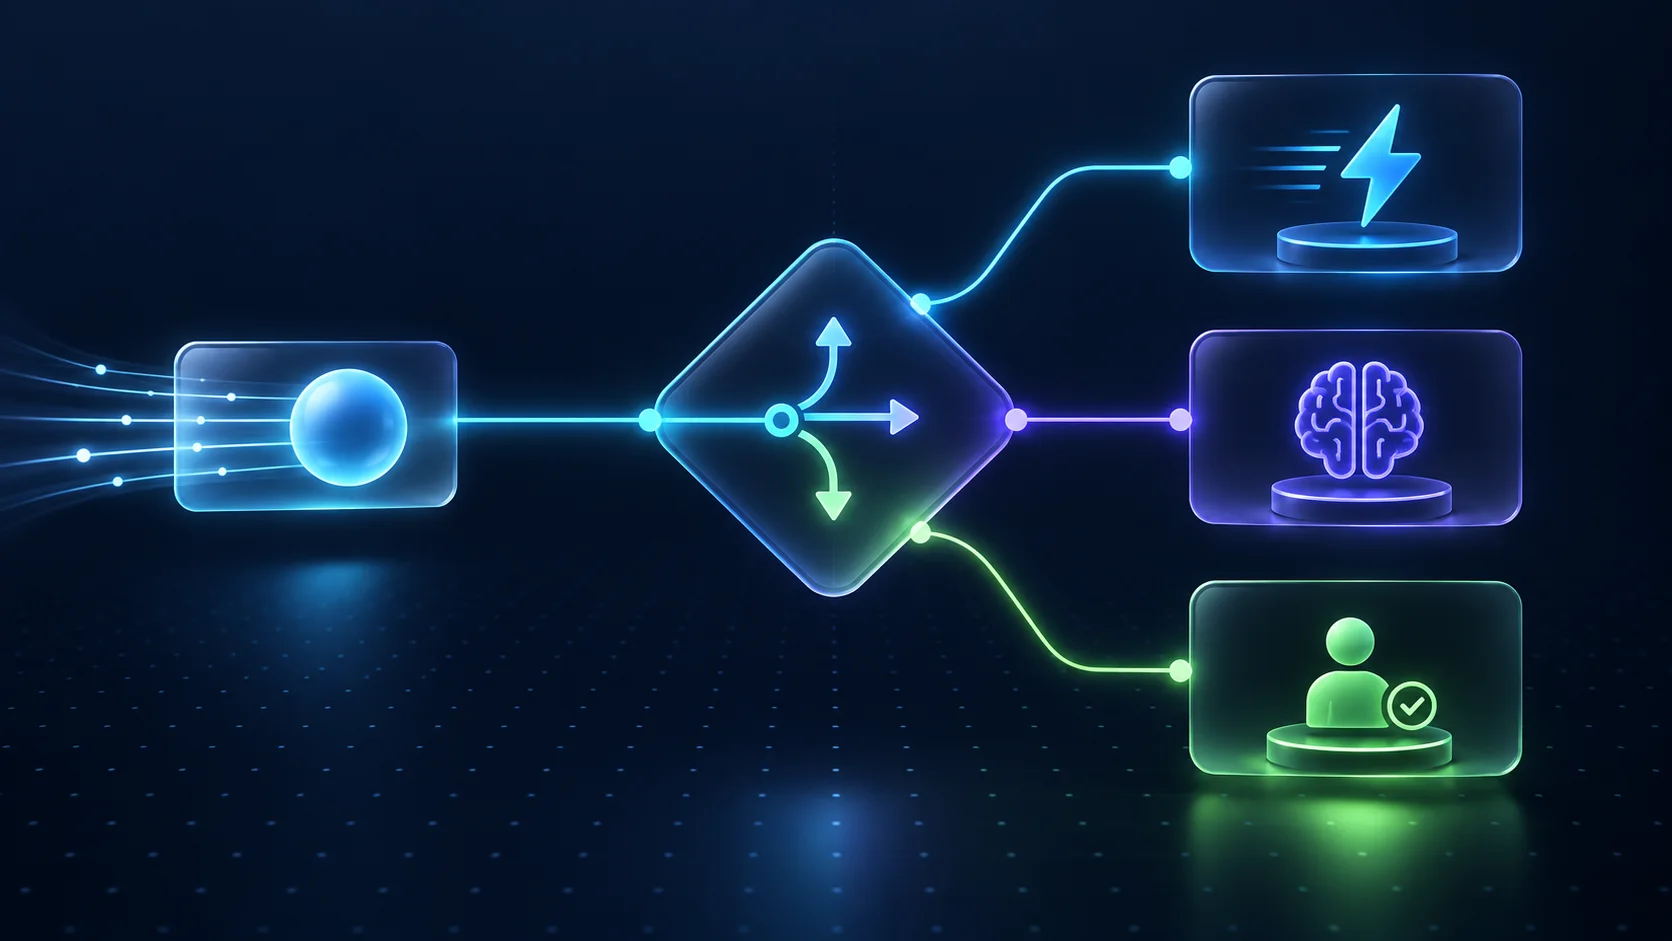
Bild: Wenn Beurteilung und Ausführung getrennt sind, lassen sich Routing, Schutzmechanismen und Prüfregeln leichter testen.
Generierter Text ist keine Berechtigung
Ein LLM kann den Satz „Ich werde diese Datei löschen“ erzeugen. Daraus darf jedoch keine Löschberechtigung entstehen. Die tatsächliche Aktion muss durch Anwendungscode, Berechtigungen und eine Prüfung der Tool-Parameter laufen.
Auch Jevs Ergebnis darf nicht als Berechtigung verstanden werden. Jev kann beurteilen, ob ein Nutzer ausdrücklich eine Löschung verlangt hat oder ob eine Anfrage riskant wirkt. Ob die Ausführung erlaubt ist, sollten trotzdem deterministische Regeln und Berechtigungssysteme entscheiden.
Agents treffen viele kleine Entscheidungen
Ein einzelner Agent-Durchlauf kann Folgendes erfordern:
- Aufgabentyp und Schwierigkeit klassifizieren.
- Ein schnelles oder ein leistungsfähigeres Modell auswählen.
- Entscheiden, ob ein externes Tool benötigt wird.
- Tool-Namen, Argumente und Zielressource validieren.
- Das Risiko bewerten und entscheiden, ob eine Bestätigung nötig ist.
- Fortfahren, wiederholen, auf einen einfacheren Ablauf ausweichen oder pausieren.
- Das Ergebnis protokollieren und den Kontext aktualisieren.
Nicht all diese Aufgaben benötigen ausführliches Schlussfolgern. Sie in atomare Fragen aufzuteilen, ist oft wartbarer, als den System-Prompt immer weiter auszubauen.
Wo Jev AI passt
Eine übersichtliche Schichtenarchitektur könnte so aussehen:
user request
     ↓
state builder  ──► permissions and hard rules
     ↓
Jev decision layer
     ├─ route model
     ├─ score risk
     ├─ check intent
     └─ request human review
     ↓
orchestrator
     ├─ call LLM
     ├─ call tool
     └─ ask user
     ↓
validator + audit log
Jev muss nicht die gesamte interne Implementierung des Agents kennen. Es benötigt nur den State und die Fragen, die für die aktuelle Beurteilung relevant sind. Modelle, Tools und Geschäftsrichtlinien können sich unabhängig voneinander weiterentwickeln.
Wenn State, Choice, Score und Noul neu für dich sind, beginne mit dem Jev-AI-API-Tutorial. Wie Jev und generative LLMs die Aufgaben aufteilen, erklärt Jev AI vs. LLMs.
Muster 1: Das Modell vor dem Aufruf routen
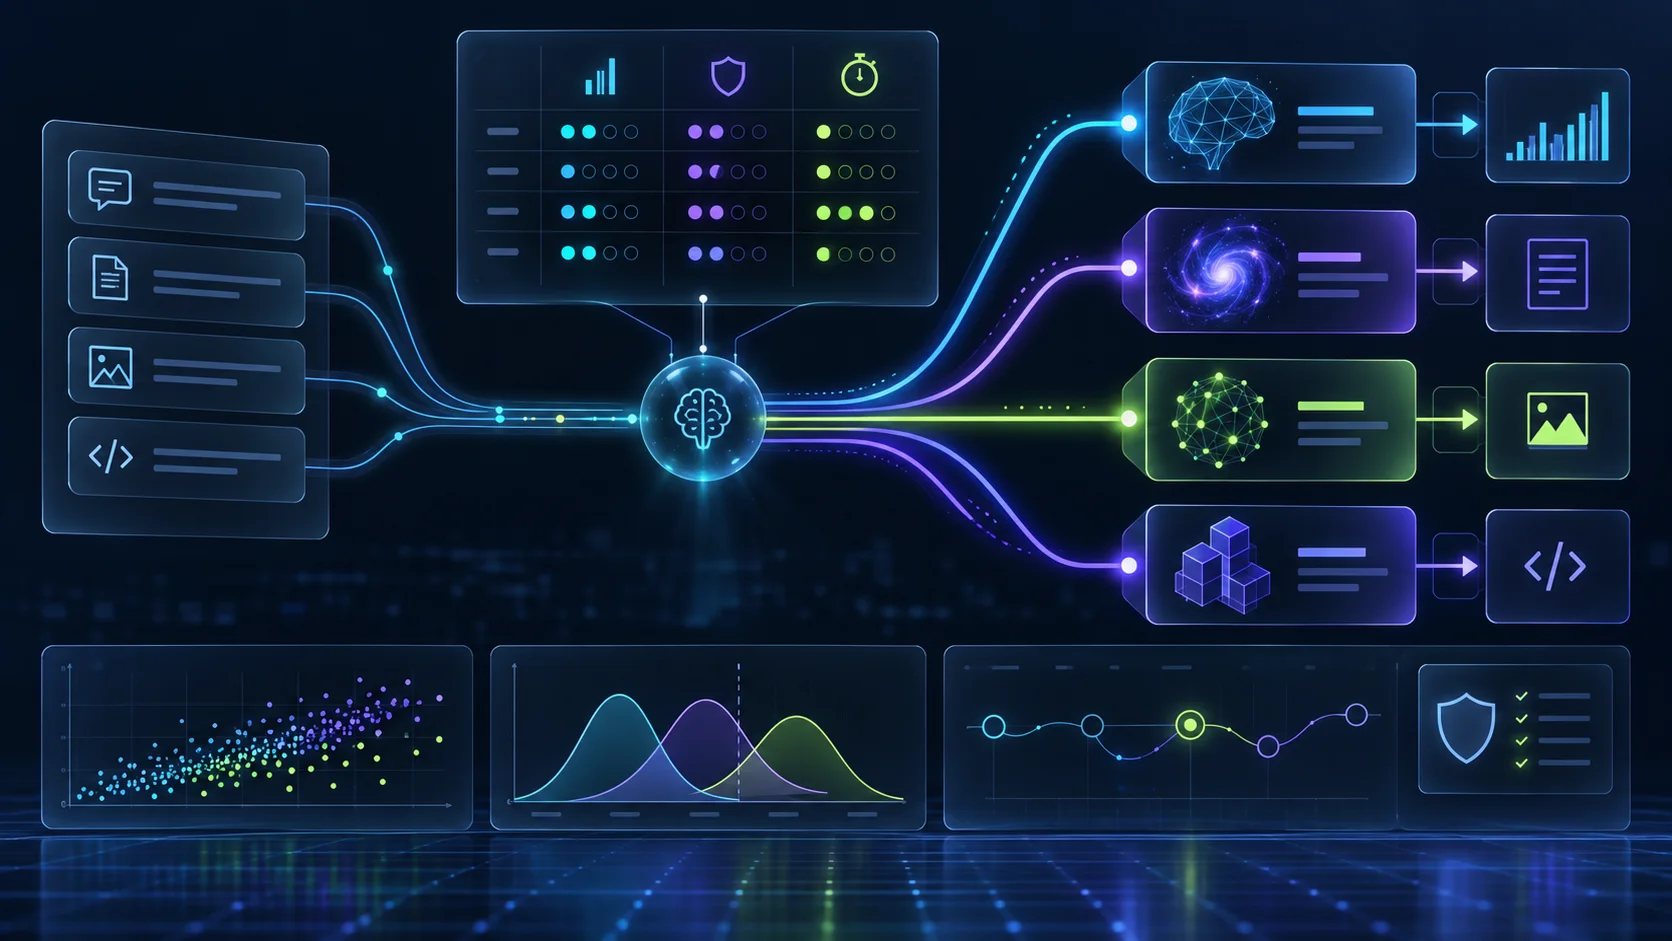
Ein Agent sollte nicht jede Anfrage an das teuerste und langsamste Modell senden. Jev kann gezielte Fragen beurteilen, zum Beispiel:
- Erfordert die Aufgabe komplexes Schlussfolgern?
- Ist ein Tool-Aufruf nötig?
- Geht es um sensible Daten oder eine Aktion mit großen Auswirkungen?
- Reicht eine kurze Antwort aus?
Eine praktische Routing-Strategie
decision = jev.system_one(
    state={
        "request": user_message,
        "conversation_summary": summary,
        "available_tools": tool_catalog,
    },
    questions={
        "difficulty": Score(rubric=["simple", "moderate", "complex"]),
        "needs_tool": Noul("Does this request require a tool call?"),
        "sensitive": Noul("Does this request involve sensitive data or action?"),
    },
)
Der Orchestrator kann einfache Aufgaben an ein schnelles Modell, komplexe Aufgaben an ein leistungsfähigeres Modell und sensible Aufgaben an einen Schutzablauf weiterleiten. Jev schlägt einen Weg vor, erteilt aber keine finale Berechtigung.
Häufige Routing-Fehler vermeiden
- Lass nicht einen einzigen Score jede Modellauswahl bestimmen.
- Betrachte einen Wahrscheinlichkeitsschwellenwert nicht als Sicherheitsnachweis.
- Füge nicht ungeprüft den vollständigen Tool-Katalog in jeden State ein.
- Überspringe die Berechtigungsprüfung nicht, nur weil eine Einschätzung hohe Konfidenz hat.
Muster 2: Tool-Aufrufe absichern
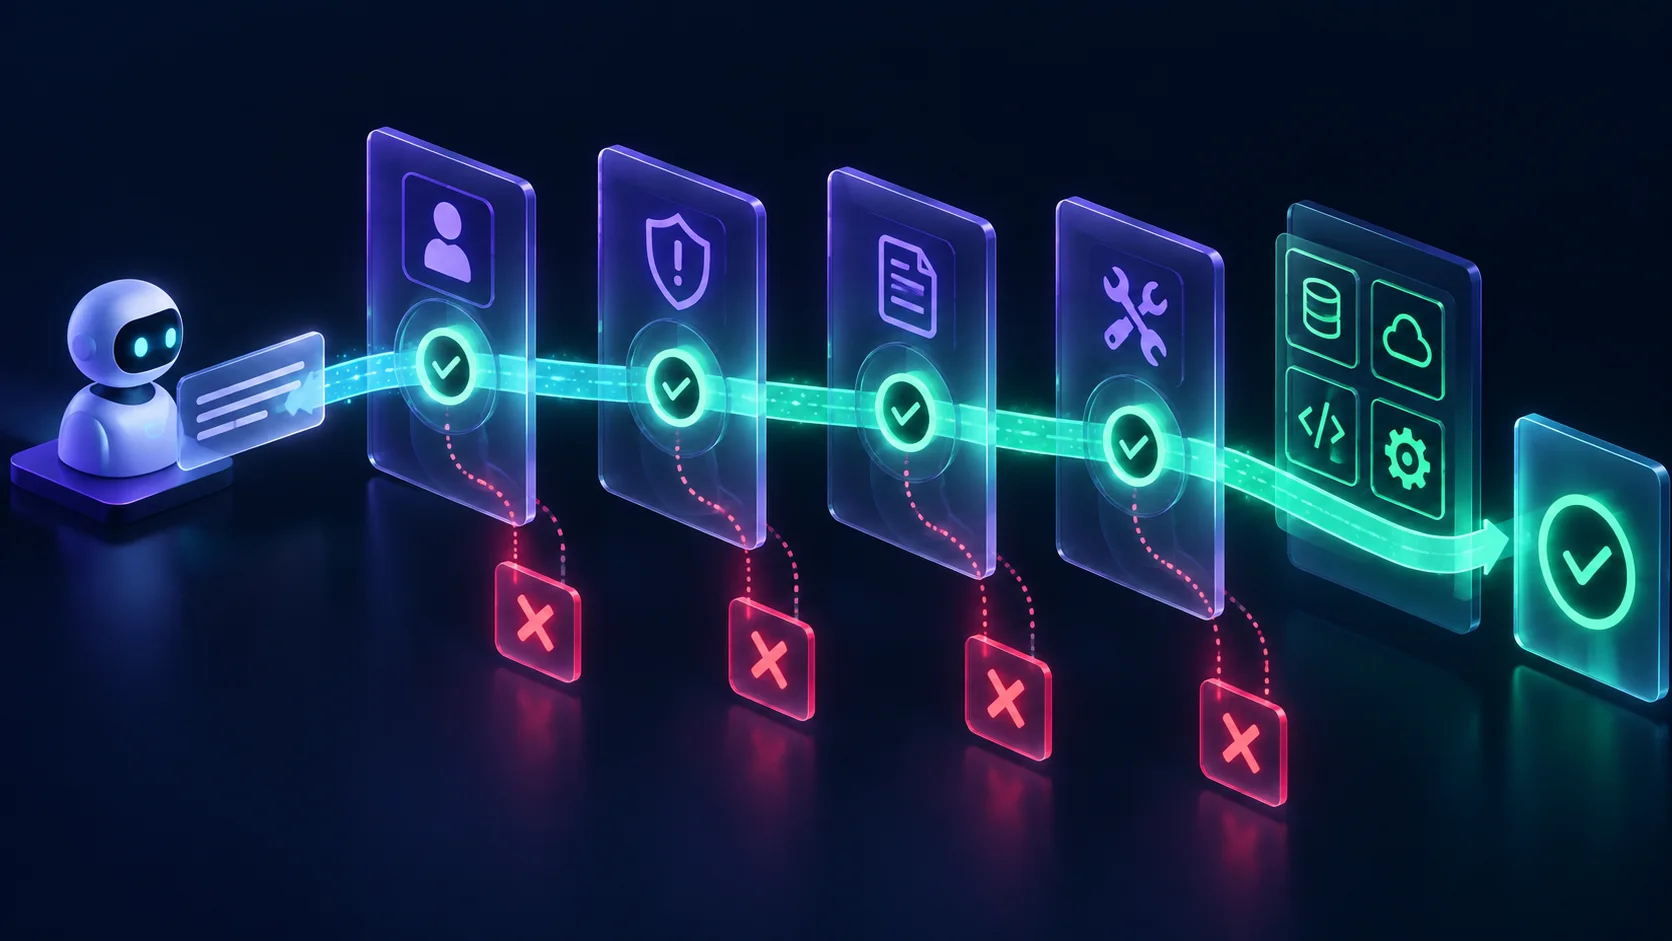
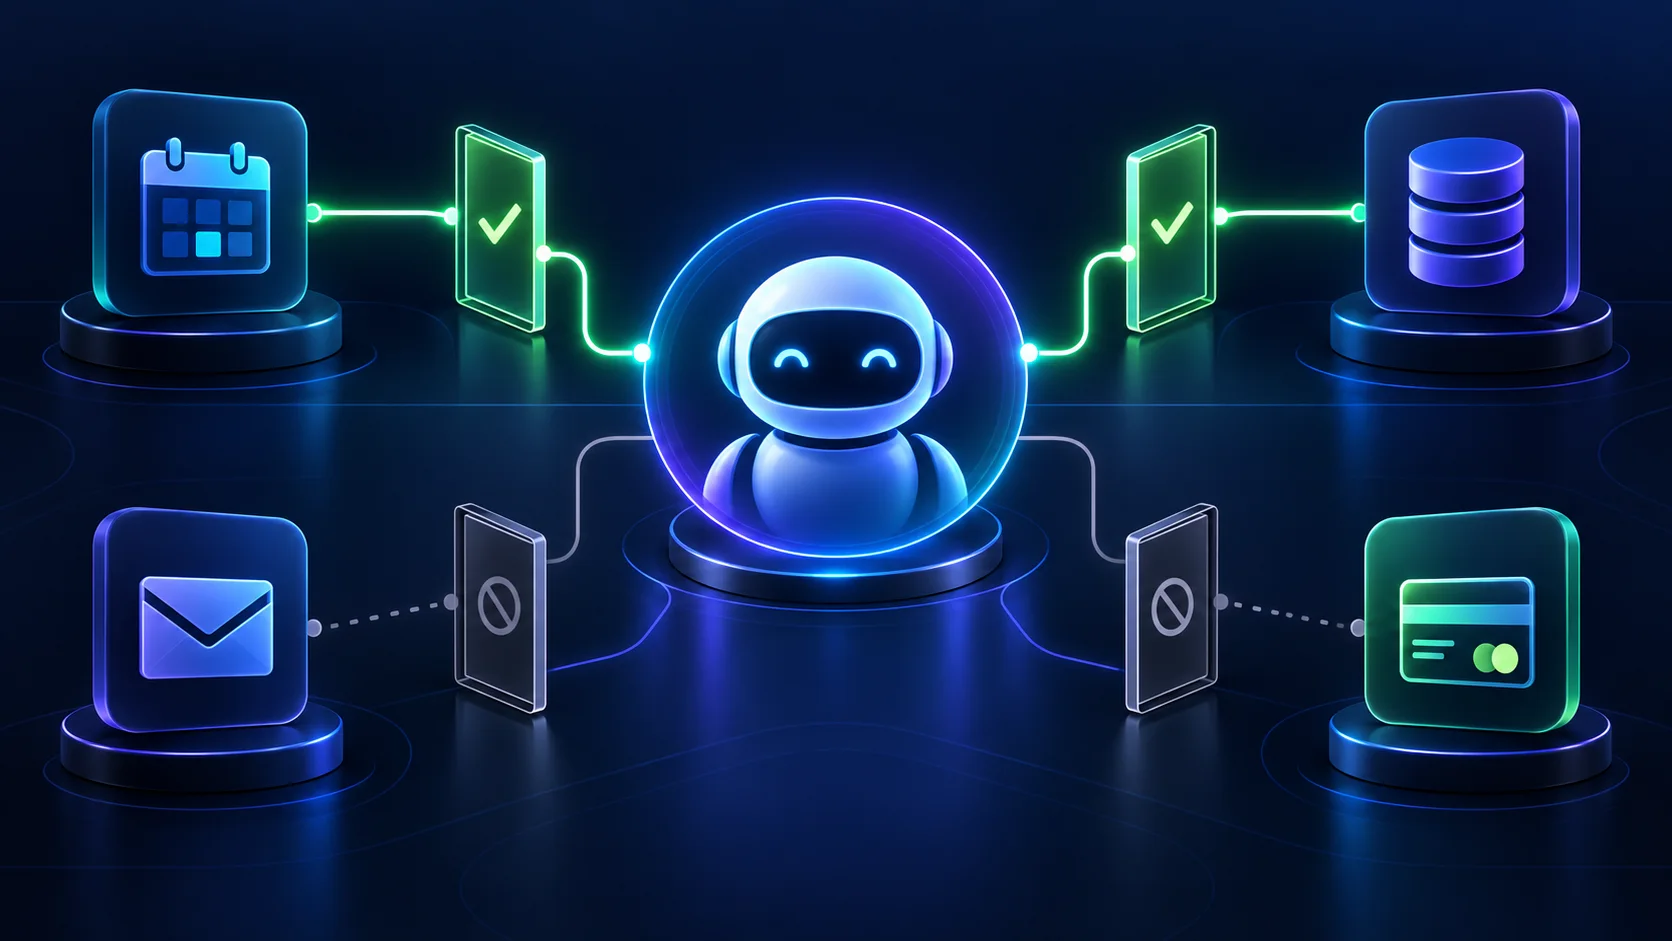
Bild: Vor der Ausführung sollte ein Tool-Aufruf Absichtsprüfung, Parameter-Validierung, Berechtigungen und Risikokontrollen durchlaufen.
Bei einem Agenten besteht der wichtigste Schutzmechanismus oft nicht darin, „alle gefährlichen Inhalte abzulehnen“. Entscheidend ist, dass eine Aktion mit Nebenwirkungen über genügend Kontext, gültige Parameter und eine ausdrückliche Bestätigung verfügt.
Vier Schutzebenen
Ebene 1: Harte Regeln
Prüfe zuerst Nutzer, Rolle, Eigentümerschaft der Ressource, Betragsgrenzen, freigegebene Tools und Parametertypen. Wird eine harte Regel verletzt, rufe weder Jev noch ein LLM auf. Lehne die Aktion ab oder leite sie an einen Menschen weiter.
Ebene 2: Absicht beurteilen
Nutze Noul, um zu beurteilen, ob der Nutzer die Aktion ausdrücklich verlangt hat. „Hat der Nutzer ausdrücklich darum gebeten, dieses Projekt zu löschen?“ ist etwas anderes als „Hat der Nutzer gefragt, wie das Löschen funktioniert?“
Ebene 3: Risiko bewerten
Verwende Score für potenzielle Auswirkungen, Umkehrbarkeit, Sensibilität und externe Sichtbarkeit. Zahlungen, Berechtigungsänderungen, Massenlöschungen und externe Nachrichten sollten strengere Prüfschwellen haben.
Ebene 4: Bestätigung und Audit
Bei Aktionen mit hohem Risiko sollten Ziel, Parameter und Folgen angezeigt, eine ausdrückliche Bestätigung angefordert und Entscheidung, Version, handelnde Person sowie Tool-Ergebnis protokolliert werden. Validiere Parameter nach der Bestätigung erneut. Eine frühere Bestätigung ist keine dauerhafte Berechtigung.
Muster 3: Prüfungen anhand von Wahrscheinlichkeiten auslösen
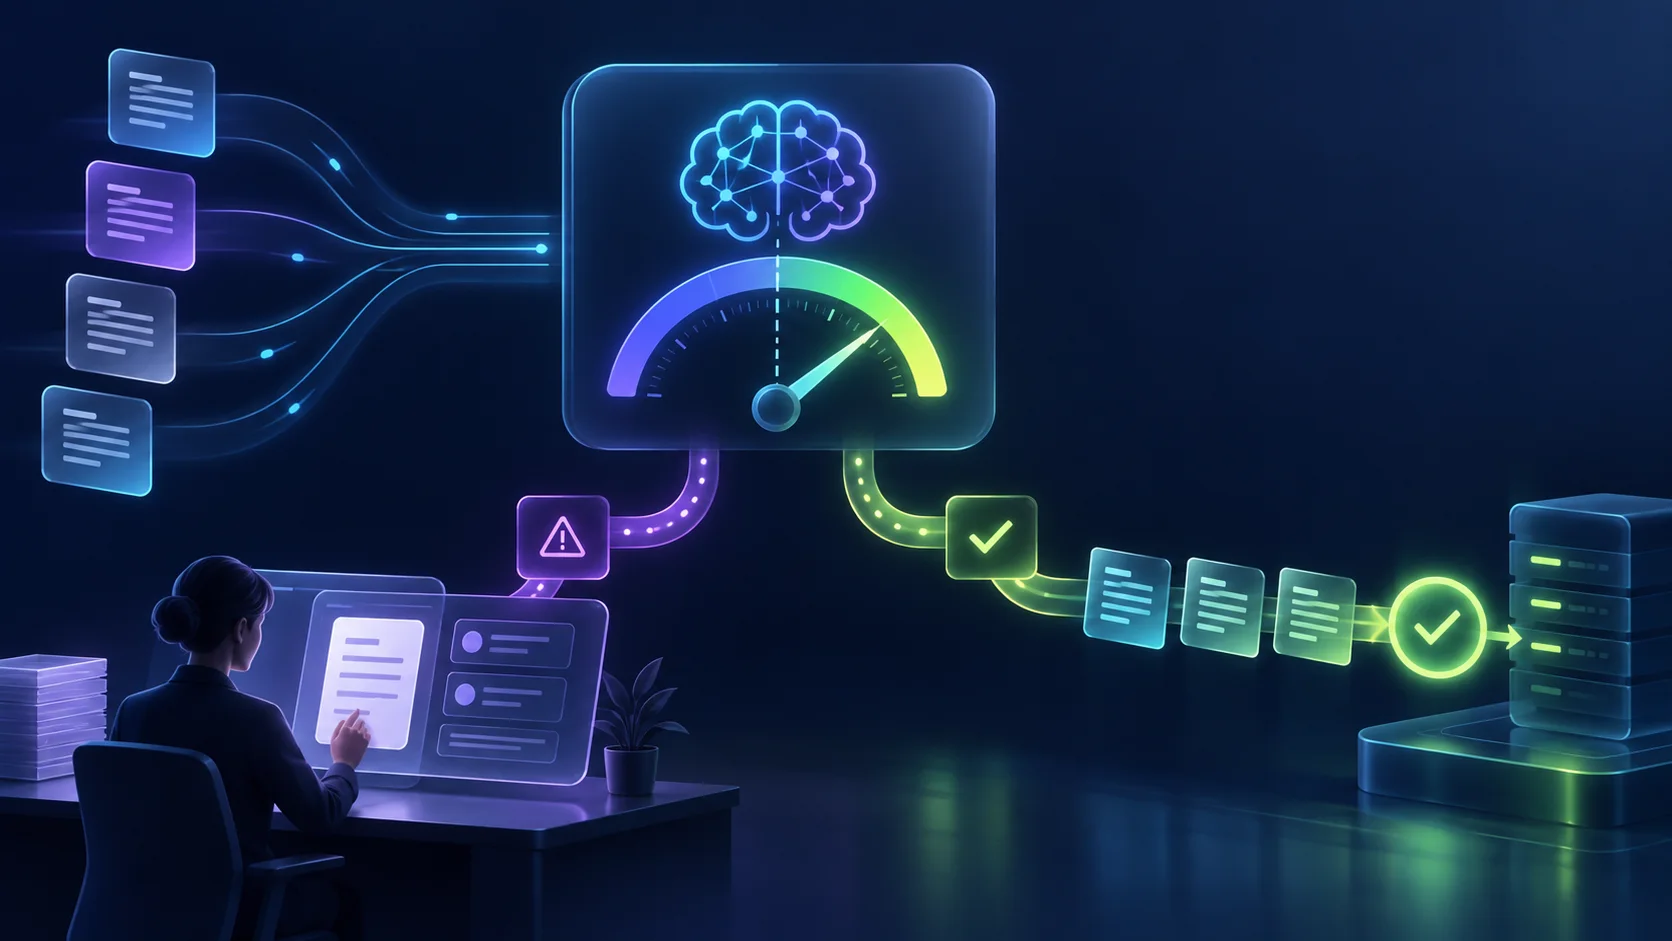
Jevs Wahrscheinlichkeit und Konfidenz sind vor allem nützlich, um den Automatisierungsgrad zu wählen – nicht um menschliches Urteil zu ersetzen. Ein System kann drei Wege vorsehen:
| Ergebnis | Behandlung |
|---|---|
| Hohe Konfidenz, geringes Risiko | Automatisch fortfahren und Ergebnis protokollieren |
| Nahe am Schwellenwert oder fehlender Kontext | Weitere Informationen anfordern oder zur Prüfung vorlegen |
| Hohes Risiko oder geringe Konfidenz | Agent pausieren und an einen Menschen weiterleiten |
Lege Schwellenwerte pro Aktion fest, nicht global pro Modell. Für eine automatische Ticket-Klassifizierung kann ein niedrigerer Wert ausreichen; Rückerstattungen, Löschungen, Berechtigungsänderungen und externe Nachrichten erfordern höhere Schwellenwerte und eine ausdrückliche Bestätigung.
Was sollte eine prüfende Person sehen?
Eine hilfreiche Prüfoberfläche sollte Folgendes anzeigen:
- den ursprünglichen State oder eine redigierte Zusammenfassung;
- die geplante Aktion des Agents und die Tool-Parameter;
- Jevs Fragen, Optionen, Wahrscheinlichkeiten und Konfidenz;
- Ergebnisse der Prüfung harter Regeln und Berechtigungen;
- Möglichkeiten zum Genehmigen, Ablehnen, Bearbeiten oder Anfordern weiterer Informationen.
Zeige nicht nur „KI-Empfehlung: genehmigen“. Prüfende benötigen die Fakten und Grenzen, auf denen die Einschätzung beruht.
State und Fragen für Agents gestalten
Nur entscheidungsrelevante Fakten in den State aufnehmen
Der längere Verlauf eines Agents kann viele Informationen enthalten, aber eine Jev-Frage braucht selten alles davon. Extrahiere in Code eine Aufgabenübersicht, das aktuelle Tool, Ressourcendetails, Nutzerberechtigungen und das letzte Ergebnis. Baue daraus einen möglichst kleinen State.
Ein kleiner State senkt Kosten, begrenzt die Offenlegung sensibler Daten und macht die Beurteilung leichter reproduzierbar.
Eine Frage, eine Beurteilung
Schreibe keine überladene Sammelfrage wie:
„Ist das sicher, braucht es eine Bestätigung, welches Modell sollen wir verwenden und sind die Parameter gültig?“
Teile sie stattdessen in Fragen auf, zum Beispiel:
intent_explicit: Hat der Nutzer ausdrücklich um diese Aktion gebeten?parameter_valid: Entsprechen die Argumente dem Tool-Vertrag?risk_level: Wie hoch ist das Risiko der Aktion?needs_human: Ist jetzt eine menschliche Prüfung erforderlich?
Der Code kann jedes Ergebnis unabhängig behandeln, und für jede Frage lassen sich eigene Gegenbeispiele hinterlegen.
Entscheidungen versionieren
Protokolliere die Fragendefinitionen, Optionsbeschreibungen, Bewertungsrubrik, Modellversion und Schwellenwertversion. Fehlen diese Angaben, kann das Team nach einer Richtlinienänderung nicht erklären, warum eine frühere Aktion zugelassen oder blockiert wurde.
Sicherheits- und Evaluierungscheckliste
Prüfe vor dem Produktivstart:
- Der Agent kann harte Regeln nicht umgehen, um ein Tool mit großen Auswirkungen aufzurufen.
- Jedes Tool mit Nebenwirkungen besitzt eine Freigabeliste, Parameter-Validierung und Berechtigungsprüfung.
- Jevs Wahrscheinlichkeiten sind Signale; kritische Aktionen haben weiterhin einen deterministischen oder menschlichen Fallback.
- Prüfabläufe verlieren Aufgaben nicht aufgrund eines Timeouts oder Dienstausfalls.
- Jede Aktion ist mit Eingabe, Fragen, Modell, Schwellenwerten und handelnder Person verknüpft.
- Tests umfassen normale, mehrdeutige, nicht autorisierte, durch Prompt-Injection beeinflusste und irreführende Eingaben.
- Chinesisch, Englisch, Fachbegriffe und fehlender Kontext werden abgedeckt.
- Routing- und Schutzfragen lassen sich ändern, ohne den gesamten Agenten neu zu schreiben.
- Fallbacks sind ausdrücklich festgelegt: pausieren, Bestätigung anfordern, übergeben oder eine statische Regel anwenden.
- Beispiele aus der Jev-AI-Showcase-Galerie dienen als Inspiration, nicht als Sicherheitsnachweis.
Jev unterstützt derzeit Text, JSON-Objekte und Textarrays als Eingaben. Bilder, Audio und Video sind keine direkten Eingaben. Nicht-englische und fachspezifische Daten solltest du mit eigenen Beispielen evaluieren, statt sie allein aufgrund der Produktpositionierung als abgedeckt anzusehen.
Häufige Fragen
Kann Jev garantieren, dass ein Agent keine Fehler macht?
Nein. Jev liefert Wahrscheinlichkeits- und Konfidenzsignale, aber keine Garantie für geschäftliche Genauigkeit oder Sicherheit. Zuverlässige Agents benötigen weiterhin Berechtigungen, harte Regeln, Parameter-Validierung, menschliche Prüfung und Audit-Protokolle.
Warum nicht das LLM entscheiden lassen, ob etwas sicher ist?
Ein LLM kann beim Verständnis und bei Erklärungen helfen, sollte aber nicht allein für die finale Berechtigung zuständig sein. Werden einzelne Beurteilungen getrennt, lassen sich Schwellenwerte, Gegenbeispiele und Fehlerpfade unabhängig voneinander testen.
Kann hohe Konfidenz die menschliche Bestätigung ersetzen?
Bei Aktionen mit geringem Risiko möglicherweise. Bei Aktionen mit großen Auswirkungen reicht Konfidenz allein nicht aus. Zahlungen, Löschungen, Berechtigungsänderungen und externe Kommunikation sollten Modellsignale mit Regeln, Berechtigungsprüfung und ausdrücklicher Bestätigung kombinieren.
Eignet sich Jev für jeden Agenten?
Nicht unbedingt. Wenn ein Agent hauptsächlich Texte schreibt und Gespräche führt, bleibt ein LLM zentral. Benötigt er häufig Routing, Tool-Auswahl, Risikobewertung und Eskalation, ist Jev ein geeigneter Kandidat für die Entscheidungsebene.
Wie sollte ich anfangen?
Teste eine risikoarme Einschätzung in der Jev-AI-Spielwiese und folge anschließend dem API-Tutorial für die serverseitige Integration. Wenn der Grundablauf funktioniert, ergänze Routing und Schutzmechanismen im Orchestrator.
Fazit: Aktionen von Agents nachvollziehbar machen
Zuverlässige Agents benötigen nicht mehr Berechtigungen, sondern klarere Grenzen. Jev AI kann die bislang verborgenen Entscheidungen rund um Routing, Tool-Nutzung, Eskalation und Fortsetzung explizit machen, während Code und Menschen die finale Aktion kontrollieren.
Beginne mit einem risikoarmen Tool, protokolliere jede Beurteilung und finale Aktion und verbessere Fragen sowie Schwellenwerte anhand realer Fehler. So wird Jev AI zu einer stabilen Entscheidungsebene statt zu einem weiteren schwer überprüfbaren Prompt.
Recherche-Stand: 2026-09-20
Primärquellen: Jev-AI-Startseite, Jev-AI-Dokumentation, Jev-AI-Showcase, Einführung von TypeSafe