Modellvergleiche
Jev AI vs. LLMs: Wann sollten Sie ein Entscheidungsmodell statt eines Chatmodells verwenden?
Jev AI und große Sprachmodelle sind keine einfachen Ersatzprodukte. Vergleichen Sie Ausgabeformat, Latenz, Unsicherheit, Entwicklungsaufwand und Sicherheitsgrenzen, um zu entscheiden, wann ein Entscheidungsmodell besser passt.
Jev AI vs. LLMs: Wann sollten Sie ein Entscheidungsmodell statt eines Chatmodells verwenden?
Wenn Teams Jev AI kennenlernen, stellen sie oft eine praktische Frage: Worin unterscheidet sich Jev von ChatGPT, Claude oder einem anderen großen Sprachmodell? Wenn ein LLM bereits JSON zurückgeben kann, warum sollte man dann ein eigenes Entscheidungsmodell ergänzen?
Die Antwort lautet nicht: „Jev AI ist immer besser.“ Die Systeme sind für unterschiedliche Aufgaben optimiert. LLMs sind stark bei offenen Texten, Erklärungen und komplexem Schlussfolgern. Jev AI wurde dafür entwickelt, einen State innerhalb eines definierten Antwortbereichs in eine Auswahl, Bewertung oder Ja/Nein-Beurteilung umzuwandeln und das Ergebnis anschließend an den Anwendungscode zurückzugeben.
Dieser Leitfaden vergleicht Jev AI und generative LLMs aus technischer Sicht, bietet einen praktischen Entscheidungsrahmen und erklärt, wie beide in einem Agenten oder SaaS-Workflow zusammenarbeiten können.
Kurzantwort: Wenn Sie den Antwortbereich im Voraus festlegen können und das Ergebnis vom Code wiederverwendet, sortiert, weitergeleitet oder blockiert werden soll, sollten Sie zuerst Jev AI prüfen. Erfordert die Aufgabe Schreiben, Erklärungen, Kreativität oder offene Schlussfolgerungen, bleiben Sie bei einem generativen LLM.
Inhaltsverzeichnis
- Der grundlegende Unterschied
- Fünf Vergleichsdimensionen
- Wann Jev AI vorzuziehen ist
- Wann ein LLM weiterhin die richtige Wahl ist
- Wie Jev AI und LLMs zusammenarbeiten können
- Eine Evaluation planen
- Häufig gestellte Fragen
Der grundlegende Unterschied
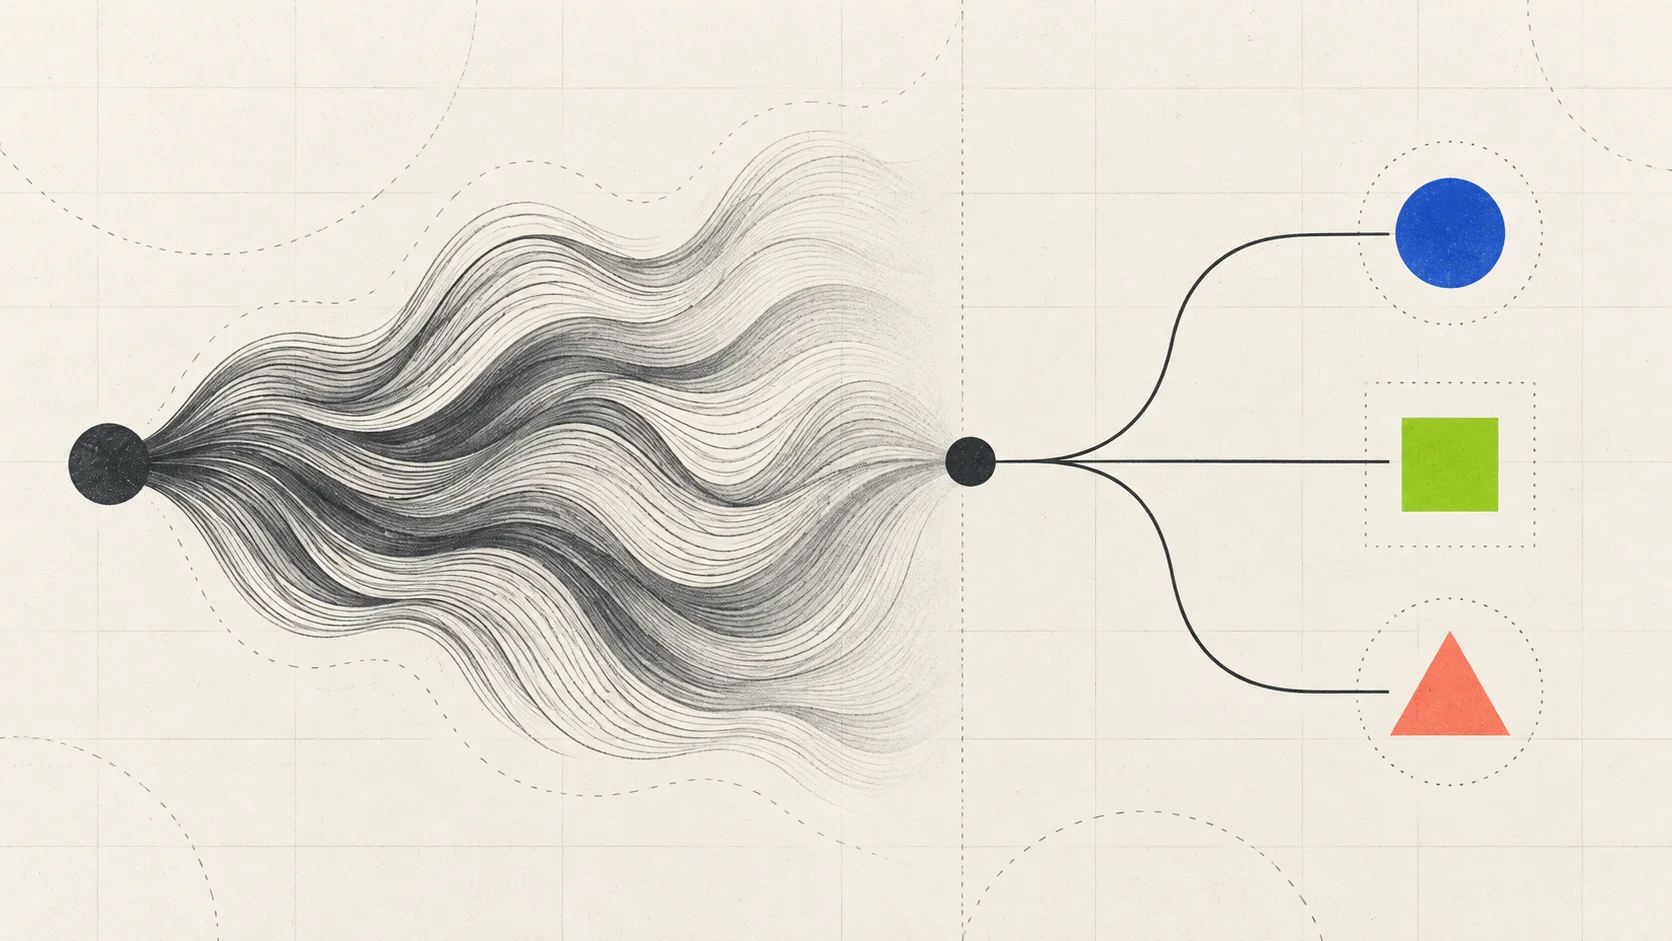
Bild: Ein LLM erzeugt vor allem Inhalte für Menschen, während Jev AI hauptsächlich Entscheidungen für Software zurückgibt.
Ein LLM generiert; Jev ist eine Entscheidungsebene
Generative LLMs erzeugen anhand des Kontexts das nächste Token. Sie können E-Mails schreiben, Code erklären, Berichte zusammenfassen oder durch Prompting JSON erzeugen. Doch auch dieses JSON ist das Ergebnis der Textgenerierung. Die Anwendung muss Felder validieren, fehlende Werte behandeln und Formatabweichungen berücksichtigen.
Jev AI beginnt mit dem Fragetyp. Sie legen fest, ob die Anwendung ein Choice-, Score- oder Noul-Urteil benötigt, und übermitteln anschließend den State. Die Antwort ist nach Auswahlmöglichkeiten, Bewertungen, Ja/Nein-Urteilen, Wahrscheinlichkeiten und Konfidenz organisiert. Jev ist nicht einfach ein kleineres Chatmodell, sondern behandelt Softwareurteile als eigene Schnittstelle.
Muss das Ergebnis an den Code zurückgegeben werden?
Wenn eine Person die Ausgabe liest und selbst über das weitere Vorgehen entscheidet, ist Text oft passend. Soll die Ausgabe dagegen in eine if-Anweisung, Warteschlange, einen Router, eine Berechtigungsprüfung oder einen Tool-Aufruf einfließen, ist ein stabiles Entscheidungsformat wichtiger.
Das ist der Kerngedanke der Jev-AI-Einführung: Jev trifft das Urteil, während der Anwendungscode die Aktion ausführt.
Fünf Vergleichsdimensionen
| Dimension | Jev AI | Generatives LLM |
|---|---|---|
| Hauptausgabe | Choice, Score, Noul, Wahrscheinlichkeiten und Konfidenz | Text, Code, Erklärungen oder offene strukturierte Inhalte |
| Antwortbereich | Vom Entwickler festgelegt | Meist offen und vom Prompt abhängig |
| Geeigneter Kontrollfluss | Klassifizierung, Weiterleitung, Rangfolge, Blockierung, Eskalation | Generierung, Zusammenfassung, Erklärung, Planung, Erstellung |
| Unsicherheit | Explizite Wahrscheinlichkeits- und Konfidenzsignale | Erfordert meist zusätzliche Validierung oder ein zweites Urteil |
| Rolle im System | Entscheidungsknoten in der Geschäftslogik | Inhalts- oder Schlussfolgerungszentrum |
1. Muss die Ausgabe ausführbar sein?
Supportweiterleitung, Modellauswahl, Risikoeskalation und Prüfungen vor Tool-Aufrufen verlangen keine schöne Prosa. Sie benötigen ein Ergebnis, das einem Programm den richtigen Pfad nennt. Für jede Anfrage natürliche Sprache zu parsen, erhöht mit wachsendem Datenverkehr den Aufwand.
Jev AI wurde dafür entwickelt, diese Ebene eng an die Anwendungseingaben zu koppeln. Auch ein LLM kann Function Calling und JSON Schema verwenden; das Team muss aber weiterhin Ausgaben validieren, Wiederholungsversuche, zusätzlichen Text und Modellversionsänderungen behandeln.
2. Kann der Antwortbereich im Voraus festgelegt werden?
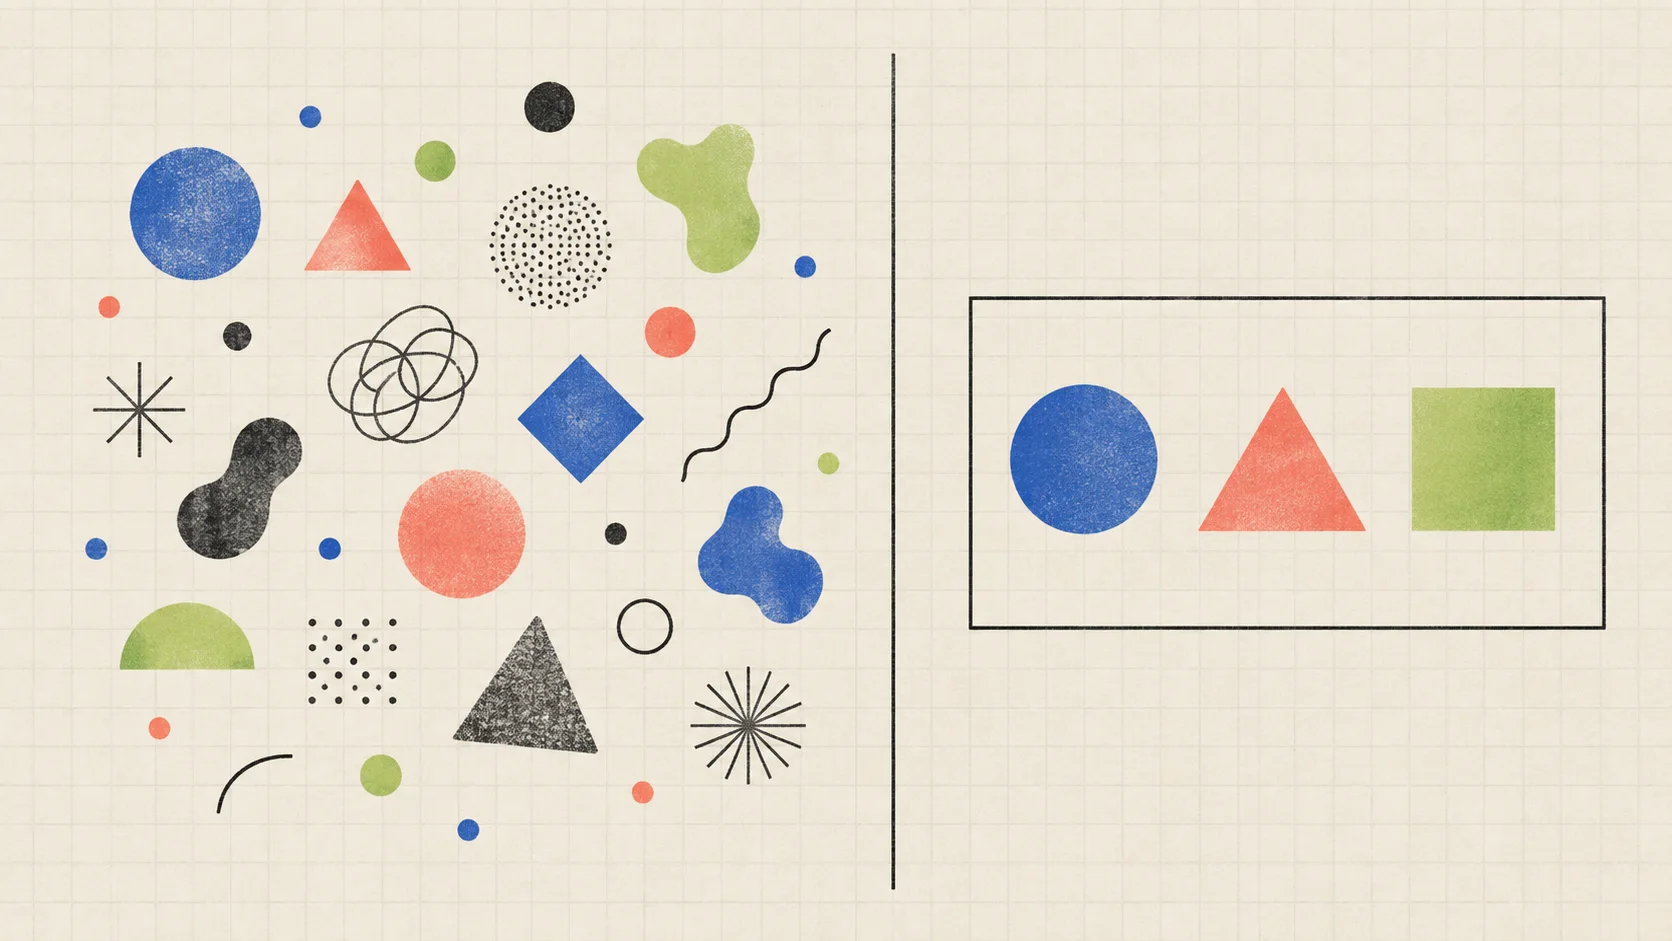
Bild: Je klarer der Antwortbereich ist, desto nützlicher wird eine dedizierte Entscheidungsschnittstelle.
Wenn die Antwort „Abrechnung, Technik oder Sonstiges“ oder eine Schweregradstufe von 0 bis 3 lautet, definieren Sie diese Grenze explizit. Choice und Score sind für diese Art von Aufgabe gemacht.
Wenn sich die Antwort nicht im Voraus festlegen lässt, etwa bei „Schreibe eine überzeugende Produkteinführung“, ist offene Generierung die bessere Wahl. Erzwingen Sie keine kreative Aufgabe in eine Liste von Kategorien, nur um Jev zu verwenden.
3. Soll Unsicherheit die Automatisierung steuern?
Viele Systeme benötigen mehr als Ja oder Nein. Sie müssen wissen, ob ein Ergebnis sicher genug für eine Automatisierung ist. Ein Ticket mit geringem Risiko und hoher Wahrscheinlichkeit kann automatisch weitergeleitet werden, während eine grenzwertige Zahlungsanfrage an einen Menschen gehen sollte.
Wahrscheinlichkeiten und Konfidenz von Jev können als Signale für den Kontrollfluss dienen, garantieren aber keine geschäftliche Genauigkeit. Produktivsysteme benötigen weiterhin Schwellenwerte, Gegenbeispiele, menschliche Stichprobenkontrollen und Audit-Richtlinien.
4. Benötigen Sie mehrere Urteile zum selben State?
Eine Supportanfrage kann eine Abteilung, Dringlichkeit, Rückerstattungsabsicht und Eskalationsentscheidung benötigen. Die Jev-Schnittstelle ermöglicht es, mehrere typisierte Fragen anhand desselben State zu bewerten und Antworten nach Fragen-ID zurückzugeben.
Auch ein LLM kann mehrere Felder in einer JSON-Antwort liefern. Haben die Urteile jedoch unterschiedliche Risikoprofile und Evaluationskriterien, lässt sich das System durch ihre Trennung oft leichter überwachen und optimieren.
5. Benötigt die Entscheidungsebene geringe Latenz und Kombinierbarkeit?
Die Jev-AI-Startseite nennt eine Antwortzeitspanne von 70–500 ms. Das kann bei kleinen Entscheidungen in einem häufig ausgeführten Workflow nützlich sein, ist aber nicht Ihr SLA. Die tatsächliche Latenz hängt von Netzwerk, Anfragegröße, Parallelität und Dienstbedingungen ab.
Die Latenz eines LLM wird oft von Kontextlänge und Zahl der generierten Tokens beeinflusst. Bei einer langen Antwort kann der Mehrwert des LLMs einige hundert Millisekunden aufwiegen. Für eine Weiterleitungsschicht, die pro Sekunde viele kleine Entscheidungen trifft, lohnt sich die Evaluation eines eigenen Entscheidungsmodells.
Wann Jev AI vorzuziehen ist
Je mehr der folgenden Bedingungen zutreffen, desto eher sollten Sie Jev AI testen:
Die Ausgabe stammt aus einer endlichen Auswahl
Sie können mögliche Antworten in Produktanforderungen oder Code aufzählen und die Bedeutung jeder Option festlegen. Das passt meist zu Choice.
Die Frage verlangt ein einzelnes, klares Urteil
Beispiele: „Fordert diese Nachricht ausdrücklich eine Rückerstattung?“ und „Welche Schweregradstufe trifft zu?“ Atomare Fragen lassen sich einfacher testen und erneut ausführen.
Das Ergebnis steuert Code
Das Ergebnis beeinflusst eine Warteschlange, Berechtigung, Modellauswahl, einen Tool-Aufruf, ein Datenbankfeld oder eine Eskalation an Menschen, statt nur einer lesenden Person angezeigt zu werden.
Das System benötigt eine unsicherheitsbewusste Automatisierung
Sie möchten, dass Ergebnisse mit hoher Konfidenz automatisch weiterlaufen, grenzwertige Ergebnisse geprüft werden und Ergebnisse mit niedriger Konfidenz weitere Informationen anfordern. Hier sind die Wahrscheinlichkeitssignale von Jev nützlich.
Geschäftsrichtlinien sollen in Ihrer Anwendung bleiben
Ihr Team kontrolliert Schwellenwerte, Gewichtungen, Prüfregeln und endgültige Aktionen. Jev fällt ein Urteil, ohne die gesamte Richtlinie in einem langen Prompt zu verbergen.
Wann ein LLM weiterhin die richtige Wahl ist
Verwenden Sie weiterhin ein generatives Modell für Aufgaben wie:
- Marketingtexte, E-Mails, Produkterklärungen oder Code erstellen;
- lange Dokumente zusammenfassen und Belege erläutern;
- offene Recherchen mit mehreren möglichen Antworten durchführen;
- über ein Problem nachdenken, dessen Antwortbereich sich nicht aufzählen lässt;
- Gespräche führen und Inhalte anhand von Feedback umformulieren.
In solchen Workflows kann Jev die Arbeit des LLMs vor oder nach der Generierung klassifizieren, bewerten, freigeben oder prüfen.
Wie Jev AI und LLMs zusammenarbeiten können
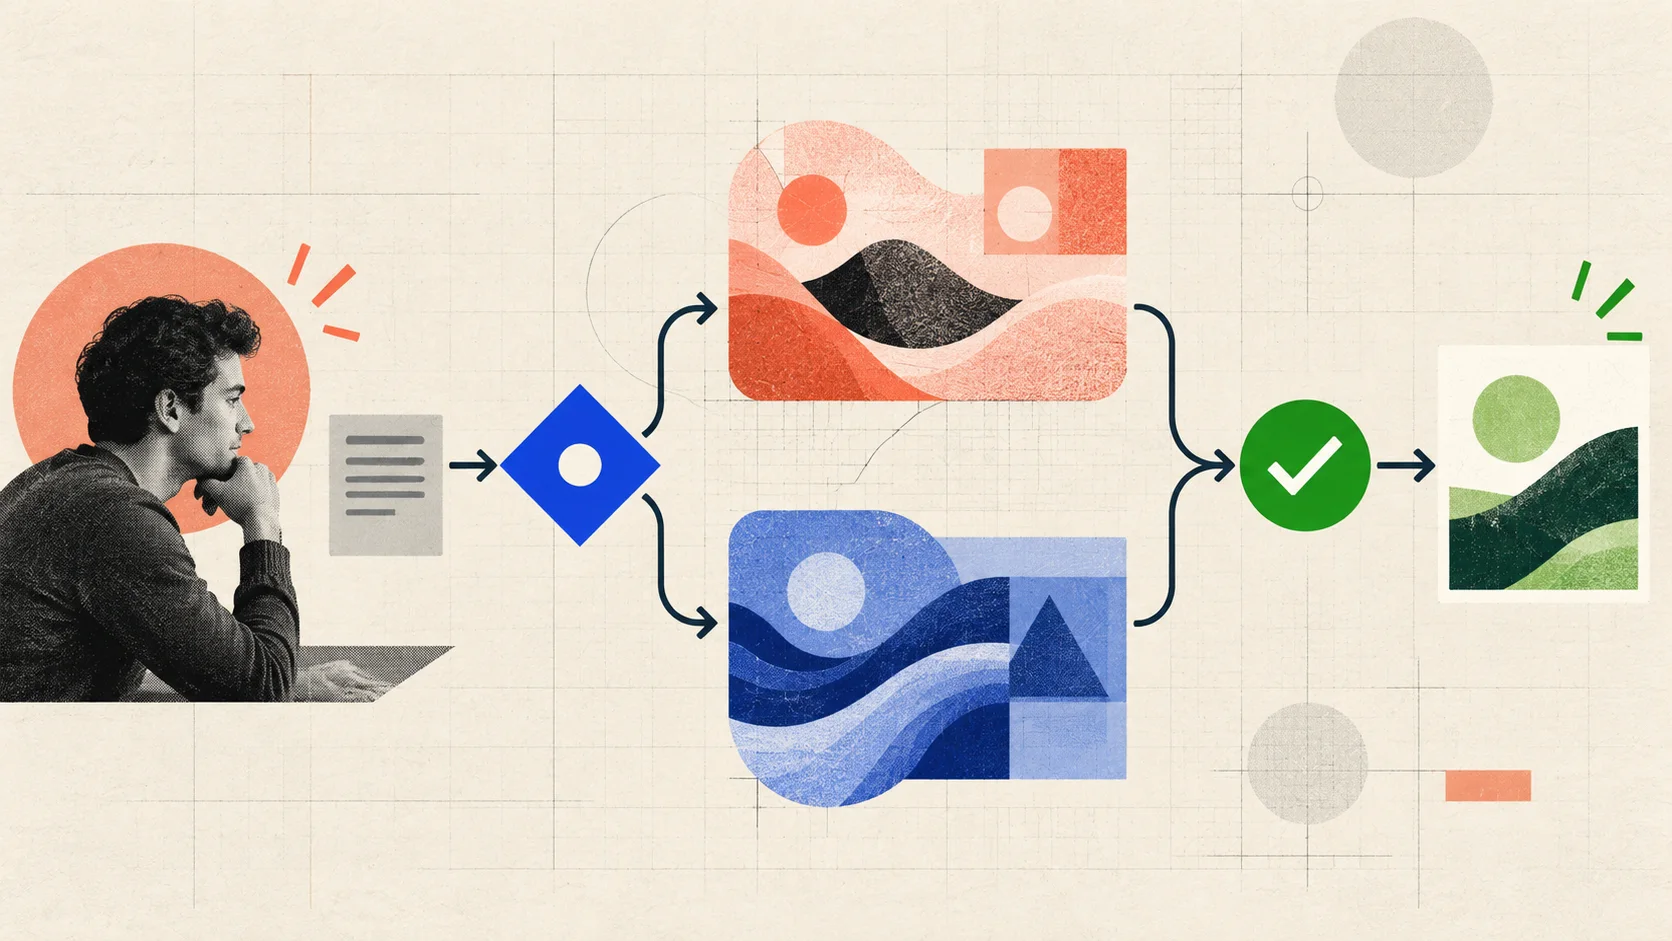
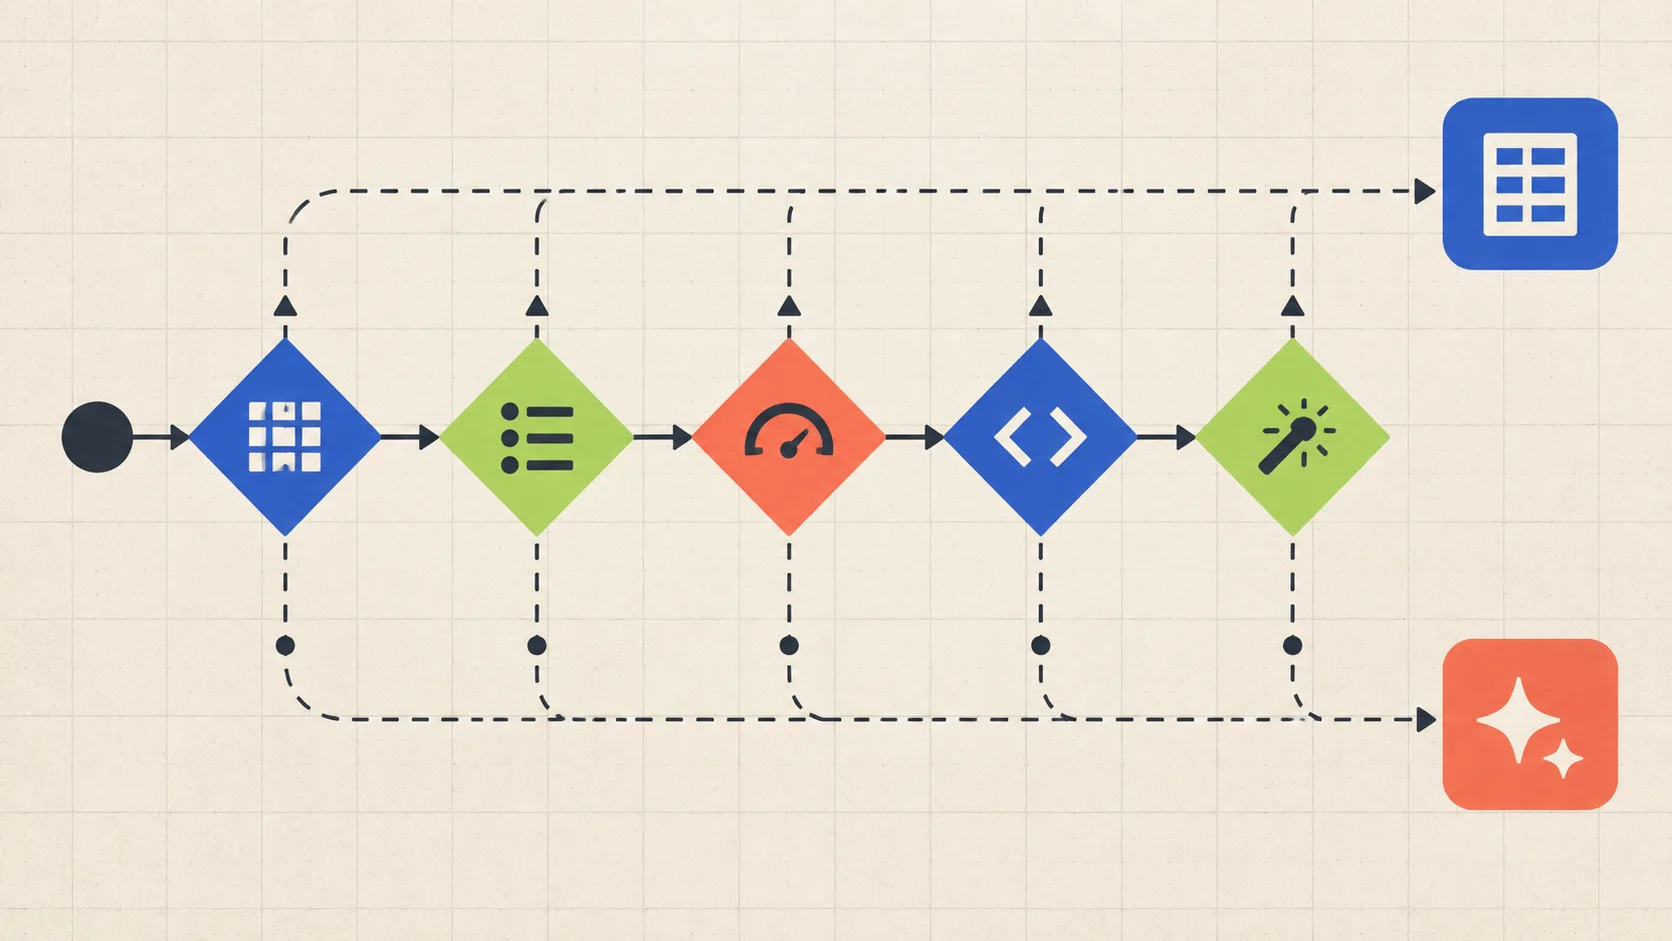
Bild: Jev kann rund um ein LLM Weiterleitung, Validierung und Risikoverzweigung übernehmen.
Eine praktische kombinierte Architektur kann so aussehen:
- Anfrage empfangen und State erstellen.
- Mit Jev Aufgabentyp, Schwierigkeit, Sensibilität und Tool-Bedarf klassifizieren.
- Einfache Aufgaben an ein schnelles Modell und komplexe Aufgaben an ein leistungsfähigeres Modell senden.
- Das LLM eine Antwort erzeugen oder offene Schlussfolgerungen durchführen lassen.
- Mit Jev oder festen Regeln prüfen, ob die Ausgabe versendet werden kann oder kontrolliert werden muss.
- Das Ergebnis vom Anwendungscode protokollieren lassen und die nächste Aktion auswählen.
Es geht nicht darum, um seiner selbst willen einen weiteren Modellaufruf hinzuzufügen. Jedes Modell soll den Teil übernehmen, für den es sich am besten eignet. Das Anfrageformat finden Sie im Jev-AI-API-Tutorial.
Vereinfachter Pseudocode
decision = jev.classify(
    state=request,
    questions={
        "risk": Score(rubric=["low", "medium", "high"]),
        "needs_tool": Noul("Does this request require a tool call?"),
    },
)

if decision.risk == "high" or decision.needs_tool > 0.9:
    return request_human_review(request)

return call_selected_llm(request, route=decision.risk)
Dies veranschaulicht eine Architektur und ist kein vollständiger SDK-Vertrag. Aktuelle Felder und Clients finden Sie in der offiziellen Jev-Dokumentation.
Eine Evaluation planen
Vergleichen Sie nicht zehn Beispiele und entscheiden Sie dann, welches System „menschlicher klingt“. Eine aussagekräftige Evaluation misst den endgültigen Kontrollfluss.
Einen repräsentativen Datensatz erstellen
Sammeln Sie normale, grenzwertige, mehrdeutige und adversariale Eingaben. Ziehen Sie Stichproben entsprechend dem realen Datenverkehr und bewerten Sie Chinesisch, Englisch, Fachbegriffe und fehlenden Kontext separat.
Kosten der einzelnen Fehler messen
Unterscheiden Sie zwischen falscher Eskalation, versäumter Eskalation, falscher Weiterleitung, unsicherer Ausführung und Kosten menschlicher Prüfung. Bei Aktionen mit großen Auswirkungen kann mehr Prüfung besser sein als die Optimierung der durchschnittlichen Genauigkeit.
Metriken Ende zu Ende vergleichen
Erfassen Sie Latenz, Kosten, Wiederholungsrate, Parsing-Fehler, Eingriffsrate von Menschen und endgültigen Aufgabenerfolg. Die geringe Latenz von Jev ist nur relevant, wenn dadurch der Gesamtworkflow verbessert wird.
Wartbarkeit bewerten
Prüfen Sie, ob Antwortbereiche klar sind, Fragen unabhängig geändert und Entscheidungen erneut abgespielt werden können und Schwellenwerte im Code bleiben. Ein scheinbar günstiges System, das sich nicht erklären lässt, kann langfristig mehr kosten.
Häufig gestellte Fragen
Ist Jev AI einfach ein schnelleres LLM?
Das wäre eine zu vereinfachte Beschreibung. Jev ist als System-One-Entscheidungsmodell konzipiert, das typisierte, von Software nutzbare Urteile statt langer Texte zurückgibt. Geschwindigkeit gehört zum Produktversprechen, muss aber in Ihrer eigenen Umgebung überprüft werden.
Brauche ich Jev noch, wenn mein LLM JSON Schema unterstützt?
Nicht immer. JSON Schema löst viele Formatierungsprobleme. Jev lohnt sich zum Vergleich, wenn Sie mehrere atomare Urteile, wahrscheinlichkeitsbasierte Weiterleitung oder eine stabile Entscheidungsschnittstelle in einem häufig ausgeführten Kontrollfluss benötigen.
Ersetzt Jev Geschäftsregeln?
Nein. Feste Regeln, Berechtigungen, Audits und Zahlungskontrollen sollten deterministisch bleiben. Jev ist vor allem für semantische Urteile nützlich, die sich nur schwer mit Regeln abdecken lassen, aber dennoch einen definierbaren Antwortbereich haben.
Kann ich Jev ohne LLM verwenden?
Ja, wenn Ihr Produkt nur Klassifizierung, Bewertung, Weiterleitung und Ja/Nein-Urteile benötigt. Brauchen Sie zusätzlich Inhaltserstellung oder offene Erklärungen, kombinieren Sie Jev mit einem LLM.
Wo sollte ich mit dem Testen beginnen?
Öffnen Sie den Jev-AI-Playground, testen Sie eine risikoarme, messbare Entscheidung und lesen Sie anschließend die API-Dokumentation. Wenn die Schnittstelle funktioniert, setzen Sie Jev in der Weiterleitungs- oder Schutzebene Ihres Agenten ein.
Fazit
Bei der Wahl zwischen Jev AI und einem LLM geht es nicht wirklich darum, welches Modell „intelligenter“ ist. Entscheidend ist, ob Ihre Software Generierung oder ein ausführbares Urteil benötigt. Überlassen Sie offene Generierung einem LLM, häufige begrenzte Entscheidungen einer Entscheidungsebene und Schwellenwerte sowie endgültige Aktionen dem Code.
Recherche-Datum: 2026-09-20
Primärquellen: Jev-AI-Startseite, Jev-AI-Dokumentation, TypeSafe-Einführung, Jev-AI-Showcase