Modellvergleiche
Jev vs. djev vs. Laya vs. OpenJev vs. SemIf: Welches Entscheidungsmodell sollten Sie verwenden?
Vergleichen Sie Jev, djev, Laya, OpenJev und SemIf nach Benchmark-Qualität, Kalibrierung, Geschwindigkeit, multimodalen Eingaben, Self-Hosting, offenen Gewichten und Kompromissen im Produktiveinsatz.
Jev vs. djev vs. Laya vs. OpenJev vs. SemIf: Welches Entscheidungsmodell sollten Sie verwenden?
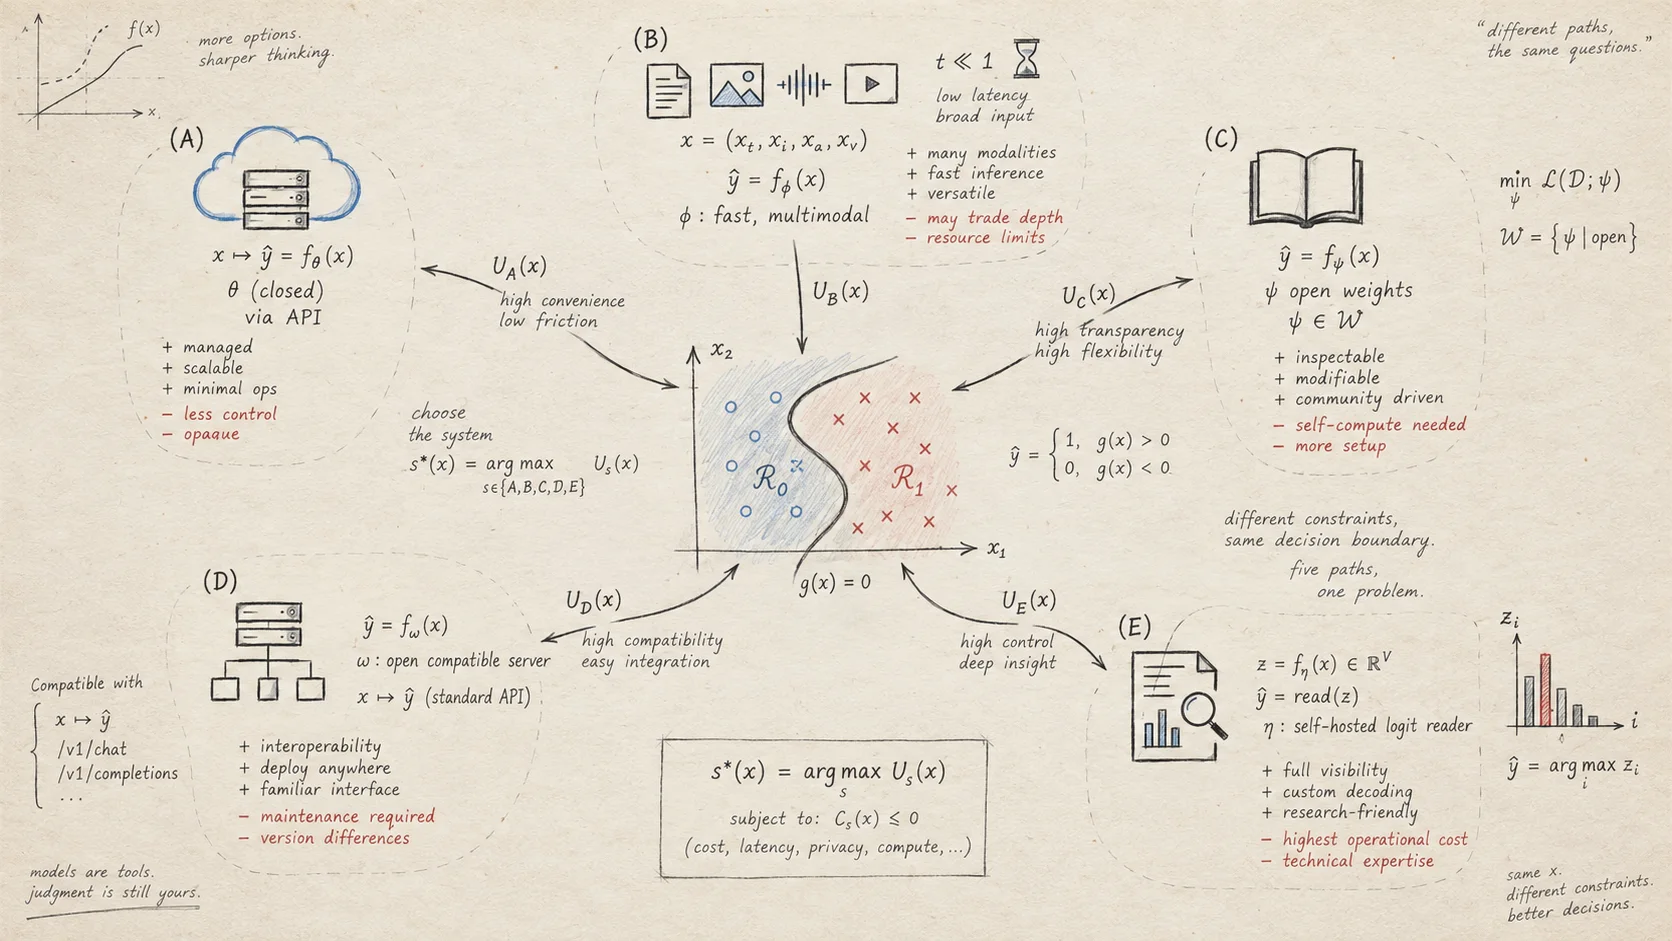
Wenn Sie Jev, djev, Laya, OpenJev und SemIf vergleichen, lautet die nützlichste Frage nicht: „Welches Modell hat die höchste Punktzahl?“ Sondern: „Welches Betriebsmodell passt zu meinem Produkt, meiner Datengrenze, meinem Latenzziel und meiner Bereitschaft, Kalibrierungsarbeit zu übernehmen?“
Alle diese Systeme zielen auf strukturierte Entscheidungen statt auf gewöhnliche Chatvervollständigung ab, setzen jedoch unterschiedliche Prioritäten. Jev ist ein gehostetes System-One-Modell mit Fokus auf kalibrierte, typisierte Entscheidungen. djev legt den Schwerpunkt auf Geschwindigkeit und native Bild- oder Kameraeingaben. Laya bietet offene Gewichte, Self-Hosting und Fine-Tuning. OpenJev stellt einen kompatiblen, selbst gehosteten Server mit multimodalen und Thinking-Optionen bereit. SemIf liest Logits offener Modelle aus und erreicht beim aggregierten Benchmark fast Jev, während die Infrastruktur unter Ihrer Kontrolle bleibt.
Dieser Leitfaden verwendet die offiziellen Vergleichsseiten und den dort veröffentlichten JevBench-v1.3.0-Snapshot, der im September 2026 aktualisiert wurde. Betrachten Sie die Zahlen als Entscheidungshilfe und nicht als Ersatz für Tests mit Ihrem eigenen Workload.
Inhaltsverzeichnis
- Die kurze Antwort
- Den Benchmark richtig lesen
- Die fünf Systeme im Überblick
- Jev vs. djev
- Jev vs. Laya
- Jev vs. OpenJev
- Jev vs. SemIf
- Nach Einschränkung auswählen
- Eine eigene Evaluation durchführen
- Häufig gestellte Fragen
Die kurze Antwort
Wählen Sie Jev, wenn Ihre Anwendung eine gehostete API, typisierte Antworten und Wahrscheinlichkeiten für Weiterleitung oder Eskalation benötigt, ohne dass Sie eine GPU betreiben oder zuerst eine Kalibrierungsebene einrichten müssen.
Wählen Sie djev, wenn Geschwindigkeit und native Bild- oder Live-Kameraeingaben wichtiger sind als eine produktionsreife Kalibrierung – besonders solange die gehostete Vorschau praktisch verfügbar ist.
Wählen Sie Laya, wenn offene Gewichte, Offline-Bereitstellung, mehrsprachige Abdeckung und Fine-Tuning wichtiger sind als Zero-Shot-Qualität bei schwierigen Entscheidungen.
Wählen Sie OpenJev, wenn Sie ein selbst gehostetes, Jev-kompatibles Anfrageformat mit Bildeingaben oder Thinking-Modus möchten und bereit sind, die Laufzeitumgebung zu betreiben.
Wählen Sie SemIf, wenn Sie eine offene Implementierung möchten, die Entscheidungs-Logits aus von Ihnen kontrollierten Modellen ausliest, Daten in Ihrem Netzwerk halten kann und über GPU-Kapazität sowie Evaluationsprozesse für die Kalibrierung verfügt.
Den Benchmark richtig lesen
Der herangezogene Vergleich mit JevBench v1.3.0 berichtet eine gemeinsame Evaluationsmethode für 52 Systeme und 534 Entscheidungen: 72 einfache, 96 Standard-, 146 urteilsbasierte und 220 schwierige Fälle. Die Gesamtpunktzahl kombiniert Intelligenz, Kalibrierung, Geschwindigkeit und Kosten.
Der veröffentlichte Snapshot der Gesamtwertung lautet:
| System | Rang | Gesamtpunktzahl | Hauptbetriebsmodell |
|---|---|---|---|
| Jev 1.13.0 | #1 | 74.4 | Gehostete Produktions-API |
| SemIf | #2 | 73.1 | Selbst gehosteter Logit-Reader für offene Modelle |
| djev | #3 | 73.0 | Gehostete API mit multimodalen Eingaben |
| OpenJev | #11 | 66.4 | Selbst gehosteter kompatibler Entscheidungsserver |
| Laya | #33 | 54.4 | Selbst gehostete offene Gewichte |
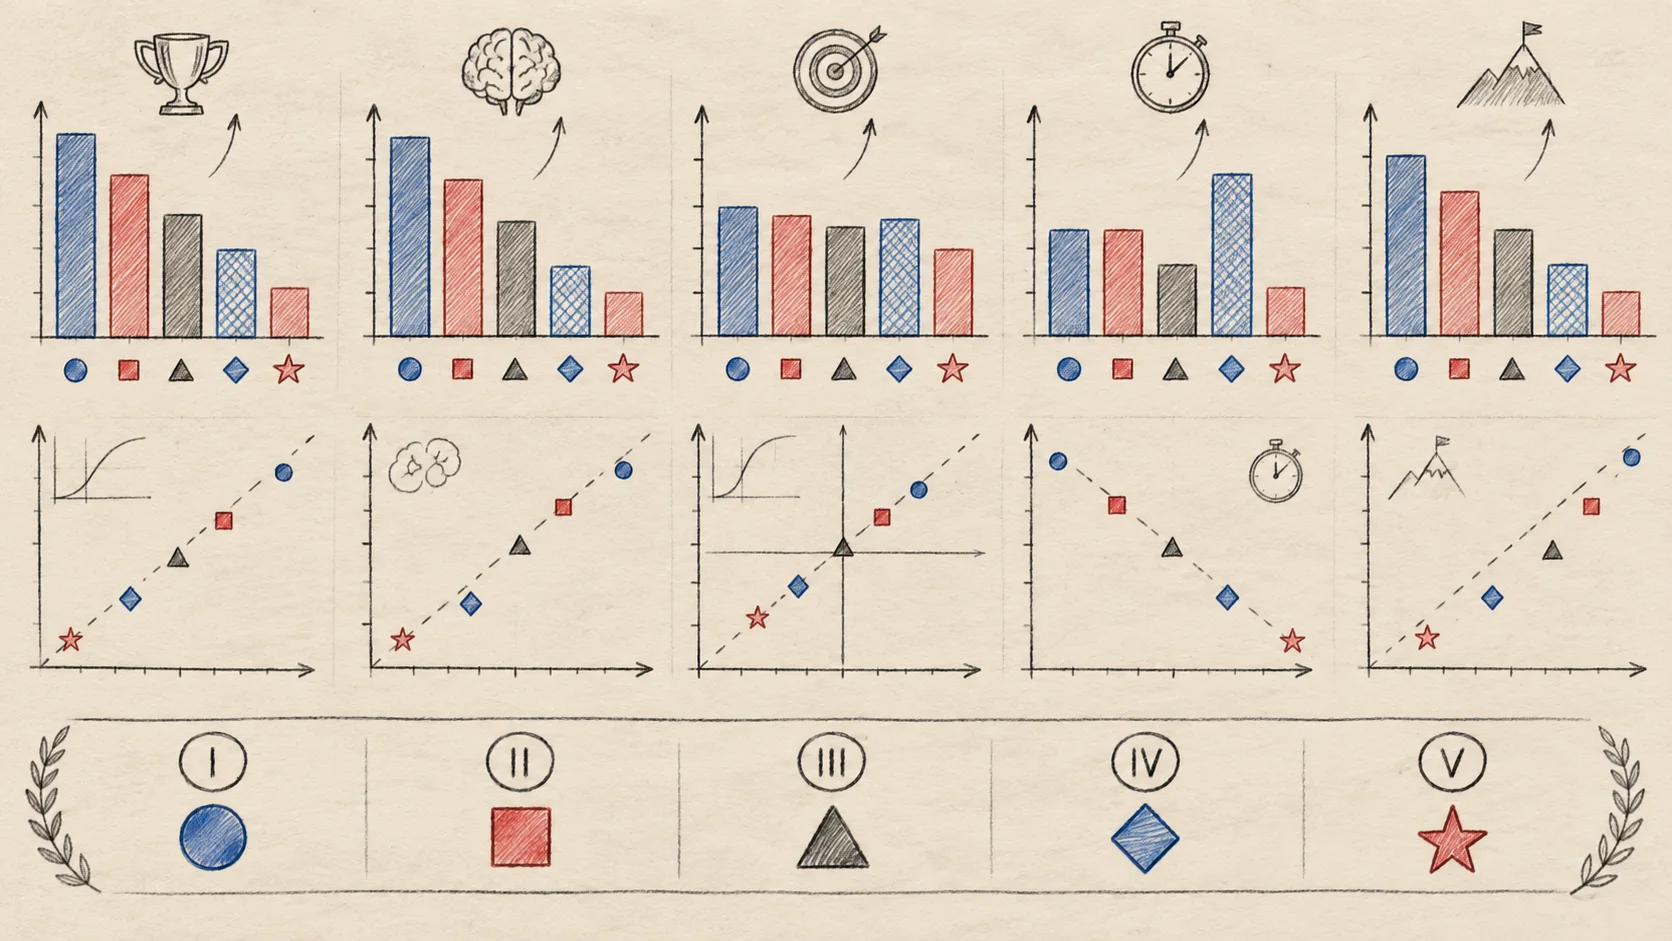
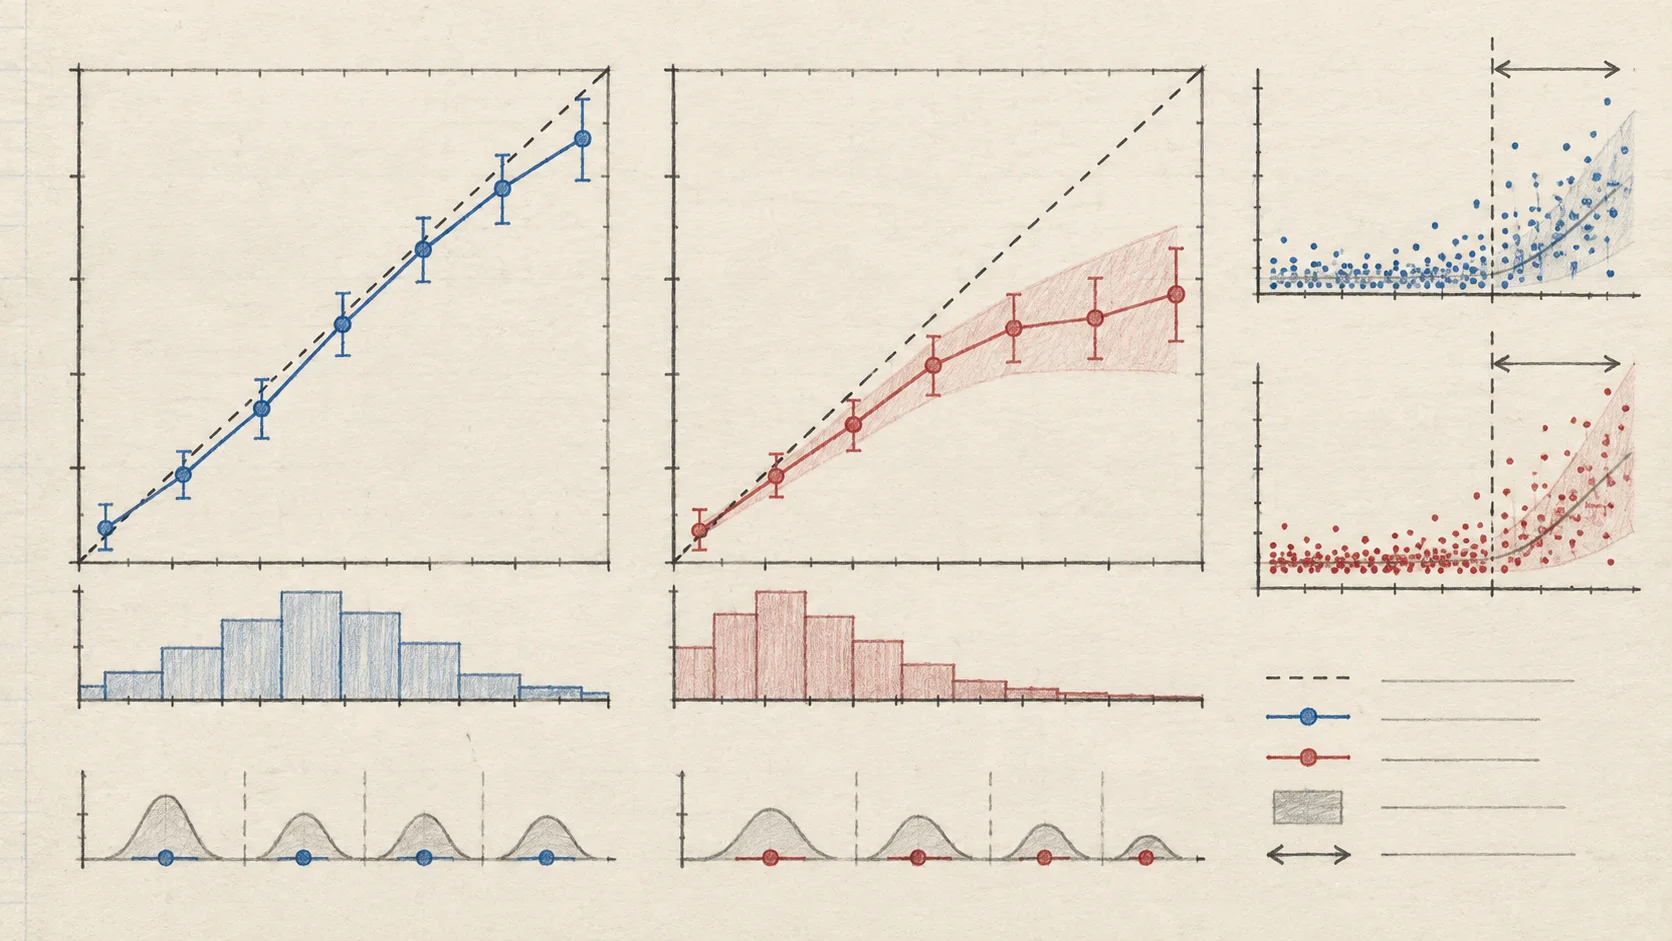
Eine Gesamtpunktzahl verbirgt wichtige Unterschiede. Ein System kann schneller, aber schlechter kalibriert sein; günstiger, aber schwieriger zu betreiben; oder auf einer Bewertungsstufe genauer, aber bei tatsächlich mehrdeutigen Fällen schwächer. Für Agenten und Workflows mit Wahrscheinlichkeitsschwellen kann die Kalibrierung wichtiger sein als eine kleine Änderung der Rohgenauigkeit.
Die fünf Systeme im Überblick
| System | Stärke | Kompromiss | Besonders geeignet für |
|---|---|---|---|
| Jev | Gehostete typisierte Entscheidungen und kalibrierte Wahrscheinlichkeiten | Nur Texteingaben und nutzungsbasierte API | Weiterleitung, Bewertung und Schutzregeln im Produktivbetrieb |
| djev | Geschwindigkeit sowie native Bilder und Kamerabilder | Wahrscheinlichkeiten sind als experimentell dokumentiert | Schnelle multimodale Prototypen und visuelle Entscheidungen |
| Laya | Apache-2.0-Gewichte, Self-Hosting auf CPU/GPU und Fine-Tuning | Benötigt Aufgabendaten und Anpassungen für verlässliche Qualität im Produktivbetrieb | Offline- oder mehrsprachige Systeme mit Trainingskapazität |
| OpenJev | Jev-kompatible API, Bilder und Thinking-Modus | Betrieb und Konfiguration von GPU oder Apple Silicon | Selbst hostende Teams mit vertrautem Anfrageformat |
| SemIf | Offene Implementierung, Offline-Logits, starke Gesamtpunktzahl | Eigene GPU, Serving und Kalibrierung pro Workload | Kontrollierte Netzwerke und Teams mit Modellbetriebserfahrung |
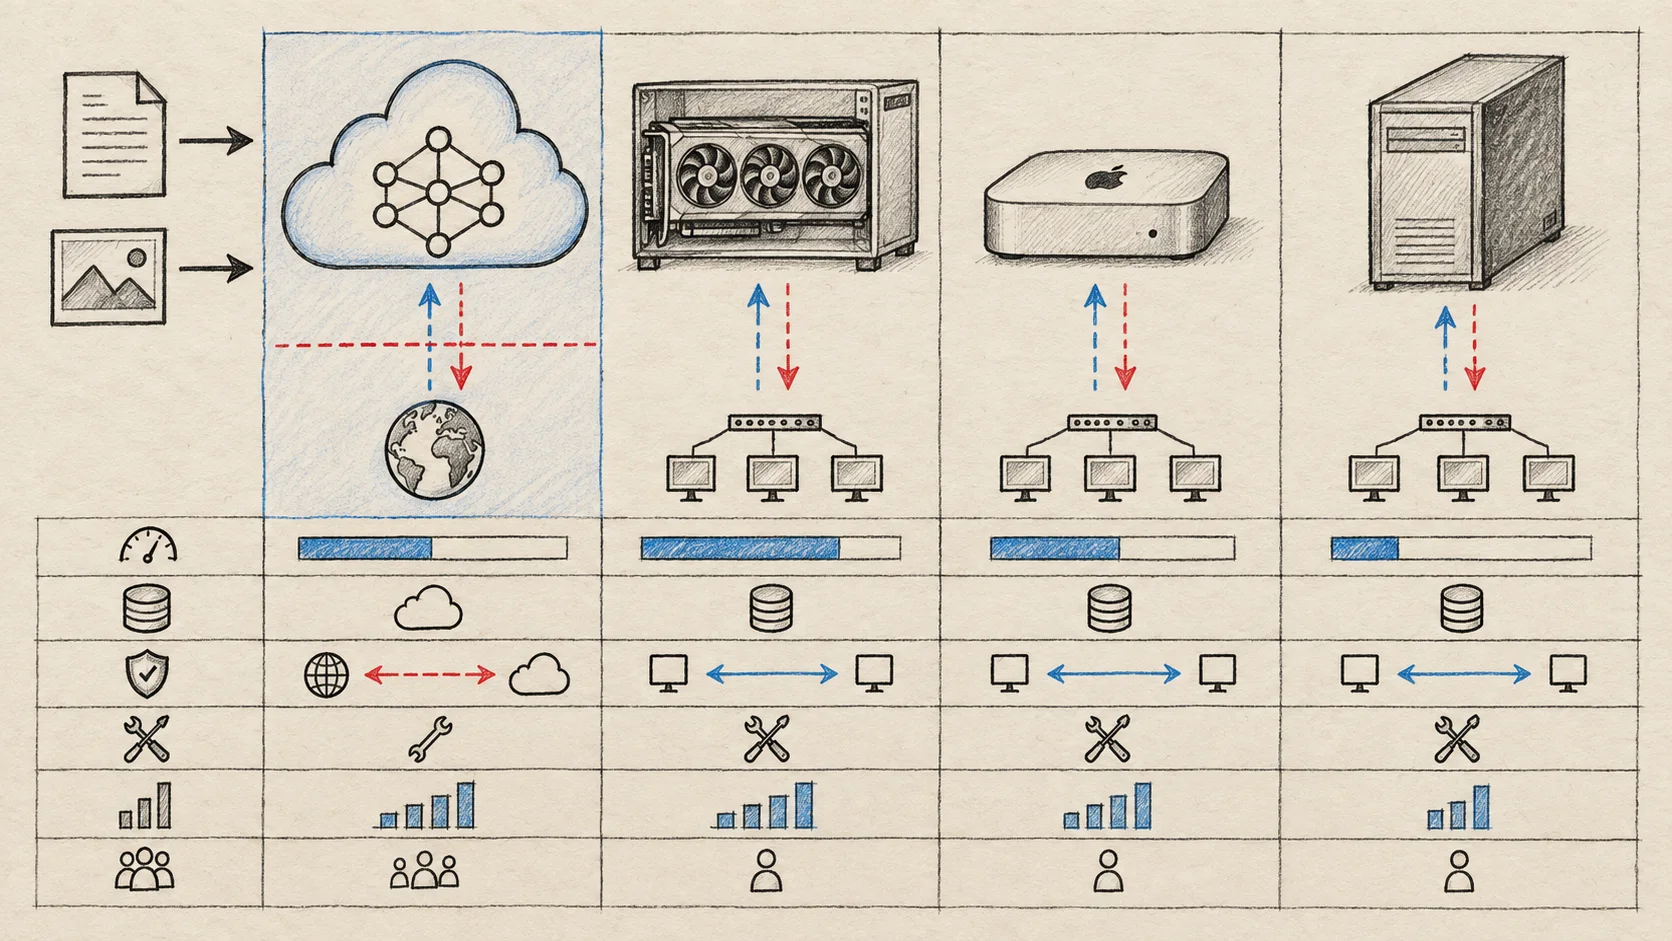
Die Bereitstellungsgrenze ist oft wichtiger als die Rangliste. Eine gehostete API reduziert den Infrastrukturaufwand, sendet Anfragen aber an einen Anbieter. Ein selbst gehostetes Modell hält Daten näher am eigenen System, macht Kapazitätsplanung, Überwachung, Upgrades und Kalibrierung jedoch zu Ihrer Verantwortung.
Jev vs. djev
Der Vergleich von Jev und djev beschreibt ein knappes Rennen mit klar unterschiedlichen Betriebsprioritäten.
Jev führt bei der veröffentlichten Kalibrierungsbewertung mit 82.7 gegenüber 65.4 für djev. Beim Vergleich der Genauigkeit auf schwierigen Fällen liegt Jev mit 74.1 % gegenüber 69.5 % vorn. djev führt bei der Geschwindigkeit mit 91.4 gegenüber 83.3 für Jev. Bei einfachen und Standardfällen liegen beide Systeme so nah beieinander, dass die Bereitstellungswahl wichtiger sein kann als die Rohgenauigkeit.
Entscheidend ist die Eingabegrenze:
- Jev konzentriert sich auf Texte, JSON-Objekte und Textarrays.
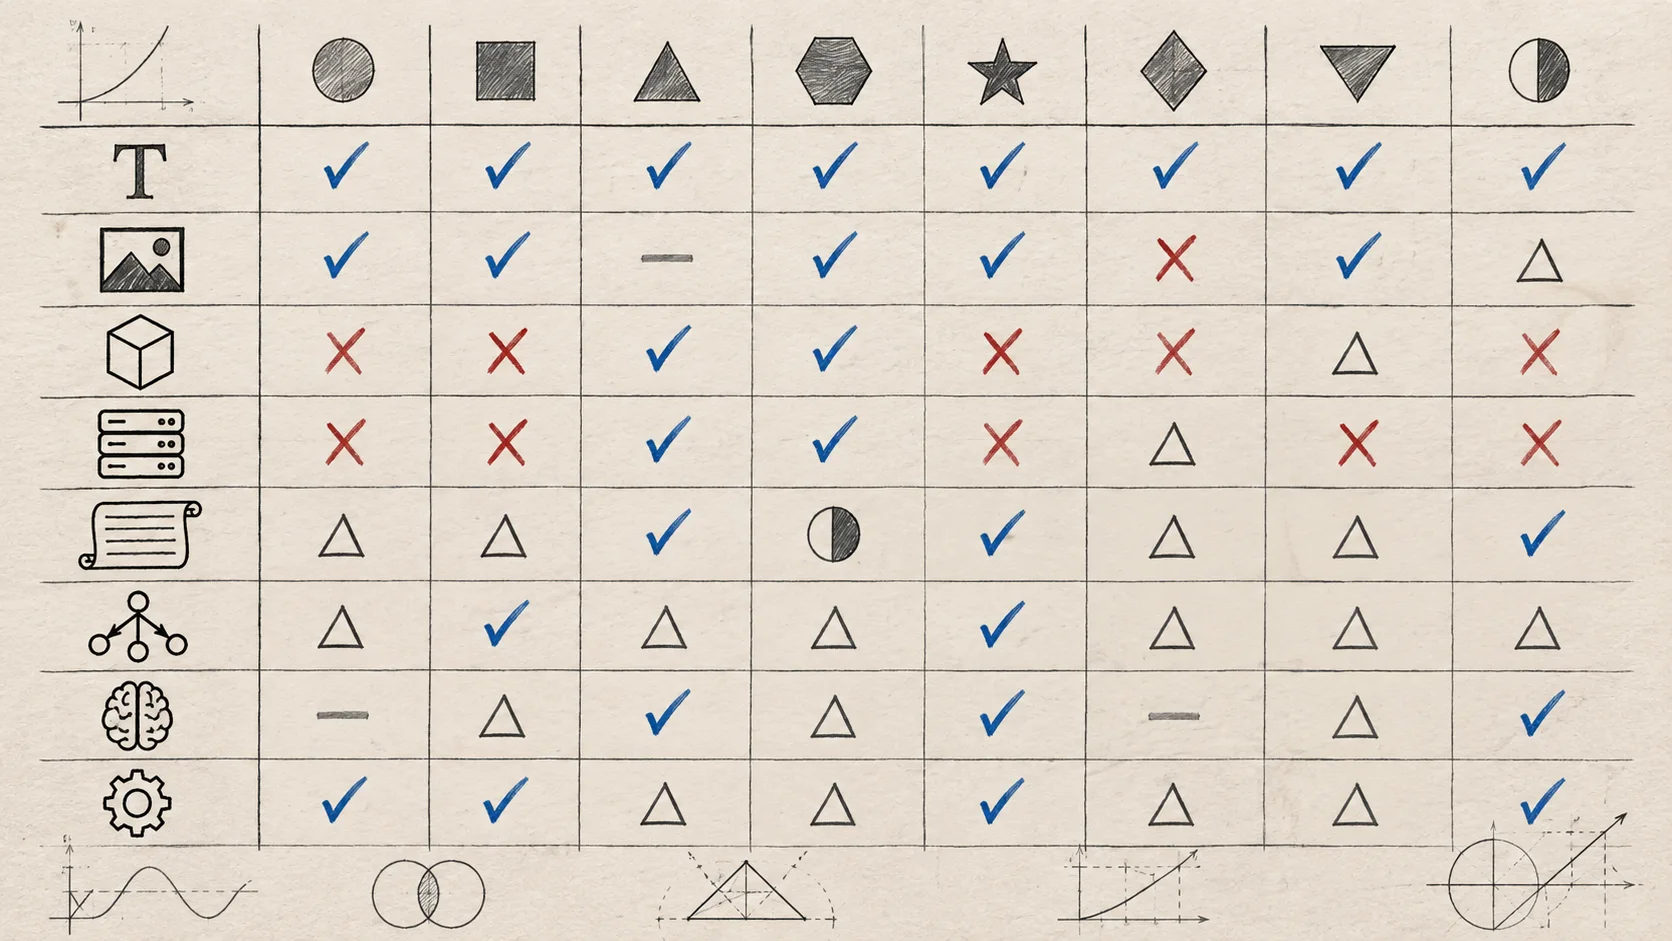
- djev akzeptiert Texte, native Bildeingaben, Bildoptionen und Live-Kamerabilder.
- Beide unterstützen typisierte Entscheidungsformen wie Noul, Choice und Score.
Verwenden Sie Jev, wenn die Anwendung Wahrscheinlichkeiten für automatische Freigabe, Eskalation, Gewichtung oder Weiterleitung nutzt und Sie einen gehosteten, produktionsorientierten Weg wünschen. Verwenden Sie djev, wenn visueller Kontext oder sehr geringe Latenz im Vordergrund steht. Behandeln Sie die Wahrscheinlichkeitsausgabe als experimentell, bis Ihre eigene Evaluation sie bestätigt.
Auch das Kostenmodell unterscheidet sich. Die Vergleichsseite beschreibt Jev als gehostete Produktions-API mit geplantem nutzungsbasiertem Modell, während djev als kostenlose Vorschau mit angekündigter Preisgestaltung verfügbar ist. Vorschauverfügbarkeit und Preise können sich ändern. Prüfen Sie deshalb die aktuellen Konditionen, bevor Sie sich auf eine Architektur festlegen.
Jev vs. Laya
Der Vergleich von Jev und Laya stellt hauptsächlich ein sofort nutzbares gehostetes Modell einem Modell mit offenen Gewichten gegenüber, das Sie selbst anpassen können.
Die veröffentlichte Genauigkeit bei schwierigen Fällen beträgt in den verglichenen Konfigurationen 74.1 % für Jev und 34.1 % für Laya. Jevs Intelligenzwert beträgt 85.7 gegenüber 45.8 für Laya, während Laya auf geeigneter Hardware für deutlich schnellere lokale Inferenz ausgelegt ist. Layas stärkster Vorteil ist nicht die Zero-Shot-Qualität, sondern Kontrolle, Fine-Tuning, Offline-Betrieb und niedrige Grenzkosten, wenn bereits eine stark ausgelastete GPU verfügbar ist.
Wichtige Unterschiede:
- Jev akzeptiert im Vergleich bis zu 64k Tokens pro Anfrage; der Kontext pro Frage ist bei Laya auf 512 Tokens begrenzt.
- Laya bietet Apache-2.0-Gewichte und englische oder mehrsprachige Checkpoints.
- Für eine stabile Produktivaufgabe benötigt Laya gelabelte Beispiele und Fine-Tuning.
- Jev funktioniert direkt über eine gehostete API, ohne dass Sie eine ungenutzte GPU oder einen Trainingslauf verwalten müssen.
Laya kann die bessere Wahl sein, wenn Daten Ihr Netzwerk nicht verlassen dürfen und Sie über eine feste Taxonomie, gelabelte Beispiele und ein Team für den Modellbetrieb verfügen. Jev ist der bessere erste Weg, wenn Sie einen Entscheidungsworkflow prüfen möchten, ohne diese Infrastruktur aufzubauen.
Jev vs. OpenJev
Beim Vergleich von Jev und OpenJev geht es weniger um das Anfrageformat als darum, was geschieht, nachdem die Anfrage Ihre Anwendung verlassen hat.
OpenJev ist als kompatibler Entscheidungsserver konzipiert. Es kann das allgemeine Format /v1/systemone annehmen, auf einer NVIDIA-GPU mit 24 GB oder Apple Silicon laufen, bis zu acht Bilder pro Anfrage verarbeiten und einen Thinking-Modus mit einem Kompromiss zwischen Qualität und Latenz anbieten. Jev ist eine gehostete Produktions-API mit Schwerpunkt auf Textentscheidungen.
Im veröffentlichten Standardvergleich erzielt Jev 82.7 bei der Kalibrierung gegenüber 64.8 für OpenJev und 74.1 % gegenüber 65.5 % bei schwierigen Fällen. Die Geschwindigkeitswerte liegen mit 83.3 gegenüber 83.2 nahe beieinander. OpenJevs Thinking-Konfiguration ist ein eigener Betriebspunkt: Die Vergleichsseite nennt 88.0 Intelligenz und 78.2 % bei schwierigen Fällen. Diese Werte sollten daher nicht mit einem Vergleich der Standardeinstellungen vermischt werden.
Wählen Sie OpenJev, wenn Sie Bildeingaben, Self-Hosting, Apache-2.0-Code und -Gewichte oder eine kompatible API innerhalb Ihres Netzwerks benötigen. Wählen Sie Jev, wenn kalibrierte Wahrscheinlichkeiten, verwalteter Betrieb und ein schneller Weg in die Produktion wichtiger sind als die Kontrolle über die Laufzeitumgebung.
Jev vs. SemIf
Der Vergleich von Jev und SemIf zeigt die stärkste offene Alternative in der veröffentlichten Gesamtwertung: SemIf erreicht 73.1 gegenüber 74.4 für Jev und liegt auf Rang 2 statt Rang 1.
Der Unterschied ist konzentriert und nicht allgemeingültig:
- SemIf führt bei urteilsbasierten Fällen mit 95.2 % gegenüber 94.5 % für Jev.
- Jev führt bei schwierigen Fällen mit 74.1 % gegenüber 59.5 % für SemIf.
- Jevs Kalibrierungswert beträgt 82.7 gegenüber 72.6 für SemIf.
- Die Geschwindigkeitswerte liegen mit 83.3 für Jev und 83.7 für SemIf nahezu gleichauf.
SemIf verwendet das Auslesen von Logits offener Modelle; die primäre Benchmark-Konfiguration nutzt Qwen3.5-4B. Der Code steht unter MIT-Lizenz, die vorgelagerten Modellgewichte unterliegen jedoch ihren eigenen Lizenzen. Die Inferenz bleibt in Ihrer Umgebung, aber Sie sind für GPU, Serving-Stack, Kapazitätsplanung und Kalibrierung Ihres Workloads zuständig.
Jev eignet sich gut, wenn Wahrscheinlichkeitssignale sofort funktionieren sollen und der Datenverkehr so unregelmäßig ist, dass die Kosten einer ungenutzten GPU ineffizient wären. SemIf ist überzeugend, wenn bereits eine stark ausgelastete GPU verfügbar ist, Offline-Betrieb erforderlich ist und das Team Schwellenwerte kalibrieren und überwachen kann.
Nach Einschränkung auswählen
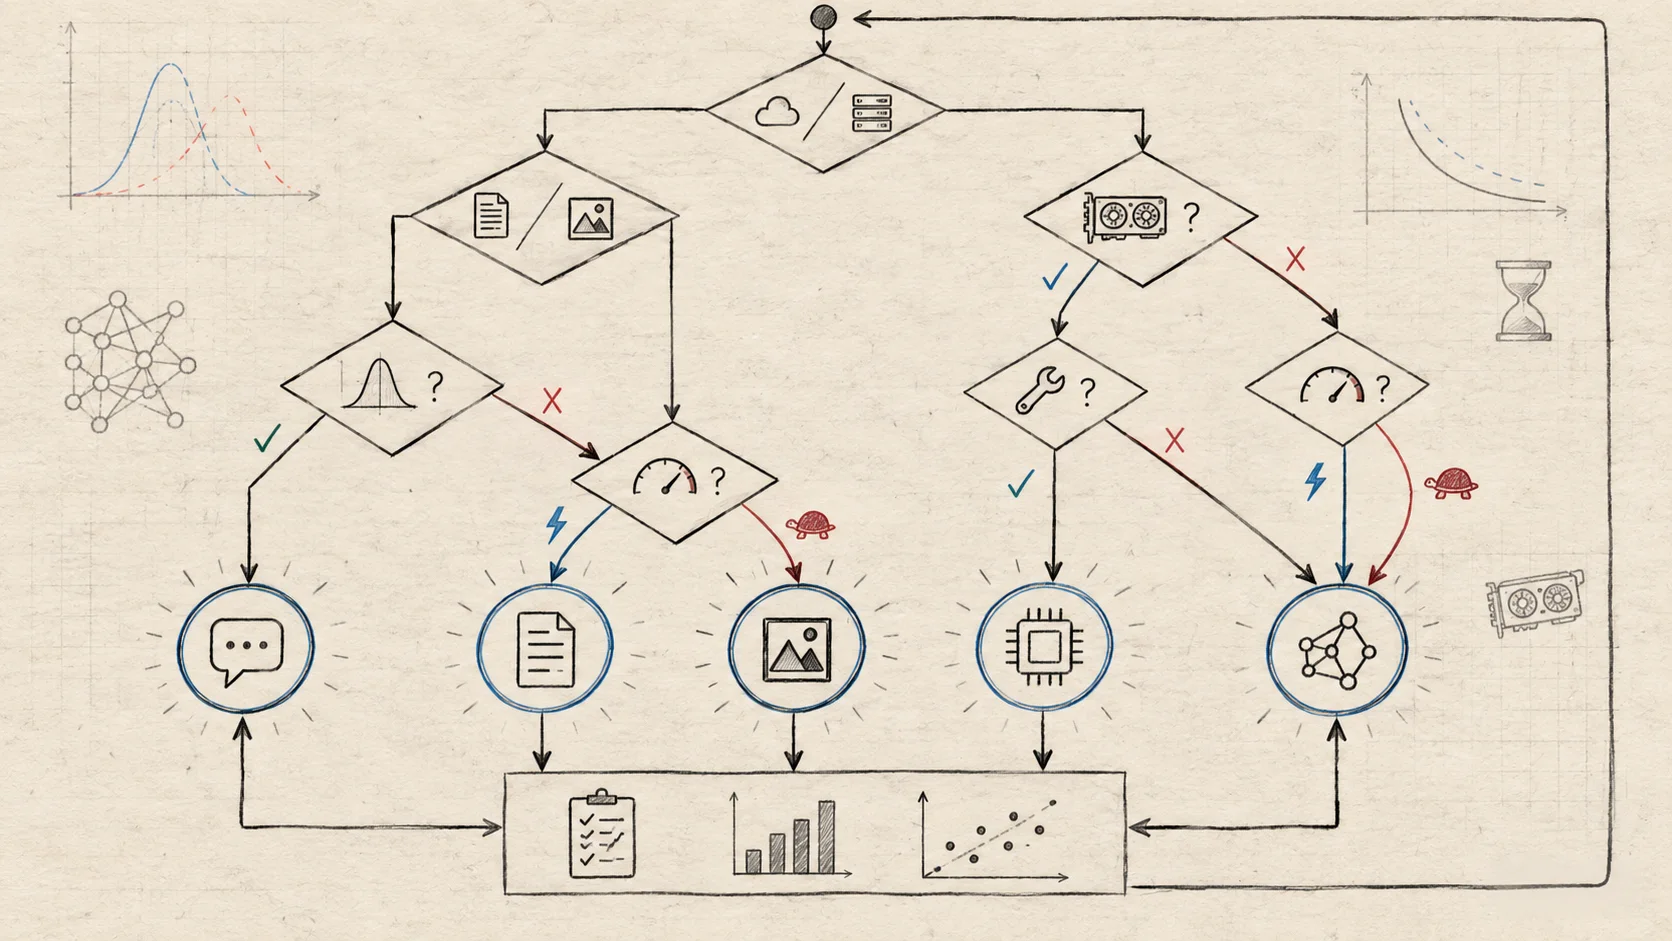
Beginnen Sie mit der Einschränkung, deren Änderung später am teuersten wäre:
| Ihre wichtigste Einschränkung | Zuerst zu evaluierende Systeme | Warum |
|---|---|---|
| Verwaltete Produktions-API | Jev, djev | Kein GPU-Serving-Stack; Kalibrierung und multimodale Anforderungen vergleichen |
| Native Bild- oder Kameraeingabe | djev, OpenJev | Beide Vergleichsseiten heben multimodale Eingaben hervor |
| Daten müssen im eigenen Netzwerk bleiben | Laya, OpenJev, SemIf | Self-Hosting hält die Serving-Grenze unter Ihrer Kontrolle |
| Kalibrierte Wahrscheinlichkeiten für Weiterleitung | Zuerst Jev, danach SemIf | Schwellenwerte mit den eigenen schwierigen Fällen vergleichen |
| Fine-Tuning und offene Gewichte | Laya, OpenJev, SemIf | Laufzeitumgebung prüfen, ändern oder selbst betreiben |
| Jev-kompatibles Anfrageformat | Jev, OpenJev | OpenJev ist auf eine kompatible API-Form ausgelegt |
| Unregelmäßiger Datenverkehr ohne ständig verfügbare GPU | Jev | Gehosteter Zugriff vermeidet die Kapazitätsplanung für einen lokalen Beschleuniger |
| Sehr geringe lokale Latenz | Laya, SemIf, OpenJev | Ende-zu-Ende-Latenz messen, nicht nur die Modellinferenz |
Eine eigene Evaluation durchführen
Das wertvollste Ergebnis ist kein universeller Sieger, sondern eine Modellwahl, die sich bei Ihren echten Beispielen bewährt.
1. Entscheidungsschnittstelle einfrieren
Verwenden Sie für jedes System denselben State, dieselbe Frageformulierung, dieselben Antwortoptionen und dieselbe Ausgaberichtlinie. Erhält ein System einen umfangreicheren Prompt oder eine andere Taxonomie, ist der Vergleich nicht fair.
2. Einen repräsentativen Testsatz erstellen
Fügen Sie normale, mehrdeutige und lange Kontexte, adversariale Eingaben und Beispiele hinzu, die eskaliert werden sollten. Trennen Sie einfache Klassifizierung von Entscheidungen, bei denen Wahrscheinlichkeiten eine reale Aktion steuern.
3. Mehr als nur Genauigkeit messen
Erfassen Sie mindestens:
- exakte Entscheidungsgenauigkeit je Schwierigkeitsgrad;
- Kalibrierung oder erwarteten Kalibrierungsfehler;
- p50- und p95-Ende-zu-Ende-Latenz;
- Kosten bei realistischem Datenverkehr einschließlich ungenutzter GPU-Zeit;
- multimodale Qualität, wenn Bilder Teil der Aufgabe sind;
- Betriebsaufwand für Bereitstellung, Upgrades und Störungen;
- Anforderungen an Datenschutz, Aufbewahrung und Netzwerkgrenzen.
4. Die Schwellenwertrichtlinie testen
Wenn der Code anhand einer Wahrscheinlichkeit automatisch freigibt, weiterleitet, blockiert oder eskaliert, evaluieren Sie auch den Schwellenwert selbst. Ein Modell mit dem besten Durchschnitt kann trotzdem ungeeignet sein, wenn sein Unsicherheitssignal dort instabil ist, wo Ihre Anwendung handelt.
5. Nach Änderungen erneut testen
Offene Modelle, gehostete Vorschauen, Preise, Laufzeitumgebungen und Kalibrierungsebenen ändern sich. Halten Sie Modellversion, Laufzeitkonfiguration, Datum und Testsatz bei jedem Benchmark-Ergebnis fest.
Häufig gestellte Fragen
Ist Jev immer die qualitativ beste Wahl?
Nein. Im herangezogenen Benchmark liegt Jev bei Gesamtwertung und schwierigen Fällen vorn. SemIf führt bei urteilsbasierten Fällen, djev bei der Geschwindigkeit, Laya bei offenen Gewichten und lokaler Kontrolle, und OpenJev bietet einen kompatiblen selbst gehosteten Weg mit Bildern und Thinking-Modus.
Welches System eignet sich am besten für eine private Bereitstellung?
Evaluieren Sie zuerst Laya, OpenJev und SemIf, da ihre Vergleichsseiten selbst gehostete Varianten beschreiben. Die richtige Wahl hängt von Ihrer GPU, Datenrichtlinie, Ihrem Fine-Tuning-Bedarf und Ihrer Fähigkeit zur Wahrscheinlichkeitskalibrierung ab.
Welches Modell sollte ein KI-Agent für die Tool-Sicherheit verwenden?
Beginnen Sie mit dem System, dessen Wahrscheinlichkeitssignal und Betriebsgrenzen Sie validieren können. Behalten Sie bei Tools mit großen Auswirkungen deterministische Berechtigungen und menschliche Freigabe im Anwendungscode bei – unabhängig vom gewählten Modell.
Können Benchmark-Werte als aktuelle Produktgarantien gelten?
Nein. Der Vergleich ist ein datierter Snapshot, der anhand eines definierten Entscheidungssatzes gemessen wurde. Nutzen Sie ihn zur Auswahl von Tests und führen Sie anschließend denselben Workload und dieselbe Schwellenwertrichtlinie mit den Versionen und Bereitstellungsmodi aus, die Sie einsetzen möchten.
Fazit
Die Wahl zwischen Jev, djev, Laya, OpenJev und SemIf ist eine Systementscheidung und nicht bloß ein Wettbewerb um Modellqualität. Jev priorisiert verwalteten Zugriff und kalibrierte Entscheidungen. djev setzt auf Geschwindigkeit und native visuelle Eingaben. Laya priorisiert offene Gewichte, Self-Hosting und Fine-Tuning. OpenJev bietet kompatible Bereitstellung mit multimodalen und Thinking-Optionen. SemIf setzt auf offene Logits und Kontrolle über die Laufzeitumgebung.
Wählen Sie die wichtigste Einschränkung, testen Sie die schwierigen Fälle, bei denen sich die Systeme unterscheiden, und messen Sie die Wahrscheinlichkeitsschwellen, die Ihr Code tatsächlich verwenden wird. So wird aus einem Vergleich eine verlässliche Produktionsentscheidung.