Entwicklerleitfaden
Laya AI: Modellauswahl und API-Integration
Laya AI verstehen, ein Laya-Modell wählen und die Laya API integrieren: mit ausführbarem Beispiel, typisierten Entscheidungen, Fehlerbehandlung und Evaluation.
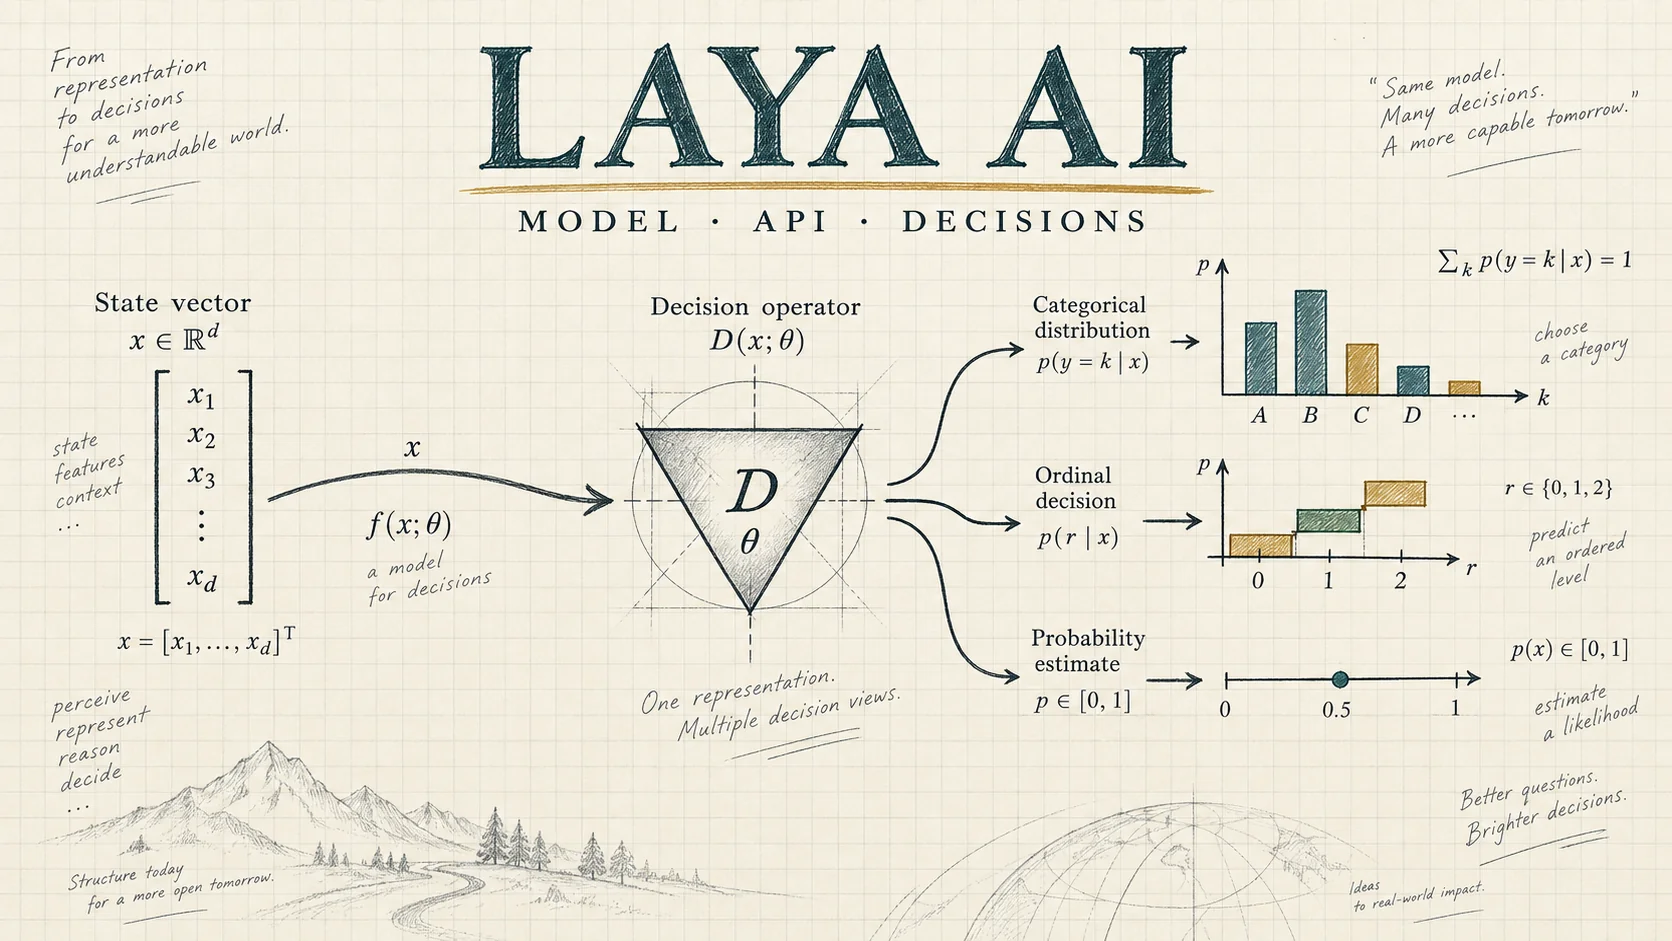
Laya AI wandelt Kontext in klar begrenzte Entscheidungen um: eine Kategorie, einen geordneten Bewertungswert oder die Wahrscheinlichkeit einer Ja-Nein-Aussage. Das Laya-Modell hilft, wenn Ihre Anwendung die möglichen Ergebnisse bereits kennt und Unterstützung bei der Auswahl benötigt. Eine Laya API stellt solche Entscheidungen über HTTP bereit. Das Modell und der Dienst, der die Schnittstelle anbietet, sind jedoch getrennte Ebenen.
Stellen Sie sich eine Supportnachricht vor: „Seit dem Update funktioniert der Checkout nicht mehr. Kunden können nicht bezahlen.“ Ihre Anwendung braucht ein zuständiges Team, eine Priorität und möglicherweise eine Kennzeichnung für die manuelle Prüfung. Dafür muss nicht zu jeder Entscheidung ein Textabsatz erzeugt werden. Im Laya AI Online-Playground können Sie dieses Muster mit eigenen Beispielen erkunden.
Dieser Leitfaden begleitet den Ablauf von der Modellauswahl über einen API-Aufruf bis zur Bewertung für den Produktivbetrieb. Die Modelldetails stammen aus dem ursprünglichen Projekt; die Schnittstellendetails beziehen sich auf den Dienst unter thejevai.com. Die Quellen wurden am 28. September 2026 geprüft. Beispiele und Abbildungen erklären Integrationsmuster und zeigen keine gemessenen Leistungsergebnisse.
Inhaltsverzeichnis
- Was ist Laya AI?
- Die drei Entscheidungstypen verstehen
- Ein Laya-Modell für Ihren Anwendungsfall wählen
- Die Entscheidung vor dem API-Aufruf entwerfen
- Die erste Anfrage an die Laya API senden
- Grenzen, Fehler und Guthaben behandeln
- Entscheidungen vor der Automatisierung bewerten
- Einen nützlichen Ablauf schrittweise einführen
- Häufige Fragen zu Laya AI, Modell und API
- Quellen und Pflege
Was ist Laya AI?
Laya ist eine Familie von Entscheidungsmodellen mit offenen Gewichten von Convai Innovations, veröffentlicht unter Apache-2.0. Die nicht-autoregressive Architektur bewertet vorgegebene Antworten, statt eine Antwort Token für Token zu erzeugen. Der englische Checkpoint verwendet ModernBERT, der mehrsprachige mmBERT. Das ursprüngliche Python-Paket enthält einen Router und unterstützt lokale Inferenz.
Diese Architektur eignet sich für Klassifikation, Routing und gezielte Bewertungen. Ein generatives Modell kann eine Kundenantwort entwerfen, während Laya ein Routingsignal liefert. Beide Komponenten lassen sich kombinieren, weil sie unterschiedliche Anforderungen an die Ausgabe erfüllen.
Unterscheiden Sie drei Ebenen:
| Ebene | Was Sie auswählen | Was Sie prüfen müssen |
|---|---|---|
| Modell | Checkpoint, Revision, Laufzeitumgebung | Genauigkeit bei Ihrem Anwendungsfall |
| API | Authentifizierung, Anfrage- und Antwortformat | Grenzen, Verfügbarkeit und tatsächliche Bereitstellung |
| Anwendung | Erlaubte Aktionen und Rückfallregeln | Ob eine Entscheidung eine Aktion auslösen darf |
Strukturierte Ausgaben vereinfachen die Integration. Ein gültiges Label kann trotzdem falsch sein. Ebenso beseitigt eine offene Lizenz keine Hostingkosten, und ein Benchmark auf einer bestimmten GPU bestimmt nicht die Antwortzeit Ihrer Anwendung.
Die drei Entscheidungstypen verstehen
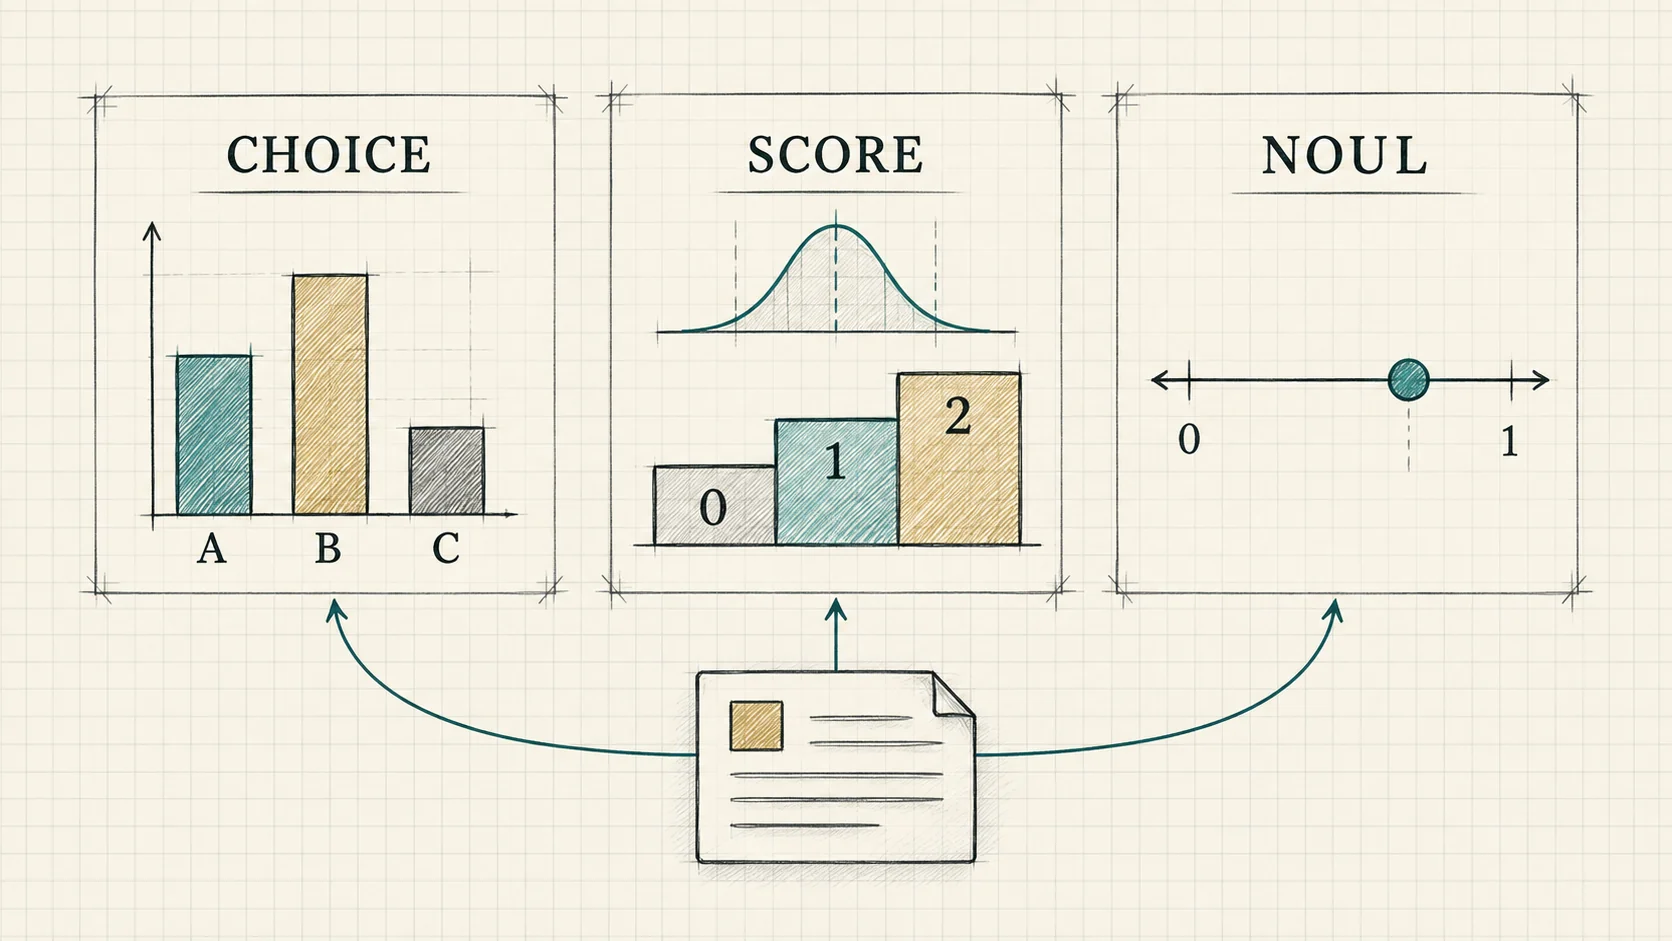
Choice: ein benanntes Ergebnis auswählen
Verwenden Sie choice für klar verständliche Kategorien wie billing, technical und other. Das Feld choice in der Antwort benennt das ausgewählte Label; zusätzlich können Wahrscheinlichkeitsfelder verfügbar sein. Beschreiben Sie die Kategorien so, dass Menschen dieselben Regeln konsistent anwenden könnten.
„Doppelt abgebucht“ gehört beispielsweise zur Abrechnung, „Checkout stürzt ab“ zum technischen Support. Enthält eine Nachricht beide Probleme, legen Sie fest, welches das Routing bestimmen soll. Das Label other steht für Ihre definierte Auffangkategorie. Es bedeutet nicht automatisch, dass das Modell Unsicherheit erkannt hat.
Score: auf einer geordneten Skala bewerten
Verwenden Sie score, wenn die Reihenfolge wichtig ist. Eine sinnvolle Dringlichkeitsskala kann zwischen Routinefragen, blockierter Arbeit mit einer Übergangslösung und einem Dienstausfall ohne Übergangslösung unterscheiden. Die gehostete Schnittstelle verwendet eine bei null beginnende Skala; das Ergebnis kann Nachkommastellen enthalten.
Auf einer dreistufigen Skala liegt 1.8 zwischen der zweiten und dritten Stufe. Der Wert bedeutet nicht, dass mit 80 % Wahrscheinlichkeit ein Ausfall vorliegt. Legen Sie fest, wie Ihre Anwendung Zwischenwerte behandelt. Messen Sie gravierende Unterschätzungen der Priorität getrennt von unkritischen Abweichungen zwischen benachbarten Stufen.
Noul: eine konkrete Aussage einschätzen
Verwenden Sie noul für eine gezielte Ja-Nein-Frage, etwa ob der Kunde ausdrücklich eine Erstattung verlangt. Der Wert ist eine Wahrscheinlichkeitsschätzung, kein boolescher Wert. Wandeln Sie ihn niemals mit JavaScripts Boolean(value) um: Schon eine kleine positive Zahl wird zu true.
Trennen Sie erkannte Absicht und Berechtigung. „Eine Erstattung wird verlangt“ beweist weder eine doppelte Zahlung noch die Zulässigkeit einer Erstattung. Diese Prüfungen gehören zu verifizierten Datensätzen und den Regeln Ihrer Anwendung.
Ein Laya-Modell für Ihren Anwendungsfall wählen
Die Laya-Modellübersicht stellt die Modellfamilie und ihre Entscheidungsschnittstelle vor. Im ursprünglichen Projekt stehen vor allem ein englischer Checkpoint, ein mehrsprachiger Checkpoint und ein auf bestimmte typisierte Entscheidungsabläufe feinabgestimmter Checkpoint zur Auswahl.
| Kandidat | Sinnvoller Ausgangspunkt | Schwerpunkt der Bewertung |
|---|---|---|
| Englisch | Überwiegend englische Eingaben | Fachvokabular und mehrdeutige Labels |
| Mehrsprachig | Nichtenglische oder gemischtsprachige Eingaben | Ergebnisse für jede tatsächlich vorkommende unterstützte Sprache |
| Typed-decisions | Abläufe, die seiner Spezialisierung ähneln | Übertragbarkeit auf eigene Labels, Regeln und Dokumente |
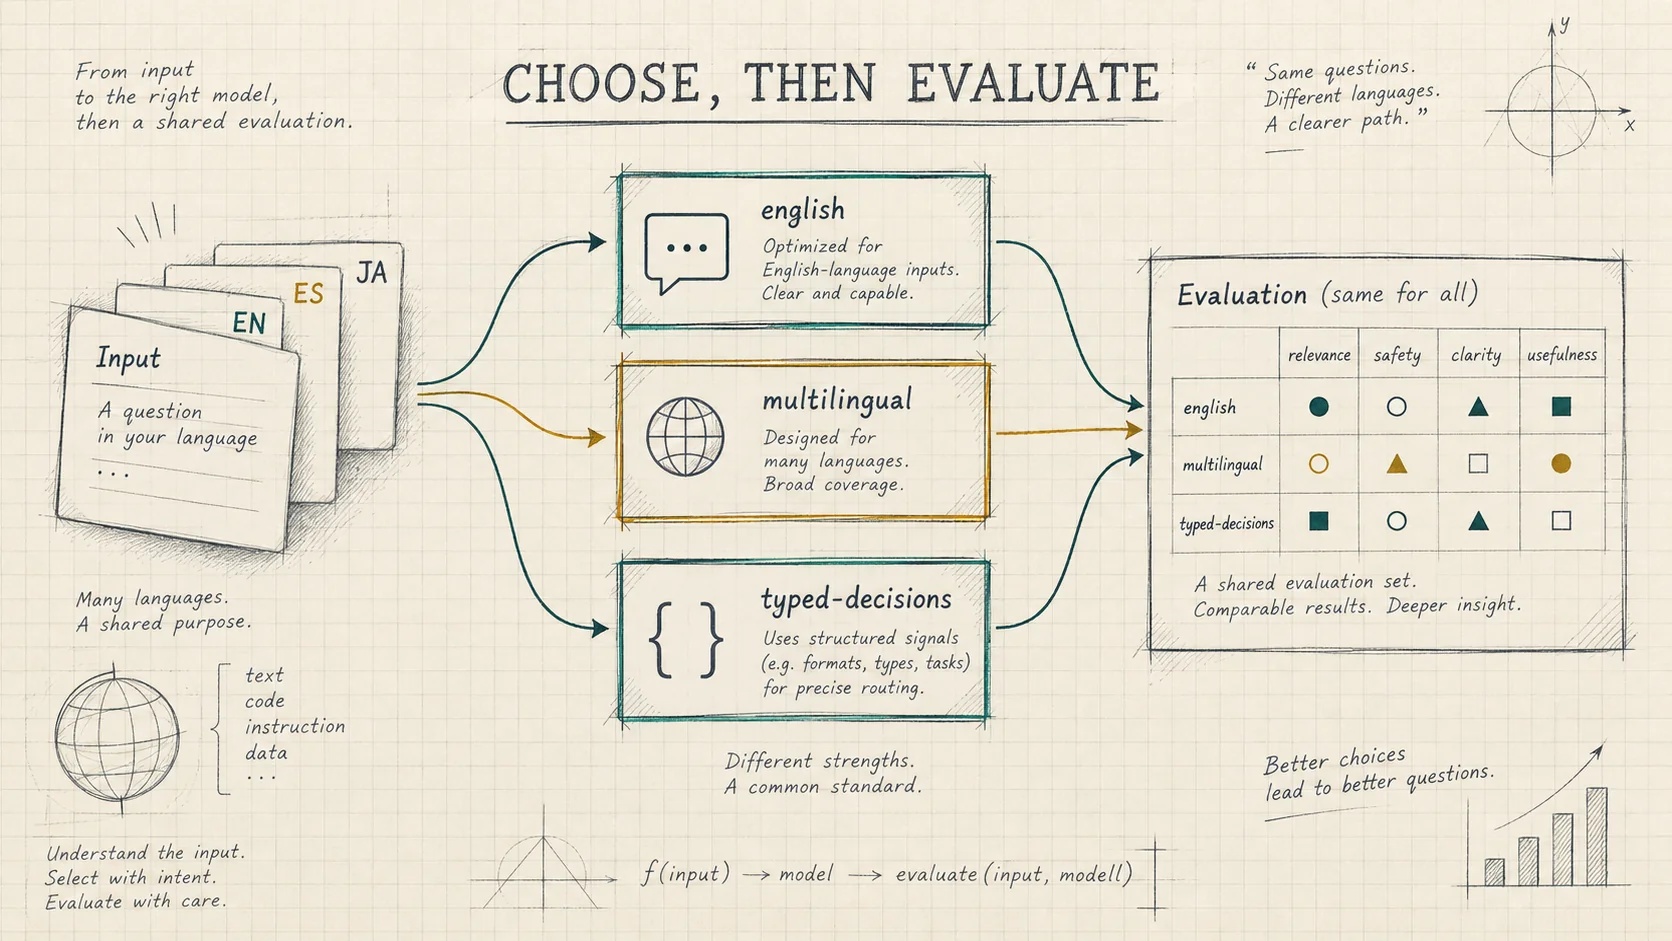
Die gehostete API akzeptiert english, multilingual und typed-decisions als Anfragekennungen. Diese Kennungen gehören zum öffentlichen Schnittstellenvertrag und sind kein Nachweis für einen festgelegten Checkpoint. Die aktuelle Projektimplementierung verwendet einen Provider-Adapter. Bestätigen Sie das tatsächlich bereitgestellte Modell und seine Revision, bevor Sie gehostete Antworten als Beleg für die Fähigkeiten eines bestimmten Checkpoints mit offenen Gewichten verwenden.
Für reproduzierbare Modellvergleiche führen Sie festgelegte Checkpoints unter denselben Bedingungen aus. Dokumentieren Sie Paketversion, Modellrevision, Gerät, Frageformulierungen und Kontexteinstellungen. Gehen Sie nicht davon aus, dass der gehostete Dienst sämtliche Einstellungen des lokalen SDK bereitstellt.
Auch die Sprachabdeckung muss praktisch geprüft werden. Eine breite Abdeckung bedeutet nicht dieselbe Genauigkeit für alle Sprachen, Slang, Transliteration oder gemischtsprachige Tickets. Werten Sie diese Bedingungen getrennt aus, statt nur einen Gesamtdurchschnitt zu melden.
Enthält Ihre Taxonomie Dutzende beinahe identischer Labels, testen Sie einen zweistufigen Ansatz: zuerst eine Hauptkategorie, danach eine spezialisierte Warteschlange innerhalb dieser Kategorie. So lassen sich Labels klarer beschreiben. Allerdings kann bereits die erste Stufe einen Vorgang in den falschen Zweig schicken. Vergleichen Sie den vollständigen Ablauf mit einer einstufigen Baseline, einschließlich zusätzlicher Latenz und der Möglichkeit, eine falsche erste Auswahl zu korrigieren.
Die Entscheidung vor dem API-Aufruf entwerfen
Beginnen Sie mit einer Entscheidungsspezifikation, die Eingabebelege, erlaubte Ergebnisse und Konsequenzen benennt. Bei der Supporttriage kann das Modell eine Warteschlange und eine Dringlichkeit empfehlen. Wer Erstattungen auslösen oder Konten ändern darf, bestimmt weiterhin Ihr bestehendes Berechtigungssystem.
Erstellen Sie state aus dem kleinsten ausreichenden Kontext. Fügen Sie die aktuelle Kundennachricht und relevante bestätigte Fakten hinzu. Eine vollständige Gesprächshistorie ist unnötig, wenn nur die neueste Störungsmeldung zählt. Benötigt das Modell einen Kontostatus, geben Sie ihn ausdrücklich an, statt die Ableitung nicht verfügbarer Daten zu erwarten.
Formulieren Sie Fragen so, dass sie unabhängig ausgewertet werden können. Eine Prioritätsfrage sollte nicht davon abhängen, die Antwort einer Routingfrage aus derselben Anfrage zu lesen. Hängt eine Entscheidung tatsächlich von einer anderen ab, organisieren Sie getrennte Schritte im Anwendungscode.
Stellen Sie vor der Integration eine kleine Sammlung schwieriger Testfälle zusammen: ein eindeutiges Abrechnungsproblem, einen technischen Ausfall, eine gemischte Anfrage, eine irrelevante Nachricht, ein nichtenglisches Ticket und eine Nachricht mit fehlenden Belegen. Ergänzen Sie Verneinungen wie „Ich verlange keine Erstattung“. Solche Fälle decken unklare Kriterien schnell auf, die eine Demonstration mit einfachen Erfolgsfällen verbergen kann.
Die erste Anfrage an die Laya API senden
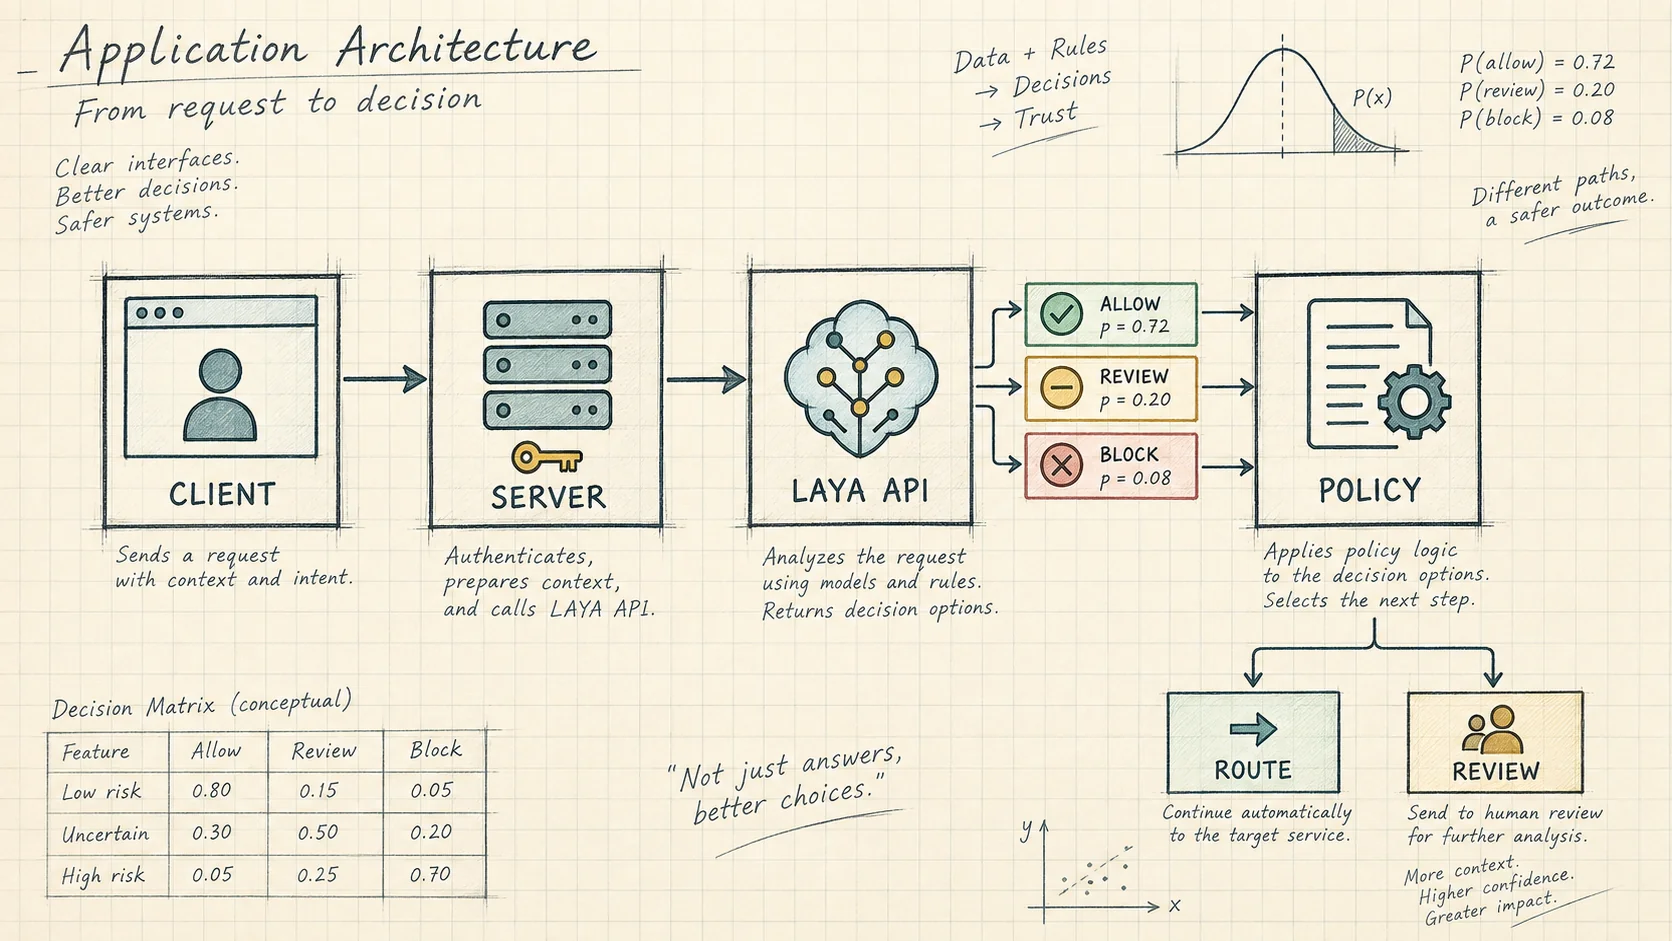
Die Dokumentation zur Laya-API-Integration beschreibt den Endpunkt der Website, die Authentifizierung und die äußere Antwortstruktur. Erstellen Sie einen API-Schlüssel für Ihr Konto, halten Sie ausreichend Guthaben vor und speichern Sie den Schlüssel serverseitig in der Umgebungsvariablen LAYA_API_KEY.
Senden Sie eine POST-Anfrage an https://thejevai.com/laya/v1/systemone mit Bearer-Authentifizierung und JSON. Der Pfad hat kein Sprachpräfix. Verwenden Sie einen Backend-Prozess, damit der Schlüssel niemals im Browser-Bundle landet.
Speichern Sie dieses Beispiel als laya-triage.mjs und führen Sie es nach dem Setzen der Umgebungsvariablen mit Node.js 18 oder neuer aus. Es sendet genau eine Anfrage und wiederholt potenziell kostenpflichtige Vorgänge nicht automatisch. Die englischen Beispieleingaben bleiben auf das Modell english abgestimmt.
const apiKey = process.env.LAYA_API_KEY;
if (!apiKey) throw new Error('Set LAYA_API_KEY on the server.');

const payload = {
  model: 'english',
  state: {
    message: 'Checkout crashes for every customer. Nobody can pay.',
    verified_status: 'No workaround has been confirmed.',
  },
  questions: {
    department: {
      type: 'choice',
      instructions: 'Which team owns the reported problem?',
      criteria: {
        billing: 'Charges, invoices, or refund requests',
        technical: 'Software failures or unavailable services',
        other: 'Issues outside billing and technical support',
      },
    },
    urgency: {
      type: 'score',
      instructions: 'Assess urgency using only the supplied evidence.',
      criteria: [
        'Routine question; work is not blocked',
        'Work is blocked but a workaround is confirmed',
        'Service is unavailable and no workaround is confirmed',
      ],
    },
    refund_requested: {
      type: 'noul',
      instructions: 'Does the customer explicitly request a refund?',
    },
  },
};

const response = await fetch('https://thejevai.com/laya/v1/systemone', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${apiKey}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify(payload),
  signal: AbortSignal.timeout(45_000),
});

const body = await response.json();
if (!response.ok || body.code !== 0) {
  throw new Error(`Laya request failed: HTTP ${response.status}`);
}

const answers = body.data?.result?.answers;
const department = answers?.department;
const urgency = answers?.urgency;
const refund = answers?.refund_requested;
if (
  department?.type !== 'choice' ||
  !['billing', 'technical', 'other'].includes(department.choice) ||
  urgency?.type !== 'score' ||
  !Number.isFinite(urgency.score) ||
  urgency.score < 0 ||
  urgency.score > 2 ||
  refund?.type !== 'noul' ||
  !Number.isFinite(refund.noul) ||
  refund.noul < 0 ||
  refund.noul > 1
) {
  throw new Error('Unexpected decision output; send this case for review.');
}

console.log({ answers, creditsUsed: body.data.creditsUsed });
Lesen Sie Antworten aus data.result.answers, jeweils über die von Ihnen angegebenen Frage-IDs. Prüfen Sie sowohl den HTTP-Erfolg als auch code === 0. Validieren Sie zurückgegebene Typen, Labels und Zahlenbereiche vor der Verwendung. Das Beispiel gibt Ergebnisse aus; die Übergabe fehlerhafter Fälle an eine Prüfwarteschlange ist Aufgabe Ihrer Anwendung.
Die Antwort enthält unter data.result außerdem Tokenverbrauch und Bearbeitungszeit sowie unter data.creditsUsed die tatsächlich abgezogenen Credits. Zeit und Kosten einer Beispielantwort sind keine Zusage für spätere Anfragen. Erfassen Sie die Ende-zu-Ende-Latenz des Clients getrennt von der serverseitig gemeldeten Dauer.
Grenzen, Fehler und Guthaben behandeln
Zum Zeitpunkt der Prüfung akzeptiert dieser gehostete Endpunkt einen UTF-8-JSON-Body von höchstens 32 KiB und eine bis acht Fragen. Eine Choice-Frage erlaubt 2–100 Optionen, eine Score-Frage 2–10 geordnete Beschreibungen. Für angemeldete Aufrufe im Playground gilt ein Mindestabstand von drei Sekunden. Diese Playground-Regel darf nicht als allgemeines Ratenlimit für API-Schlüssel dargestellt werden.
Die Inferenzanfrage hat ein Timeout von 30 Sekunden. Ihr Client benötigt zusätzliche Zeit für Transport und vollständige Antwort. Ein längeres Client-Timeout verlängert jedoch nicht das Inferenzlimit des Dienstes.
| HTTP-Status | Bedeutung | Passender nächster Schritt |
|---|---|---|
| 400 | Ungültige Anfrage | Felder oder Kriterien korrigieren |
| 401 | Authentifizierung fehlgeschlagen | Serverseitigen Schlüssel prüfen |
| 402 | Guthaben reicht nicht aus | Ausreichendes Guthaben bereitstellen |
| 413 | Anfrage zu groß | Kontext verkürzen oder Aufgabe aufteilen |
| 429 | Anfragen folgen zu schnell aufeinander | Retry-After beachten, falls vorhanden |
| 502 | Inferenz fehlgeschlagen oder ungültige Daten geliefert | Fehler prüfen, bevor Sie über eine Wiederholung entscheiden |
| 503 | Dienst nicht verfügbar | Rückfalllösung verwenden oder später versuchen |
Für den Endpunkt ist kein Idempotenzschlüssel dokumentiert. Nach einem Client-Timeout kann die erste Anfrage trotzdem abgeschlossen und berechnet werden. Ungeprüfte Wiederholungen können daher doppelte Arbeit und Kosten verursachen. Bewahren Sie den lokalen Auftragszustand auf, gleichen Sie das Ergebnis nach Möglichkeit ab und entscheiden Sie ausdrücklich über Wiederholungen.
Trennen Sie außerdem Anfragegröße und Modellkontext. Das Einhalten der HTTP-Grenze von 32 KiB beweist nicht, dass jeder Satz und jede Option in das Tokenbudget eines Checkpoints passt. Testen Sie lange Eingaben und große Labelmengen gezielt.
Entscheidungen vor der Automatisierung bewerten
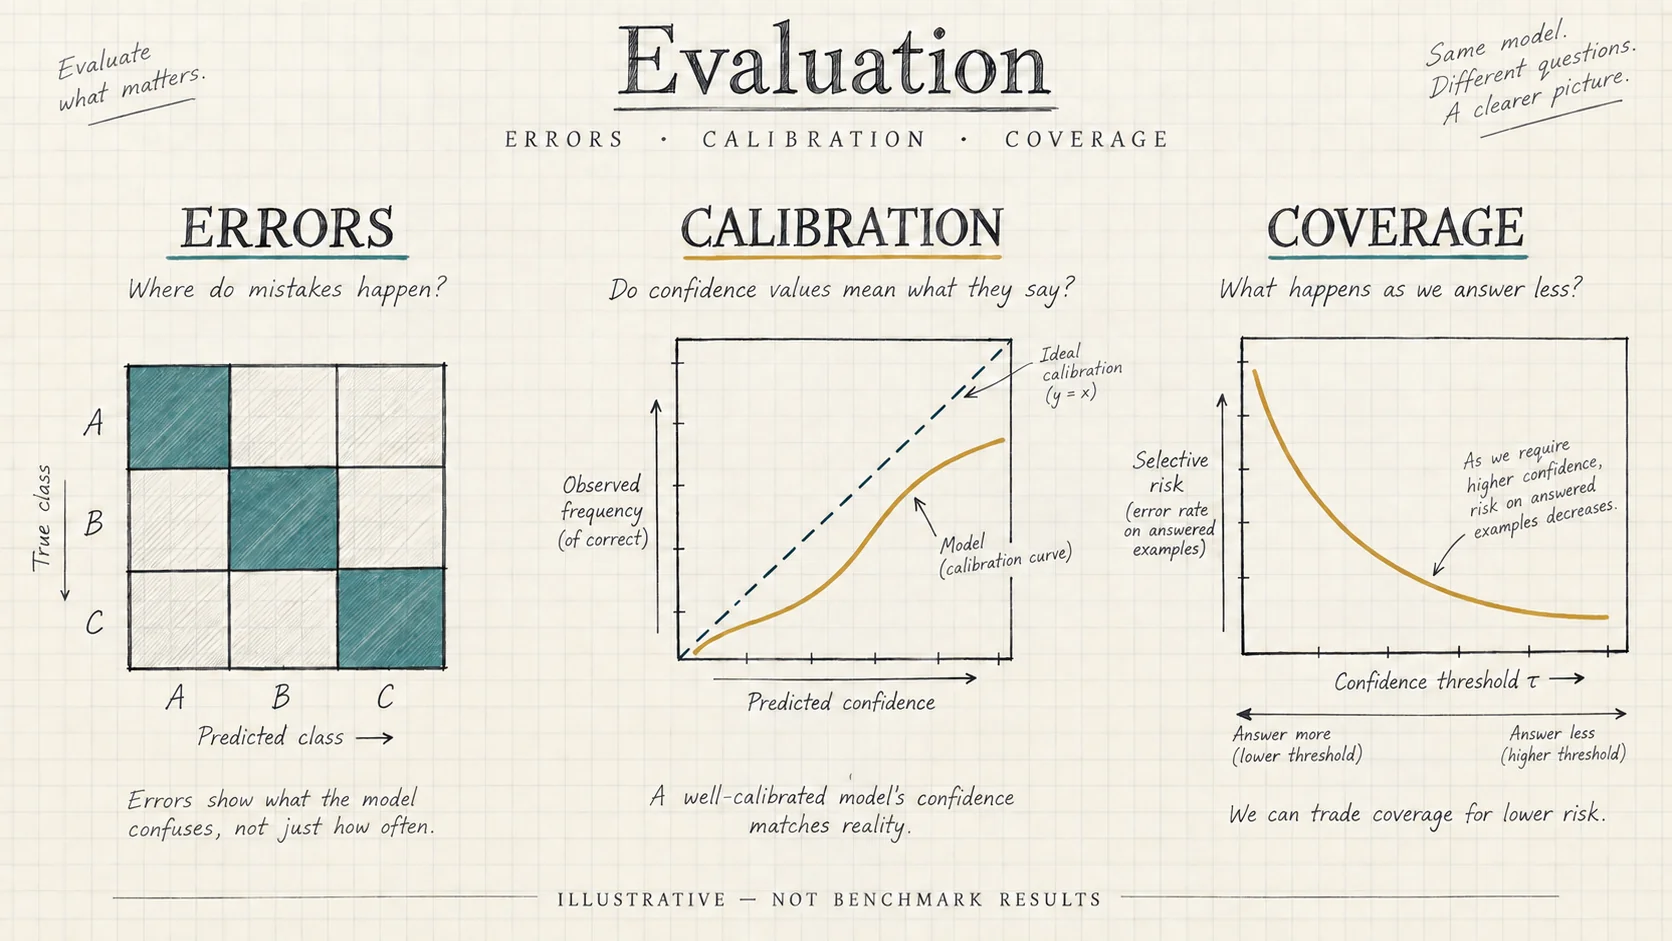
Erstellen Sie einen Evaluationsdatensatz aus echten, angemessen aufbereiteten Beispielen Ihres Ablaufs. Halten Sie Daten zur Schwellenwertanpassung vom abschließenden Testdatensatz getrennt. Ordnen Sie verwandte Nachrichten derselben Teilmenge zu, damit nahezu identische Tickets nicht zwischen Training, Validierung und Test gelangen.
Bewerten Sie jede Ausgabe nach ihren Folgen. Untersuchen Sie für Routing eine Konfusionsmatrix sowie Precision und Recall je Klasse. Erfassen Sie für Dringlichkeit neben dem durchschnittlichen Fehler auch schwere Unterschätzungen. Testen Sie bei der Erkennung von Erstattungswünschen ausdrückliche Bitten, Verneinungen, hypothetische Diskussionen und zitierte Nachrichten.
Die Kalibrierung verdient eine eigene Prüfung. Gruppieren Sie Vorhersagen mit ähnlichen Wahrscheinlichkeiten und vergleichen Sie sie mit den beobachteten Häufigkeiten. Sind Vorhersagen um 0.8 nur in der Hälfte der Fälle richtig, verhält sich ein darauf basierender Schwellenwert anders, als sein Zahlenwert vermuten lässt. Jede Kalibrierungsanpassung muss ohne den abschließenden Testdatensatz bestimmt werden.
Die ursprüngliche Modellkarte nennt wichtige Grenzen, darunter übermäßige Sicherheit und Empfindlichkeit gegenüber dem Tokenbudget für Labels. Sie beschreibt außerdem einen noul-Fehlermodus, bei dem Optionslabels die Eingabe überlagern können. Scheinen binäre Ausgaben festzuhängen, untersuchen Sie dies mit gegensätzlichen Beispielen und vergleichen Sie eine choice-Formulierung mit zwei Optionen. Setzen Sie die Wirksamkeit dieser Alternative nicht ohne Messung voraus.
Bewerten Sie Entscheidungsenthaltung als Abwägung. Abdeckung bezeichnet den Anteil automatisch bearbeiteter Fälle; die selektive Fehlerrate ist die Fehlerquote innerhalb dieser Teilmenge. Höhere Schwellenwerte können die Automatisierung reduzieren und die Prüfwarteschlange vergrößern. Berichten Sie beide Werte zusammen mit dem Prüfaufwand, statt nur die Genauigkeit einer immer kleineren, leichteren Teilmenge hervorzuheben.
Verwenden Sie zusätzlich eine einfache Baseline. Eine deterministische Regel für einen eindeutigen Störungscode oder ein vorhandener Warteschlangenklassifikator kann manche Fälle bereits günstig lösen. Vergleichen Sie Laya anhand derselben Eingaben und Ergebnisdefinitionen mit dieser Baseline. Führen Sie ein kurzes Fehlerprotokoll mit typischen Fehlschlägen und ihren Ursachen. Ändern Sie jeweils nur einen Faktor: die Frage, die bereitgestellten Belege, den Checkpoint oder den Schwellenwert. Das macht Verbesserungen nachvollziehbar und mindert den Anreiz, eine Demonstration lediglich überzeugend aussehen zu lassen.
Einen nützlichen Ablauf schrittweise einführen
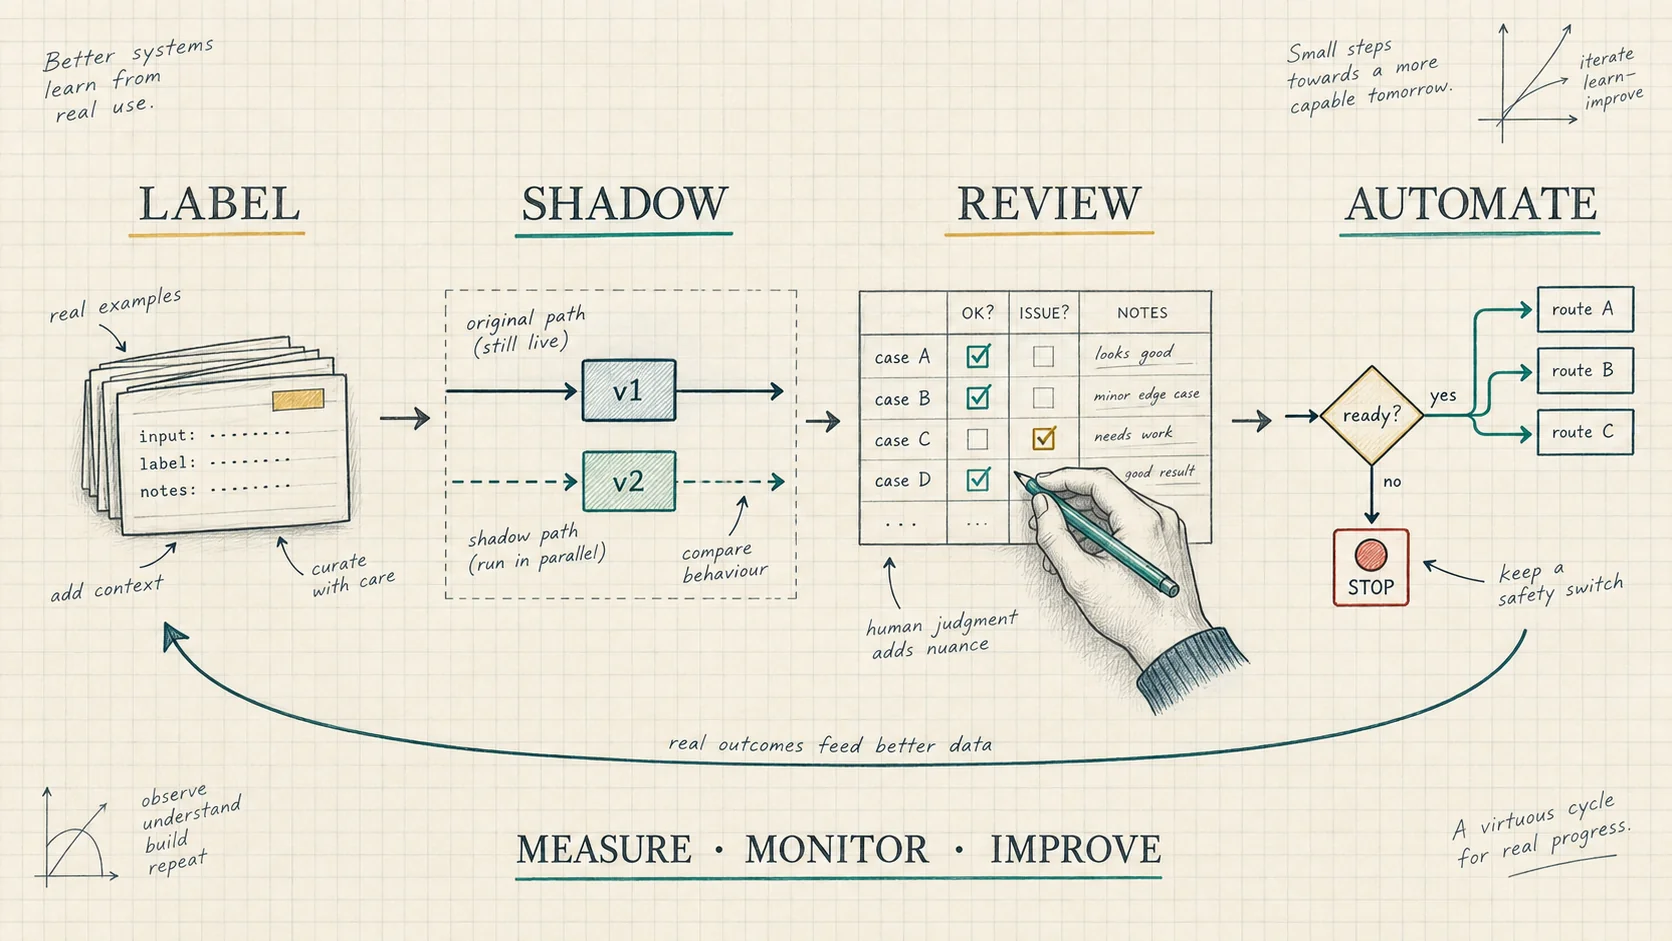
Beginnen Sie im Schattenmodus: Speichern Sie Empfehlungen, während der bestehende Ablauf weiterhin die tatsächlichen Ergebnisse bestimmt. Vergleichen Sie Entscheidungen mit menschlichen Bearbeitungsergebnissen und untersuchen Sie Gruppen wiederkehrender Abweichungen. Wiederholte Fehler können auf unklare Labels, fehlenden Kontext, eine unpassende Sprache oder ein ungeeignetes Modell hindeuten.
Lassen Sie Mitarbeiter anschließend Empfehlungen vor der Ausführung prüfen. Dadurch erkennen Sie den Prüfaufwand, die Verständlichkeit der Bewertungen und ob das vorgeschlagene Routing tatsächlich Zeit spart. Automatisieren Sie eine eng begrenzte, umkehrbare Aktion erst, wenn gemessene Fehlerquote und betrieblicher Nutzen dies rechtfertigen.
Definieren Sie für einen Supportpilot vor dem Start, was Erfolg bedeutet: akzeptable Fehlleitungen, die Höchstzahl übersehener dringender Fälle, Prüfkapazität und eine Rückfalllösung bei Dienstausfällen. Halten Sie einen einfachen Schalter bereit, der zum bisherigen Routing zurückkehrt. Prüfer sollten Labels korrigieren können, ohne dabei unbemerkt die zugrunde liegenden Regeln zu ändern. Diese Korrekturen sollten in den nächsten Evaluationsdatensatz einfließen.
Protokollieren Sie genügend Metadaten zur Reproduktion von Fehlern: Ihre Anfragekennung, Schemaversion, angefragte Modellkennung, verfügbare Angaben zur bereitgestellten Version, Latenz, Kosten und tatsächliches Ergebnis. Speichern Sie möglichst wenig Kundeninhalt. Verfolgen Sie Änderungen der Eingabesprache, Labelhäufigkeit und Prüfmenge, da sie eine Drift früher als eine globale Genauigkeitskennzahl sichtbar machen können.
Vergleichen Sie die Wirtschaftlichkeit des gesamten Ablaufs. Guthaben für gehostete Aufrufe, Rechenleistung beim Eigenbetrieb, technische Wartung, manuelle Prüfung und falsche Aktionen tragen zu den Kosten bei. Weitere Hinweise zu Bereitstellungsentscheidungen bietet der Vergleich Jev gegen Laya. Wählen Sie die Lösung, die unter Ihren beobachteten Bedingungen und betrieblichen Einschränkungen gut funktioniert.
Häufige Fragen zu Laya AI, Modell und API
Ist Laya AI ein Chatbot?
Sein Kernzweck sind klar begrenzte Entscheidungen. Nutzen Sie es zum Auswählen, Bewerten oder Klassifizieren. Für frei formulierte Texte eignet sich ein generatives Modell. Eine Anwendung kann beides kombinieren.
Ist das Laya-Modell kostenlos?
Die veröffentlichten Gewichte stehen unter Apache-2.0. Der Betrieb benötigt weiterhin Rechenleistung und organisatorischen Aufwand. Der hier beschriebene gehostete Dienst verbraucht Kontoguthaben. Offene Gewichte bedeuten deshalb keine kostenlosen gehosteten Anfragen.
Wählt die Laya API automatisch einen Checkpoint?
Die API dieser Website verlangt eine ausdrückliche Modellkennung. Das ursprüngliche lokale SDK besitzt einen Router. Dessen Routingverhalten und Optionen dürfen Sie jedoch nicht für jeden gehosteten Dienst voraussetzen.
Können Laya-Wahrscheinlichkeiten eine Aktion autorisieren?
Eine Wahrscheinlichkeit kann eine Regelentscheidung unterstützen, aber weder Berechtigungen erteilen noch Fakten prüfen, die in der Eingabe fehlen. Aktionen mit relevanten Folgen sollten durch Anwendungsprüfungen und einen geeigneten Prüfprozess abgesichert sein.
Sollte ich mit lokaler Inferenz oder der gehosteten API beginnen?
Verwenden Sie die gehostete Schnittstelle, um Anfrageformat und Ablauf zu erkunden. Nutzen Sie lokale Inferenz mit festgelegter Version für checkpointbezogene Experimente oder die Kontrolle über Ihre Infrastruktur. Bewerten Sie beide Optionen anhand derselben repräsentativen Fälle.
Quellen und Pflege
Das ursprüngliche Laya-Repository dokumentiert Installation, Routing, Bereitstellung und Laufzeitoptionen. Die Modellkarte von Convai Innovations beschreibt Checkpoints, Architektur, Evaluationen und bekannte Grenzen. Die Details gehosteter Anfragen wurden am 28. September 2026 anhand der beiden oben verlinkten Website-Leitfäden und der Endpunktimplementierung dieses Projekts geprüft.
Prüfen Sie vor der Bereitstellung Backend, Grenzen und Modellrevision erneut. Beginnen Sie mit einer wichtigen Entscheidung, messen Sie sie an echten Beispielen und erweitern Sie die Automatisierung, wenn die Ergebnisse dies rechtfertigen.