開発者ガイド
Cloudflare Clef の使い方:実践 API チュートリアル
REST と Workers AI を使った Cloudflare Clef の利用方法を解説。型付きの判断スキーマ、信頼度のしきい値、画像入力、料金、導入時の確認事項を学べます。
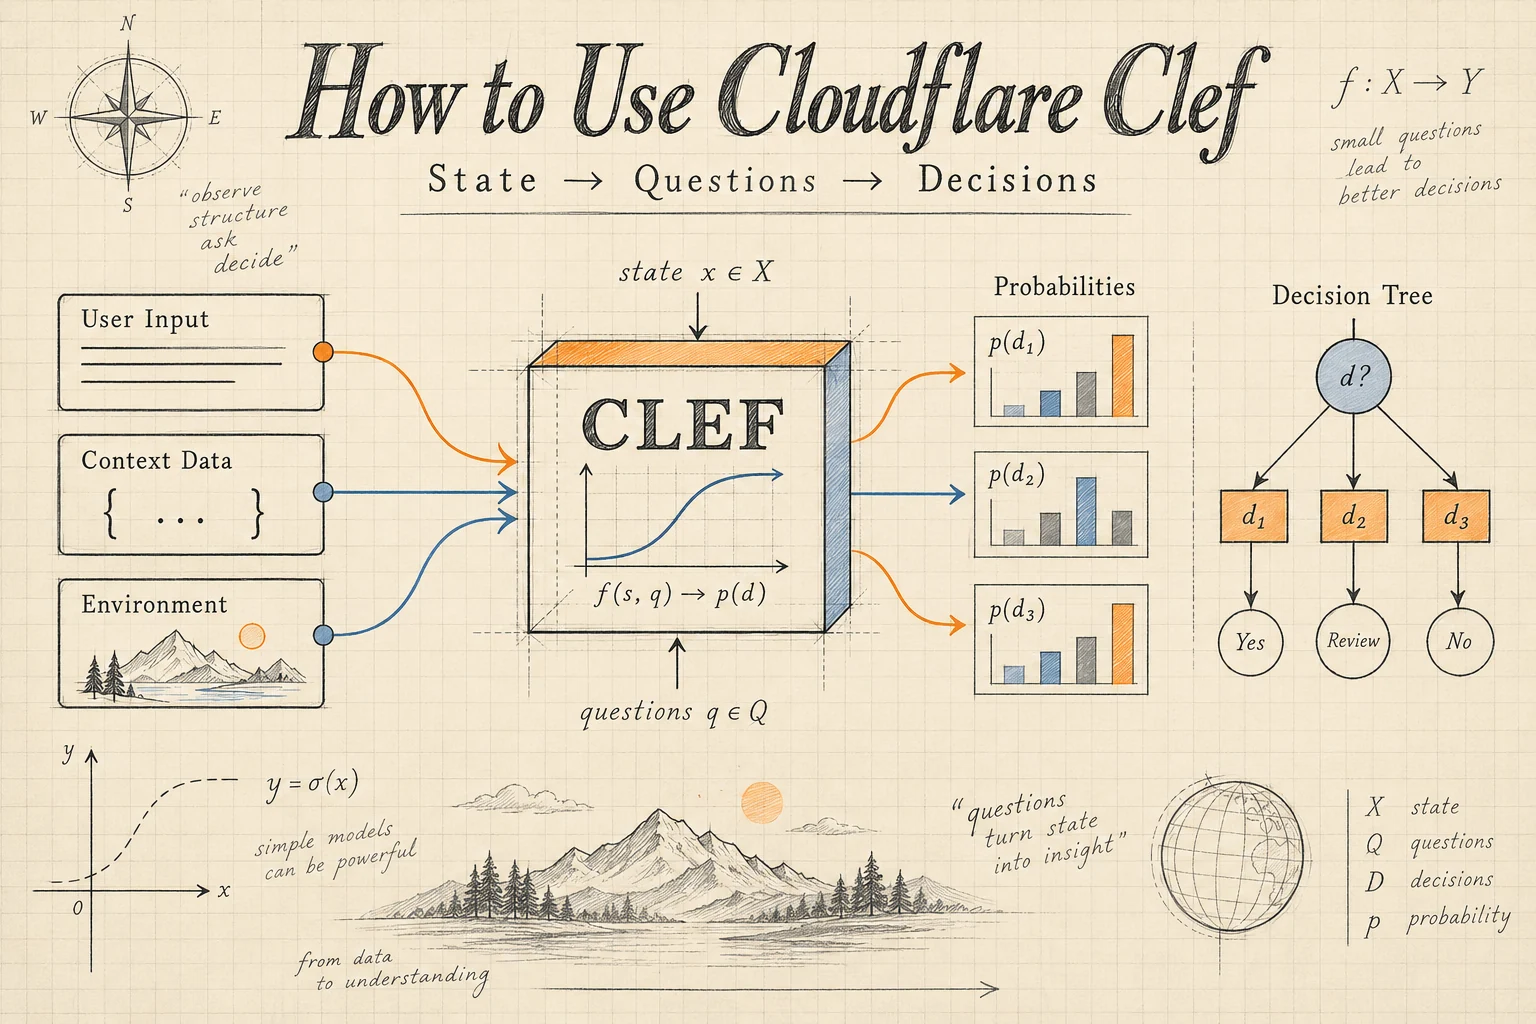
Cloudflare Clef を使うには、アプリケーションの判断材料を state に入れ、questions に型付きの質問を定義し、Workers AI 経由で @cf/cloudflare/clef を呼び出します。返された確率を読み取り、独自のルールに基づいて実行するアクションを選びます。 最初は REST を使い、同じ判断用ペイロードを後から Cloudflare Worker に移せます。
Clef は 270 億パラメータのマルチモーダル判断モデルです。チケットをどのキューに振り分けるか、証拠が障害を示しているか、中断の影響がどれほど大きいかなど、あらかじめ定めた選択肢についてソフトウェアが判断する場面に適しています。ホスト型インターフェースは公式モデルリファレンスで説明されています。
このチュートリアルでは、サポートチケットの振り分けを例に、スキーマ設計から本番導入までを解説します。ドキュメントと料金の確認日は 2026 年 10 月 3 日です。コード例は公開されたインターフェース仕様と照合済みですが、実際の推論アカウントでは実行していません。確率の例はすべて説明用の仮想データです。
目次
- モデル化する価値のある判断を選ぶ
- 状態と質問のスキーマを作る
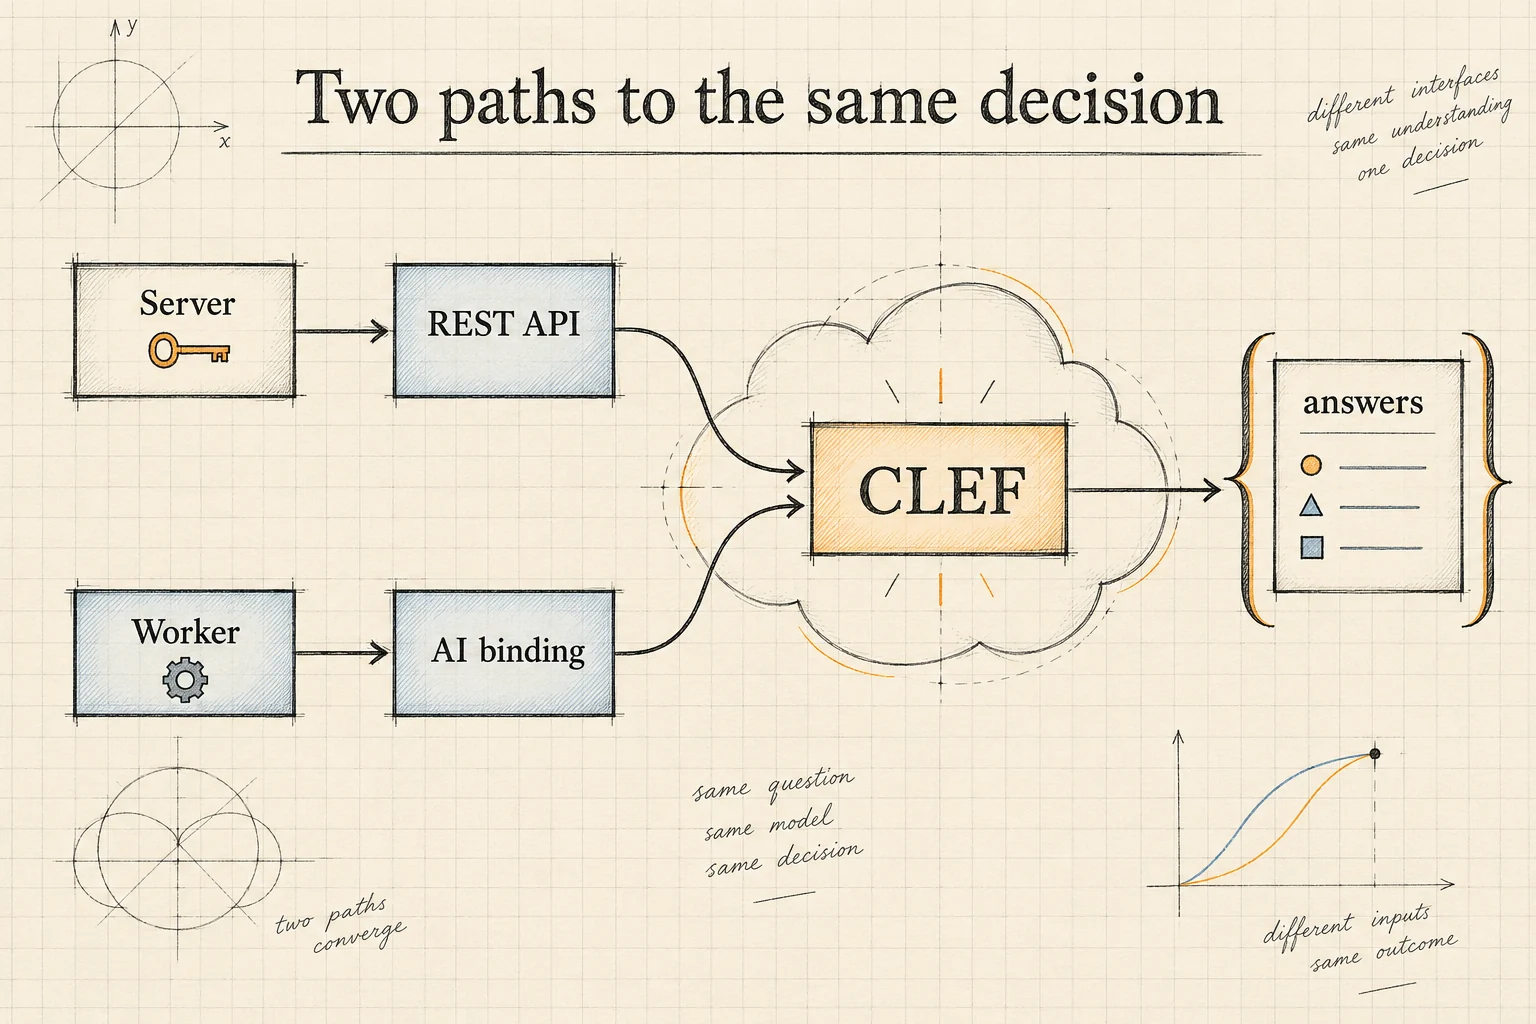
- Cloudflare Clef REST API を呼び出す
- レスポンスを正しく読み取る
- Cloudflare Worker 内で Clef を使う
- 自分のデータに基づいてしきい値を決める
- 画像の追加とセルフホスティングを理解する
- Cloudflare Clef のコストを見積もる
- よくある連携ミスを修正する
- ワークフローを評価して導入する
- よくある質問
モデル化する価値のある判断を選ぶ
まず、担当が明確で、結果を測定できる小さなアクションを選びます。この例では、アプリケーションがサポートチケットを accounts、billing、review のいずれかに振り分けます。正しい結果とは、受け取ったチームが別のチームへ転送せずに問題を処理できることです。
プロンプトを書く前に、その定義を書き出しましょう。「顧客を理解する」では範囲が広すぎて評価できません。「主たる未解決の問題を担当するチームを特定する」なら、評価担当者に具体的な作業を示せます。
モデルが不要な判断もあります。保存済みのサブスクリプション状態で機能の利用権限が決まるなら、データベースを参照します。請求額が固定のしきい値を超えたかどうかなら、コードで数値を比較します。Clef は、単純なルールでは意味を安定して捉えられない判断材料の解釈に使いましょう。
選ばれた振り分け先と実行権限は分けます。billing という分類でチケットを請求担当キューに送ることはできますが、それだけで返金を承認してはいけません。この責任分担については、Cloudflare Clef の概要でさらに説明しています。
エージェントアプリケーションでは、モデルを選ぶ前に振り分け先を書き出します。判断の対象がサポートチームではなくツールや別のモデルである場合は、モデルとツールのルーティングワークフローも参考になります。
状態と質問のスキーマを作る
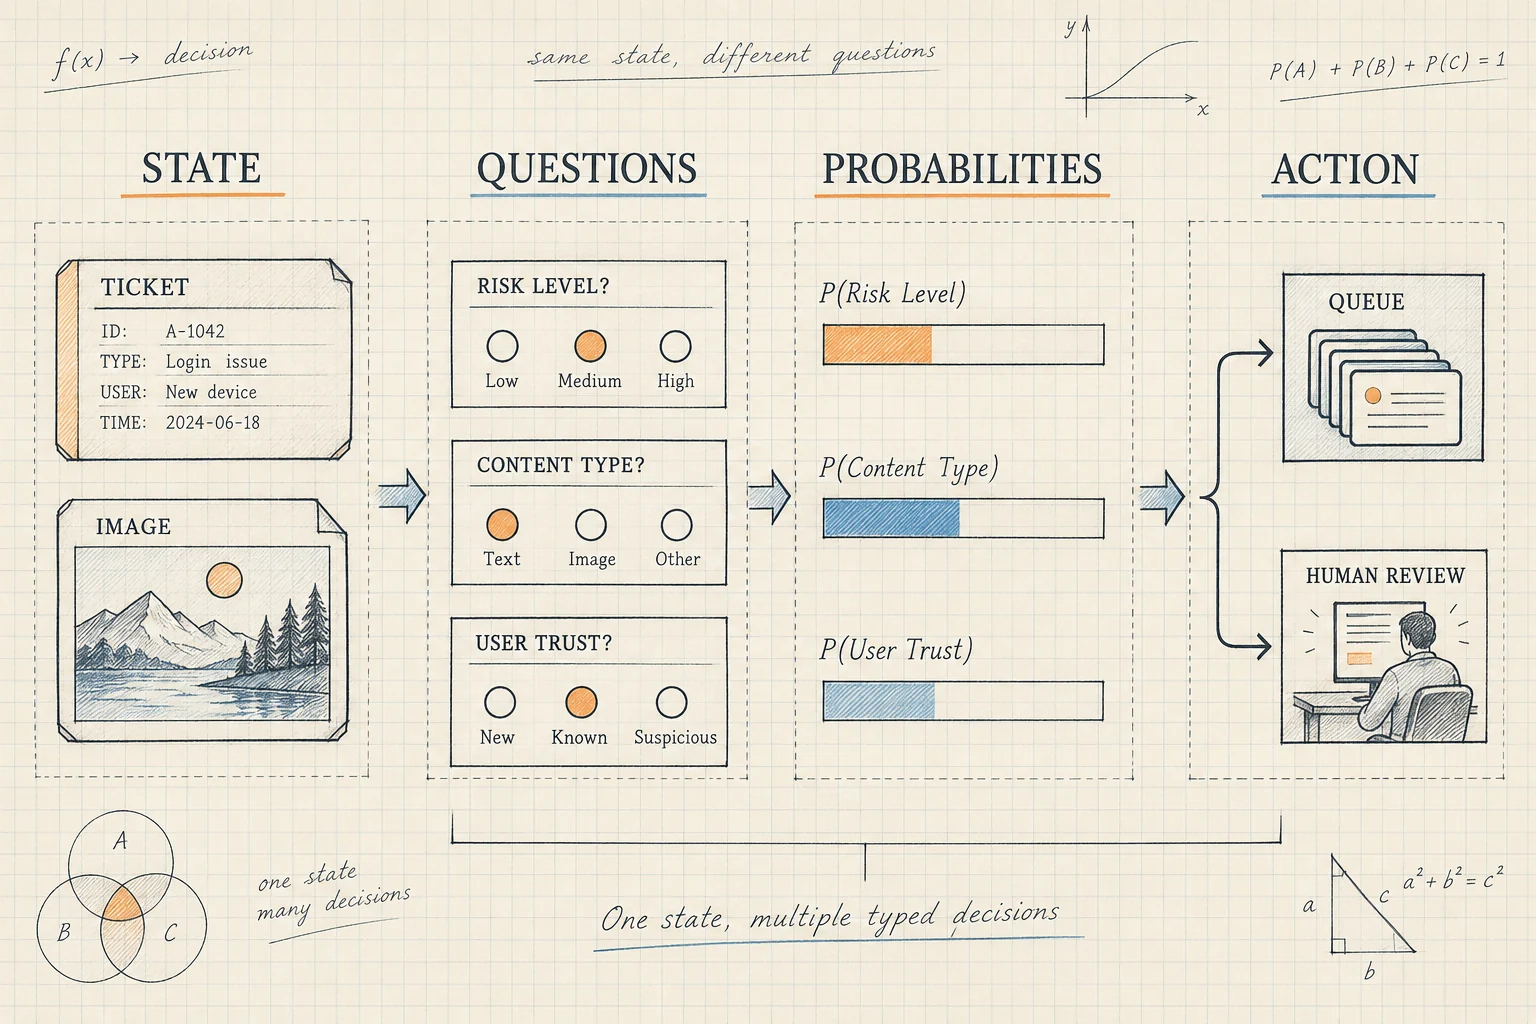
評価する材料は state に入れます。各質問の instructions と criteria で判断の基準を定義します。顧客が書いた文章を、信頼する評価基準の一部にしないでください。
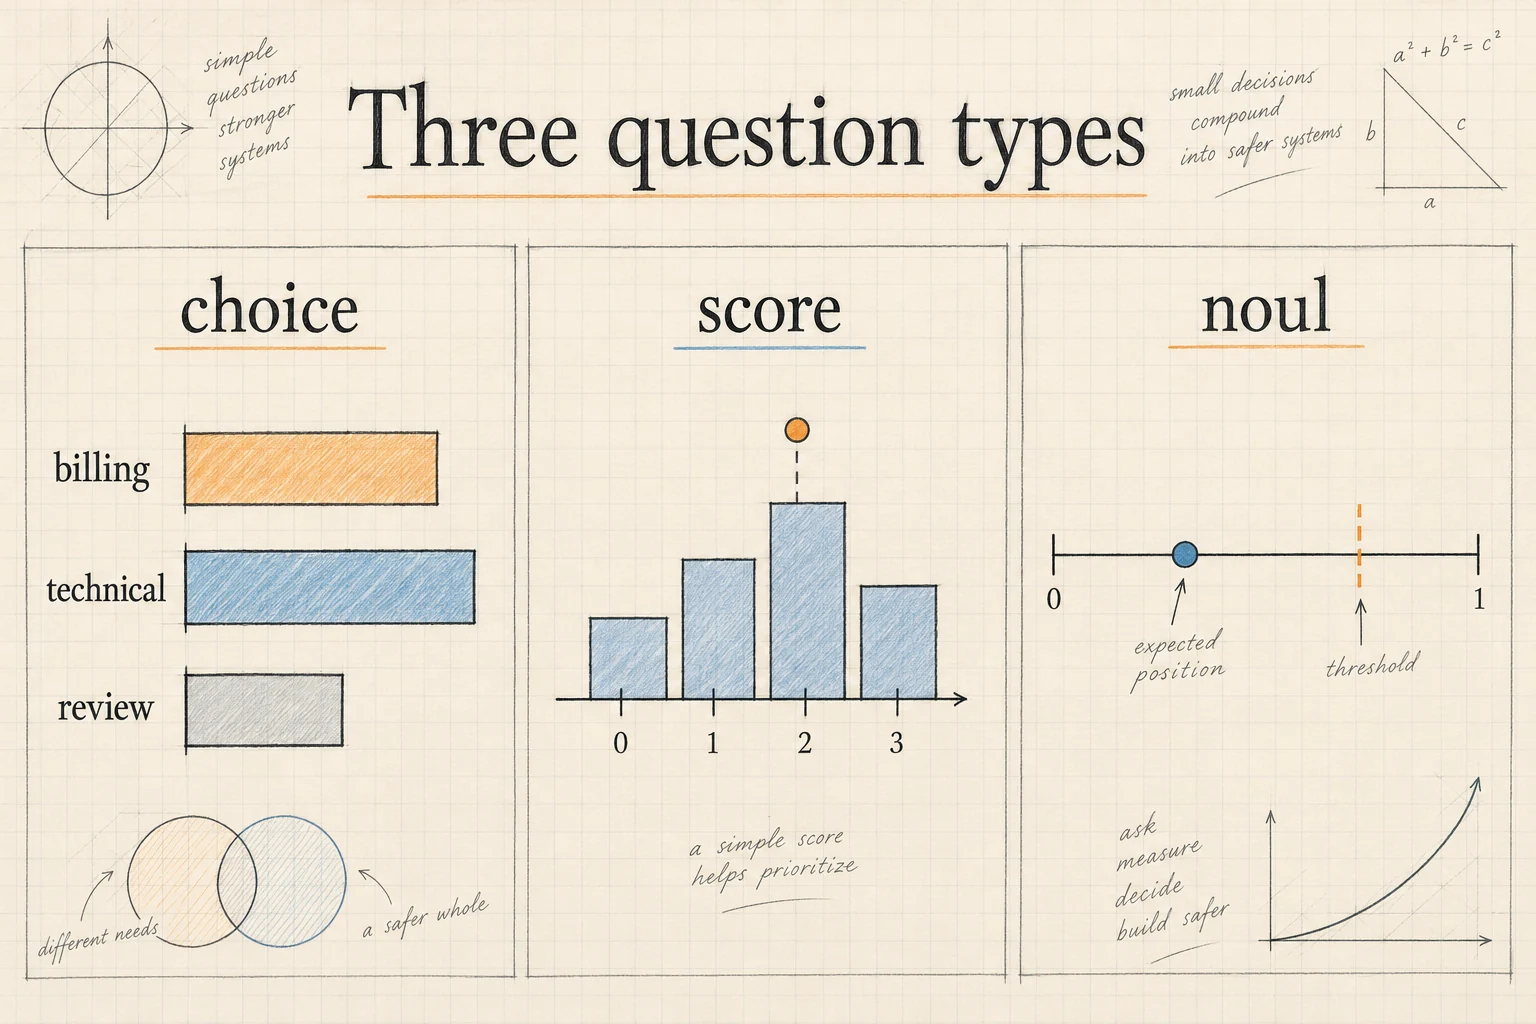
ホスト型 API の入力スキーマでは、model、state、questions が必須です。すべての質問に type と instructions が必要で、choice と score には criteria も必要です。
| 型 | 用途 | criteria の形式 |
|---|---|---|
choice |
名前の付いた振り分け先を選ぶ | 選択肢 ID と説明を対応付けるオブジェクト |
noul |
はい・いいえで答えられる命題を評価する | 任意の true と false の説明 |
score |
順序のある基準で影響を評価する | 低い順から高い順に並べた配列 |
選択肢の説明は区別できるようにします。「アカウントへのアクセス」と「支払いに関する異議」なら、担当範囲が異なります。「緊急の問題」と「技術的な問題」は重複します。緊急度と担当は別の軸だからです。二つの軸が必要なら、質問を二つに分けます。
証拠が足りない場合や分類に当てはまらない場合のため、review という振り分け先を意図的に用意します。これがないと、例外的なリクエストも通常の振り分け先のどれかを競うことになり、断定的に見える出力の裏に分類体系の欠陥が隠れてしまいます。
状態を構成するときは、関連する文脈を出所とともに明示します。顧客が「決済が使えない」と報告したことと、サービスのヘルスチェックで観測した結果は別の情報です。変化しやすい情報にはタイムスタンプを付け、不明な項目を明示し、取得できるからというだけで無関係な履歴を追加しないようにします。
スキーマのバージョンをアプリケーションと一緒に管理します。「重大な影響」の意味を変えれば、JSON のキーが同じでもタスクは変わります。スキーマのバージョンを明確にしておくと、後の比較を正しく解釈できます。
API に接続する前に、いくつかの反例を手作業で試しましょう。ある顧客はパスワードのリセットを求めながら支払いに言及し、別の顧客はサインインできるものの二重請求に異議を唱えるかもしれません。振り分けの定義は、これらのチケットを異なるチームが担当する理由を説明できる必要があります。基準だけを読んだ二人の評価担当者が一致できないなら、モデルに適用させる前に基準を改善しましょう。
Cloudflare Clef REST API を呼び出す
まず Cloudflare のアカウント ID と Workers AI API トークンを取得します。Cloudflare の REST セットアップガイドに、ダッシュボードのトークンテンプレートが説明されています。手動で作成するトークンには Workers AI の Read と Edit 権限が必要です。認証情報はローカル環境変数やサーバーのシークレットストアに保存します。
以下のオリジナル例を decision.json として保存します。一つのチケットについて、関連する三つの質問を投げかけます。
{
  "model": "clef",
  "state": {
    "ticket": "I paid yesterday, but password resets still do not let me sign in.",
    "paymentStatus": "settled",
    "serviceHealth": "unknown"
  },
  "questions": {
    "owner": {
      "type": "choice",
      "instructions": "Choose the team for the primary unresolved issue.",
      "criteria": {
        "accounts": "Sign-in, credentials, or account access",
        "billing": "Unresolved charges, refunds, or payment disputes",
        "review": "Missing evidence or no matching team"
      }
    },
    "accessBlocked": {
      "type": "noul",
      "instructions": "Does the customer report being unable to sign in?"
    },
    "impact": {
      "type": "score",
      "instructions": "Rate the disruption supported by this ticket.",
      "criteria": [
        "No current disruption",
        "Partial disruption with a workaround",
        "Customer cannot access the service"
      ]
    }
  }
}
CLOUDFLARE_ACCOUNT_ID と CLOUDFLARE_API_TOKEN を設定したら、このファイルを送信します。
curl --fail-with-body \
  "https://api.cloudflare.com/client/v4/accounts/${CLOUDFLARE_ACCOUNT_ID}/ai/run/@cf/cloudflare/clef" \
  -H "Authorization: Bearer ${CLOUDFLARE_API_TOKEN}" \
  -H "Content-Type: application/json" \
  --data-binary @decision.json
エンドポイントのモデルとペイロードのセレクターは、意図的に一致させています。@cf/cloudflare/clef と組み合わせるのは "model": "clef" です。認証やスキーマのエラーを切り分けやすくするため、まずはこの小さなリクエストから始めましょう。
最初のリクエストに成功したら、機密情報を取り除いたレスポンスを開発用の固定サンプルとして保存し、スキーマのバージョンも記録します。このサンプルがあれば、画面を修正するたびに有料の推論リクエストを送らなくても、レスポンス処理を確認できます。
本番の呼び出し元にはリクエストのタイムアウトを設け、推論の失敗と判断の不確実さを区別し、フォールバック先を定義します。一時的な障害は上限のある範囲で再試行します。再試行によって周辺アプリケーションが同じサポートチケットを重複作成しないようにしてください。
レスポンスを正しく読み取る
REST API は Cloudflare のレスポンスエンベロープを使います。HTTP ステータスと success を確認してから、result の下にあるモデル出力を読み取ります。Workers AI バインディングはモデル出力を直接返します。
Clef の出力スキーマによると、関連するパスは次のとおりです。
| 値 | REST レスポンスのパス | Worker バインディングのパス |
|---|---|---|
| 選ばれたチーム | result.answers.owner.choice |
answers.owner.choice |
| チームごとの確率 | result.answers.owner.probabilities |
answers.owner.probabilities |
| 報告されたアクセス不能の状態 | result.answers.accessBlocked.noul |
answers.accessBlocked.noul |
| 影響レベルの期待値 | result.answers.impact.score |
answers.impact.score |
| 入力使用量 | result.usage.input_tokens |
usage.input_tokens |
noul の回答は、数値の noul フィールドを含むオブジェクトであり、単独の真偽値ではありません。Choice と score の回答には confidence も含まれます。Score はレベルのインデックスを確率で加重平均した値なので、レベルとレベルの間の値になることがあります。
たとえば、レベル 0、1、2 に対して 0.10、0.20、0.70 という仮想的な影響分布を与えると、結果は 1.60 になります。これは重大度のラベルでも、リスクが 160% であるという推定でもありません。必要な運用上の意味に変換するのは、アプリケーションのポリシーです。
振り分ける前に、想定した質問 ID と回答の型を検証します。項目の欠落や形式不正は連携の失敗として扱い、通常の review 分類とは別のログ区分に記録します。この区別があれば、アプリケーションコードを直すべきか、判断設計を改善すべきかを見極めやすくなります。
Cloudflare Worker 内で Clef を使う
既存の Worker プロジェクトでは、Wrangler 設定に AI バインディングを追加します。
{
  "ai": {
    "binding": "AI"
  }
}
先ほどの decision.json を Worker のエントリーファイルと同じ場所にコピーします。以下の JavaScript 例は、その固定ペイロードをインポートし、推奨する振り分け先を返します。
import decisionInput from "./decision.json";

export default {
  async fetch(_request, env) {
    try {
      const result = await env.AI.run(
        "@cf/cloudflare/clef",
        decisionInput
      );
      const owner = result.answers?.owner;
      const allowed = ["accounts", "billing", "review"];
      const probability = owner?.probabilities?.[owner.choice];

      if (
        owner?.type !== "choice" ||
        !allowed.includes(owner.choice) ||
        typeof probability !== "number" ||
        probability < 0 || probability > 1
      ) {
        throw new Error("Unexpected owner answer");
      }

      // Illustrative threshold: replace after evaluation.
      const route = probability >= 0.85 ? owner.choice : "review";
      return Response.json({ route, probability });
    } catch {
      return Response.json(
        { route: "review", error: "Decision unavailable" },
        { status: 503 }
      );
    }
  }
};
Workers バインディングのガイドには、設定と npx wrangler dev を使うローカル開発の説明があります。ローカル開発中も Workers AI の推論には Cloudflare のリソースを使うため、料金が発生する場合があります。
この固定サンプルのエンドポイントは、バインディング、レスポンスへのアクセス、フォールバックを示しています。実際のチケットを連携するには、アプリケーションで使っている認証、入力検証、リクエスト制限が必要です。信頼する質問スキーマはサーバー側で作成し、無制限の推論プロキシを公開するのではなく、範囲を限定した入力形式でチケットの判断材料を受け取ります。
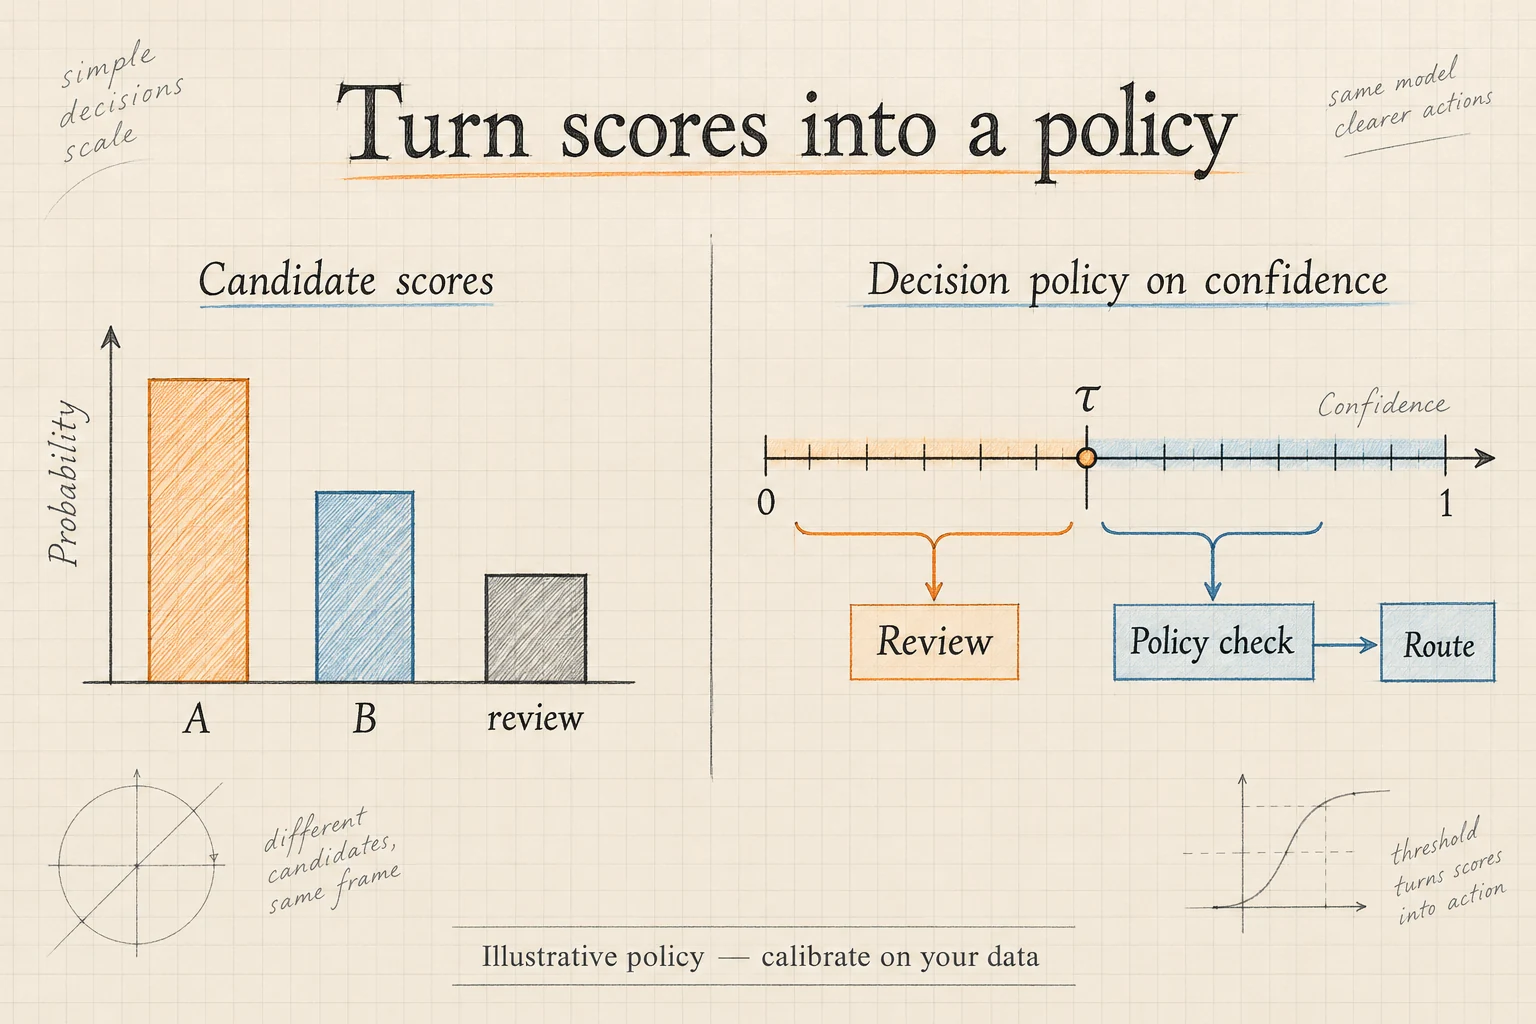
0.85 というしきい値は、ポリシーを置く場所を示すための例です。Clef のデフォルト値でも、実験で検証された推奨値でもありません。次の段階では、自分の評価結果から選んだしきい値に置き換えます。
自分のデータに基づいてしきい値を決める
高い確率が役立つのは、実際に受け取るケースで信頼できる結果を予測できる場合だけです。別に返される confidence フィールドを、独立に検証された成功率だと解釈しないでください。ポリシーで使う統計量を選び、記録し、その統計量を使ったポリシーそのものを評価します。
キューへの振り分けでは、選ばれた選択肢の確率から始められます。最大確率と二番目の確率の差も確認できます。アカウント担当と請求担当の確率が拮抗しているなら、顧客の意図が実際に混在している可能性も、分類の説明が十分に分離されていない可能性もあります。
ラベル付きの検証セットを作り、複数のしきい値候補を比較します。それぞれについて、自動処理したチケットの振り分け精度と、確認に回す割合を測定します。しきい値を上げると通常は対象範囲と引き換えに選別が厳しくなりますが、実用的な設定はデータと誤りのコストによって変わります。
1,000 件のチケットを含む仮想的な検証セットを考えます。あるしきい値では 800 件を自動で振り分け、そのうち 720 件が正解でした。カバレッジは 80%、振り分けたケースの精度は 90% です。より厳しいしきい値では 500 件を振り分け、そのうち 480 件が正解でした。カバレッジは 50%、振り分け精度は 96% です。どちらが常に優れているわけでもありません。増える人手確認のコストと、顧客を誤ったチームへ送るコストを比較してください。また、しきい値を上げるにつれて、どの分類が自動処理から外れるかも調べます。全体の改善が、サービスの偏りを隠す場合があるためです。
キャリブレーションでは、予測を確率帯ごとにまとめ、予測した確率と実際の正解率を比較します。0.90 前後と予測したケースの正解率が 70% しかないなら、そのサンプルでは確率が過信気味です。キャリブレーションの作業と、最終的なホールドアウト評価は分けてください。
操作ごとに別のポリシーを使います。チケットの誤振り分けと、アカウントの認証情報の変更では影響が異なります。プロンプトの安全性ワークフローでは、明示的な実行制御と併用できる判断チェックを紹介しています。
画像の追加とセルフホスティングを理解する
ホスト型の視覚判断では、埋め込みデータ URL、または content_type と base64 を含むオブジェクトを使って、リクエストに images を追加します。ホスト型 API の入力仕様では PNG、JPEG、WebP が使えますが、通常のリモート画像 URL は受け付けません。画像は最大 4 枚、1 枚につき 4 MiB かつ 1,600 万ピクセルまで、デコード後の合計サイズは 8 MiB まで、リクエストボディは 13 MiB までと規定されています。
最初の実用的なタスクとして、スクリーンショットにログインエラーが見えるかどうかを判定できます。画像に、焦点を絞った質問と関連する文脈を添えます。正確な数値の抽出が必要なアプリケーションでは、算術ルールを適用する前に抽出結果を検証してください。
Hugging Face のモデルカードでは別の実行方法が説明されています。リリースをダウンロードし、バックボーンと結合スキーマヘッドを読み込み、付属の joint_schema_model ヘルパーを使う方法です。例では load_release_model と systemone を使用しています。このリリースのライセンスは Apache-2.0 で、記載されているテスト環境は H200 1 基、PyTorch 2.11、Transformers 5.10.2 です。
ローカル用ヘルパーには PIL 画像や動画フレームの配列についての説明もあります。ただし、それはホスト型 API が動画に対応していることを意味しません。現在のホスト型スキーマに記載されているのは画像であり、動画のリクエストフィールドはありません。ローカル用ヘルパーのデフォルトのエンコード上限は 16,384 トークンで、ホスト型のコンテキストウィンドウとは異なります。自分のデプロイ環境の設定を確認してください。
推論環境を制御する利点が運用負担に見合うなら、セルフホスティングを選べます。GPU メモリ、バッチ処理、監視、アップグレードのためのリソースを見込んでおきましょう。初めて連携する場合は、ホスト型 API を使うと同時に調査しなければならないシステムを減らせます。
Cloudflare Clef のコストを見積もる
2026 年 10 月 3 日に確認した Workers AI の料金表では、Clef は入力 100 万トークンあたり 0.24 米ドル、Clef-flash は入力 100 万トークンあたり 0.09 米ドルと記載されています。
例として、平均 1,200 入力トークンのリクエストを 100,000 回実行すると、入力使用量は合計 1 億 2,000 万トークンです。掲載料金を適用すると、Clef は 28.80 米ドル、Clef-flash は 10.80 米ドルになります。これは利用枠の適用前のモデル入力料金であり、ほかのプラットフォーム費用は含みません。月額請求全体の見積もりではありません。
代表的なリクエストで報告された使用量を使い、仮定した平均値を置き換えます。長いチケット履歴、詳細な評価基準、再試行、画像入力によって使用量は変わります。人手確認の費用も追跡してください。推論が安くても、手作業が増えればワークフロー全体が安くなるとは限りません。
同じラベル付きケースに同じ採用ポリシーを適用して、モデルを比較します。Clef-flashを試すには、エンドポイントの識別子を @cf/cloudflare/clef-flash に変え、ボディのセレクターも "model": "clef-flash" に変更します。トークン単価だけで選ばず、コストとともにレイテンシーと品質も記録しましょう。
よくある連携ミスを修正する
導入初期の問題の多くは、次の四つのいずれかに分けられます。
| 症状 | 最初に確認する項目 |
|---|---|
| 認証に失敗する | アカウント ID、トークンの権限範囲、環境変数の読み込み |
| リクエストの検証に失敗する | 必須の instructions、criteria の形式、モデルセレクター |
| JavaScript で回答が undefined になる | REST のエンベロープとバインディングの直接出力の違い |
| 判断はもっともらしいが用途に合わない | 判断材料の品質、重複する選択肢、確認用ルートの欠如 |
別の Workers AI モデルが対応しているからといって、チャット形式の messages ペイロードを送らないでください。Clef に文書化された判断用の仕様を使います。同様に、answers.owner を文字列として解析したり、チャット補完のフィールドに文章での説明を期待したりしないでください。
長い記録では、関連する判断材料を意識して選びます。ホスト型モデルのページには、コンテキストウィンドウが 65,536 トークンで、長いテキスト状態は切り詰められると記載されています。その境界に達する前に、判断に必要な事実を残すようにしましょう。
予測が不適切に見える場合は、一つのケースを最初から最後まで確認します。実際に送った判断材料、スキーマのバージョン、確率分布の全体、最終的なアプリケーションルールを調べます。先にモデルを変更しても、元のデータやポリシーの誤りが残ることがあります。
ワークフローを評価して導入する
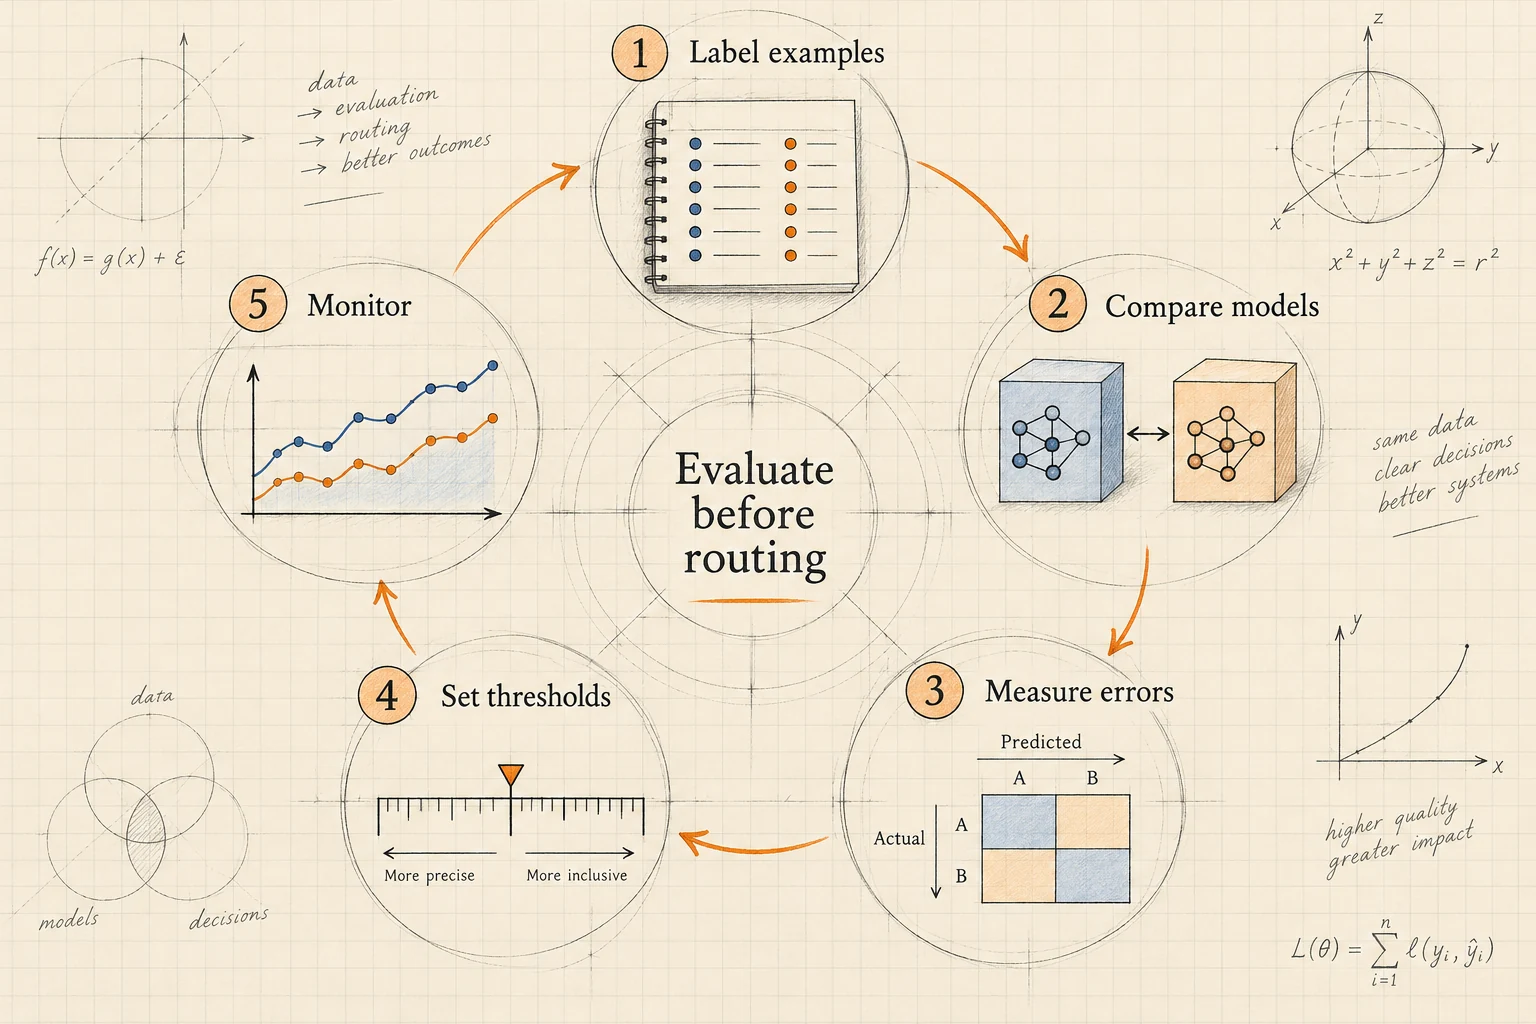
想定する振り分け先、言語、情報不足のパターンを反映した過去のチケットから始めます。モデルの出力とは独立に、主たる未解決の問題をラベル付けします。ラベルを信頼できる基準として扱う前に、評価担当者間の意見の違いを解消します。
データを開発セット、検証セット、ホールドアウトセットに分けます。開発ケースでスキーマを改善し、検証ケースでしきい値を設定し、ホールドアウトセットで最終的なリリース判断を行います。同じ会話に含まれる、ほぼ重複したチケットが別々のセットに入らないようにします。
少なくとも、振り分けの正しさ、人手確認率、振り分け先ごとの誤り、レスポンスのレイテンシー、推論の失敗、採用した判断 1 件あたりのコストを追跡します。件数の少ない振り分け先は別に確認してください。全体平均が良くても、少数ながら重要な分類で誤りが繰り返されている可能性があります。
小さなエラー記録簿を作り、確認した失敗ごとに原因を記録します。判断材料の不足、曖昧な基準、モデルの誤り、アプリケーションポリシーの誤り、といった区分です。区分ごとに必要な修正は異なります。修正済みのケースは回帰確認用のケース集に追加しますが、最終ホールドアウトセットに対して繰り返し調整しないでください。単純な決定論的ベースラインも役立ちます。新しい推論ステップによる改善が、その複雑さに見合うかどうかを判断できるためです。
自動振り分けの前にシャドーモードで動かします。既存の運用を続けながら、Clef なら何を選ぶかを記録します。その提案と実際の結果を比較してください。その後、すぐに戻せる小さな範囲のトラフィックで有効にし、即座に使えるフォールバックを維持します。
各結果とともに、モデル識別子、スキーマのバージョン、判断ポリシー、入力の出所を保存します。製品、サポート分類、顧客の言葉遣いが変わったら、ドリフトを確認します。Jev のドキュメントハブには、型付きの判断を軸に構築するアプリケーションの関連資料があります。
よくある質問
Worker をデプロイせずに Cloudflare Clef を使えますか?
はい。アカウント単位の REST エンドポイントと Workers AI トークンを使えます。判断の呼び出しを、リクエスト処理やアプリケーションのポリシーと同じ場所に置きたいときに Worker が役立ちます。
choice と複数の noul 質問はどちらを使うべきですか?
競合する選択肢から一つの振り分け先を選ぶ必要があるなら、choice を使います。複数の独立した条件が同時に成立する可能性があるなら、別々の noul 質問を使います。結果を解釈する前に、それらの条件が重複してよいかを定義してください。
Clef はチャットモデルの代わりになりますか?
答えがあらかじめ指定された判断に使いましょう。次のステップがメールの作成なら、選ばれた振り分け先と検証済みの文脈を、適切な生成ワークフローに組み合わせます。その出力にも同じアプリケーションルールを適用します。
スコアが高いとモデルの確信度も高いのですか?
いいえ。影響スコアが高いのは、確率質量が評価基準の高いレベルに偏っていることを意味します。Confidence は分布の別の性質を表します。実際の確率を確認し、アクションを制御する統計量を評価してください。
最初に何を作るべきですか?
一つの判断、明示的なフォールバック、小さなラベル付き評価セットを実装します。失敗の理由を説明でき、許容できるカバレッジを測定できるようになってから、スキーマを広げたり、別のワークフローを追加したりしましょう。