製品・コンセプト
Jev AIとは?System Oneと実行可能な判断の実践ガイド
Jev AIはソフトウェア向けの判断モデルです。業務の状態と型付きの質問を渡すと、分類、振り分け、スコアリング、安全確認に使える構造化された結果、確率、信頼度シグナルが返されます。
Jev AIとは?System Oneと実行可能な判断の実践ガイド
エージェント、サポートシステム、ワークフロー、SaaS製品にAIを追加するとき、最も難しいのはモデルに文章を書かせることではない場合がよくあります。多くのリクエストに対して小さな判断を一貫して行うことが難しいのです。このチケットはどのチームに送るべきか。この操作には人の承認が必要か。タスクの緊急度はどのくらいか。次にどのモデルやツールを実行すべきか。
Jev AIは、こうした判断をソフトウェアが直接利用できる構造化された結果に変えるために設計されています。 Jev AIのWebサイトでは、ソフトウェアチーム向けの判断ツールとして紹介されています。TypeSafeの公式ドキュメントでは、主力モデルであり、最初のSystem Oneモデルと説明されています。Stateと型付きの質問を渡すと、選択、スコア、Yes/Noの判断、確率シグナルが返されます。
この記事では、Jev AIの概要と仕組み、生成LLMと併用する場面、APIの接続方法、本番設計で考慮すべき制約を解説します。
要約: Jev AIは、あらゆる会話型AIシステムの置き換えを目的とするものではありません。定義された回答範囲で、分類、振り分け、スコアリング、安全確認を速く繰り返し行うための、アプリケーション内の判断レイヤーです。
目次
Jev AIとは
ソフトウェア向けSystem Oneモデル
大規模言語モデルは、主に人が読むテキストの生成を目的に設計されています。ソフトウェアで範囲の限られた判断が必要になると、開発者は追加で3つの処理を行うことがよくあります。プロンプトで出力形式を指定し、自然言語またはJSONのレスポンスを解析し、アクションを実行するか判断します。この方法は柔軟ですが、書式エラーや余分な文章、不確実性がアプリケーション層に入り込みます。
Jev AIは異なるインターフェースを使います。
- State: チケット、メッセージ、フォーム項目、JSONオブジェクトを判断のコンテキストとして送信します。
- 型付きの質問: アプリケーションが必要とする判断の種類を正確に定義します。
- 構造化された結果: コードで分岐、並べ替え、振り分け、保存できる結果を受け取ります。
製品の位置付けはJev AIホームページで、System Oneモデルと基本要素についてはTypeSafeの公式紹介で確認できます。
Jev AIと生成LLMの違い
Jev AIと生成LLMは、単に同じ製品の競合バージョンというわけではありません。それぞれ得意分野が異なります。LLMは自由形式の文章生成、説明、創作に強く、Jevはソフトウェアが処理する必要のある、繰り返し発生する範囲の定まった判断を対象としています。
| 比較項目 | Jev AI | 生成LLM | ルールベースのコード |
|---|---|---|---|
| 主な出力 | 選択、スコア、Yes/No判断、確率、信頼度 | テキスト、コード、自由形式の構造化コンテンツ | 明示的な条件から得られる決定論的な値 |
| 得意な用途 | 分類、振り分け、優先度、リスク確認、ツール実行の制御 | 文章作成、要約、Q&A、複雑な推論 | 意味解釈を必要としない安定した条件 |
| インターフェース | State + 型付きの質問 | プロンプト + コンテキスト | if/else、ルールエンジン、クエリ |
| 不確実性 | 確率と信頼度シグナルで可視化 | 通常は独自の検証が必要 | 通常、モデル確率はない |
| システム上の役割 | アプリケーションロジック内の判断レイヤー | 生成または推論の中心 | 決定論的な実行レイヤー |
Jevが業務ポリシーを決めるわけではありません。回答範囲、スコア基準、しきい値、人による確認の方法は、引き続きチームが選びます。
Jev AIの仕組み
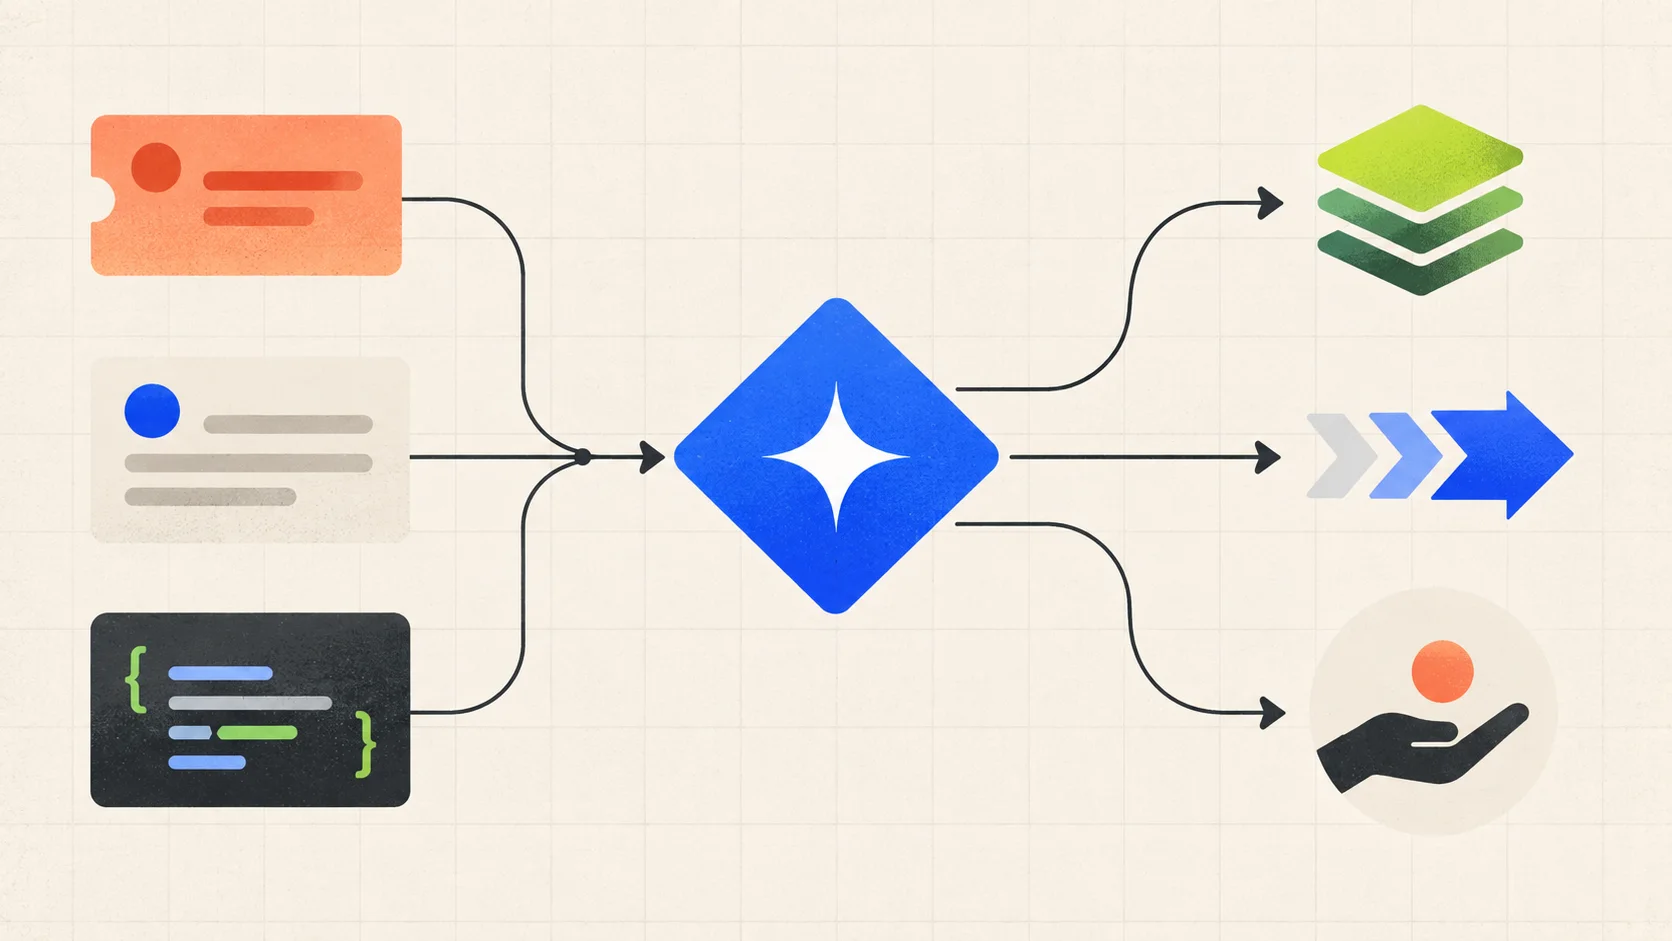
画像:複数の小さな質問が同じStateを参照し、次の動作はアプリケーションコードが決定します。
公式ドキュメントに記載されたワークフローは、次の4段階にまとめられます。
1. Stateを準備する
Stateは、すべての質問が参照するコンテキストです。次のような形式を使えます。
- サポートメッセージ、アラート、ユーザー報告などの自然言語の文字列。
- チケット、注文、ユーザー層、ポリシー項目を含むJSONオブジェクト。
- 関連メッセージや検索で取得した抜粋などのテキスト配列。
業務プロセス全体を巨大なプロンプト1つに詰め込むのではなく、通常は共通のStateに対して質問を行います。現在のドキュメントによると、Jevはテキスト、JSONオブジェクト、テキスト配列を受け付けます。画像、音声、動画は現時点で直接入力できません。
2. 型付きの質問を定義する
各質問では、1つの具体的な判断を尋ねます。「この顧客を引き留めるべきか、どのチームがフォローすべきか」と一度に尋ねるのではなく、「どのチームが対応すべきか」と「顧客維持のワークフローが必要か」に分けます。質問を小さくするとテストしやすく、コードで組み合わせやすくなります。
3. 構造化されたレスポンスを読む
Jevは、送信した質問IDを使って回答を返します。フィールドは質問タイプによって異なります。Choiceは選択肢、確率、信頼度を返すことがあり、Scoreはスコア、凡例、確率、信頼度を返すことがあります。Noulは「はい」である確率を返します。
レスポンスには usage や elapsedMs などの実行情報が含まれる場合もあります。elapsedMs はリクエスト全体の所要時間であり、モデル推論のみの時間とは限りません。
4. 次のアクションをコードで決める
モデルが判断し、アプリケーションが処理を実行します。コードから route()、queue()、block()、request_review()、または別のLLMを呼び出せます。しきい値、権限、監査ログ、高リスク時のフォールバックをアプリケーション側で管理できます。
実際の、ただしリスクの低い業務状態を使って、Jev AI Playgroundで一連の流れを試してみてください。
3種類の質問
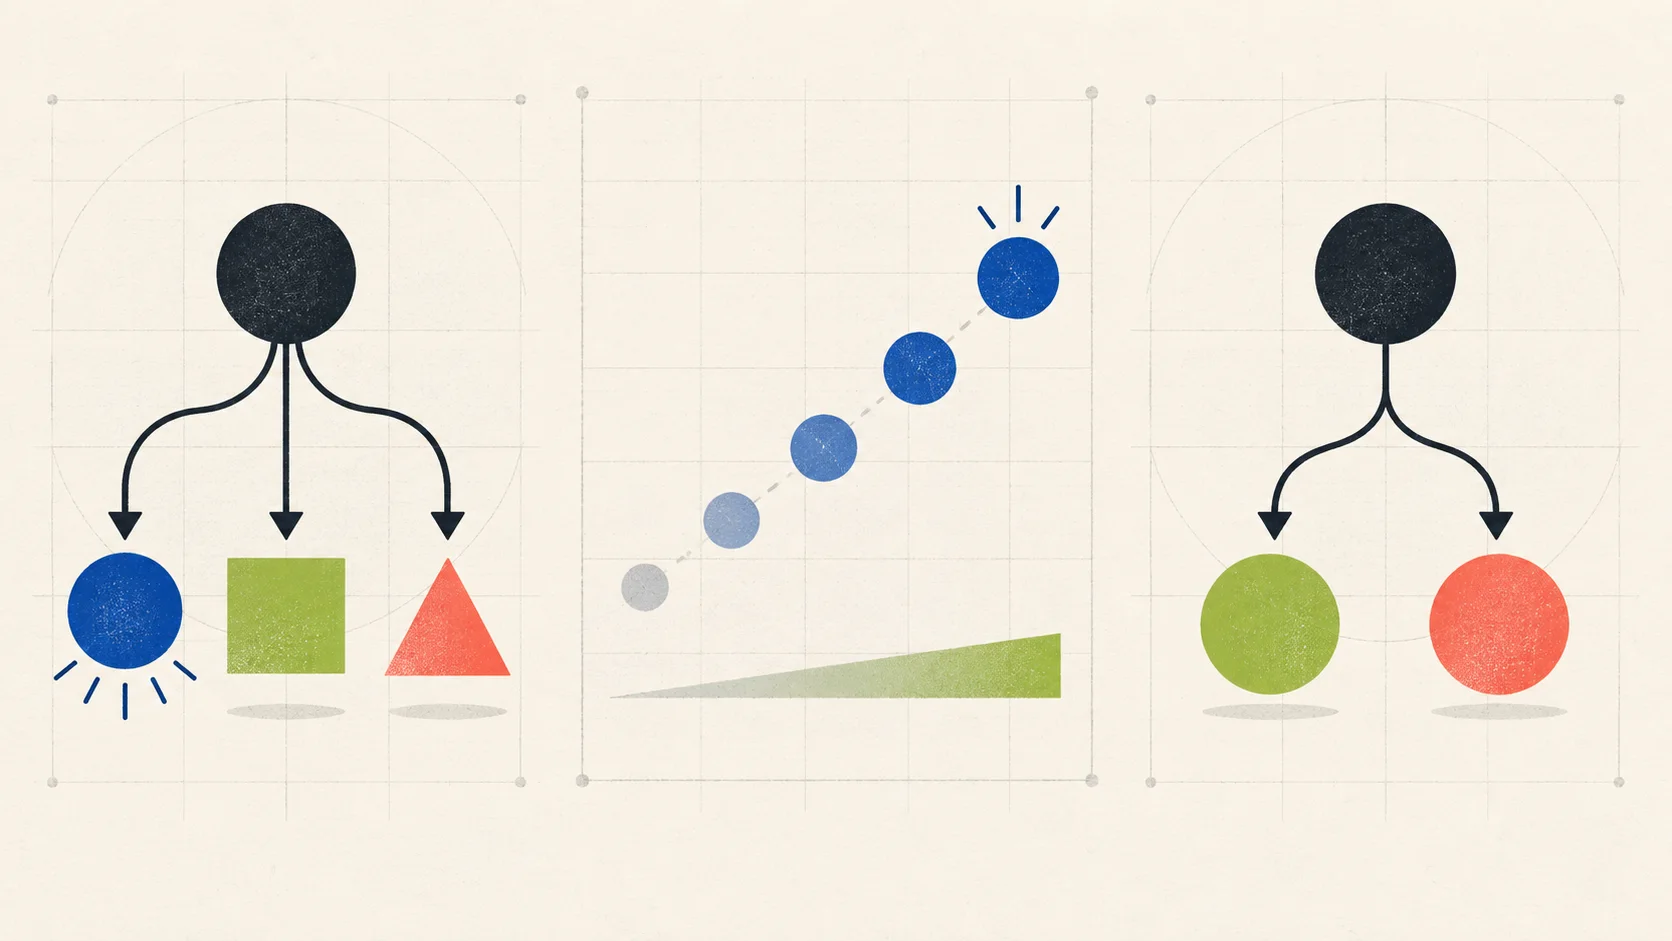
画像:3つの基本要素は、選択、スコアリング、記述が正しいかの判断に対応します。
Choice:定義済みの選択肢から選ぶ
Choiceは分類や振り分けを目的としています。たとえば、次のような質問です。
- このサポート依頼は請求担当、技術サポート、または別のチームのどこに送るべきか。
- このコンテンツはチュートリアル、製品アップデート、顧客事例のどれか。
- リクエストには高速モデル、より高性能なモデル、人によるワークフローのどれを使うべきか。
選択肢と説明は事前に定義します。未知のケースがあり得る場合は other や none-of-the-above を残し、モデルに不適切な選択を強制しないようにします。
Score:順序付き基準で評価する
Scoreは深刻度、満足度、優先度、リスクレベルに適しています。「対応不要」から「即時エスカレーション」までの段階を定義し、Jevの確率で重み付けした結果を使ってキューの順序を決められます。
スコア基準は具体的に定義してください。「緊急度を判断する」とだけ記すのではなく、各レベルについて期限、顧客への影響、運用上の結果を説明します。そうすることで、SLAや優先順位付けロジックで活用しやすくなります。
Noul:記述が正しいか判断する
Noulは、「顧客は明示的に返金を求めているか」「このツール呼び出しには人の確認が必要か」といった二択の判断に使います。0から1の「はい」の確率を返し、別の信頼度フィールドを返すわけではありません。
結論に複数の独立した条件が含まれる場合は、複数のNoul質問に分けてコードで結果を組み合わせます。事実、リスク、アクションを1つの質問で一度に処理させるより評価しやすくなります。
最新のフィールドや例はJev AIの質問ドキュメントとTypeSafe APIドキュメントをご覧ください。
LLMにJSONを返すよう頼むだけではだめ?
LLMにJSONを返すよう依頼するのは、今でも有用なエンジニアリング手法です。判断の形が既知で、確実に繰り返す必要があるときにJev AIが役立ちます。
回答範囲が明示されている
Choice、Score、Noulはそれぞれ異なる判断の意味を表します。開発者が先に回答範囲を定義するため、アプリケーションコードが文章から意図を推測する必要がありません。
1つのStateに複数の質問を設定できる
サポートチケットに対して、同じリクエスト内で担当部署、緊急度、返金の意図を評価できます。公式ドキュメントによると、複数の質問は同じStateに対して並列評価されるため、1つの判断を分割するためだけに個別リクエストを連鎖させずに済みます。
確率シグナルを制御フローに利用できる
結果が十分に明確なら、コードで自動的に振り分けられます。しきい値に近い場合や操作のリスクが高い場合は、人による確認、追加情報の要求、より強力なモデルの呼び出しができます。すべての出力を同じ安全度として扱うのではなく、シグナルに応じて自動化の度合いを変えられます。
ポリシーはコードで管理できる
Jevは現在のStateについて定義済みの質問に答えます。しきい値、権限、再試行、監査履歴、最終アクションはアプリケーションが管理します。ポリシーが変わった場合は、巨大な会話型プロンプト全体を作り直さず、質問の定義やコードを更新できます。
Jevがすべてのタスクに適しているわけではありません。自由形式の調査、長い説明、創造的な生成には、引き続き生成モデルまたは人が適しています。
Jev AIが活躍する場面
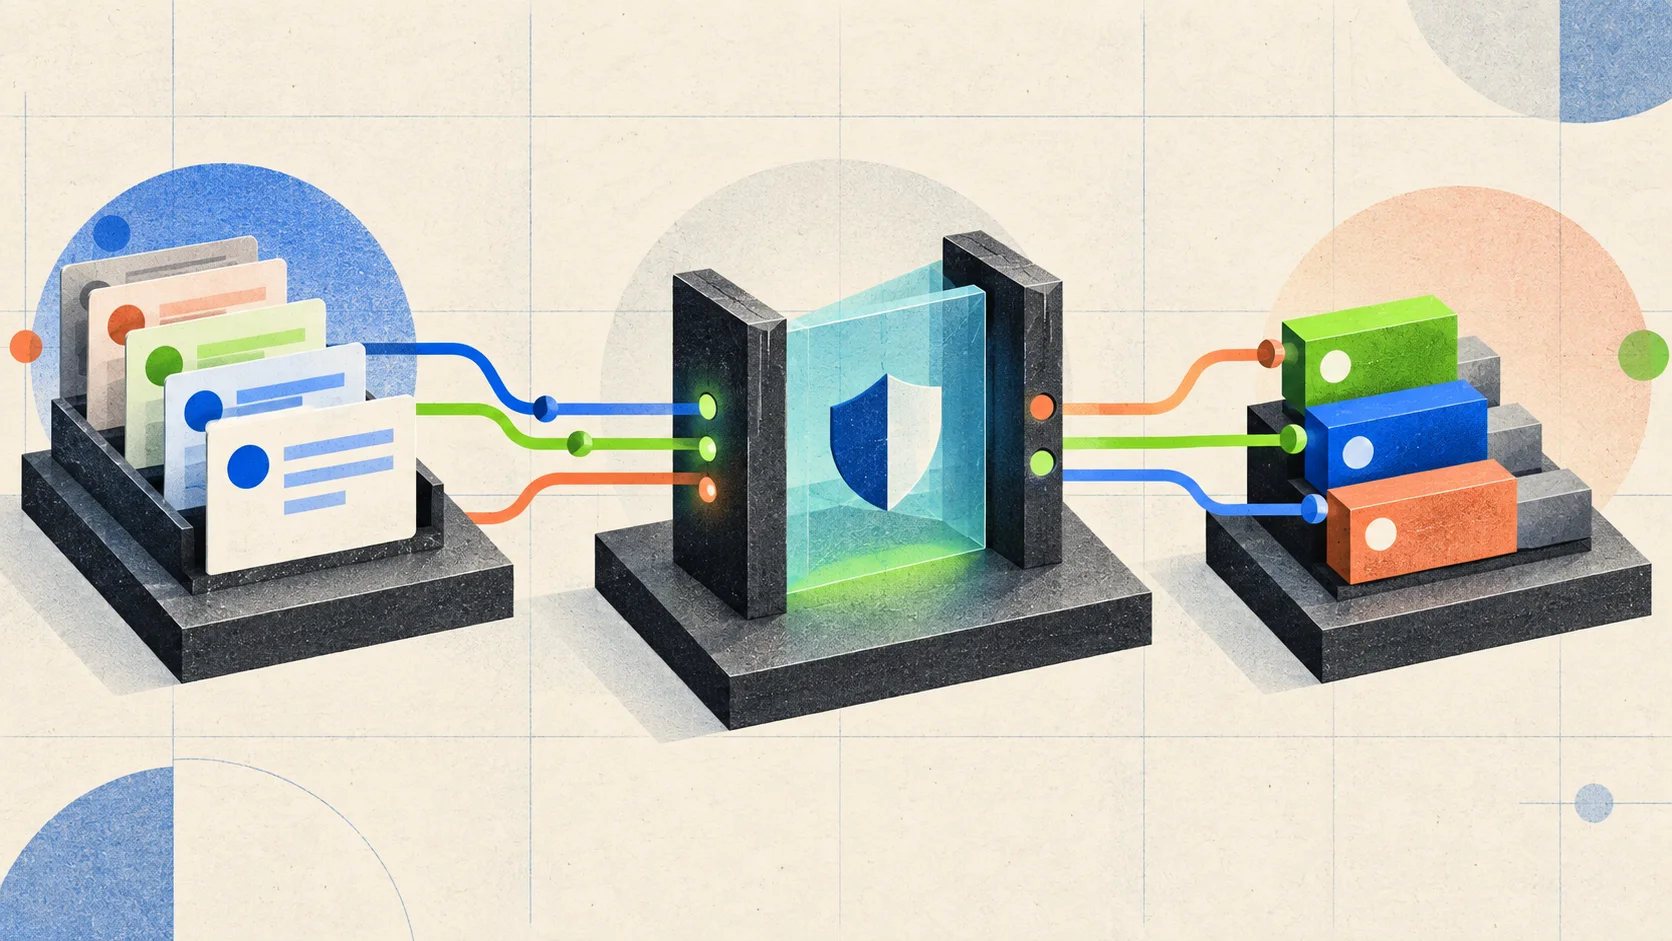
画像:Jevは入力、ガードレール、実行キューの間にある判断ノードとして機能します。
サポートチケットの分類と振り分け
チケット本文、顧客のプラン、関連する履歴をStateとして使います。Choiceで担当チームを選び、Scoreで緊急度を見積もります。キューはチーム、スコア、確率で並べ替え、信頼度の低いケースは人の確認に回せます。
AIエージェントのモデル振り分け
タスクの難易度、必要なツール、リスクを分類してから、高速モデル、高性能モデル、人によるワークフローのいずれを選ぶか決めます。経路を判断するのはJevですが、モデル呼び出し、コンテキスト、ツールの管理は引き続きエージェントのオーケストレーション層が行います。
ツール呼び出し前の安全確認
データ削除、カードへの課金、権限変更、外部メッセージの送信前に、Noulで意図が明示的か、必要条件を満たすかを判断します。高リスクのアクションでは、ハードルール、認可確認、監査ログも併用してください。
キューの優先順位付けと人へのエスカレーション
影響、期限、顧客の状態を別々のScoreまたはNoulの質問に分け、コード内の順位付け式で結果をまとめます。これにより、1つの大きなプロンプトを書き直さずに、運用チームが重み付けを変更できます。
構造化された情報の抽出
対象フィールドと候補値を事前に定義できる場合、Jevは軽量な分類や検証に利用できます。不明なフィールド、長文の抽出、複雑なエンティティ関係には、まず生成モデルを使い、Jevは検証や振り分けに使ってください。
利用を始める
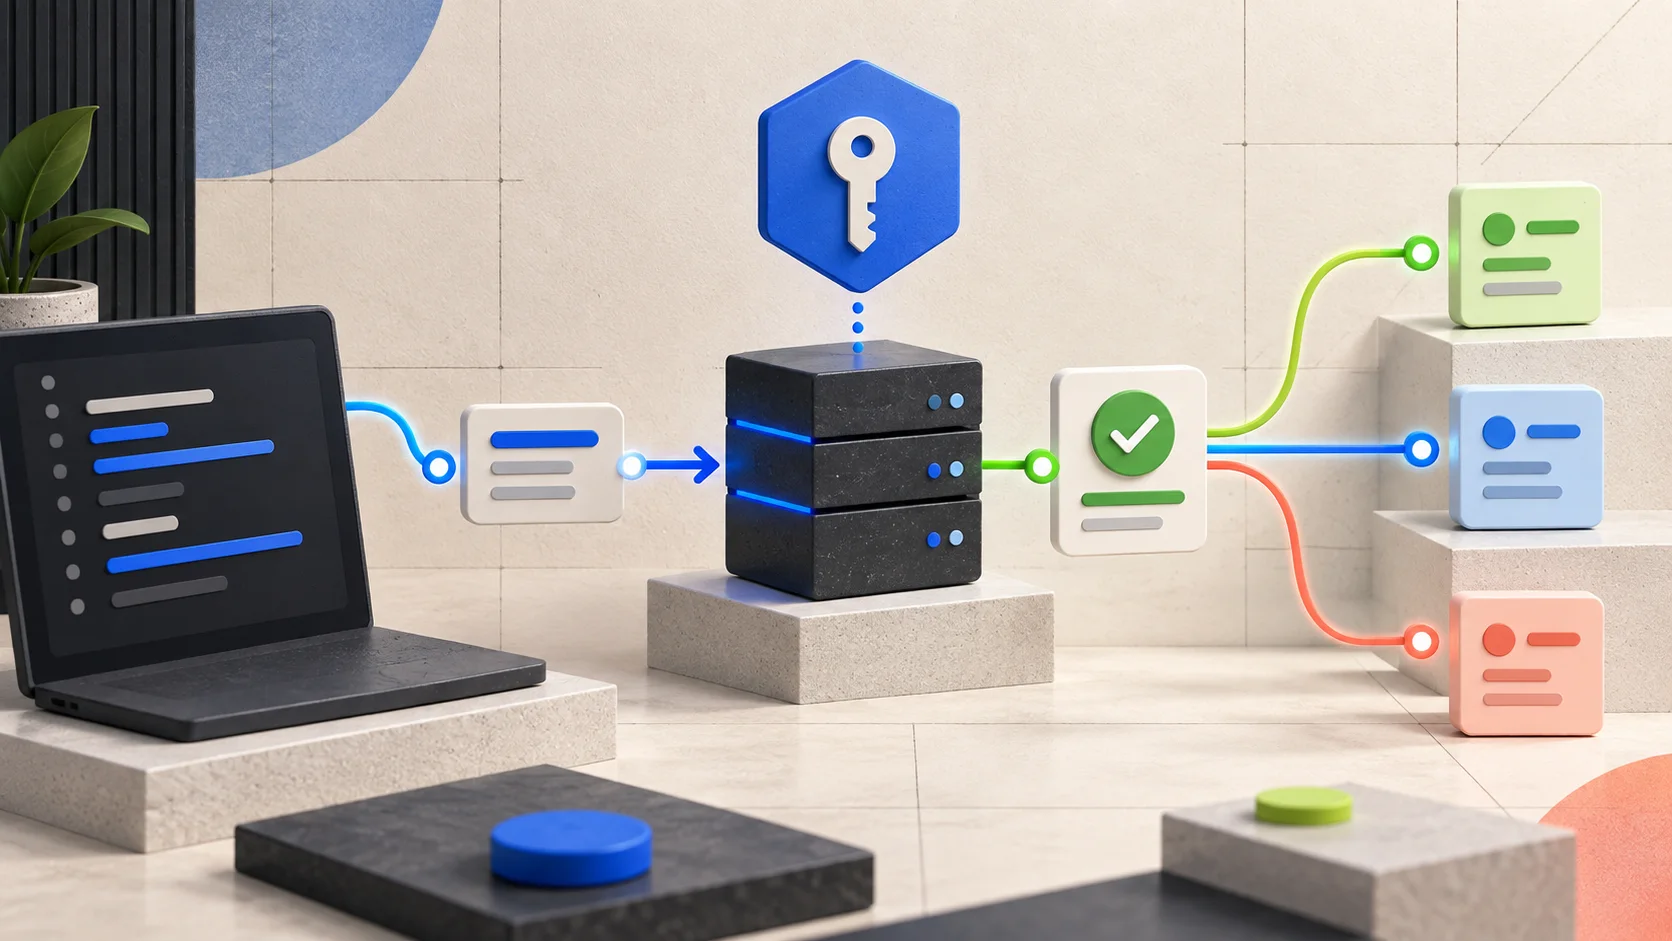
画像:API呼び出しはサーバー側で行い、構造化された結果をアプリケーションコードに渡します。
ステップ1:Playgroundで判断を1つ検証する
測定可能な結果と明確な回答範囲がある、リスクの低い判断を選びます。最初のテストにワークフロー全体を持ち込まないでください。1つの判断で手作業や繰り返しのアプリケーションロジックが実際に減るか検証します。
ステップ2:サーバー側でAPIキーを作成する
ワークフローの検証後、Jev AI APIガイドに沿ってAPIキーを作成します。キーはサーバー側の環境変数に保存してください。ブラウザーコード、実際に使うMarkdownの例、Gitリポジトリに含めないでください。
ステップ3:systemoneエンドポイントを呼び出す
現在のWebサイトドキュメントでは POST https://thejevai.com/v1/systemone が使われています。次はドキュメント記載のリクエスト形式に基づく、最小限のNoulの例です。
curl -X POST https://thejevai.com/v1/systemone \
  -H "Authorization: Bearer $JEV_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "typesafe/jev-1.13",
    "state": "A customer has tried to connect Stripe for three days.",
    "questions": {
      "urgent": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }'
概念的には、answersには質問IDごとの結果、usageには利用情報、elapsedMsにはリクエスト全体の所要時間が含まれます。本番コードでは、短い例からオプションのパラメーターを推測せず、すべてのフィールド、検証、エラー処理について公式APIリファレンスに従ってください。
ステップ4:結果を制御フローにつなぐ
本番向けの堅牢なフローには、通常、次の処理が含まれます。
- Stateを送る前に、長さ、権限、機密データを確認する。
- 範囲を絞った少数の質問を送る。
- レスポンス形式とリクエストのステータスを検証する。
- 確率、信頼度、業務リスク、しきい値を使い、自動化するか確認に回すか決める。
- 再現と評価のため、入力のバージョン、質問定義、モデルバージョン、最終アクションを記録する。
現在の利用上限、APIキー管理、プランの詳細はJev AI料金ページをご覧ください。
確率、信頼度、制約
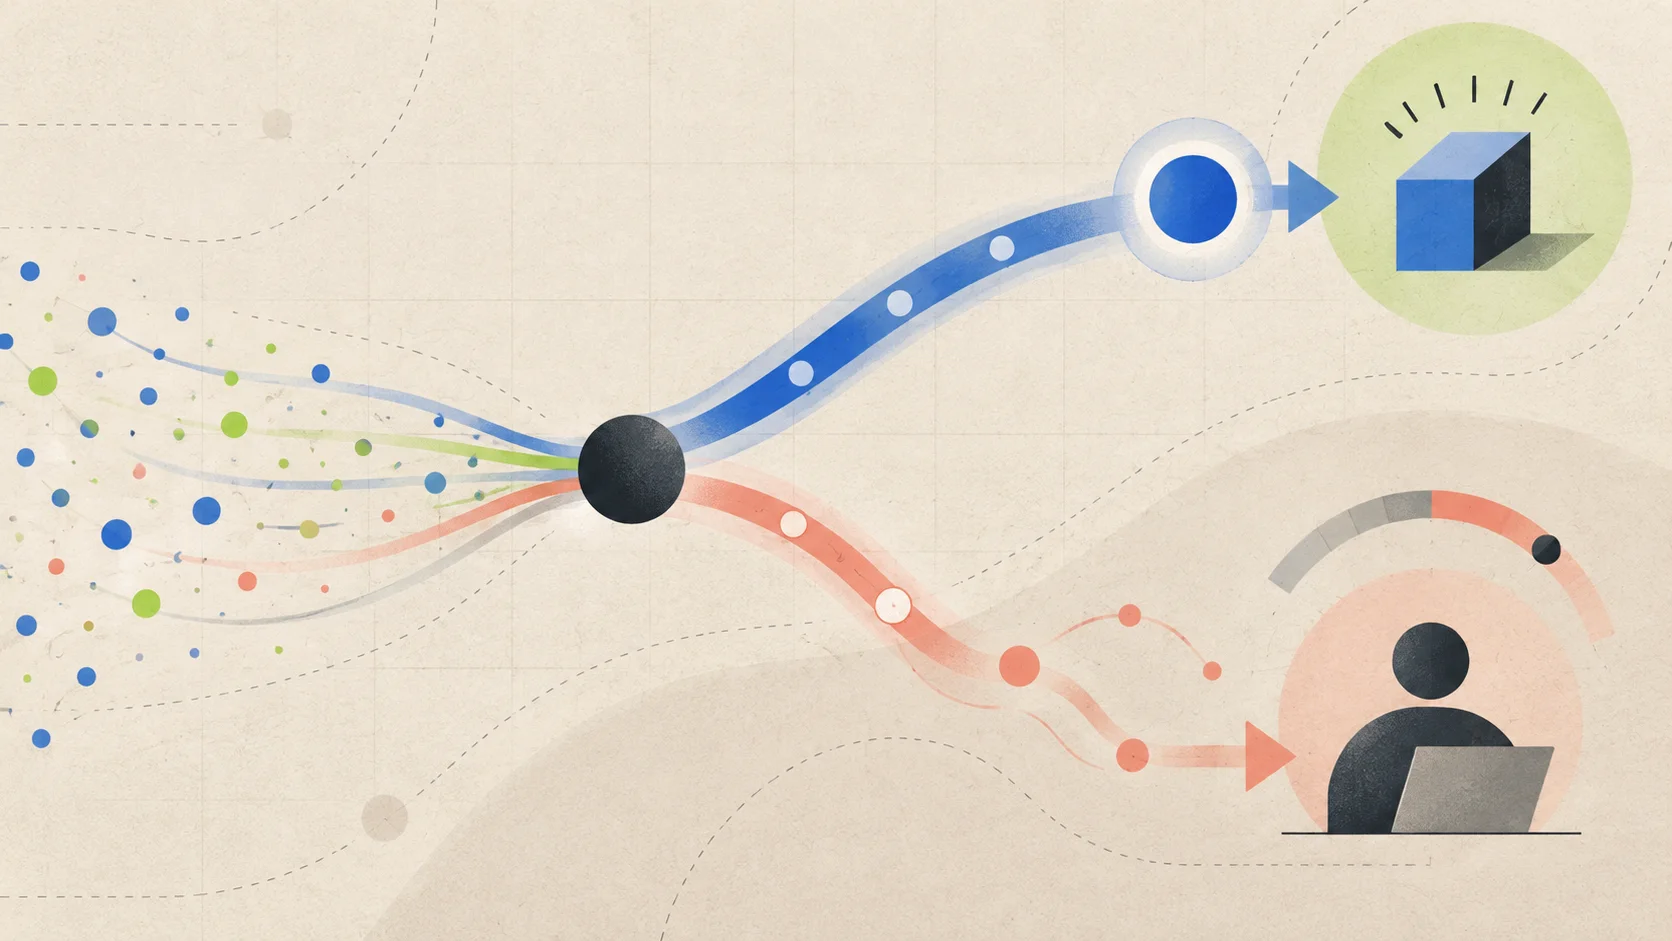
画像:確率はリスク管理の代わりではなく、自動化の度合いを選ぶ手がかりとして使います。
確率は業務上の正確性を保証しない
公式ドキュメントでは、確率と信頼度は自動化のためのシグナルであり、業務上の正確性を保証するものではないと明記されています。高い信頼度の結果でも、利用分野、言語、データ分布、ポリシーによっては誤り得ます。
アクションに応じて異なる戦略を使います。
- 低リスクの分類では、修正経路を設けたうえで低めのしきい値を使えます。
- 中リスクのアクションでは、再試行、反例、人によるサンプリング確認を取り入れます。
- 削除、決済、権限変更では、モデルのシグナルにハードルール、認可、人の確認を組み合わせます。
質問の範囲を狭く保つ
良い質問は1つの判断を尋ね、それぞれの回答に明確な意味があります。長い文脈推論、複数の独立要因、ポリシー解釈、アクションの提案が必要な質問は、小さな質問に分けてコードで組み合わせます。
テキスト以外の入力を前処理する
現在のサイトドキュメントでは、テキスト、JSONオブジェクト、テキスト配列がState入力として記載されています。画像、音声、動画は現時点で直接入力できません。中国語、専門用語、特定分野のデータを扱う場合は、独自の評価セットを用意し、Choice、Score、Noulを個別にテストしてください。
実際の環境でレイテンシーを検証する
Jev AIホームページでは70~500ミリ秒の応答時間が示されていますが、実際のレイテンシーはネットワークの場所、リクエストの大きさ、同時実行数、キュー、サービス状況によって異なります。この数値は製品紹介として捉え、SLAと見なさないでください。本番で依存する前に、実際のリクエストと想定同時実行数でベンチマークを行います。
Jev AIの料金
次の概要は、2026年9月20日に表示された料金ページに基づいています。プランや特典は変更される可能性があるため、購入前に公式料金ページで確認してください。
| プラン | 料金 | クレジットと想定用途 |
|---|---|---|
| Starter | $10 | 有効期限なしの100,000クレジット。実際のワークフロー1つの検証向け |
| Pro | $100 | 1,000,000クレジット、複数ワークスペース、本番APIの利用 |
| Enterprise | $1,000 | 10%の追加分を含む11,000,000クレジット、チーム連携、カスタム統合サポート |
クレジット総数だけで比較しないでください。Stateのサイズ、1リクエストあたりの質問数、判断が並列評価されるか、人による確認が必要な低信頼度の結果の件数を見積もります。
よくある質問
Jev AIはチャットボットですか?
いいえ。Jev AIは会話形式の返答を生成するものではなく、ソフトウェアが利用する構造化された判断を目的としています。チャットボット、エージェント、SaaSワークフロー内の判断ノードとして使えます。
開発経験がなくてもJev AIを使えますか?
PlaygroundでState、質問タイプ、結果を理解することから始められます。判断を製品に接続し、APIキー、権限、再試行、人による確認を管理するには、基本的なバックエンド開発が必要です。
Jev AIは大規模言語モデルを置き換えられますか?
通常、単独では置き換えられません。Jevは範囲の定まった判断に適し、生成LLMは自由形式のテキスト、説明、深い推論に適しています。実用的なシステムでは、Jevがリクエストを振り分けてリスクのある操作を確認し、LLMが生成や複雑な推論を担えます。
Choice、Score、Noulはどう使い分ければよいですか?
- 選択肢から1つ選ぶ場合は Choice。
- 深刻度、優先度、品質を順序付きで評価する場合は Score。
- 1つの記述が正しいか判断する場合は Noul。
信頼度は正確性と同じですか?
いいえ。信頼度と確率は、アプリケーションが自動化の度合いを選ぶ手がかりです。独自のデータ、言語、分野、リスクレベルでモデルを評価し、影響の大きな操作では人による確認経路を残してください。
最新のドキュメントや例はどこにありますか?
まず公式ドキュメントを確認し、次にShowcaseでコミュニティのワークフローをご覧ください。具体的な統合を作る場合は、先にPlaygroundで小さな例を検証します。
まとめ:まず小さな判断を確実にする
Jev AIは、すべてのAI機能を1つのモデルに詰め込むものではありません。ソフトウェアにすでに存在している小さな判断を明確にすることに価値があります。Stateを定義し、型付きの質問を行い、確率シグナルを読み、振り分け、キューへの登録、ブロック、人の確認依頼のいずれを行うかコードで決めます。
AIエージェント、サポート自動化、開発者向けツール、業務ワークフローを作るチームは、低リスクで測定可能な判断を1つ選ぶのが実践的な出発点です。Jev AI Playgroundで検証し、APIドキュメントを使ってサーバー側に接続します。モデル呼び出しと合わせて境界、しきい値、失敗時の経路を設計すれば、Jevは一度きりのデモではなく、保守可能なソフトウェアコンポーネントになります。
調査日: 2026-09-20