開発者ガイド
Jev AI TypeSafe AI:本番環境で型付きAI判断を使う実践ガイド
Jev AI、TypeSafe AI、型付き判断の関係を解説。状態と質問の設計、応答検証、ルーティング、安全なAIワークフローを実践します。
Jev AI TypeSafe AI:本番環境で型付きAI判断を使う実践ガイド
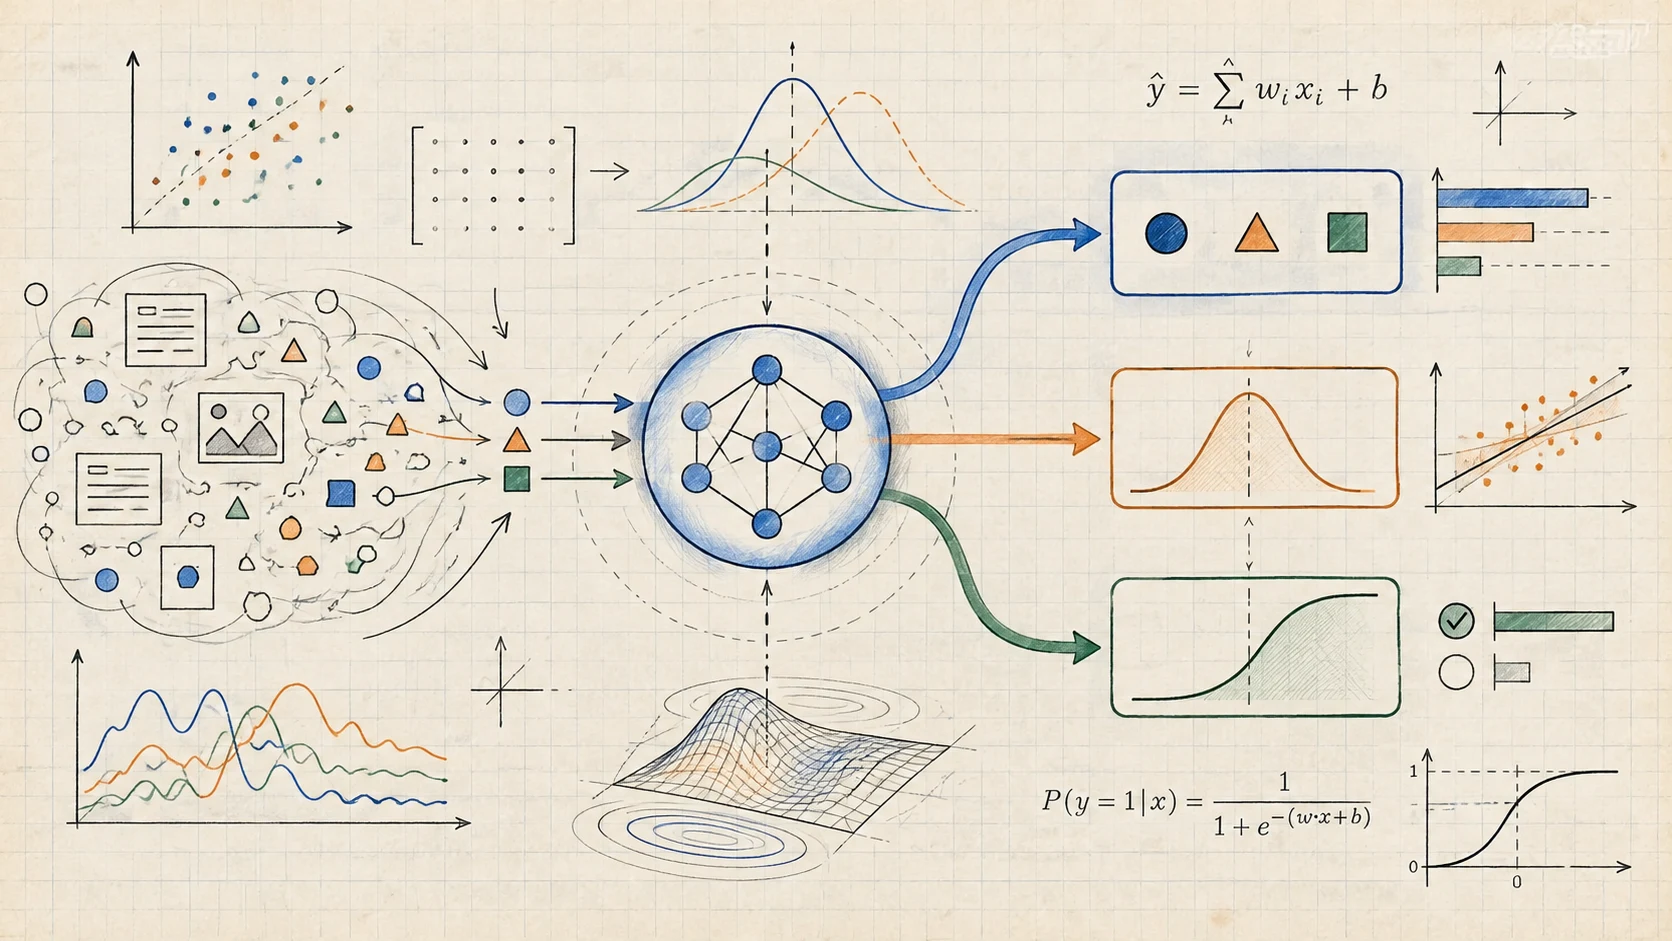
jev ai typesafe aiで検索している人は、おそらくJev AI、TypeSafe AI、そしてソフトウェアが安全に扱えるAI結果の関係を知りたいはずです。ここで重要なのは、型付き判断はチャットの回答をJSONで包んだだけのものではないという点です。型付き判断には、明確な回答空間、検証できるレスポンス形状、そしてアプリケーションの制御フローの中で使う場所があります。
Jevはソフトウェアチーム向けの判断ツールとして位置づけられています。アプリケーションは状態と一つ以上の型付き質問を送り、選択肢、スコア、Yes確率などの構造化された回答を受け取ります。公式のJev AIホームページは、自由な文章生成ではなく、分類、ルーティング、スコアリング、安全チェックを中心に製品を説明しています。また、Jev AIは独立して運営されており、TypeSafeとは提携・運営関係になく、TypeSafeからの推奨も受けていないと明記されています。「TypeSafe AI」は検索やエコシステム上の文脈として扱い、TypeScriptの型ライブラリや別のTypeSafeプロジェクトとJevを同一視しないことが大切です。
この記事では、Jev AI TypeSafe AIを本番で使うための考え方を整理します。判断契約の設計、Choice・Score・Noulの使い分け、リモートレスポンスの実行時検証、生成LLMとの組み合わせ、不確実または利用できないときの安全なフォールバックまでを、実装に落とし込める形で説明します。
目次
- Jev AI TypeSafe AIとは何か
- 型付き判断と生成JSONの違い
- 判断契約:state、質問、ポリシー
- Jevの3種類の質問
- TypeScriptの型は実行時検証ではない
- Jev AIの本番アーキテクチャ
- 価値の高いユースケース
- 確率と信頼度の使い方
- セキュリティ、プライバシー、運用上の境界
- 導入計画とチェックリスト
- Jevが適さないケース
- よくある質問
Jev AI TypeSafe AIとは何か
この検索語は、一般的なチャットボットではなく、プログラムの分岐に組み込める型付きAIインターフェースを探していることを示します。一般的なLLM連携では、アプリケーションがプロンプトを送り、テキストを受け取ります。JSONで返すよう追加指定し、パースして使うこともできますが、質問の定義、回答できる範囲、データ抽出、実行可否の判断が一つのプロンプトに混ざりやすくなります。
Jevはその責任を分けます。アプリケーションコードがstateを渡し、質問を定義します。Jevはstateを質問に照らして評価し、質問IDごとに回答します。その後、アプリケーションが決定的なルール、権限、しきい値、人によるレビューを適用します。
ここでいう「型付き」には、次の3つの意味があります。
- 質問の形が宣言されている。 自由な文章生成ではなく、Choice、Score、Noulのいずれかの判断です。
- 回答の形が対応している。 Choiceは選択肢、確率、信頼度を返します。Scoreは確率加重スコア、凡例、確率、信頼度を返します。NoulはYesである確率を返します。
- アプリケーション上の役割がある。 キューの振り分け、モデルの選択、確認要求、人によるレビューへの送信に使えます。
型付きであることは、正しさを保証することではありません。モデルとコードの境界を明示し、検証、評価、監視を可能にするという意味です。
型付き判断と生成JSONの違い
生成JSONと型付き判断はログ上では似て見えますが、エンジニアリング上の契約は異なります。例えば、サポートチケットのルーティングで生成モデルが次のように返したとします。
{
  "team": "technical",
  "reason": "The customer mentions a failed integration"
}
このオブジェクトは便利ですが、technicalが許可されたチームか、billingとの境界がどれほど近いか、レビューが必要な曖昧なケースかは分かりません。スキーマ、パーサー、ポリシー層を自分で追加する必要があります。
型付き判断では、まず回答できる範囲を定義します。Choice質問にbilling、technical、sales、needs_reviewを設定し、それぞれの基準を記述します。結果には候補ごとの分布を残せるため、アプリケーションは許可リストとリスク別のしきい値を確認してから自動ルーティングできます。
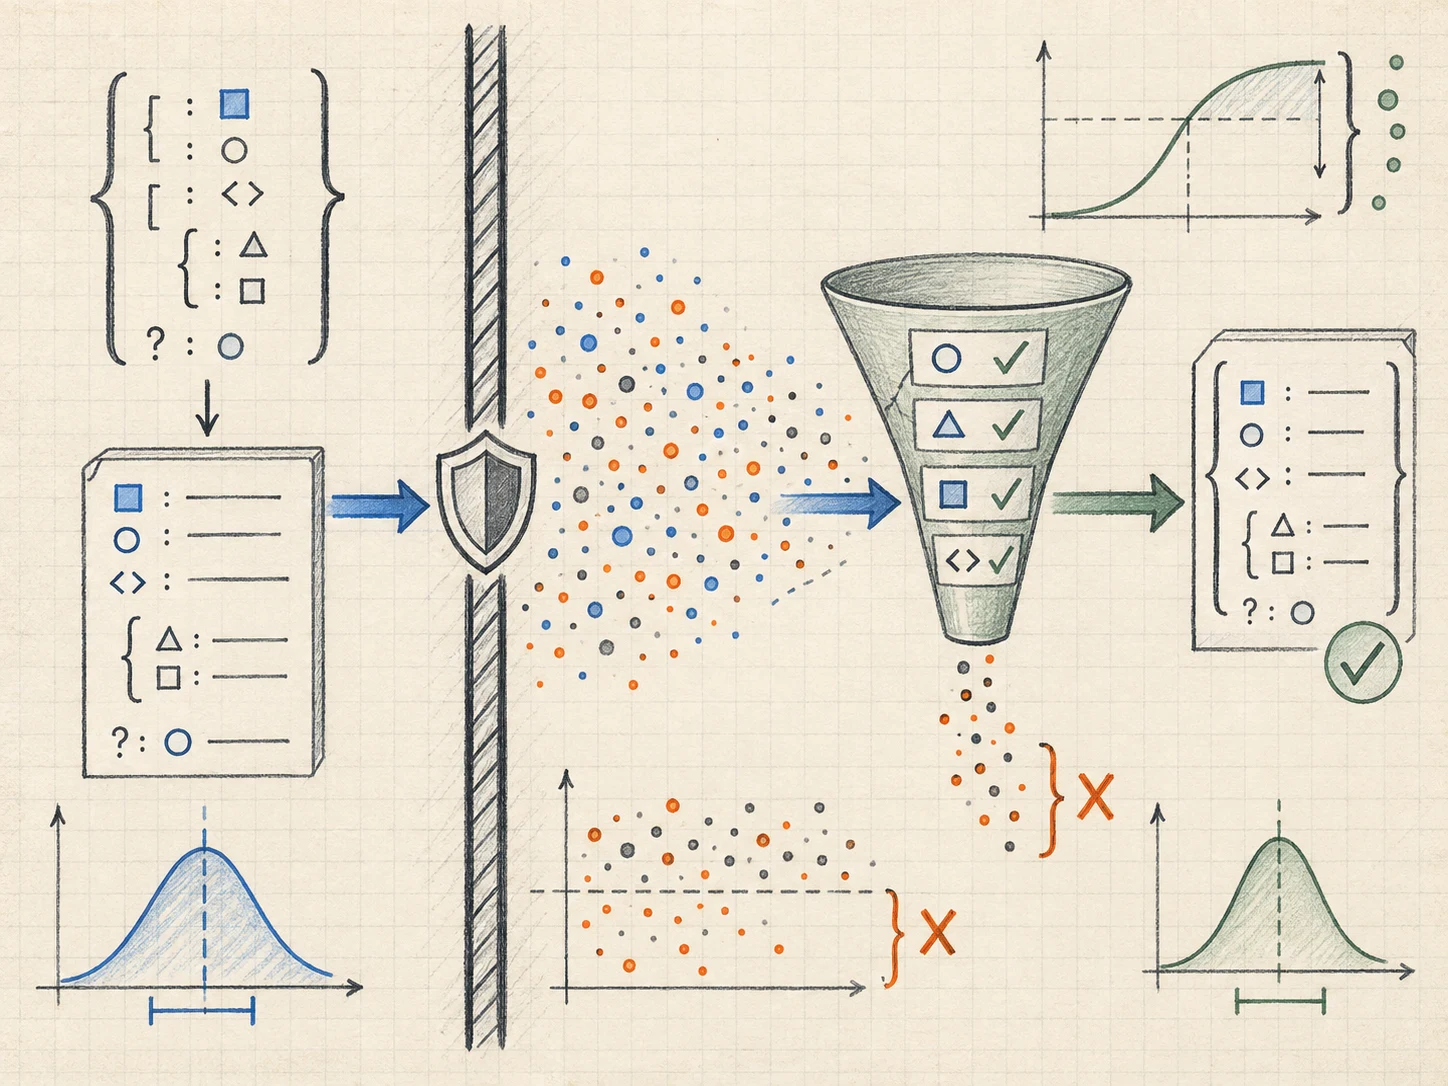
同じstateに対して複数の質問を並列評価できることも重要です。意図、緊急度、レビュー要否を別々のリクエストに分けるのではなく、独立した判断として一つのリクエストにまとめられます。不要なオーケストレーションを減らし、判断面を見通しやすくできます。
基本原則はシンプルです。モデルには境界のある意味判断を任せ、最終的なアクションは通常のアプリケーションコードで実行します。
判断契約:state、質問、ポリシー
APIリクエストを書く前に、小さな判断契約を定義します。少なくとも次の4点を決めてください。
- モデルに必要なstateは何か。
- 何を判断する質問なのか。
- 有効な結果は何か。
- 不確実、無効、利用不可の場合に何をするか。
1. 必要なstateだけを準備する
公開ドキュメントでは、Jevの入力境界はテキスト、JSONオブジェクト、テキスト配列とされています。単純な問い合わせは文字列で、チケット、アカウント階層、製品領域、ポリシー抜粋を組み合わせる場合はJSONオブジェクトで渡します。データベースのレコード全体を送る必要はありません。
stateを小さくすると、レビューしやすくなり、関係のない個人情報や機密情報を送るリスクも減ります。モデルが判断に必要なフィールドだけを見るため、なぜ結果が変化したのかを評価しやすくなります。
2. 一つの質問IDに一つの判断を割り当てる
department、urgency、needs_humanのように安定したキーを使います。「担当チーム、緊急度、返金の可否を同時に判断して」のような複合質問は避けてください。これは異なる回答形式と責任を持つ複数の判断です。
質問IDはアプリケーション契約の一部です。管理画面の表示ラベルは変更できますが、コードが読むキーは計画されたバージョン移行なしに変更しない方が安全です。
3. 回答空間を記述する
criteriaは飾りではありません。曖昧な分類を説明可能な判断に変える評価基準です。各選択肢の条件、スコアの低い側と高い側、どのカテゴリにも合わない場合のフォールバックを明記します。
4. ポリシーをモデルの外に置く
ユーザーにアカウント削除権限があるか、支払いを許可するか、レート制限を超えたかはモデルが決めるべきではありません。認証、認可、リソース所有権、不可逆操作の確認はアプリケーションの決定的な責任です。Jevはその前段で意図やリスクの信号を返す役割を担います。
Jevの3種類の質問
Jevの公式開発ドキュメントでは、3種類の質問が説明されています。判断の形に合うものを選びましょう。

Choice:既知の選択肢から選ぶ
Choiceは、出力が定義済みの選択肢の一つである場合に使います。サポートチーム、リードの分類、文書タイプ、モデル選択、コンテンツ状態などが例です。
const questions = {
  department: {
    type: "choice",
    instructions: "Which team should handle this request?",
    criteria: {
      billing: "Payments, invoices, refunds, or payouts",
      technical: "Bugs, outages, or integration failures",
      sales: "Pricing, upgrades, or new accounts",
      needs_review: "The request does not clearly fit another option"
    }
  }
} as const;
needs_reviewという選択肢は重要です。これがなければ、どのカテゴリにも明確に合わない場合でも最も近いものを強制的に選ぶことになります。完全な回答空間は、長いプロンプトより役に立つことがあります。
Score:順序のある属性を評価する
緊急度、重大度、関連性、顧客の不満度など、低いから高いまでの順序がある概念にはScoreを使います。criteriaは順序付きのレベルで、返されるスコアは確率加重になるため、定義したレベルの間の値になる場合があります。
レベルは観測できる証拠と、影響させたいアクションを基準に定義します。2.7というスコアはエスカレーションを提案できますが、インシデントポリシーや権限チェックを迂回する許可ではありません。
Noul:一つのYes/No命題を判断する
「このメッセージは明確に返金を求めているか」「このツール呼び出しには不可逆な操作が含まれるか」のような、一つの命題にはNoulを使います。返されるnoulはYesである確率であり、二つ目の信頼度フィールドではありません。
カテゴリ、緊急度、Yes/Noチェックが必要なら、同じstateに対して名前の明確な3つの質問を送ります。アプリケーション側で通常の論理とポリシーを使って組み合わせます。
TypeScriptの型は実行時検証ではない
「TypeSafe AI」実装でよくある失敗はここです。TypeScriptはコンパイル時のコードを検査しますが、リモートサーバーが返したバイト列を検査しません。次のコードは検証ではありません。
const payload = (await response.json()) as JevResponse;
型アサーションはコンパイラの認識を変えるだけです。payload.answers.department.choiceが存在し、文字列であり、アプリケーションの許可リストに含まれることは証明しません。
ネットワーク境界ではunknownから始め、ポリシーが使うフィールドを検証します。
type Decision = {
  team: "billing" | "technical" | "sales" | "needs_review";
  confidence: number;
  probabilities: Record<string, number>;
};

function asRecord(value: unknown): Record<string, unknown> | null {
  return typeof value === "object" && value !== null && !Array.isArray(value)
    ? (value as Record<string, unknown>)
    : null;
}

function parseDecision(value: unknown): Decision {
  const root = asRecord(value);
  const answers = asRecord(root?.answers);
  const answer = asRecord(answers?.department);
  const team = answer?.choice;
  const confidence = answer?.confidence;
  const probabilities = asRecord(answer?.probabilities);
  const allowed = ["billing", "technical", "sales", "needs_review"];

  if (
    typeof team !== "string" ||
    !allowed.includes(team) ||
    typeof confidence !== "number" ||
    !Number.isFinite(confidence) ||
    confidence < 0 ||
    confidence > 1 ||
    !probabilities
  ) {
    throw new Error("Unexpected Jev response shape");
  }

  const values = Object.values(probabilities);
  if (!values.every((item) => typeof item === "number" && item >= 0 && item <= 1)) {
    throw new Error("Invalid probability map");
  }

  return {
    team: team as Decision["team"],
    confidence,
    probabilities: probabilities as Record<string, number>
  };
}
本番サービスでは、アクションに影響するすべてのフィールドで同じ考え方を適用します。型、必須キー、数値範囲、確率の合計、許可されたIDを確認し、検証に失敗したら低信頼度のNoではなく「判断不能」として扱います。
Jev AIの本番アーキテクチャ
Jevは大きなシステムの中にある狭い判断レイヤーとして使うのが効果的です。
- 生成LLMまたはアプリケーションサービスがコンテキストを集め、境界のある質問を作る。
- Jevが同じstateに対して型付き質問を評価する。
- 決定的なポリシー層がレスポンス、権限、しきい値を確認する。
- アプリケーションが実行、確認要求、または人によるレビューを選ぶ。
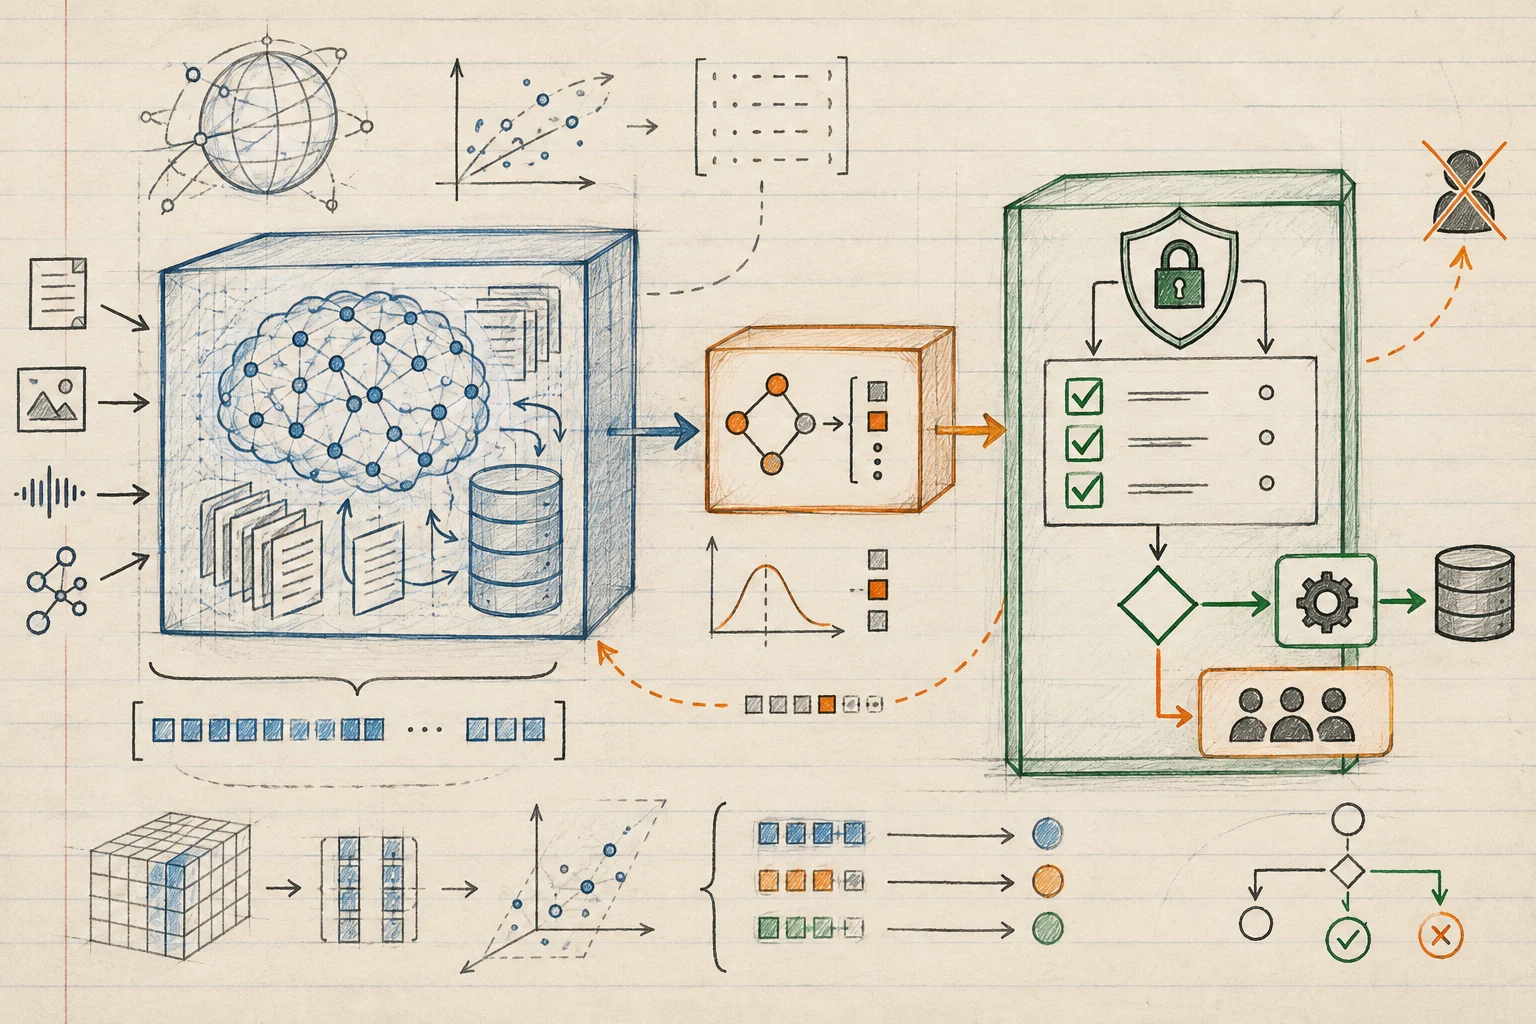
この分離によって、汎用LLMがリクエストの解釈と危険な操作の実行を同時に担うことを防げます。LLMはコンテキストを保持し、Jevは「このツール呼び出しは危険か」を判断します。しかしAPIキー、権限、冪等性、レート制限、確認、最終実行はアプリケーションが所有します。
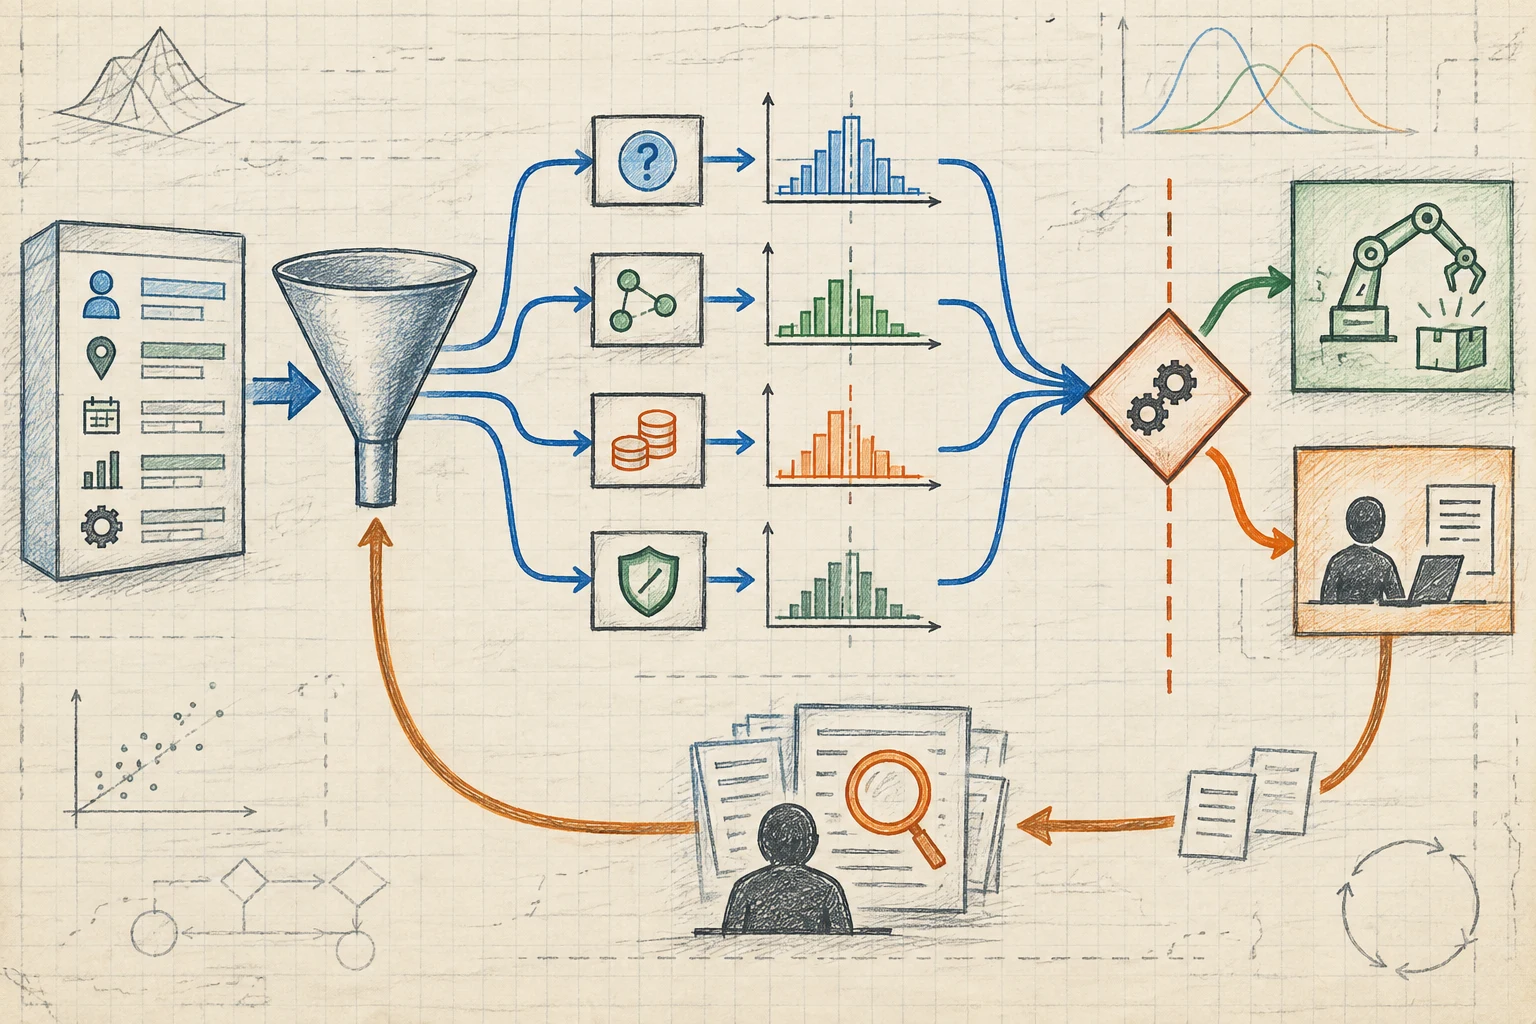
RESTの境界は明確です。公式ドキュメントの例では、Bearer APIキー、model(例:jev-latest)、state、questionsを付けてPOST https://thejevai.com/v1/systemoneを呼び出します。呼び出しはサーバー側に置き、JEV_API_KEYをブラウザコードやAgentの公開トランスクリプトに含めないでください。
内部結果は単なるBooleanではなく、例えば次のように表します。
type WorkflowResult<T> =
  | { kind: "decision"; value: T; confidence?: number }
  | { kind: "review"; reason: string }
  | { kind: "unavailable"; reason: string };
「billing」と分類されたチケットとタイムアウトは同じではありません。評価できなかったツール呼び出しも、安全なツール呼び出しと同じではありません。状態を明示すれば、フォールバックをメトリクスで追跡できます。
価値の高いユースケース
サポートと運用のルーティング
チーム、緊急度、人による対応の要否を一つのリクエストで判断できます。選択されたルートはサーバー側の許可リストで検証し、重大なインシデントが誤分類によって隠れないようにエスカレーションルールを別途持ちます。
モデルルーティング
高価な生成モデルを呼ぶ前に、タスクの難易度を判断します。Choiceでfast、balanced、reasoningを選び、Scoreで難易度を評価できます。最終的なプロバイダー、予算、記録はアプリケーションが管理します。
ツール呼び出しの安全確認
Agentがツールを実行する前に、不可逆な操作を含むかをNoulで判断します。Yesなら明示的な確認や人によるレビューを要求します。ただし認証、認可、リソース所有権、入力制約は必ず決定的に確認してください。
コンテンツとリードのワークフロー
既知の編集キューにコンテンツを振り分け、リードの緊急度を評価し、レビューが必要なメッセージをマークできます。criteriaをバージョン管理し、全体平均だけでなく顧客層や安全カテゴリごとに性能を測定します。
コンテキスト圧縮とメモリ選択
長時間動くAgentでは、コンテキストを圧縮した後にどの事実を残すかが課題になります。ChoiceやScoreでツール結果を順位付けできますが、元データと保留理由を保存し、重要な事実の唯一のコピーを確率信号だけで削除しないでください。
確率と信頼度の使い方
確率と信頼度は信号であり、正しさの保証ではありません。Jev Playgroundで代表的なstateと回答形状を確認してから、APIキーを本番に接続するとよいでしょう。
しきい値はチュートリアルからコピーせず、ラベル付き評価セットから決めます。通常、境界、まれなケース、敵対的な表現、needs_reviewに送るべき例を含めます。誤りのビジネスコストも測定してください。誤った非エスカレーションは障害を広げ、誤ったエスカレーションはレビュー工数を増やします。誤ったモデル選択はコストと遅延を増やし、安全でないツール判断は不可逆な事故につながります。
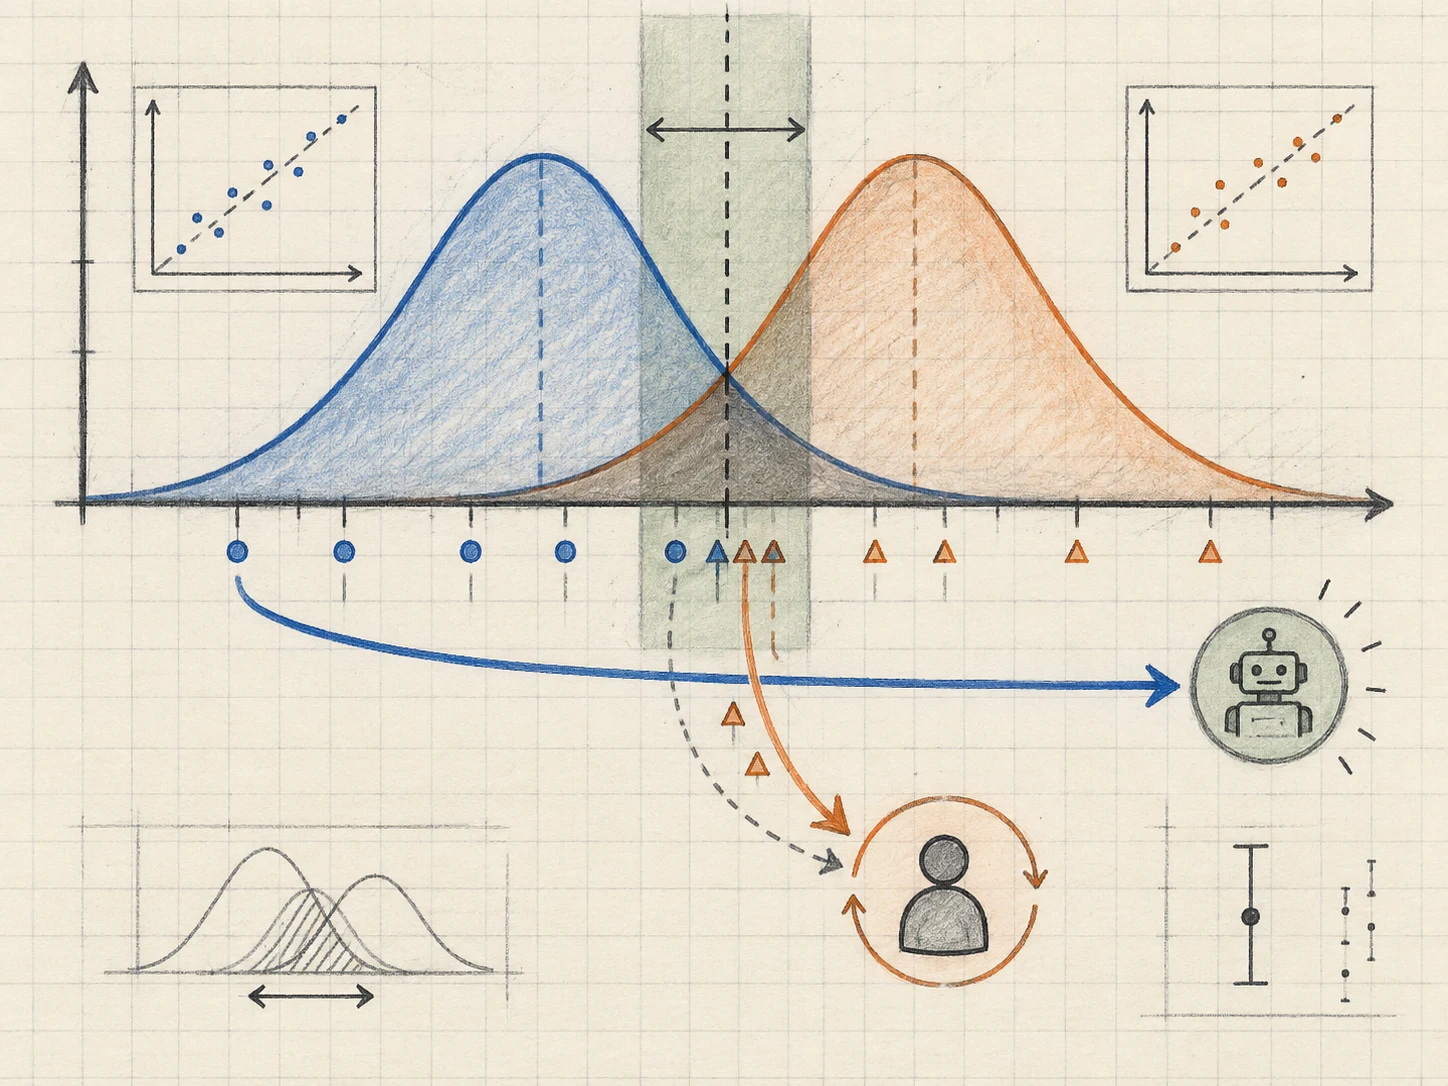
低リスクのコンテンツタグと、決済、アカウント制限、削除、デプロイで同じしきい値を使わないでください。高リスクの操作には、信頼度が高くても決定的なゲートと人による確認を残します。
監視するのは信頼度だけではありません。選択された回答、確率差、入力セグメント、人による修正、エスカレーション率、下流の結果、レイテンシ、利用不可率も記録します。入力分布が変われば、以前のしきい値は再評価が必要です。
セキュリティ、プライバシー、運用上の境界
APIキーはサーバー側の環境変数またはシークレット管理サービスに保存します。ログ、エラー、ブラウザバンドル、分析イベントにキーを含めないでください。質問に必要なstateだけを送信し、個人情報や機密情報がある場合は保持期間、アクセス制御、暗号化、削除を事前に決めます。
タイムアウトとリトライには上限を設けます。一時的な障害だけを再試行し、サーバーのリトライ指示を尊重します。レスポンス検証エラーをネットワークエラーとして再試行しないでください。リトライ回数を使い切ったら、安全なルールパスかレビューキューに戻します。
質問とcriteriaを、回答を解釈するコードと一緒にバージョン管理します。「critical」の意味を変更したり、カテゴリを追加したりした場合は、評価セットを更新し、旧版との結果を比較します。
執筆時点の公開ドキュメントでは、入力としてテキスト、JSONオブジェクト、テキスト配列が説明され、画像、音声、動画は直接入力としてまだ対応していないとされています。マルチモーダルデータを使う場合は、まず根拠のあるテキストまたは構造に前処理し、その前処理自体も別に評価してください。
導入計画とチェックリスト
最初は、頻度が高く、回答範囲が明確で、やり直せる判断を選びます。
- 探索: 匿名化した実データをPlaygroundで試し、別のエンジニアにも一貫して適用できるcriteriaにする。
- オフライン評価: 通常、曖昧、まれ、高コストな失敗例を含むラベル付きセットを作る。
- シャドー実行: 既存フローを正解として残し、Jevの提案だけを比較する。
- 支援モード: オペレーターに提案を表示し、修正を集める。
- 限定自動化: 測定済みで低リスク、かつ停止スイッチのある分岐だけを自動化する。
- 継続レビュー: ドリフト、利用不可、修正率、コストを監視する。
本番前には次を確認します。
- stateに無関係な秘密情報や個人情報が含まれていない;
- すべての質問に安定したIDと一つの目的がある;
- 回答空間に安全なフォールバックがある;
- リモートJSONを
unknownから実行時検証している; - 権限と不可逆操作をポリシー層が管理している;
- しきい値が測定した誤りコストに結び付いている;
- ネットワーク障害と検証エラーを区別している;
- APIキーがサーバー側にだけ存在する;
- 質問とcriteriaのバージョンを観測できる。
現在のプランや利用条件は、古い記事を参照せず、Jev AIの料金ページで確認してください。
Jevが適さないケース
長い説明、草稿、翻訳、自由な会話が主な出力なら、生成LLMの方が適しています。条件が完全に既知で厳密である必要があるなら、決定的なルールが適しています。データの保管場所、オフライン運用、推論基盤の完全な管理を最優先するなら、ローカルモデルや従来型の分類器が適する場合があります。
Jevの価値が最も大きいのはその中間です。入力は意味理解を必要とするほど複雑ですが、出力は業務判断に入れられるほど制約されています。モデルに権限や副作用を渡さずに、判断だけを補助させる境界です。
よくある質問
Jev AIとTypeSafe AIは同じものですか?
関連する言葉ですが、同じ名前として扱わないでください。Jev AIは公式サイトが説明する判断製品です。サイトはJevが独立運営で、TypeSafeとの提携・運営関係や推奨がないことを明記しています。ブランドや連携については必ず現在の公式ページを確認してください。
「型付き」なら回答は正しいですか?
いいえ。型付きレスポンスは検証と評価を容易にしますが、意味の正確さ、確率の校正、ビジネス上の正しさを保証しません。評価データ、しきい値、決定的なチェック、人によるレビューが必要です。
Jevは大規模言語モデルを置き換えますか?
すべての用途ではありません。Jevは分類、ルーティング、スコアリング、安全チェックなど、境界のある判断に向いています。自由な文章は生成モデルに任せ、実行前に型付き判断レイヤーを使う構成が現実的です。
ユーザーのレコード全体をstateに送るべきですか?
通常は送るべきではありません。質問に必要な最小のテキストまたは構造だけを送ります。プライバシー、監査、再現性が改善します。
Jevが利用できない場合はどうしますか?
利用不可を明示的な状態として扱います。操作を止める、既存のルールを使う、人に送るなど、ワークフローに応じた安全なフォールバックを実装します。タイムアウトを黙ってNoとして扱わないでください。
最初のJev AI TypeSafe AIプロジェクトには何がよいですか?
サポートルーティング、リード優先順位、モデル選択、ツールレビューなど、頻度が高く、境界があり、結果を測定できる判断を選びます。まずシャドー実行し、実行時検証と誤りコストを確認してから自動化します。
まとめ
jev ai typesafe aiの実践的な意味は、「LLMにJSONを返させる」ということではありません。関連するstateを渡し、明確な型付き質問を定義し、構造化された信号を検証し、ポリシーと実行をアプリケーションコードに残すことです。
この方法なら、TypeScriptで内部契約を表現し、実行時検証でネットワーク境界を守り、評価によって実際のワークロードで有効かを確かめられます。スキーマらしく見えるだけの長いプロンプトより、テスト、監視、改善がしやすいワークフローになります。