開発者ガイド
Jev TypeSafe:TypeScriptに型付きAI判断を組み込む
Jev TypeSafeの実践ガイド。型付き質問を定義し、API応答を実行時に検証して、TypeScriptアプリで不確実な判断を安全に振り分けます。
jev typesafeで検索すると、関連はあるものの異なる二つの概念に行き着くことがあります。Jevの型付きAI判断と、TypeScriptの型システムです。このガイドでは、コンパイル時の型を信頼できる実行時データと混同せずに、両者を連携する方法を解説します。Jevは状態に関する質問を評価して構造化された回答を返しますが、ネットワーク応答を検証し、アプリが何を実行できるかを決めるのはTypeScriptサービスです。
Jevのサイトでは、ソフトウェアチーム向けの独立した判断ツールとして紹介されています。JevはTypeSafeと提携・運営関係になく、TypeSafeからの推奨も受けていません。まずはJev AIのホームページとオンラインPlaygroundをご覧ください。
TypeScriptアプリで「Jevを型安全に使う」とは
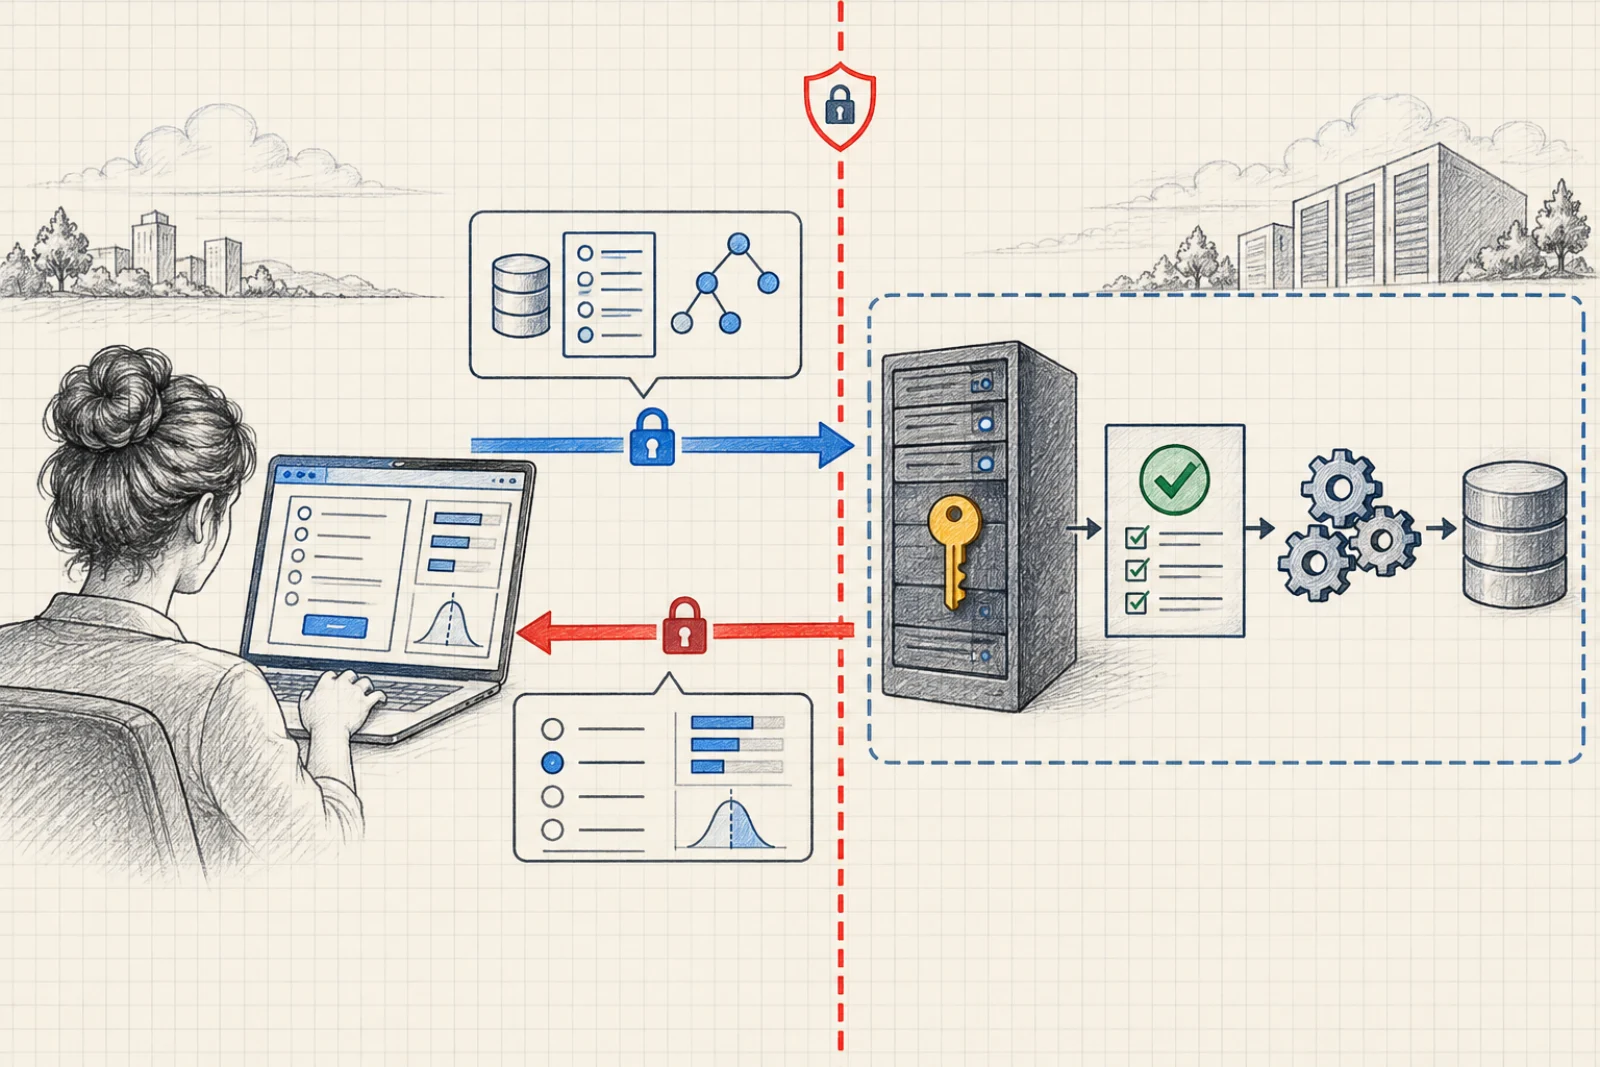
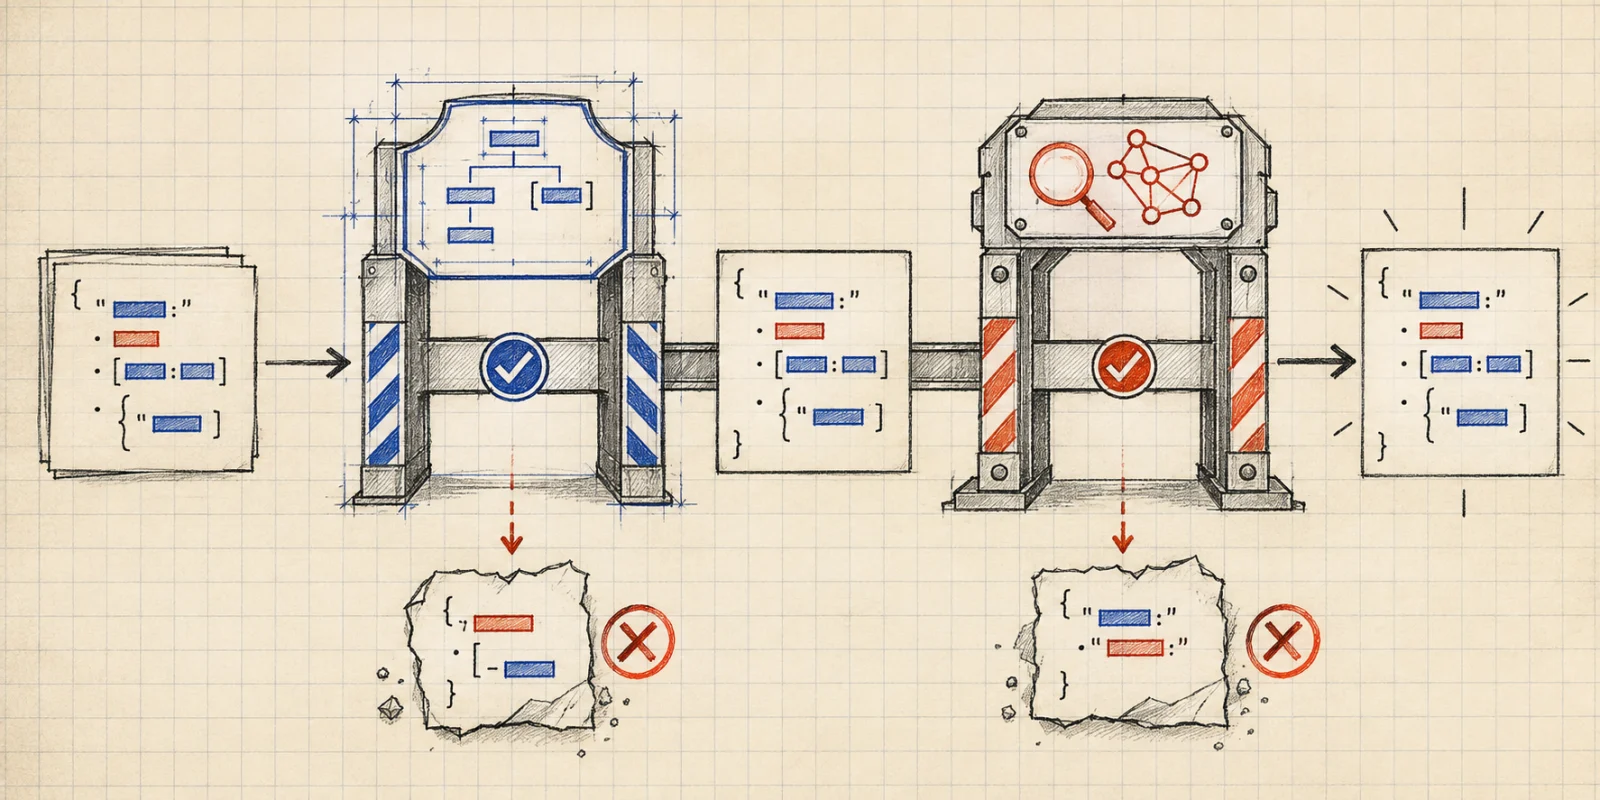
TypeScriptは実行前にコードを検査します。プロパティ名の誤りや関数に渡す内部データの型違いなどを見つけられます。しかし、リモートサービスのHTTP応答が宣言した型と一致することまでは証明できません。const answer: Decision = await response.json() のように宣言しても、コンパイラーにサーバーから返ると期待する型を伝えるだけで、受信したデータそのものは検査されません。
response.json() の値は、構造を確認するまでは unknown として扱います。この境界には二つの側面があります。
- リクエストの構築: TypeScriptで状態、質問の定義、内部IDの一貫性を保つ。
- レスポンスの解析: 実行時チェックで、リモートデータにアプリが読むフィールドがあることを確認する。
この区別は重要です。モデルの回答は判断材料であり、操作を実行する権限ではありません。認証、ビジネスルール、決定論的な検査、必要な承認はアプリ側で管理します。
Jevの三つの質問タイプ
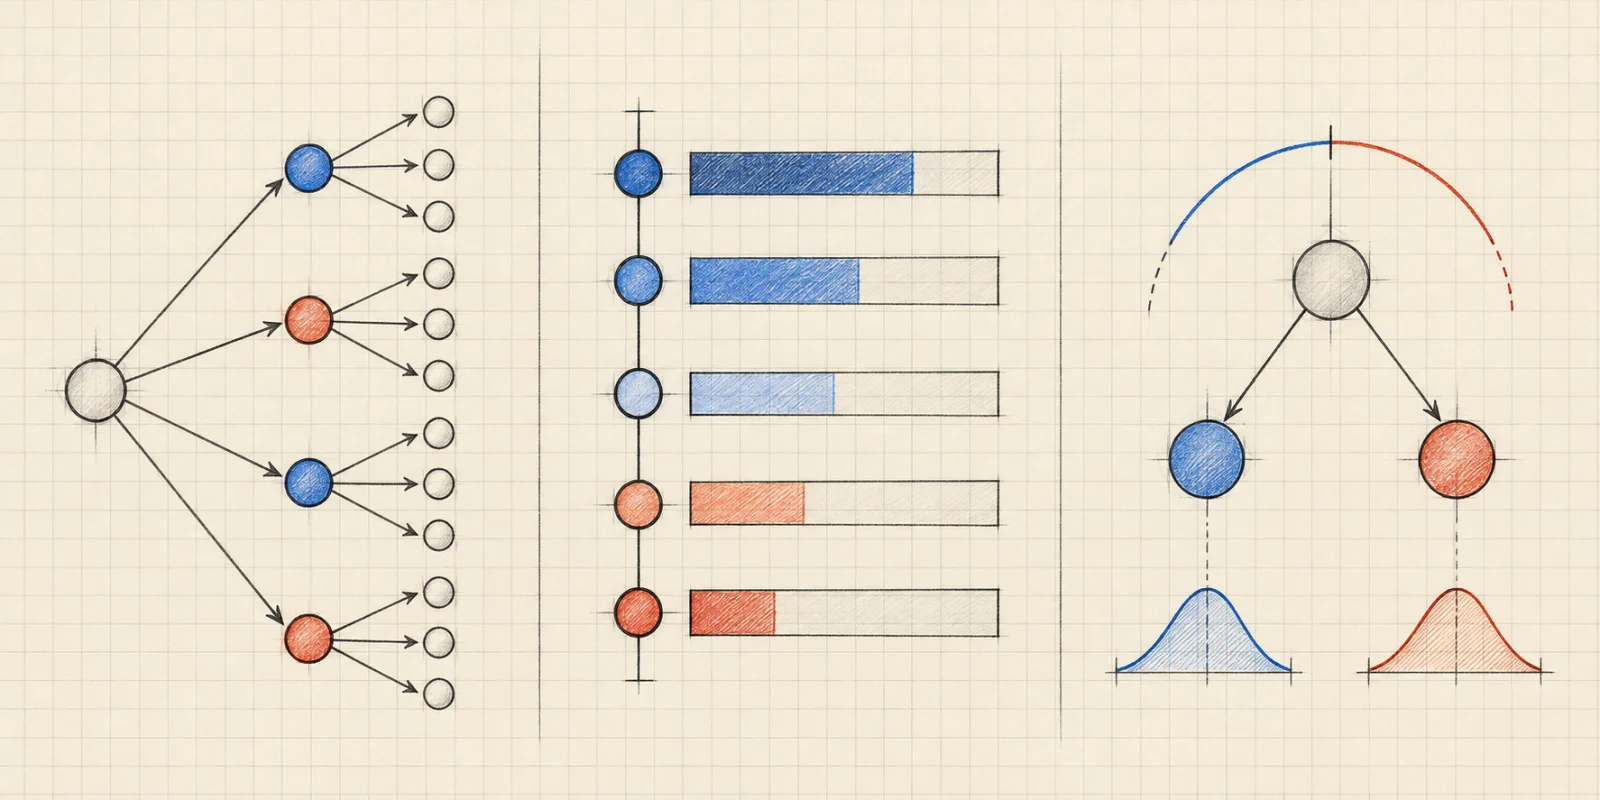
Jevの公式ドキュメントでは、三種類の質問形式が説明されています。幅広い一つのプロンプトで無関係な複数の処理をさせるのではなく、判断結果の形に合うタイプを選びます。
| タイプ | 適した用途 | 確認する結果 |
|---|---|---|
| Choice | チーム、キュー、カテゴリ、モデルの選択 | 選択肢、確率、confidence |
| Score | 重大度、品質、緊急度など順序のある尺度 | 加重スコア、レベルごとの確率、confidence |
| Noul | 一つの命題が正しいかの判断 | 回答が「はい」である0〜1の確率 |
結果の候補が決まっている場合はChoiceを使います。サポートチケットの担当先が請求、技術サポート、営業であれば、それぞれの条件を定義します。候補が網羅的でない場合は other や needs_review のような安全な選択肢を含めます。候補がなければ、分類器は最も近い不完全な選択肢を選ばざるを得ません。
回答に順序がある場合はScoreを使います。レベルを低い順から高い順に並べ、具体的に説明します。重大度の尺度なら、「低」「中」「重大」が対応する応答時間やエスカレーション方法まで決められます。Jevは確率分布と確率加重スコアを返すため、結果が名前付きレベルの間になる場合があります。それを明示的な業務ルールに変換するのはアプリの役目です。
Noulは「メッセージに返金の依頼が明記されているか」のような、単一のはい・いいえ命題に使います。noul は答えが「はい」である確率で、confidenceがもう一つ返るわけではありません。分類と条件判定の両方が必要なら、質問IDを二つ使って回答を別々に読み取ります。
リクエストを書く前に判断範囲を設計する
信頼できる連携は、小さく明確な判断契約から始まります。アプリが実行してよい具体的な操作、回答候補、入力に必要な根拠、結果が不確かな場合の処理を書き出します。そうすると、一つの「AIタスク」と考えていたものが、実際には二、三個の独立した質問だと分かることがあります。
例えばサポートフローでは、担当チームを選び、緊急度を評価し、メッセージに返金依頼が明記されているかを判定できます。これらの質問は同じ状態を共有し、一回のリクエストで評価できます。department、urgency、refund_requested のような安定したキーを付けると、コードが回答を取り出しやすくなります。画面上の表示名を変更しても、キーは変えないでください。
状態は判断に必要な情報を含めつつ、不要に膨らませないようにします。チケットの振り分けには、メッセージ、製品分野、アカウント区分が必要かもしれません。一方、顧客プロフィール全体、無関係な会話履歴、秘密情報は通常不要です。関連性の高い状態はレビューしやすく、送信コストを抑え、判断に無関係なデータの漏えいリスクも減らせます。
Jevは状態としてテキスト、JSONオブジェクト、テキストの配列を受け付けます。簡単なケースなら文字列、意味の異なるフィールドをまとめるなら構造化オブジェクトを使います。配列には、現在のメッセージと短いポリシー抜粋など、関連するテキストを入れられます。公式ドキュメントに記載された現在の入力形式では、画像、音声、動画は直接扱いません。必要な場合はOCRや文字起こしなどで関連テキストに変換してから渡します。
型付きリクエストを作り、レスポンスを検証する
以下はサーバー側のTypeScriptサービスから、ドキュメントに記載されたSystem Oneエンドポイントを呼び出す例です。リクエスト型で記述時のミスを防ぎ、レスポンスは unknown のまま受け取り、このフローで利用するフィールドを実行時に検査します。
type Question =
  | { type: "choice"; instructions: string; criteria: Record<string, string> }
  | { type: "score"; instructions: string; criteria: string[] }
  | { type: "noul"; instructions: string };

type EvaluationRequest = {
  model: "jev-latest";
  state: string | Record<string, unknown> | string[];
  questions: Record<string, Question>;
};

function asRecord(value: unknown): Record<string, unknown> | null {
  return typeof value === "object" && value !== null && !Array.isArray(value)
    ? (value as Record<string, unknown>)
    : null;
}

function isProbabilityMap(value: unknown): value is Record<string, number> {
  const map = asRecord(value);
  if (!map) return false;
  const entries = Object.values(map);
  if (entries.length === 0) return false;
  if (!entries.every(
    (item) => typeof item === "number" && Number.isFinite(item) && item >= 0 && item <= 1
  )) return false;
  const total = entries.reduce((sum, item) => sum + item, 0);
  return Math.abs(total - 1) < 0.02;
}

async function classifyTicket(ticket: string) {
  const apiKey = process.env.JEV_API_KEY;
  if (!apiKey) throw new Error("JEV_API_KEY is not configured");

  const request = {
    model: "jev-latest",
    state: { message: ticket },
    questions: {
      department: {
        type: "choice",
        instructions: "このチケットはどのチームが担当すべきですか?",
        criteria: {
          billing: "支払い、請求書、返金、または入金",
          technical: "バグ、障害、または連携の失敗",
          sales: "料金、アップグレード、または新規アカウント"
        }
      }
    }
  } satisfies EvaluationRequest;

  const response = await fetch("https://thejevai.com/v1/systemone", {
    method: "POST",
    headers: {
      Authorization: "Bearer " + apiKey,
      "Content-Type": "application/json"
    },
    body: JSON.stringify(request)
  });

  if (!response.ok) throw new Error("Jevリクエストに失敗しました:" + response.status);

  const payload: unknown = await response.json();
  const root = asRecord(payload);
  const answers = asRecord(root?.answers);
  const answer = asRecord(answers?.department);

  if (
    answer?.type !== "choice" ||
    typeof answer.choice !== "string" ||
    typeof answer.confidence !== "number" ||
    !Number.isFinite(answer.confidence) ||
    answer.confidence < 0 ||
    answer.confidence > 1 ||
    !isProbabilityMap(answer.probabilities)
  ) {
    throw new Error("Jevレスポンスの形式が想定と異なります");
  }

  const allowedTeams = ["billing", "technical", "sales"];
  if (!allowedTeams.includes(answer.choice)) {
    throw new Error("Jevが未定義のチームを返しました");
  }

  return {
    team: answer.choice,
    confidence: answer.confidence,
    probabilities: answer.probabilities
  };
}

const result = await classifyTicket("デプロイが3回失敗し、本番環境が500エラーを返しています。");
if (result.confidence >= 0.8) {
  // 振り分け前に許可リストと業務ルールを適用する。
} else {
  // 不確かなケースは人によるレビューキューへ送る。
}
この例は意図的に範囲を絞っています。担当チームの振り分けで使うレスポンス形状を検査し、確率が有限の範囲内にあることを確認し、アプリ独自の許可リストにない選択肢を拒否します。実際のアプリでは、操作に影響するすべてのフィールドを検証してください。表示専用の値が、知らないうちに制御信号にならないようにします。
JEV_API_KEY はサーバー側のシークレットストアに保管してください。ブラウザ用バンドル、公開リポジトリ、エラーメッセージ、分析イベントのプロパティに含めてはいけません。キーを含むコードをブラウザへ配信すれば、TypeScriptの型で値を隠すことはできません。
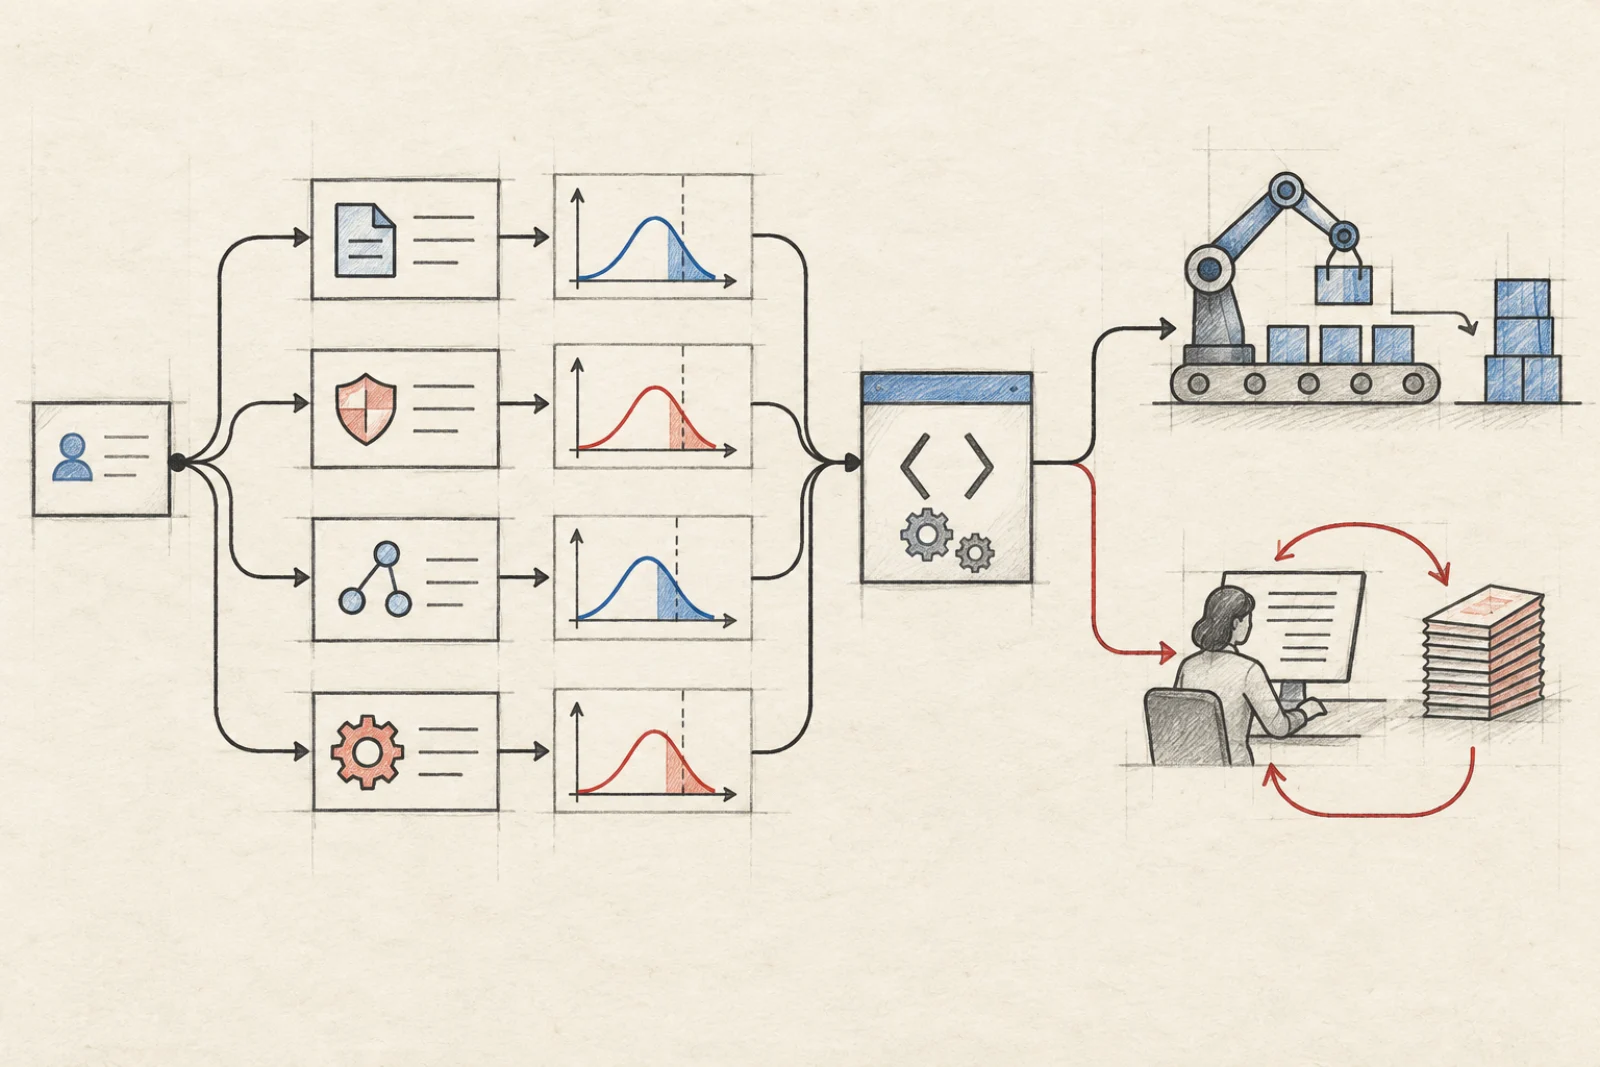
回答の形を読み、過信しない
レスポンスは送信した質問IDごとに整理されています。Choiceでは選択された候補、各候補の確率、confidenceを確認します。Scoreでは確率加重スコア、レベルの凡例、レベル別確率、confidenceを確認します。Noulでは「はい」の確率を読み取ります。すべての回答に同じフィールドがあると思い込まず、質問タイプごとの構造を検証します。
構造が正しい回答でも、特定の業務ケースでは誤り得ます。実行時検証が答えるのは「コードがこの値を安全に読めるか」です。評価が答えるのは「代表的な入力で、このフローが良い判断をするか」です。別々の確認であり、どちらも必要です。
あらゆる信号を汎用の success という真偽値にまとめないでください。アプリの方針が適切なフィールドを使えるよう、型付きの結果を保ちます。振り分けではChoiceの候補とconfidenceの閾値、優先度キューではScore、確認フローではNoulが役立つでしょう。明示的に対応付けておくと、後からレビューやデバッグがしやすくなります。
Confidenceは保証ではなく判断材料として使う
JevはChoiceとScoreに確率とconfidenceを返し、Noulには「はい」の確率を返します。これらはケースの比較や振り分けに役立ちますが、判断が正しいと証明するものではありません。confidenceは実測精度と同じではなく、高い値も安全を保証しません。
実際の入力分布に近いラベル付き評価セットを用意します。通常ケース、境界ケース、頻度は低くても失敗コストが高いケース、other や人手レビューにすべきケースを含めます。総合正解率だけではなく、結果ごとにエラーを測ります。緊急障害を低優先度キューへ送る失敗は、通常の依頼を誤ってエスカレーションするより高くつく場合があります。
観測した挙動と誤りのコストをもとに閾値を決めます。影響の小さい提案なら、人が簡単に修正できるため、低めの閾値でもよいかもしれません。支払い、アカウント制限、破壊的な操作では、モデルの信号が強くても決定論的なチェックと人の承認を残します。チュートリアルの閾値を万能の初期値としてコピーしないでください。
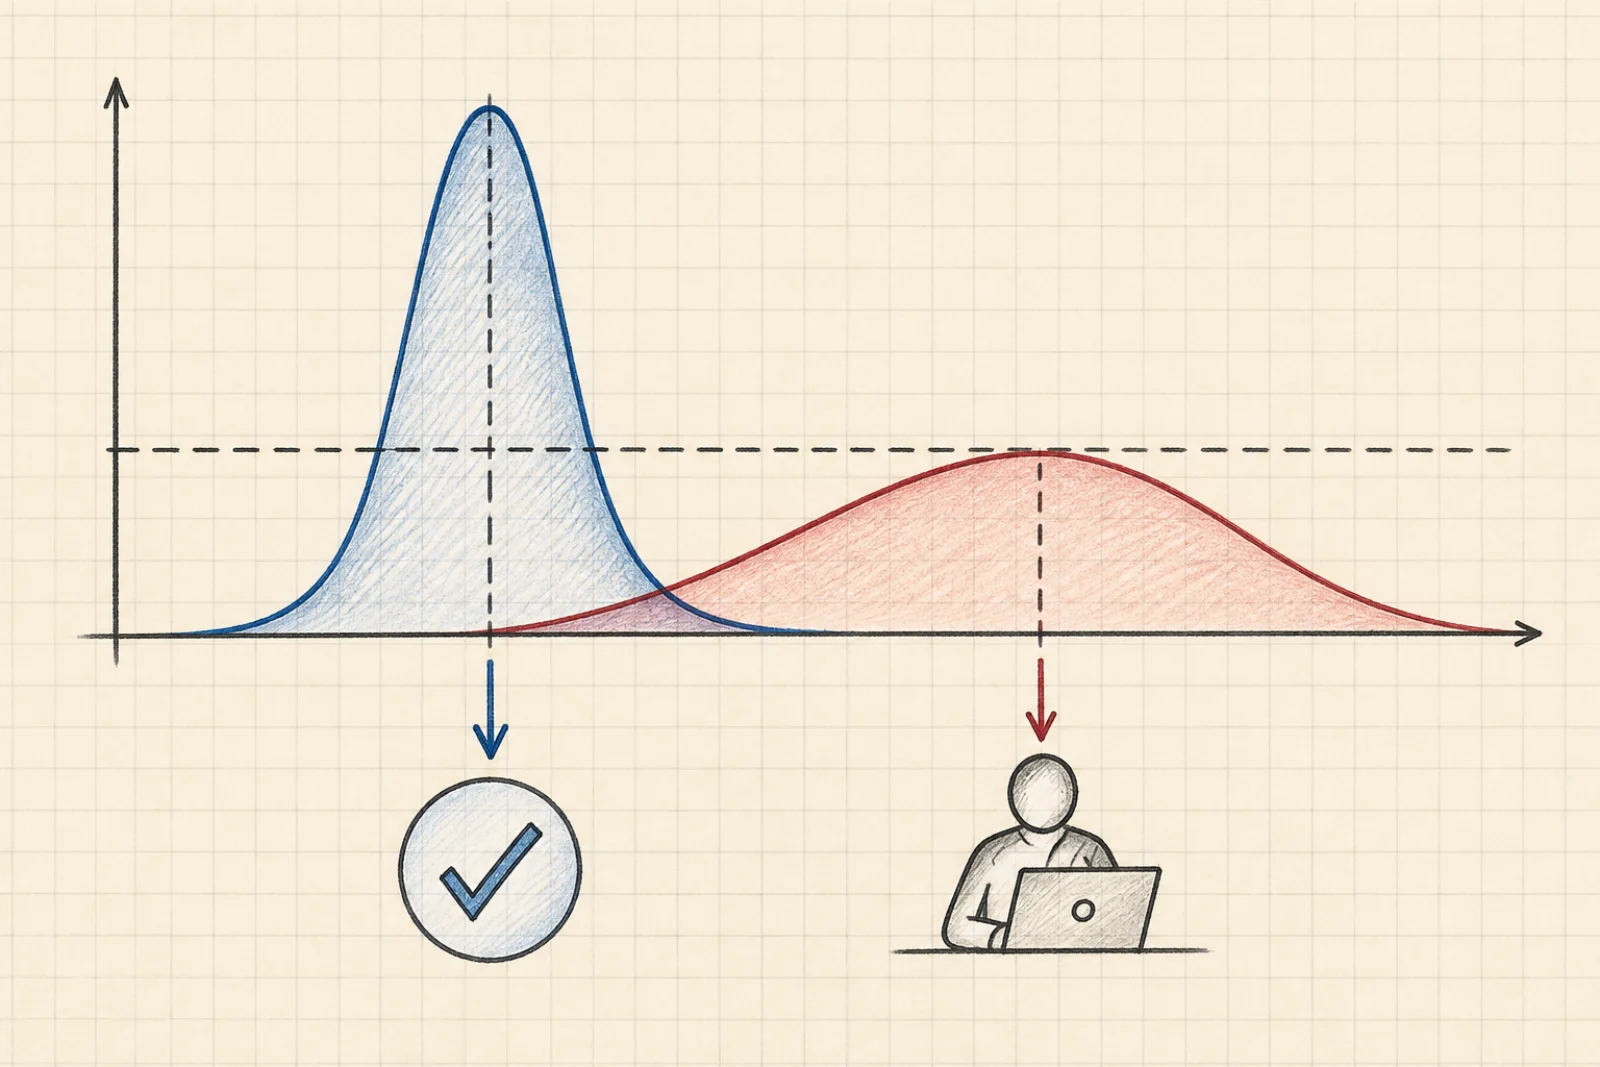
障害や不確かな結果も通常の分岐として扱う
Jevが回答を返す前に、ネットワークのタイムアウト、サービスのエラーステータス、レスポンス本文の解析失敗が起こる可能性があります。これらを明示的にモデル化してください。内部の結果型で decision、review、unavailable を区別すれば、通信障害が通常の「いいえ」と誤認されにくくなります。
処理内容に合った上限付きタイムアウトとリトライを設定します。一時的に解消しそうなエラーだけを再試行し、サーバーの再試行指示を尊重して回数を制限します。検証エラーをネットワーク障害のように再試行してはいけません。リトライ上限後も判断できなければ、先頭の候補を黙って選ばず、安全が分かっているキューまたは人手レビューへ戻します。
診断に必要な情報を記録します。利用できる場合はリクエスト相関ID、質問ID、レスポンス状態、検証結果、適用したポリシー分岐などです。APIキーや不要な個人データをログに残さないでください。監査のために元の状態を保存するなら、保持期間、アクセス制御、マスキング方針を定めます。
段階的にリリースする
段階的な導入によって、モデル品質の問題と連携上の不具合を切り分けやすくなります。
- 試す: JevのPlaygroundで代表的な状態と型付き質問を試し、曖昧な条件をコード化する前に修正します。
- オフライン評価: ラベル付きサンプルでリクエストフローを実行し、混同行列や業務コストの高いケースを確認します。
- シャドー運用: 既存フローを引き続き正としたまま提案だけを記録し、実際の結果と比較します。操作は実行しません。
- 担当者を支援: 操作者に提案を示して修正を収集し、抜けているカテゴリや分かりにくい基準を見つけます。
- 対象を絞って自動化: 実測閾値を満たし、安全なフォールバックもある分岐だけを有効にします。入力傾向が変わったときに停止できるようにします。
質問の文言や基準は、結果を解釈するコードと一緒にバージョン管理します。critical の意味を変えたり、担当チームを追加したりしたら、リリース前に評価セットで新しい挙動を確認します。入力構成、修正率、エスカレーション率、後続の結果を監視してください。レスポンス形式が安定していても、性能まで一定とは限りません。
よくある連携ミス
TypeScriptの型アサーションを信じる。 型アサーションが変えるのはコンパイラーの認識であり、サーバーが送ったデータではありません。unknown から解析し、使うフィールドを検証して、想定外の回答型は拒否します。
複合的な質問をする。 「チームを選び、緊急度を判断し、返金資格も決める」は別々の判断をまとめています。明確な質問IDを使い、通常のコードで結果を組み合わせます。厳密な資格条件は決定論的に判定します。
候補が合わないのに選ばせる。 条件が不十分だと、最も近いだけの誤った回答を選びやすくなります。受け皿の候補を追加するか、不確かなケースをレビューへ回します。
確率を実行許可とみなす。 確率はポリシーの根拠であり、ポリシーそのものではありません。認証、認可、レート制限、取り消せない操作の確認はサービス側の責任です。
レコード全体を送る。 コンテキストは多ければよいとは限りません。特に個人情報や機密情報を含む場合、質問に必要な情報だけを渡します。
Jev TypeSafe連携の本番チェックリスト
- APIキーはサーバー側のシークレットストアに保存し、組織の方針に従ってローテーションする。
- 関連するテキストや構造化フィールドだけを送り、無関係な個人情報や秘密情報を取り除く。
- Playgroundとオフライン評価セットで、通常、曖昧、敵対的、範囲外の例を確認する。
- 回答型、必須フィールド、値の範囲、確率の合計、アプリ独自の許可リストを検証する。
- タイムアウト、回数を制限したリトライ、エラー処理、安全なフォールバックを定義する。
- 認証情報や不要な機微データを記録せず、検証結果とポリシーの分岐をログに残す。
- 入力分布や業務上のコストが変わったら、閾値と質問条件を見直す。
現在のリクエストとレスポンスのフィールドはJev APIドキュメントで確認できます。本番の利用量を見積もる前に、プランと利用量も確認してください。
よくある質問
Jev TypeSafeはTypeScriptと同じものですか?
いいえ。Jevは選択肢、スコア、「はい」の確率など、型付きの判断結果を返します。TypeScriptは実行前にアプリのコードを検査します。堅牢な連携では両方を使い、リクエストと内部結果を型付けしたうえで、信頼できないネットワークデータを実行時に検証します。
TypeScriptの型でAPIレスポンスを検証できますか?
できません。JavaScriptの実行時には型注釈が取り除かれます。デコード後の値を unknown として扱い、振り分け、保存、表示で使う各フィールドを確認します。型ガードを使えば、検証済みの部分を安全に絞り込めます。
複数の質問で同じ状態を使えますか?
使えます。Jevは同じ状態に対する複数の型付き質問を並行評価できます。各質問を独立させ、安定したキーを付ければ、コードから回答を個別に参照できます。複雑な入れ子の判断を一つのプロンプトに詰めるより、分けた質問のほうがテストと組み合わせが簡単です。
Noulはconfidenceですか?
違います。Noulは命題が正しい確率です。ChoiceとScoreは回答の確率に加えてconfidenceも返します。質問タイプに合うフィールドを読み、測定した例から閾値を決めてください。
判断後の操作をJevに実行させられますか?
操作の実行はアプリ側で管理します。Jevには範囲を限定した質問を評価させ、認可チェック、許可リスト、決定論的ルール、承認手順で実行可否を決めます。こうすれば、不確かなモデル回答が未検証の副作用になるのを防げます。
最初のユースケースには何が適していますか?
候補が少なく、繰り返し発生し、影響の小さい判断から始めます。例えば、サポートチケットの担当チームを提案する用途です。ラベル付きサンプルを作り、各結果の意味と未知ケースの扱いを定義します。測定できるようになったら実行時検証を加え、自動化前に既存フローと比較します。
まとめ
jev typesafe の実践的な意味は、モデルの構造化された判断と、それを利用するアプリのロジックとの間に明確な境界を置くことです。質問の範囲を狭くし、必要な状態だけを送り、各レスポンスを実行時に検証し、代表的なサンプルで挙動を測定します。不確実なケースや影響の大きいケースには、明示的なレビュー経路を残します。TypeScriptは自分のコードを理解しやすくし、実行時検証は信頼できないデータからコードを守ります。