Guías para desarrolladores
Laya AI: guía de modelos e integración de la API
Conoce Laya AI, elige un modelo e integra la Laya API con un ejemplo ejecutable, decisiones tipadas, gestión de errores y un plan práctico de evaluación.
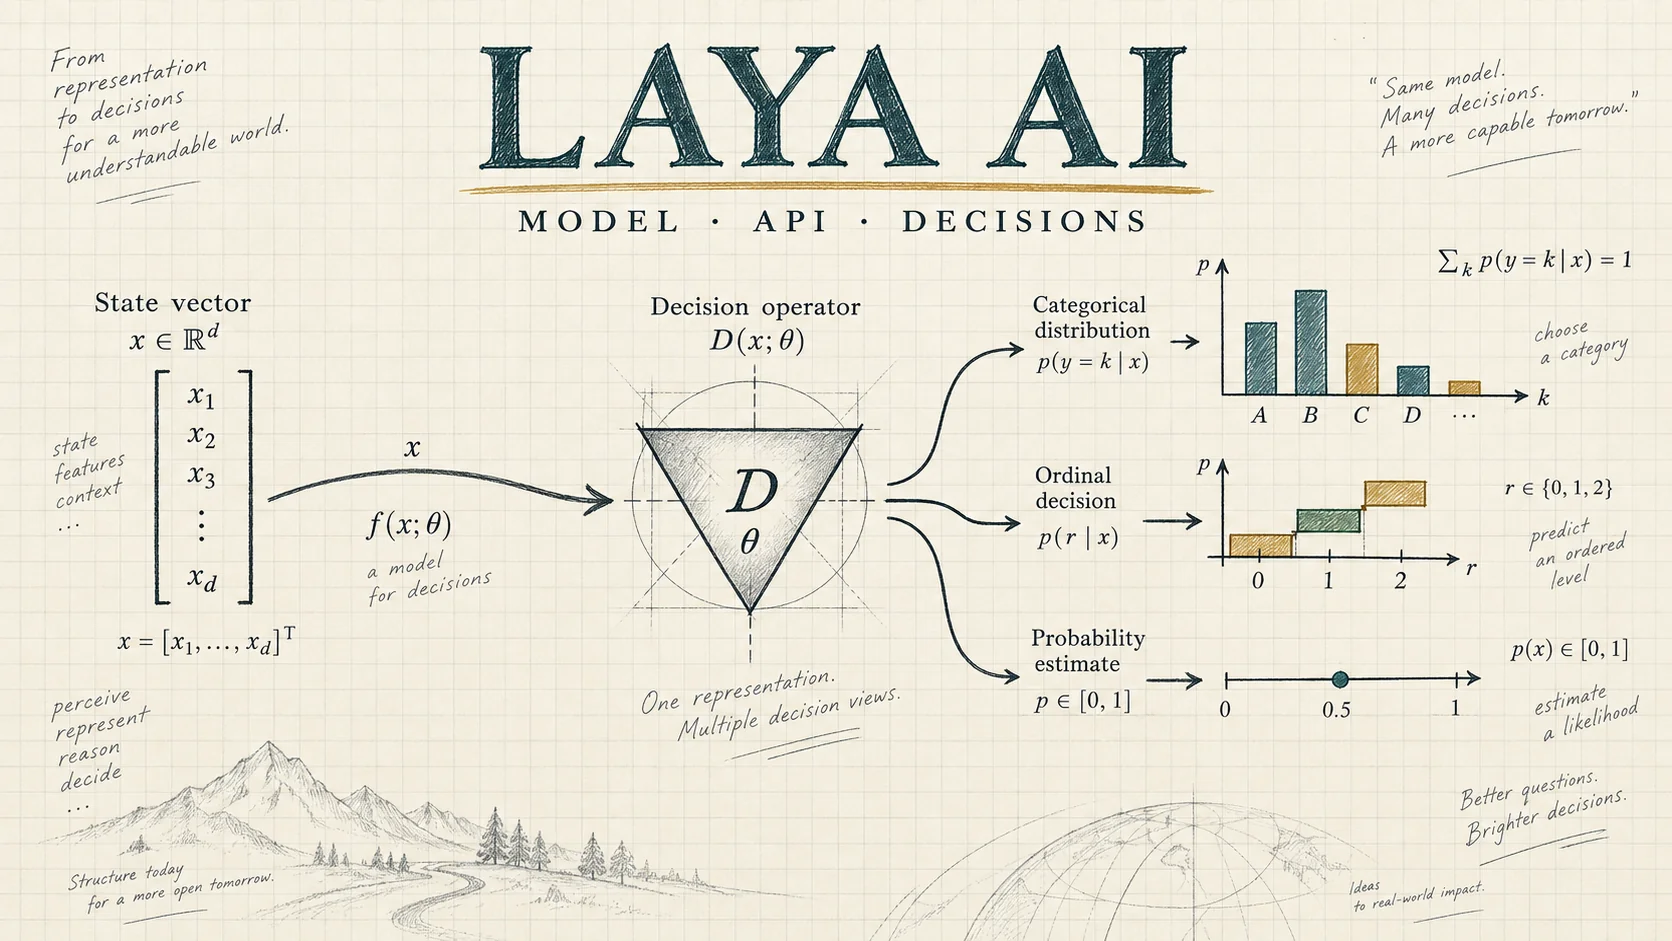
Laya AI convierte el contexto en decisiones delimitadas: una categoría, una puntuación en una escala ordenada o la probabilidad de una afirmación de sí o no. El modelo Laya resulta útil cuando tu aplicación ya conoce los resultados posibles y necesita ayuda para elegir entre ellos. Una Laya API permite acceder a estas decisiones mediante HTTP, pero el modelo y el servicio que expone la interfaz son cosas distintas.
Imagina un mensaje de soporte: «El proceso de compra dejó de funcionar tras la actualización. Los clientes no pueden pagar». Tu aplicación necesita un equipo de destino, una prioridad y, quizá, una indicación de que hace falta revisión humana. No necesariamente necesita generar un párrafo para cada decisión. Empieza con el playground de Laya AI para explorar este patrón con tus propios ejemplos.
Esta guía sigue ese flujo desde la elección del modelo hasta una petición a la API y su evaluación para producción. Los detalles del modelo proceden del proyecto original; los del endpoint describen el servicio de thejevai.com. Las fuentes se comprobaron el 28 de septiembre de 2026. Los ejemplos y las ilustraciones explican patrones de integración; no son resultados de rendimiento medidos.
Índice
- Qué es Laya AI
- Entender los tres tipos de decisión
- Elegir un modelo Laya para tu tarea
- Diseñar la decisión antes de llamar a la API
- Enviar tu primera petición a la Laya API
- Gestionar límites, errores y créditos
- Evaluar las decisiones antes de automatizar
- Desplegar un flujo útil de forma gradual
- Preguntas frecuentes sobre Laya AI, el modelo y la API
- Fuentes y mantenimiento
Qué es Laya AI
Laya es una familia de modelos de decisión de pesos abiertos creada por Convai Innovations y publicada bajo Apache-2.0. Su arquitectura no autorregresiva puntúa respuestas definidas en lugar de generar una contestación token a token. El checkpoint de inglés utiliza ModernBERT; el multilingüe utiliza mmBERT. El paquete Python del proyecto original incluye un enrutador y admite inferencia local.
Esta arquitectura encaja en clasificación, enrutamiento y evaluaciones concretas. Un modelo generativo puede redactar una respuesta al cliente mientras Laya aporta una señal para dirigir el caso. Ambos componentes pueden colaborar porque cumplen contratos de salida diferentes.
Conviene distinguir tres capas:
| Capa | Qué eliges | Qué debes verificar |
|---|---|---|
| Modelo | Checkpoint, revisión y entorno de ejecución | Exactitud en tu tarea |
| API | Autenticación y formato de peticiones y respuestas | Límites, disponibilidad y configuración real del servicio |
| Aplicación | Acciones permitidas y reglas de respaldo | Si una decisión puede desencadenar una acción |
La salida estructurada simplifica la integración, pero una etiqueta válida puede seguir siendo incorrecta. Del mismo modo, una licencia abierta no elimina los costes de alojamiento, y un benchmark de una GPU concreta no determina el tiempo de respuesta de tu aplicación.
Entender los tres tipos de decisión
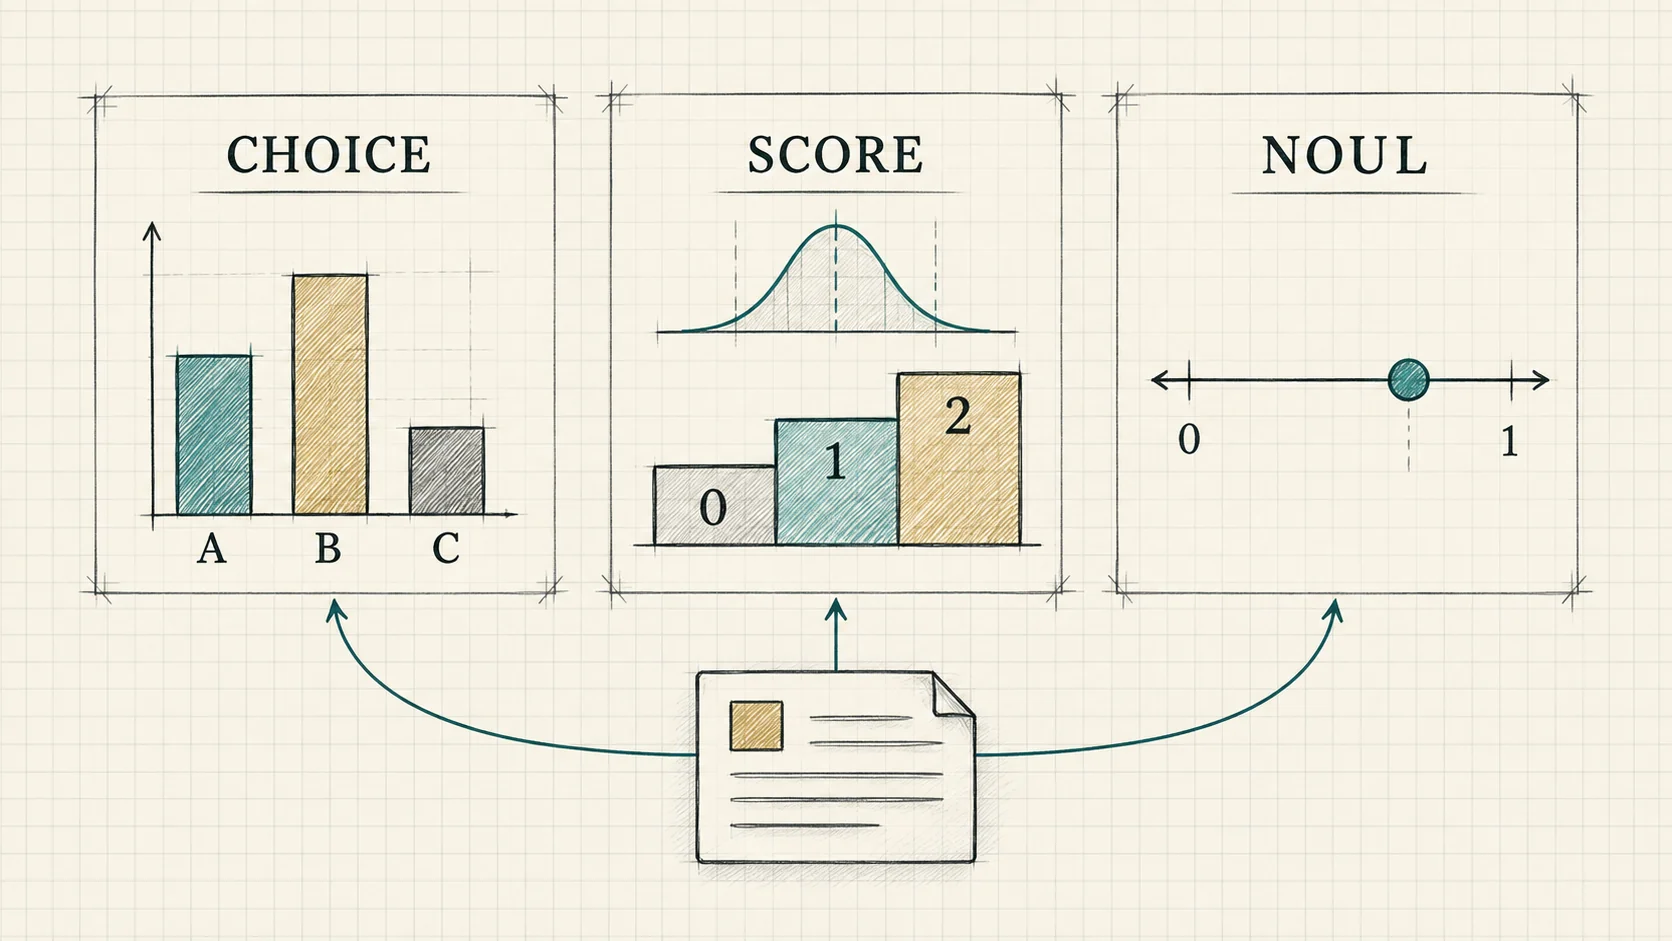
Choice: seleccionar un resultado con nombre
Usa choice para categorías con un significado claro, como billing, technical y other. El campo choice de la respuesta identifica la etiqueta seleccionada; también pueden aparecer campos de probabilidades. Describe las categorías de forma que una persona pueda aplicar las mismas reglas de manera consistente.
Por ejemplo, «me han cobrado dos veces» corresponde a facturación, mientras que «el proceso de compra se bloquea» corresponde al equipo técnico. Si un mensaje contiene ambos problemas, especifica cuál debe determinar el destino. La etiqueta other representa la categoría de respaldo que has definido; no significa automáticamente que el modelo haya detectado incertidumbre.
Score: evaluar en una escala ordenada
Usa score cuando el orden sea relevante. Una rúbrica útil de urgencia puede distinguir consultas rutinarias, trabajo bloqueado con una solución provisional e interrupciones del servicio sin alternativa. La interfaz alojada utiliza una escala que empieza en cero y el resultado puede ser fraccionario.
En una escala de tres niveles, 1.8 se sitúa entre el segundo y el tercero. No significa una probabilidad del 80 % de que haya una interrupción. Decide cómo manejará tu aplicación los valores intermedios y mide las infravaloraciones graves de prioridad por separado de las discrepancias menores entre niveles contiguos.
Noul: estimar una afirmación concreta
Usa noul para una pregunta específica de sí o no, como si el cliente solicita explícitamente un reembolso. Su valor es una estimación de probabilidad, no un booleano. Nunca lo conviertas con Boolean(value) de JavaScript: incluso un número positivo muy pequeño se convierte en true.
Separa la intención observada de la autorización. «Se solicita un reembolso» no demuestra que haya existido un pago duplicado ni que esté permitido devolver el dinero. Esas comprobaciones deben basarse en registros verificados y en la política de la aplicación.
Elegir un modelo Laya para tu tarea
La descripción del modelo Laya presenta la familia y su interfaz de decisiones. En el proyecto original, las principales opciones son el checkpoint de inglés, el multilingüe y uno ajustado para determinados flujos de decisiones tipadas.
| Candidato | Tarea razonable para empezar | Prioridad de evaluación |
|---|---|---|
| Inglés | Entradas predominantemente en inglés | Vocabulario del dominio y etiquetas ambiguas |
| Multilingüe | Entradas en otros idiomas o con idiomas mezclados | Resultados de cada idioma admitido que realmente recibes |
| Typed-decisions | Flujos parecidos a su especialización | Adaptación a tus etiquetas, políticas y documentos |
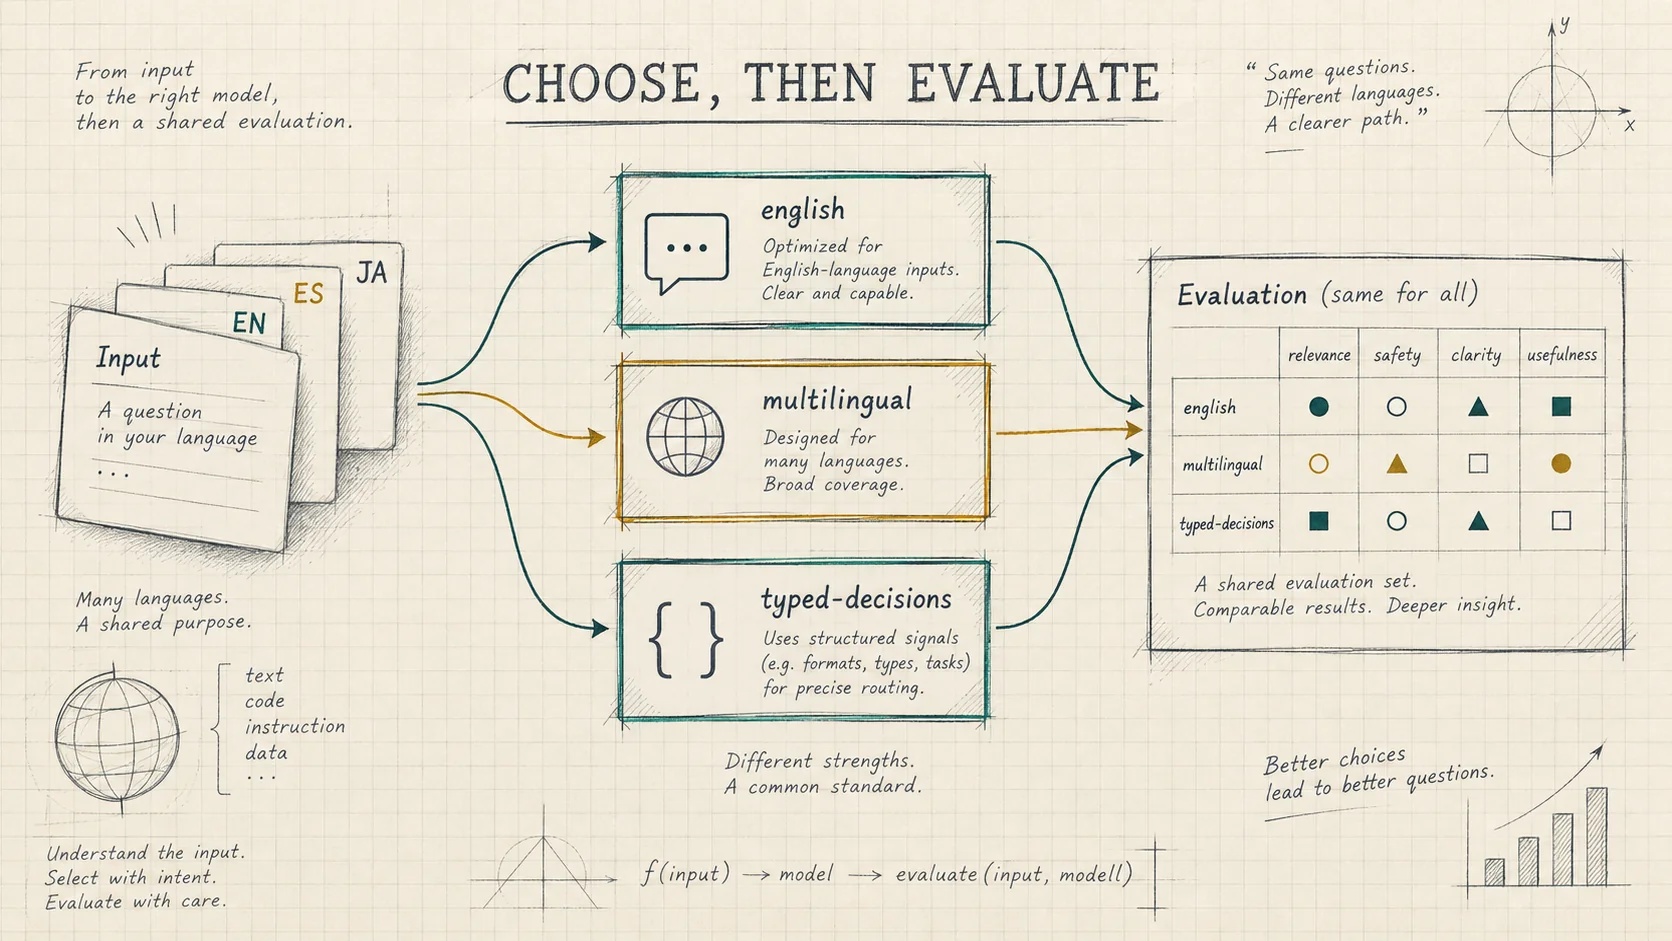
La API alojada acepta english, multilingual y typed-decisions como identificadores en la petición. Estos identificadores forman parte de su contrato público, pero no prueban que se utilice un checkpoint con una versión fijada. La implementación actual del proyecto usa un adaptador de proveedor. Confirma el modelo y la revisión que realmente atienden las peticiones antes de considerar las respuestas alojadas como evidencia sobre un checkpoint concreto de pesos abiertos.
Para comparar modelos de forma reproducible, ejecuta checkpoints de versiones fijadas en las mismas condiciones. Registra la versión del paquete, la revisión del modelo, el dispositivo, la redacción de las preguntas y los ajustes de contexto. No supongas que el servicio alojado expone todas las opciones del SDK local.
La cobertura lingüística también requiere pruebas prácticas. Una afirmación de amplia cobertura no garantiza la misma exactitud entre idiomas, jerga, transliteraciones o tickets con varios idiomas. Desglosa los resultados por estas condiciones en lugar de comunicar solo una media global.
Si tu taxonomía contiene decenas de etiquetas casi idénticas, prueba un diseño en dos etapas: selecciona primero una familia general y después una cola especializada dentro de ella. Esto permite describir mejor cada etiqueta, pero la primera etapa también puede enviar la petición a una rama equivocada. Compara el proceso completo con una referencia de una sola etapa, incluida la latencia adicional y la capacidad de recuperarse de una primera elección incorrecta.
Diseñar la decisión antes de llamar a la API
Empieza por una especificación que identifique las evidencias de entrada, los resultados permitidos y sus consecuencias. En la clasificación de tickets, el modelo puede recomendar una cola y un nivel de urgencia. El sistema de permisos existente sigue determinando quién puede emitir reembolsos o modificar cuentas.
Construye state con el contexto mínimo suficiente. Incluye el mensaje actual del cliente y los hechos verificados que sean pertinentes. Evita enviar todo el historial si solo importa el último informe de una avería. Si el modelo necesita conocer una condición de la cuenta, proporciónala expresamente en lugar de esperar que deduzca datos a los que no tiene acceso.
Redacta preguntas que sigan teniendo sentido al evaluarse de manera independiente. Una pregunta de prioridad no debe depender de leer la respuesta de otra pregunta de enrutamiento dentro de la misma petición. Cuando una decisión realmente dependa de otra, organiza pasos separados en el código de la aplicación.
Antes de integrar, prepara un pequeño conjunto de casos difíciles: un problema claro de facturación, una avería técnica, una petición mixta, un mensaje irrelevante, un ticket en otro idioma y un mensaje con información insuficiente. Añade negaciones, como «No estoy pidiendo un reembolso». Estos casos permiten detectar rápidamente criterios vagos que una demostración con ejemplos fáciles puede ocultar.
Enviar tu primera petición a la Laya API
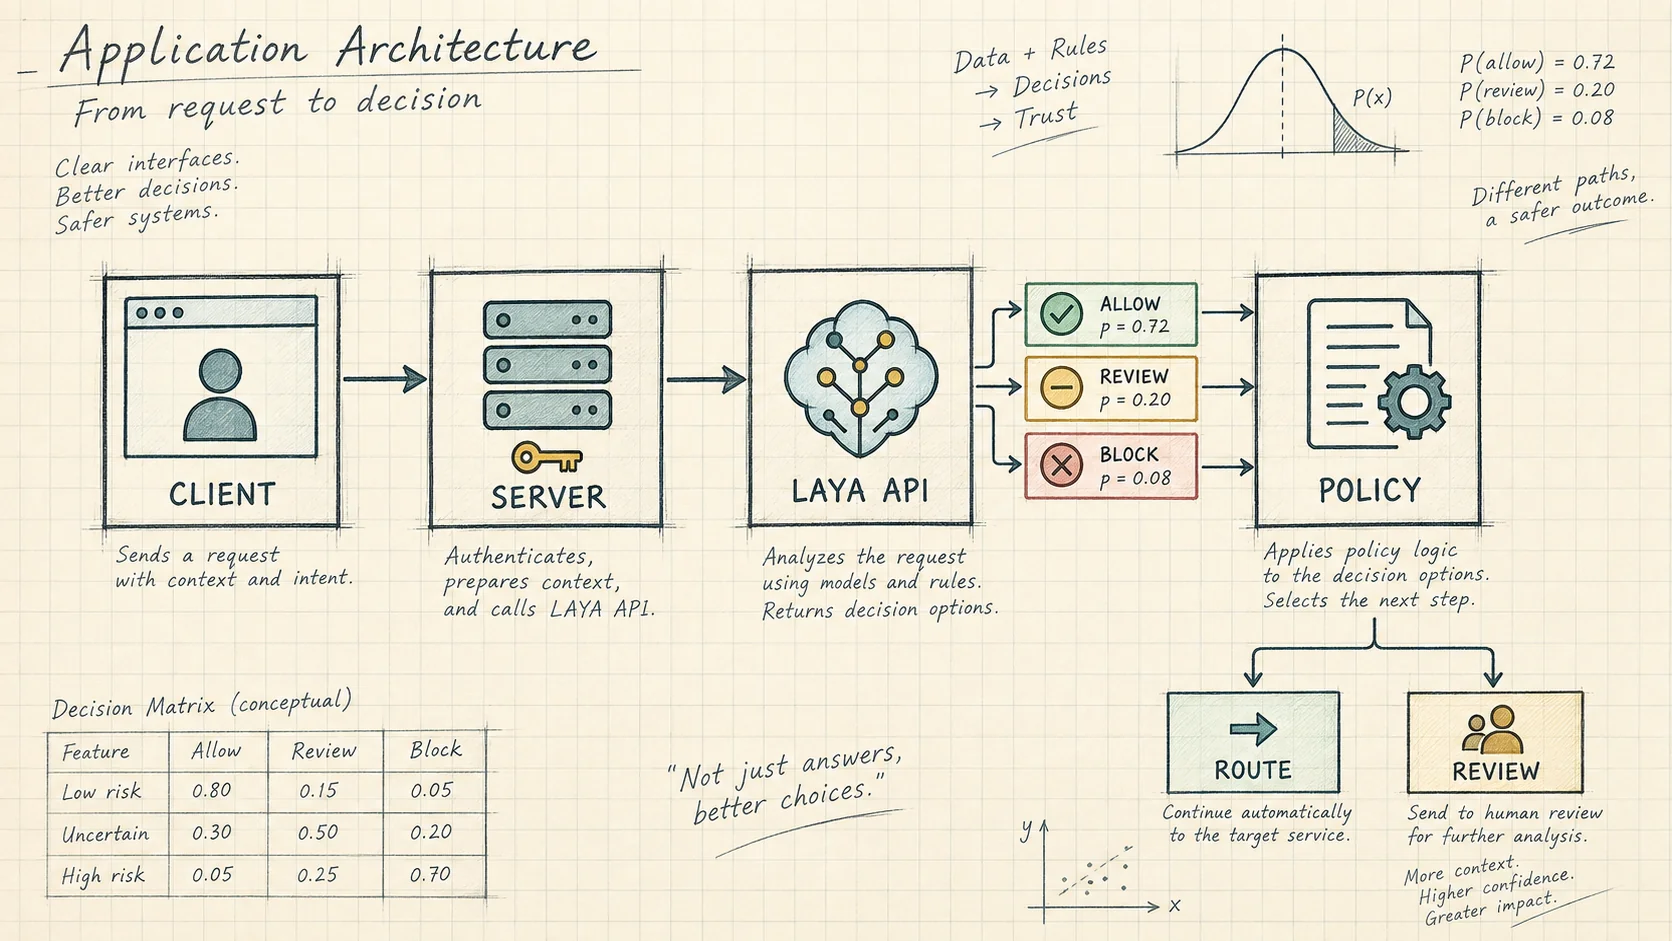
La documentación de integración de Laya API describe el endpoint del sitio, la autenticación y la estructura externa de la respuesta. Crea una clave API de tu cuenta, mantén suficientes créditos y guarda la clave en la variable de entorno del servidor LAYA_API_KEY.
Envía una petición POST a https://thejevai.com/laya/v1/systemone con autenticación Bearer y JSON. La ruta no lleva un prefijo de idioma. Haz la llamada desde un proceso de backend para que la clave nunca entre en el código distribuido al navegador.
Guarda este ejemplo como laya-triage.mjs y ejecútalo con Node.js 18 o posterior después de configurar la variable de entorno. Envía una sola petición y no reintenta automáticamente una operación que podría generar cargos. Las entradas de ejemplo se conservan en inglés para corresponder al modelo english.
const apiKey = process.env.LAYA_API_KEY;
if (!apiKey) throw new Error('Set LAYA_API_KEY on the server.');

const payload = {
  model: 'english',
  state: {
    message: 'Checkout crashes for every customer. Nobody can pay.',
    verified_status: 'No workaround has been confirmed.',
  },
  questions: {
    department: {
      type: 'choice',
      instructions: 'Which team owns the reported problem?',
      criteria: {
        billing: 'Charges, invoices, or refund requests',
        technical: 'Software failures or unavailable services',
        other: 'Issues outside billing and technical support',
      },
    },
    urgency: {
      type: 'score',
      instructions: 'Assess urgency using only the supplied evidence.',
      criteria: [
        'Routine question; work is not blocked',
        'Work is blocked but a workaround is confirmed',
        'Service is unavailable and no workaround is confirmed',
      ],
    },
    refund_requested: {
      type: 'noul',
      instructions: 'Does the customer explicitly request a refund?',
    },
  },
};

const response = await fetch('https://thejevai.com/laya/v1/systemone', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${apiKey}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify(payload),
  signal: AbortSignal.timeout(45_000),
});

const body = await response.json();
if (!response.ok || body.code !== 0) {
  throw new Error(`Laya request failed: HTTP ${response.status}`);
}

const answers = body.data?.result?.answers;
const department = answers?.department;
const urgency = answers?.urgency;
const refund = answers?.refund_requested;
if (
  department?.type !== 'choice' ||
  !['billing', 'technical', 'other'].includes(department.choice) ||
  urgency?.type !== 'score' ||
  !Number.isFinite(urgency.score) ||
  urgency.score < 0 ||
  urgency.score > 2 ||
  refund?.type !== 'noul' ||
  !Number.isFinite(refund.noul) ||
  refund.noul < 0 ||
  refund.noul > 1
) {
  throw new Error('Unexpected decision output; send this case for review.');
}

console.log({ answers, creditsUsed: body.data.creditsUsed });
Lee las respuestas en data.result.answers, usando los identificadores de pregunta que enviaste. Comprueba tanto el éxito HTTP como code === 0. Valida los tipos, las etiquetas y los rangos numéricos antes de utilizar el resultado. El ejemplo imprime las respuestas; conectar los errores con una cola de revisión es responsabilidad de tu aplicación.
La respuesta también ofrece el consumo de tokens y el tiempo de procesamiento dentro de data.result, además del cargo real de créditos en data.creditsUsed. El tiempo o el cargo de una respuesta ilustrativa no constituye una promesa para futuras peticiones. Registra por separado la latencia completa del cliente y el tiempo comunicado por el servidor.
Gestionar límites, errores y créditos
En el momento de la comprobación, este endpoint alojado acepta un cuerpo JSON UTF-8 de hasta 32 KiB y entre una y ocho preguntas. Una pregunta Choice permite 2–100 opciones; una pregunta Score acepta 2–10 descripciones ordenadas. Las llamadas al playground con sesión iniciada deben separarse al menos tres segundos. Esa regla del playground no debe presentarse como un límite universal para las claves API.
La petición de inferencia tiene un tiempo límite de 30 segundos. El cliente necesita tiempo adicional para el transporte y la respuesta completa, aunque ampliar su espera no prolonga el límite de inferencia del servicio.
| Estado HTTP | Significado | Siguiente paso adecuado |
|---|---|---|
| 400 | Petición no válida | Corregir los campos o los criterios |
| 401 | Fallo de autenticación | Revisar la clave del servidor |
| 402 | Créditos insuficientes | Restablecer un saldo suficiente |
| 413 | Cuerpo demasiado grande | Reducir el contexto o dividir el trabajo |
| 429 | Peticiones demasiado próximas | Respetar Retry-After cuando se incluya |
| 502 | Fallo de inferencia o datos devueltos no válidos | Investigar el fallo antes de decidir si se reintenta |
| 503 | Servicio no disponible | Usar una alternativa o intentarlo más tarde |
El endpoint no documenta una clave de idempotencia. Tras agotarse la espera del cliente, la primera petición todavía puede completarse y generar un cargo. Los reintentos indiscriminados pueden duplicar tanto el trabajo como los costes. Conserva el estado local de la tarea, comprueba el resultado cuando sea posible y decide de forma explícita cuándo repetir la operación.
También debes distinguir el tamaño de la petición del contexto del modelo. Cumplir el límite HTTP de 32 KiB no demuestra que cada frase u opción quepa en el presupuesto de tokens del checkpoint. Prueba específicamente las entradas largas y los conjuntos grandes de etiquetas.
Evaluar las decisiones antes de automatizar
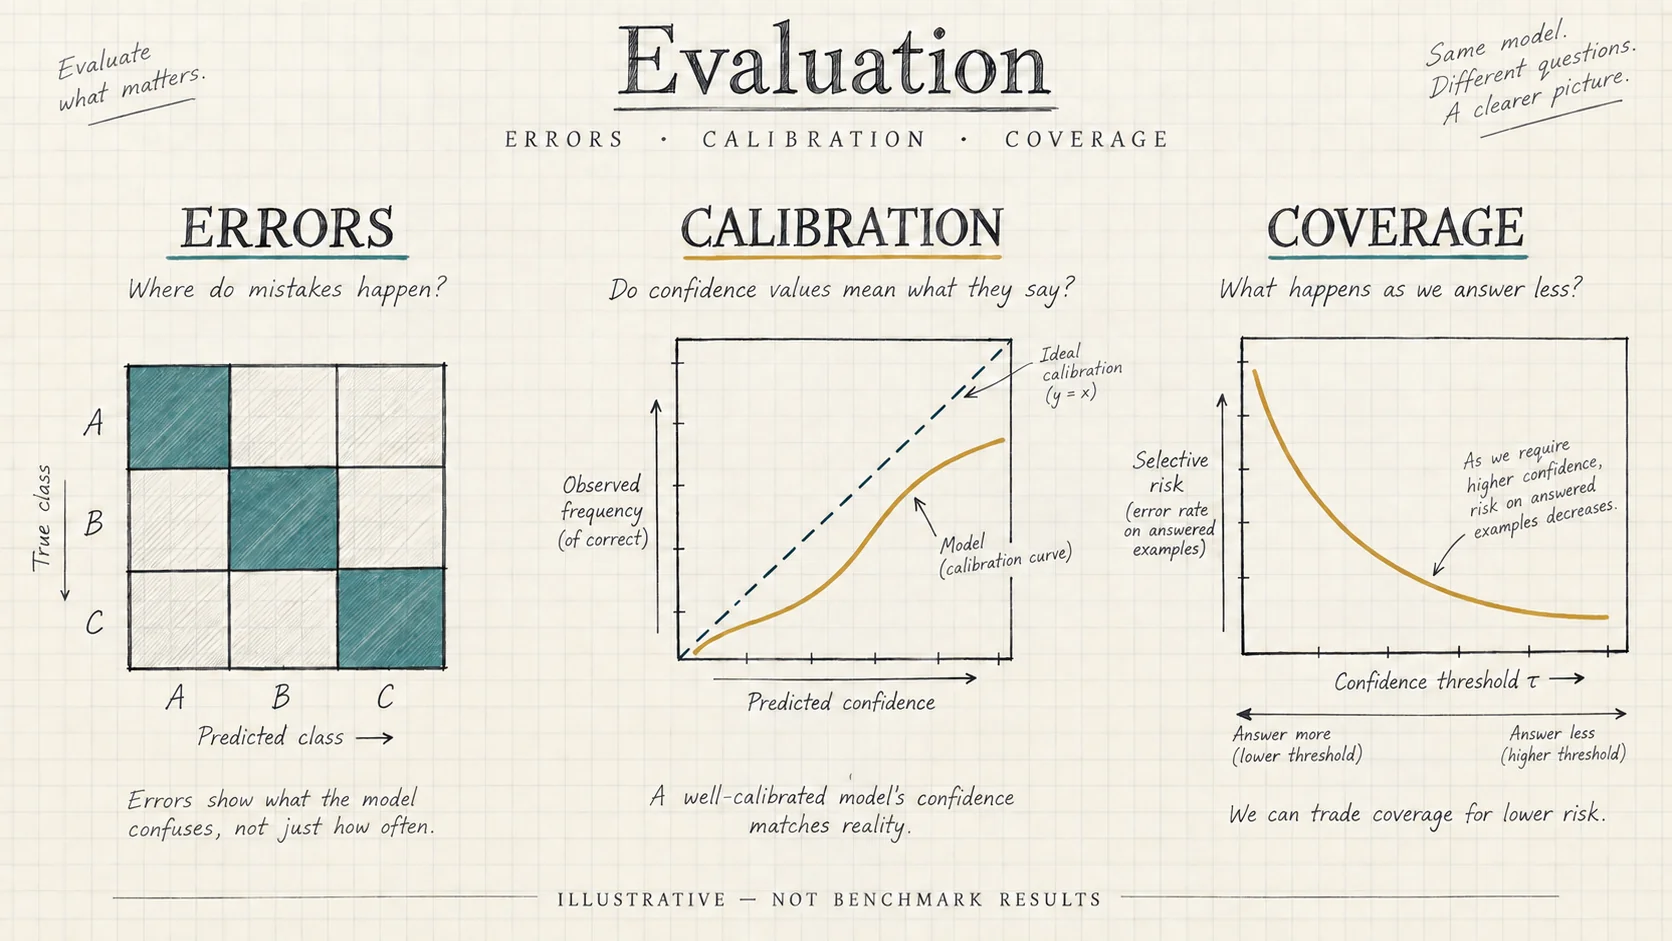
Construye un conjunto de evaluación con ejemplos reales del flujo, tratados de forma adecuada. Separa los datos para ajustar umbrales del conjunto de prueba final. Mantén juntos los mensajes relacionados al dividir los datos, para evitar que tickets casi duplicados se filtren entre entrenamiento, validación y prueba.
Mide cada salida según sus consecuencias. Para el enrutamiento, revisa una matriz de confusión y la precisión y sensibilidad de cada clase. Para la urgencia, cuenta las infravaloraciones graves además del error medio. Para detectar solicitudes de reembolso, prueba peticiones explícitas, negaciones, discusiones hipotéticas y mensajes citados.
La calibración merece una comprobación propia. Agrupa predicciones con probabilidades similares y compáralas con las frecuencias observadas. Si las predicciones próximas a 0.8 solo aciertan la mitad de las veces, un umbral basado en esos números se comportará de forma distinta a lo que su valor sugiere. Cualquier ajuste de calibración debe estimarse sin utilizar el conjunto de prueba final.
La ficha original del modelo comunica limitaciones importantes, entre ellas el exceso de confianza y la sensibilidad al presupuesto de tokens de las etiquetas. También describe un fallo de noul en el que los nombres de las opciones pueden dominar la entrada. Si las respuestas binarias parecen atascadas, investiga con ejemplos contrastantes y compara una formulación de choice con dos opciones. No des por hecho que esa alternativa funciona sin medirla.
Evalúa la abstención como una compensación entre objetivos. La cobertura es la proporción de casos que se procesan automáticamente y el error selectivo es la tasa de error dentro de ese subconjunto. Elevar el umbral puede reducir la automatización y aumentar la cola de revisión. Informa de ambos indicadores y del trabajo de revisión, en lugar de destacar solo la exactitud sobre un subconjunto fácil cada vez más pequeño.
Incluye también una referencia sencilla. Una regla determinista para un código de avería concreto o un clasificador de colas ya existente quizá resuelva algunos casos a bajo coste. Compara Laya con esa referencia usando las mismas entradas y definiciones de resultado. Conserva un registro breve de fallos representativos y sus causas, y cambia un factor cada vez: la pregunta, la evidencia proporcionada, el checkpoint o el umbral. Así podrás explicar las mejoras y reducir la tentación de ajustar una demostración hasta que simplemente parezca convincente.
Desplegar un flujo útil de forma gradual
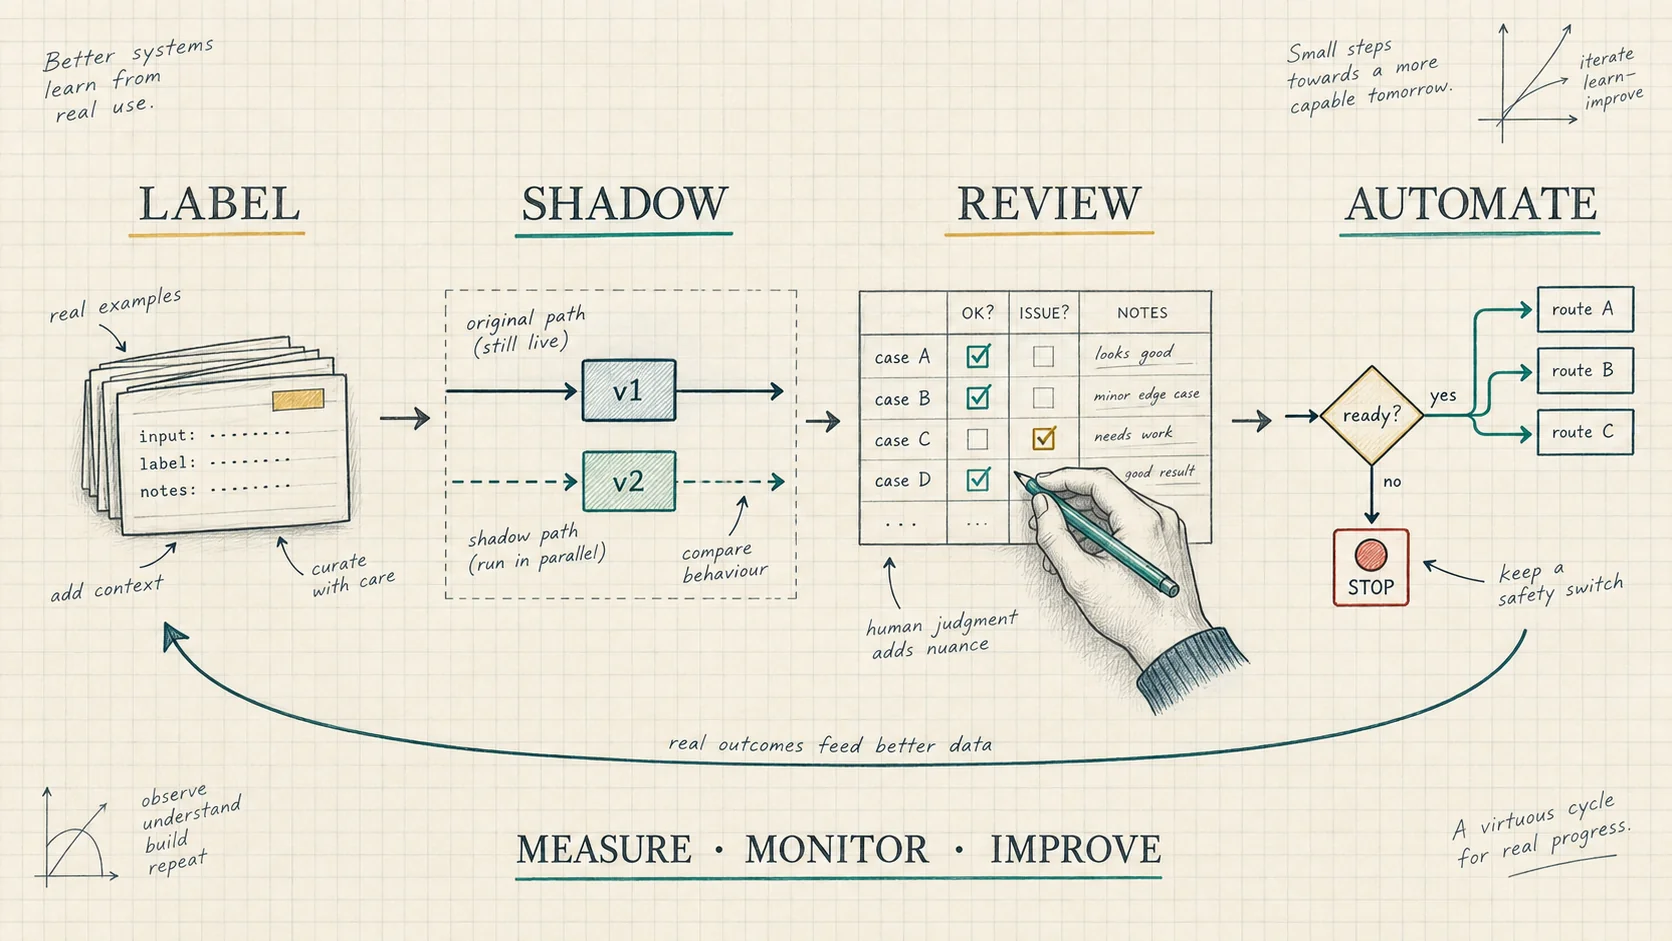
Empieza en modo sombra: registra las recomendaciones mientras el flujo existente sigue determinando los resultados reales. Compara las decisiones con las resoluciones humanas e investiga los grupos de desacuerdos. Un error repetido puede indicar etiquetas poco claras, falta de contexto, un idioma inadecuado o un modelo que no encaja en la tarea.
Después, permite que el personal revise las recomendaciones antes de actuar. Esto revela el coste de revisión, si las puntuaciones se entienden y si el destino propuesto realmente ahorra tiempo. Automatiza una acción limitada y reversible solo cuando la tasa de error medida y el beneficio operativo lo justifiquen.
En un piloto de soporte, define el éxito antes de empezar: errores de enrutamiento aceptables, máximo de urgencias graves pasadas por alto, capacidad de revisión y alternativa cuando falle el servicio. Mantén un interruptor sencillo para recuperar el enrutamiento anterior. Los revisores deben poder corregir una etiqueta sin alterar inadvertidamente la política subyacente, y esas correcciones deben alimentar el siguiente conjunto de evaluación.
Registra suficientes metadatos para reproducir los fallos: tu identificador de petición, la versión del esquema, el identificador de modelo enviado, la información disponible sobre la versión que presta el servicio, la latencia, el cargo y el resultado final. Minimiza el contenido de clientes almacenado. Vigila cambios en el idioma de entrada, la frecuencia de etiquetas y el volumen de revisión, porque pueden revelar desviaciones antes que una métrica global de exactitud.
Compara la economía del flujo completo. Los créditos del servicio alojado, la infraestructura propia, el mantenimiento técnico, la revisión humana y las acciones incorrectas contribuyen al coste. La comparativa Jev vs. Laya aporta contexto sobre otras decisiones de despliegue. Elige la configuración que funcione bien con tus evidencias y restricciones operativas.
Preguntas frecuentes sobre Laya AI, el modelo y la API
¿Laya AI es un chatbot?
Su propósito principal es tomar decisiones delimitadas. Úsalo para seleccionar, evaluar o clasificar; utiliza un modelo generativo cuando necesites texto abierto. Una aplicación puede combinar ambos.
¿El modelo Laya es gratuito?
Los pesos publicados usan Apache-2.0. Ejecutarlos sigue requiriendo recursos de cómputo y trabajo operativo. El servicio alojado descrito aquí consume créditos de la cuenta, por lo que los pesos abiertos no deben confundirse con peticiones alojadas gratuitas.
¿La Laya API elige automáticamente un checkpoint?
La API de este sitio exige un identificador explícito de modelo. El SDK local del proyecto original incluye un enrutador, pero no debes suponer que su comportamiento y sus opciones se aplican a todos los servicios alojados.
¿Las probabilidades de Laya pueden autorizar una acción?
Una probabilidad puede orientar una política, pero no otorga permisos ni verifica hechos ausentes de la entrada. Mantén las acciones con consecuencias sujetas a comprobaciones de la aplicación y a un proceso de revisión adecuado.
¿Conviene empezar con inferencia local o con la API alojada?
Utiliza la interfaz alojada para explorar el contrato de petición y el flujo de trabajo. Elige inferencia local con versiones fijadas cuando necesites experimentos de un checkpoint concreto o control de la infraestructura. Evalúa ambas opciones con los mismos casos representativos.
Fuentes y mantenimiento
El repositorio original de Laya documenta la instalación, el enrutamiento, el servicio de inferencia y las opciones de ejecución. La ficha del modelo de Convai Innovations describe checkpoints, arquitectura, evaluaciones y limitaciones conocidas. Los detalles de las peticiones alojadas se comprobaron el 28 de septiembre de 2026 con las dos guías del sitio enlazadas anteriormente y la implementación del endpoint de este proyecto.
Antes de desplegar, vuelve a comprobar el backend, los límites y la revisión del modelo. Empieza por una decisión importante, mídela con ejemplos reales y amplía la automatización cuando los resultados lo respalden.