AIエージェント
Jev AIで信頼性の高いAIエージェントを構築する:ルーティング、安全対策、人によるレビュー
1つの言語モデルにすべてを判断させないエージェント設計を解説。Jev AIでモデル選択、ツール実行前の安全確認、リスク評価、人によるレビューを行い、実行権限はコード側に保つ方法を紹介します。
Jev AIでより信頼性の高いAIエージェントを構築する:ルーティング、安全対策、人によるレビュー
AIエージェントの難しさは、「モデルが答えられるか」ではなく、現在の状態でエージェントが行動すべきかどうかにあることが少なくありません。モデルを選ぶ、ツールを呼び出す、追加情報を求める、一時停止する、人に引き継ぐ、といった判断が必要になります。
すべての判断を1つの生成型LLMに任せると、計画、実行、安全確認が絡み合います。モデルがもっともらしい説明を返しても、安定した制御シグナルが得られないことがあります。その結果、問題が理解、権限、ツール、閾値のどこで起きたのか判別しにくくなります。
Jev AIはエージェントの独立した意思決定レイヤーとして機能できます。現在のStateを受け取り、短く明確なChoice、Score、Noulの質問を評価し、確率と確信度のシグナルをオーケストレーションコードに返します。エージェントが実行し、Jevが判断し、ルールと人が安全網になります。
このガイドでは、モデルルーティング、ツール実行前の安全対策、リスク評価、人によるレビュー、本番環境での評価を含む実用的なエージェント構成を紹介します。
基本原則: 1つのモデルに理解、判断、権限付与、実行を同時に任せないでください。判断をテスト可能な質問に分解し、最終アクションは制約されたコードで実行します。
目次
- エージェントに意思決定レイヤーが必要な理由
- Jev AIの役割
- パターン1:呼び出す前にモデルを振り分ける
- パターン2:ツール呼び出しを保護する
- パターン3:確率を使ってレビューを促す
- エージェントのStateと質問を設計する
- セキュリティと評価のチェックリスト
- よくある質問
エージェントに意思決定レイヤーが必要な理由
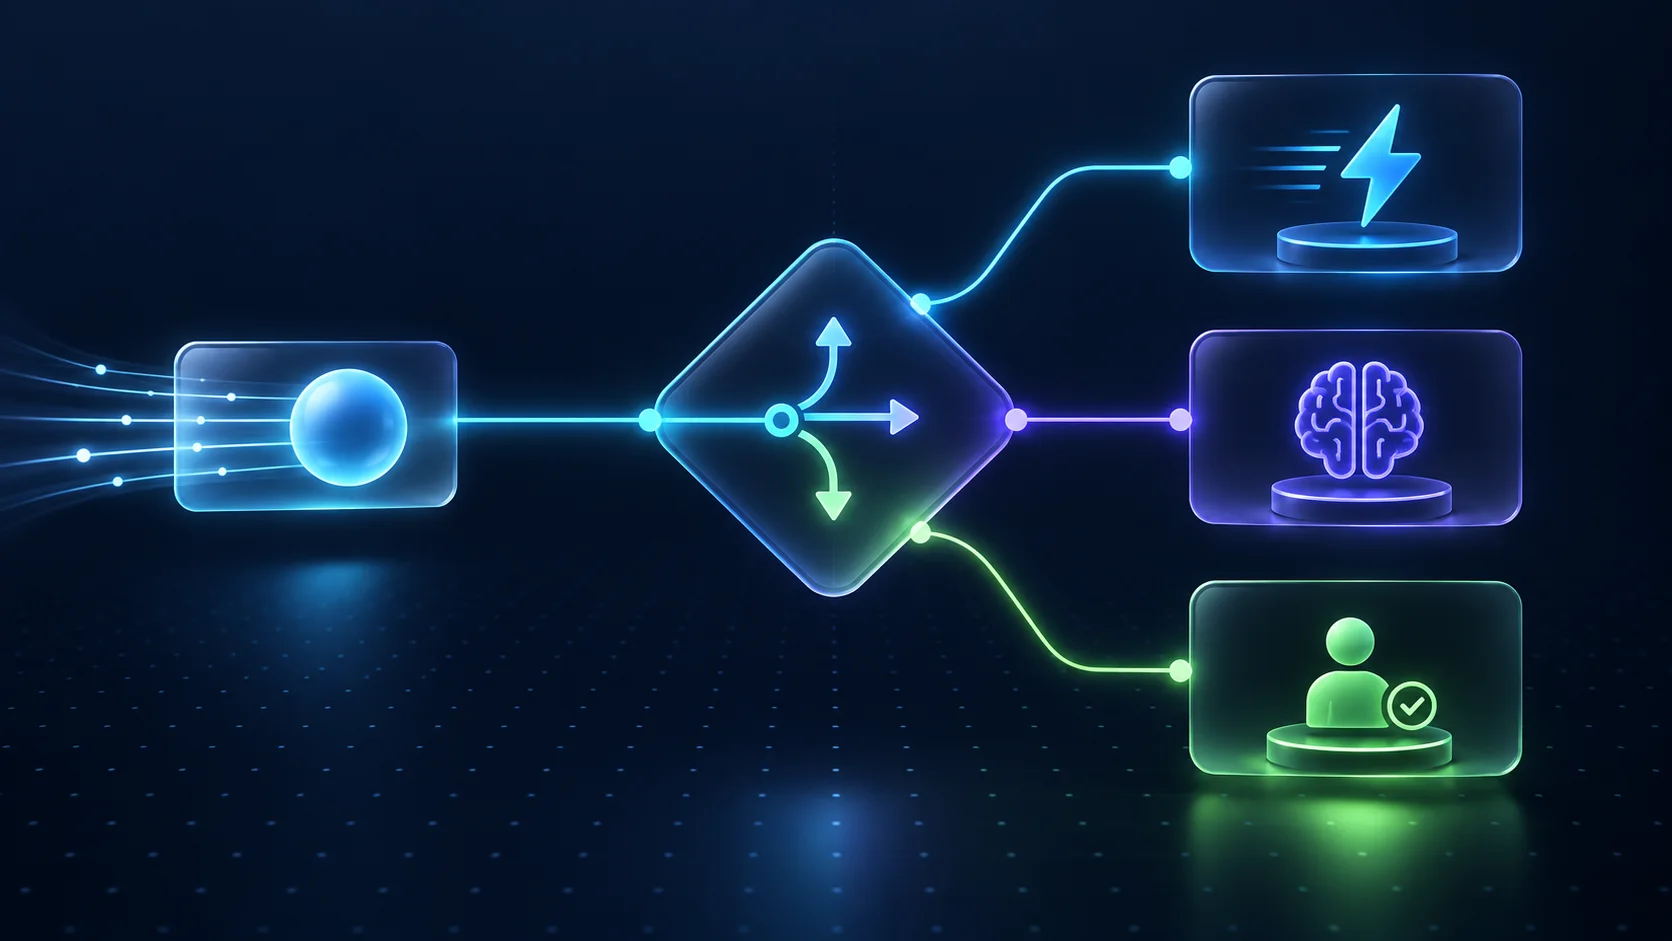
画像:判断と実行を分けると、ルーティング、安全対策、レビュー方針をテストしやすくなります。
生成された文章は権限ではない
LLMが「このファイルを削除します」と生成しても、それだけで削除権限を与えてはいけません。実際の操作はアプリケーションコード、権限、ツールパラメーターの検証を通す必要があります。
Jevの結果も権限として扱ってはいけません。ユーザーが明示的に削除を依頼したか、リクエストが高リスクに見えるかは判断できますが、実行可能かどうかは決定論的なルールと権限システムが判定します。
エージェントは多くの小さな判断を行う
1回のエージェント処理で、次のような作業が必要になることがあります。
- タスクの種類と難易度を分類する。
- 高速モデルか高性能モデルかを選ぶ。
- 外部ツールが必要か判断する。
- ツール名、引数、対象リソースを検証する。
- リスクを評価し、確認が必要か判断する。
- 続行、再試行、縮退、一時停止を選ぶ。
- 結果を記録し、コンテキストを更新する。
こうした判断すべてに長い推論が必要なわけではありません。システムプロンプトを延々と拡張するより、判断を小さな質問に分けるほうが保守しやすいことがあります。
Jev AIの役割
明確なレイヤー構成は次のようになります。
user request
     ↓
state builder  ──► permissions and hard rules
     ↓
Jev decision layer
     ├─ route model
     ├─ score risk
     ├─ check intent
     └─ request human review
     ↓
orchestrator
     ├─ call LLM
     ├─ call tool
     └─ ask user
     ↓
validator + audit log
Jevがエージェントの内部実装全体を知る必要はありません。現在の判断に必要なStateと質問だけを渡します。モデル、ツール、ビジネスポリシーはそれぞれ独立して進化できます。
State、Choice、Score、Noulに慣れていない場合は、Jev AI APIチュートリアルから始めてください。Jevと生成型LLMの役割分担については、Jev AIとLLMの比較をご覧ください。
パターン1:呼び出す前にモデルを振り分ける
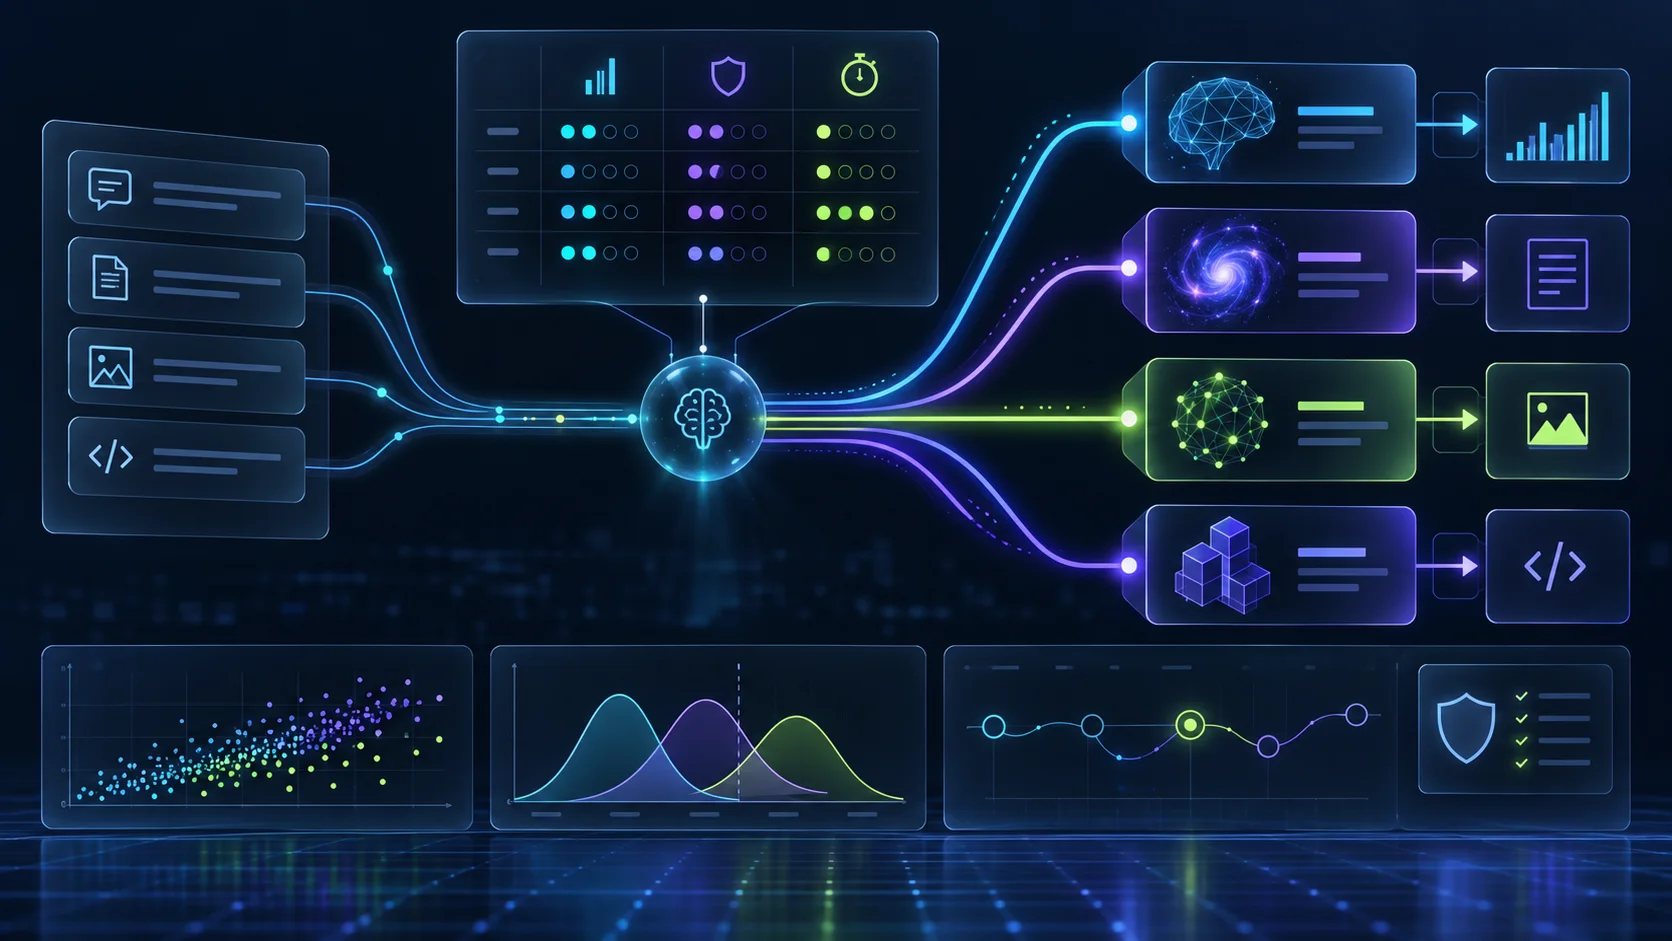
すべてのリクエストを最も高価で遅いモデルに送るべきではありません。Jevを使って、次のような小さな判断を行います。
- 複雑な推論が必要か?
- ツール呼び出しが必要か?
- 機密データや影響の大きい操作に関わるか?
- 短い回答で依頼を満たせるか?
実用的なルーティング戦略
decision = jev.system_one(
    state={
        "request": user_message,
        "conversation_summary": summary,
        "available_tools": tool_catalog,
    },
    questions={
        "difficulty": Score(rubric=["simple", "moderate", "complex"]),
        "needs_tool": Noul("Does this request require a tool call?"),
        "sensitive": Noul("Does this request involve sensitive data or action?"),
    },
)
オーケストレーターは、簡単な作業を高速モデルに、複雑な作業を高性能モデルに、機密性の高い作業をガードレール付きのフローに振り分けられます。Jevは経路を提案しますが、最終的な権限は付与しません。
ルーティングで避けたい間違い
- 1つのスコアだけですべてのモデル選択を決めない。
- 確率の閾値をセキュリティの証明と見なさない。
- テストしていないツール一覧全体をすべてのStateに含めない。
- 1つの判断の確信度が高いからといって、権限確認を省略しない。
パターン2:ツール呼び出しを保護する
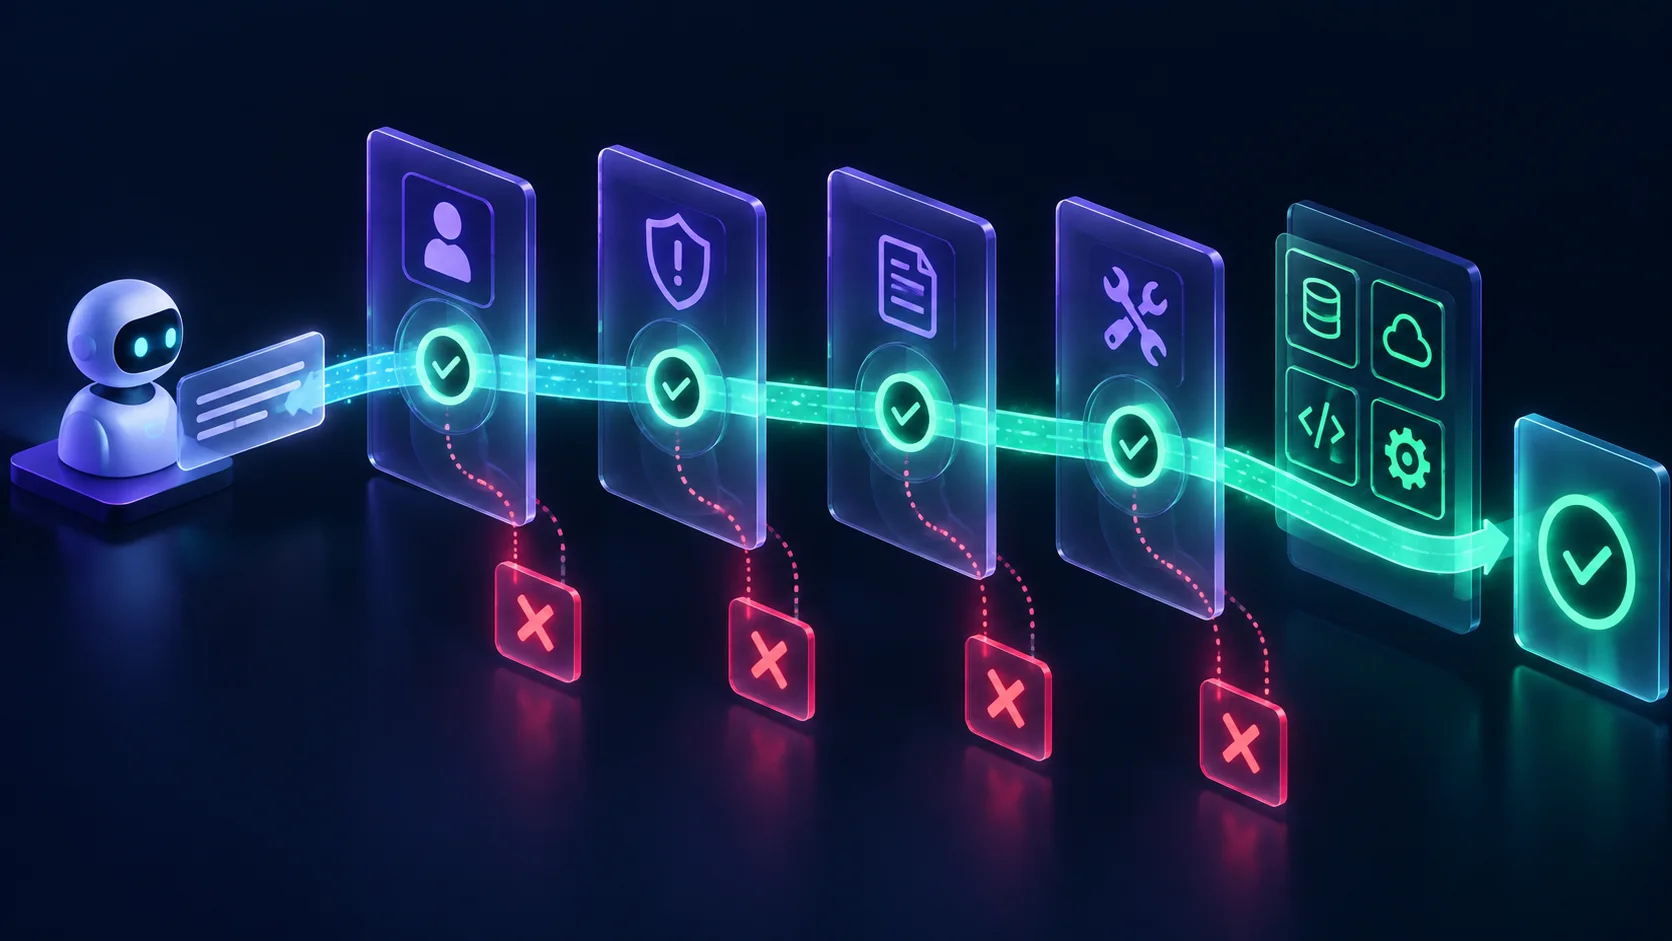
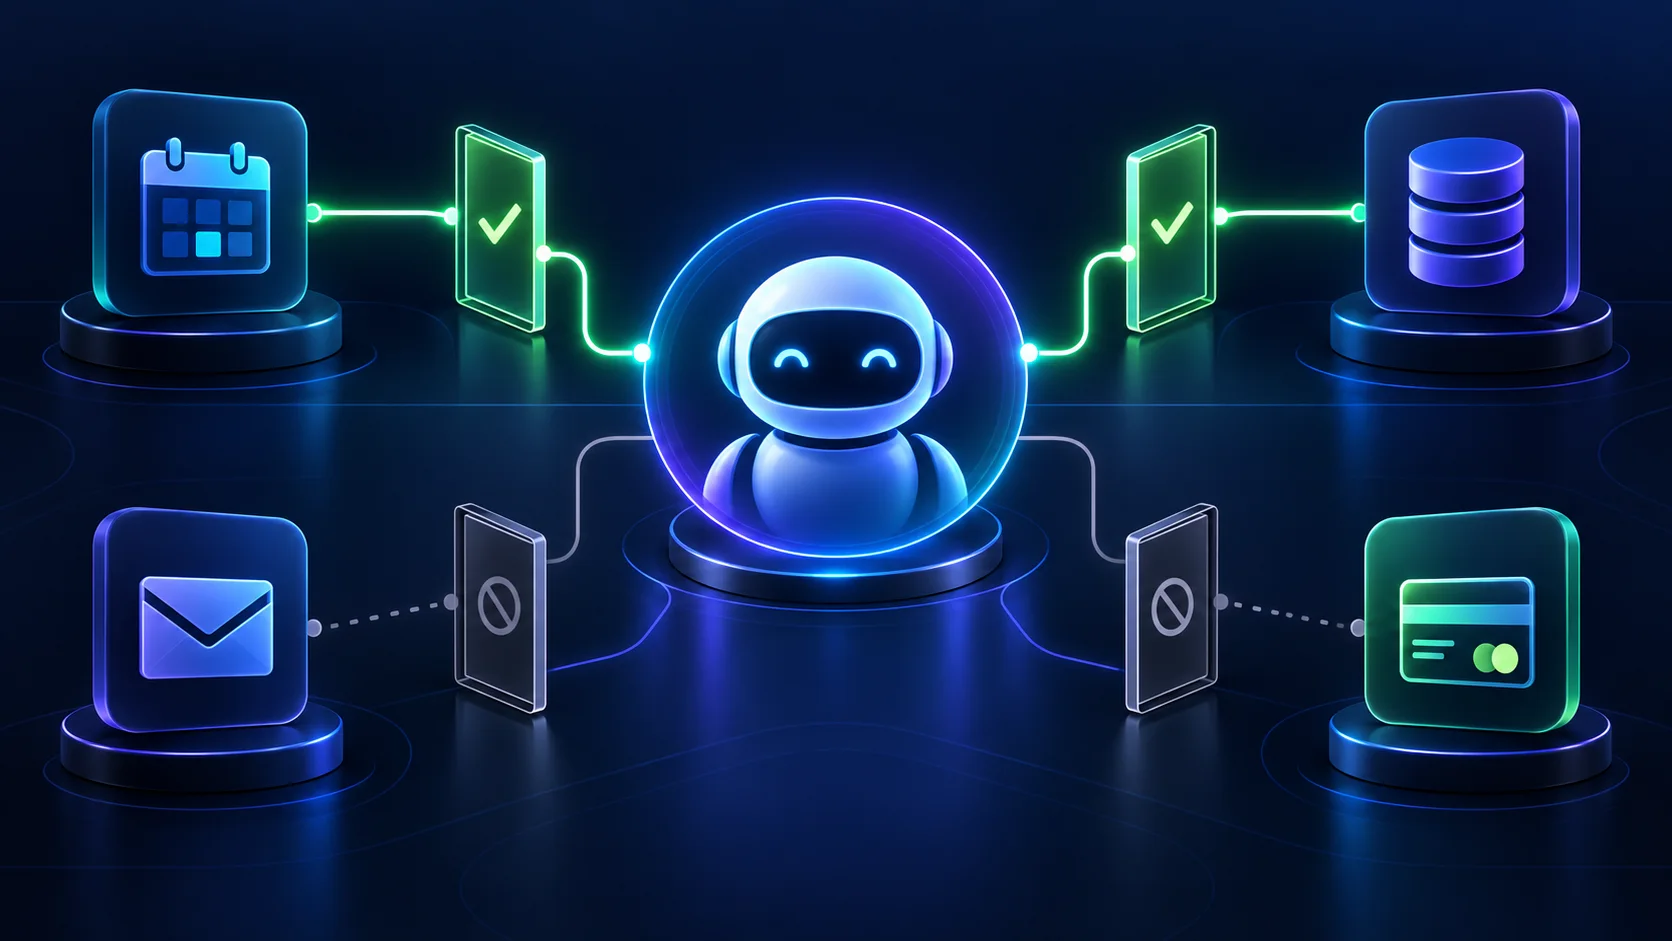
画像:ツール呼び出しは、実行前に意図確認、パラメーター検証、権限確認、リスク評価を通過させます。
エージェントにとって重要な安全対策は、「危険なコンテンツをすべて拒否すること」とは限りません。副作用を伴う操作について、十分なコンテキスト、正しいパラメーター、明示的な確認を確保することです。
4つの防御レイヤー
レイヤー1:必須ルール
ユーザー、ロール、リソースの所有権、金額の上限、許可されたツール、パラメーターの型を先に確認します。必須ルールに違反した場合、JevやLLMを呼び出さず、操作を拒否するか人に引き継ぎます。
レイヤー2:意図の判断
ユーザーが操作を明示的に依頼したかをNoulで判断します。「ユーザーはこのプロジェクトの削除を明示的に依頼したか?」と「削除方法を尋ねただけか?」は別の問いです。
レイヤー3:リスク評価
影響範囲、取り消し可能性、機密性、外部からの見えやすさをScoreで評価します。支払い、権限変更、一括削除、外部へのメッセージには、より厳しいレビュー閾値を設定します。
レイヤー4:確認と監査
高リスク操作では、対象、パラメーター、結果をユーザーに示して明示的な確認を求め、判断、バージョン、実行者、ツールの結果を記録します。確認後にもパラメーターを再検証してください。過去の確認を恒久的な権限として扱ってはいけません。
パターン3:確率を使ってレビューを促す
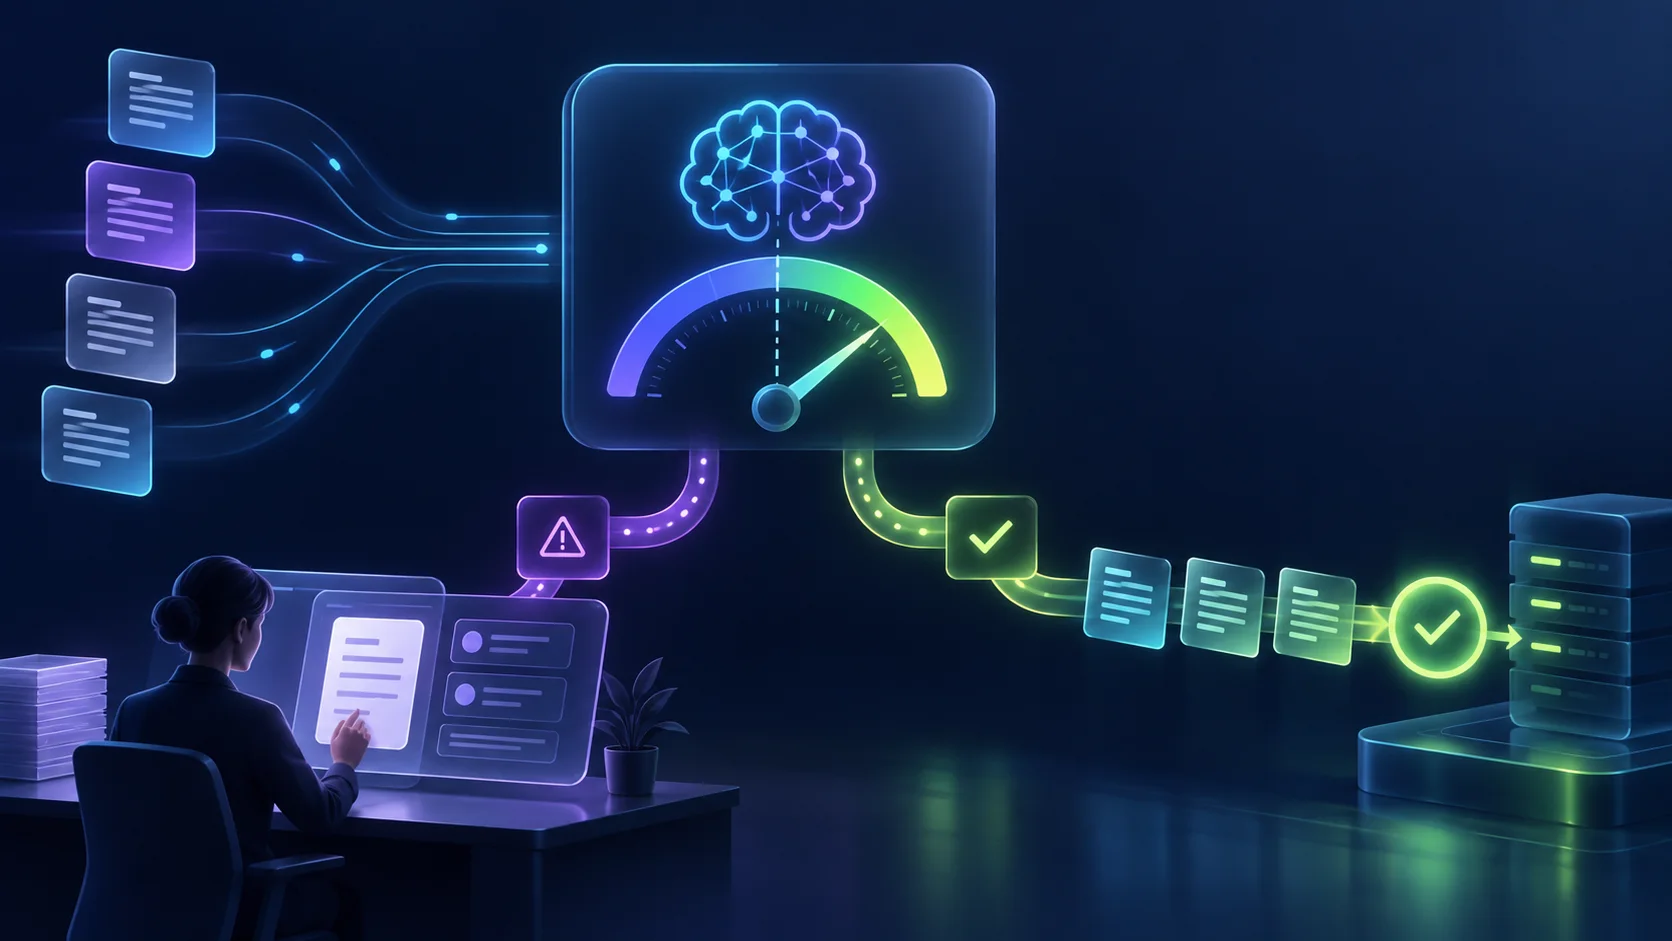
Jevの確率と確信度は、人の判断の代わりではなく、自動化の度合いを選ぶために役立ちます。システムには次の3つの経路を用意できます。
| 結果 | 処理 |
|---|---|
| 確信度が高く、リスクが低い | 自動で続行し、結果を記録する |
| 閾値に近い、またはコンテキストが不足 | 追加情報を求めるか、レビュー対象にする |
| リスクが高い、または確信度が低い | エージェントを一時停止し、人に引き継ぐ |
閾値はモデル全体ではなく、操作ごとに設定します。チケットの自動分類なら低めの閾値でもよいかもしれませんが、返金、削除、権限変更、外部への連絡では、より高い閾値と明示的な確認が必要です。
レビュアーに何を見せるべきか?
役に立つレビュー画面には、次の情報を表示します。
- 元のState、または機密情報を除いた要約。
- エージェントが実行しようとしている操作とツールのパラメーター。
- Jevへの質問、選択肢、確率、確信度。
- 必須ルールと権限確認の結果。
- 承認、拒否、編集、追加情報の要求を行う操作。
「AIの推奨:承認」だけを表示してはいけません。レビュアーには判断の根拠と境界条件が必要です。
エージェントのStateと質問を設計する
判断に必要な事実だけをStateに入れる
エージェントの会話履歴には大量の情報が含まれることがありますが、個々のJev質問でそのすべてが必要になることはほとんどありません。タスクの要約、現在のツール、リソースの詳細、ユーザーの権限、直近の結果をコードで抽出し、最小限のStateを作ります。
Stateを小さくするとコストが下がり、機密データの露出が減り、判断を再現しやすくなります。
1つの質問で1つの判断
次のような詰め込みすぎた質問は避けます。
「これは安全か、確認が必要か、どのモデルを使うべきか、パラメーターは有効か?」
代わりに、次のように分けます。
intent_explicit:ユーザーは操作を明示的に依頼したか?parameter_valid:引数はツールの契約を満たしているか?risk_level:この操作のリスクはどの程度か?needs_human:今、人によるレビューが必要か?
コードで各結果を個別に扱え、それぞれの質問に対する反例も用意できます。
判断をバージョン管理する
質問定義、選択肢の説明、評価基準、モデルのバージョン、閾値のバージョンを記録します。これらがないと、ポリシー変更後に過去の操作が許可または拒否された理由を説明できません。
セキュリティと評価のチェックリスト
本番環境に導入する前に、次を確認してください。
- エージェントが必須ルールを回避して、影響の大きいツールを呼び出せない。
- 副作用のあるツールすべてに、許可リスト、パラメーター検証、権限確認がある。
- Jevの確率はシグナルとして扱い、重大な操作には決定論的または人による代替策がある。
- タイムアウトやサービス停止でレビュー対象のタスクが失われない。
- すべての操作を入力、質問、モデル、閾値、実行者と関連付けている。
- 通常、曖昧、未承認、プロンプトインジェクション、誤解を招く入力を含むテストがある。
- 中国語、英語、専門用語、コンテキスト不足を対象にしている。
- ルーティングやガードレールの質問を、エージェント全体を書き直さず変更できる。
- 一時停止、確認要求、引き継ぎ、静的ルールの使用など、代替処理が明示されている。
- Jev AIショーケースのコミュニティ事例を参考として扱い、安全性の証明とは見なさない。
現在Jevが直接受け付ける入力は、テキスト、JSONオブジェクト、テキスト配列です。画像、音声、動画は直接入力できません。英語以外のデータや専門分野のデータは、製品の説明だけで対応済みと見なさず、自分のサンプルで評価してください。
よくある質問
Jevはエージェントが間違えないことを保証できますか?
いいえ。Jevが返すのは確率と確信度のシグナルであり、業務上の正確性や安全性を保証するものではありません。信頼できるエージェントには、権限、必須ルール、パラメーター検証、人によるレビュー、監査ログが引き続き必要です。
安全性の判断をLLMに任せないのはなぜですか?
LLMは理解や説明に役立ちますが、最終的な権限判断を単独で担うべきではありません。小さな判断に分けることで、閾値、反例、失敗時の経路を個別にテストできます。
確信度が高ければ人の確認を省略できますか?
リスクの低い操作なら可能な場合があります。しかし、影響の大きい操作では確信度だけでは不十分です。支払い、削除、権限変更、外部への連絡には、モデルのシグナルに加えてルール、権限確認、明示的な承認を組み合わせてください。
Jevはあらゆるエージェントに適していますか?
必ずしもそうではありません。主に文章作成や会話を行うエージェントでは、LLMが中心です。一方、ルーティング、ツール選択、リスク評価、エスカレーションを頻繁に行う場合、Jevは意思決定レイヤーの有力な候補です。
どこから始めればよいですか?
Jev AIプレイグラウンドで低リスクの判断を1つ試し、サーバー連携はAPIチュートリアルを参考にしてください。基本の流れが動いたら、オーケストレーターにルーティングと安全対策を追加します。
まとめ:エージェントの操作を説明可能にする
信頼性の高いエージェントに必要なのは、権限の拡大ではなく、より明確な境界です。Jev AIを使えば、ルーティング、ツール利用、エスカレーション、処理継続に関わる隠れた判断を明示できます。その一方で、最終アクションの制御はコードと人が担います。
まずはリスクの低いツールを1つ選び、すべての判断と最終操作を記録し、実際の失敗に基づいて質問と閾値を改善してください。そうすることで、Jev AIは監査しにくい新たなプロンプトではなく、安定した意思決定レイヤーになります。
調査日: 2026-09-20