モデル比較
Jev AIとLLMの比較:チャットモデルではなく判断モデルを使うべき場面
Jev AIと大規模言語モデルは単純な代替関係ではありません。出力形式、レイテンシー、不確実性、開発の複雑さ、安全性の境界を比較し、判断モデルが適する場面を見極めます。
Jev AIとLLMの比較:チャットモデルではなく判断モデルを使うべき場面
Jev AIを初めて知ったチームから、よく実務的な質問が出ます。JevはChatGPT、Claude、その他の大規模言語モデルとどう違うのか。 LLMがすでにJSONを返せるなら、なぜ別の判断モデルを追加するのでしょうか。
答えは「Jev AIは常に優れている」ではありません。それぞれ最適化されている仕事が異なります。LLMは自由形式の生成、説明、複雑な推論に強みがあります。Jev AIは、Stateを定義済みの回答範囲内で選択、スコア、Yes/Noの判断に変換し、その結果をアプリケーションコードに返すよう設計されています。
この記事では、エンジニアリングの観点からJev AIと生成LLMを比較し、実用的な選択基準を示すとともに、1つのエージェントやSaaSワークフロー内で両者を連携させる方法を説明します。
簡単に言うと: 回答範囲を事前に定義でき、結果をコードで再利用、順位付け、振り分け、ブロックする必要があるなら、まずJev AIを評価しましょう。文章作成、説明、創造性、自由形式の推論が必要なら、生成LLMを使い続けます。
目次
根本的な違い
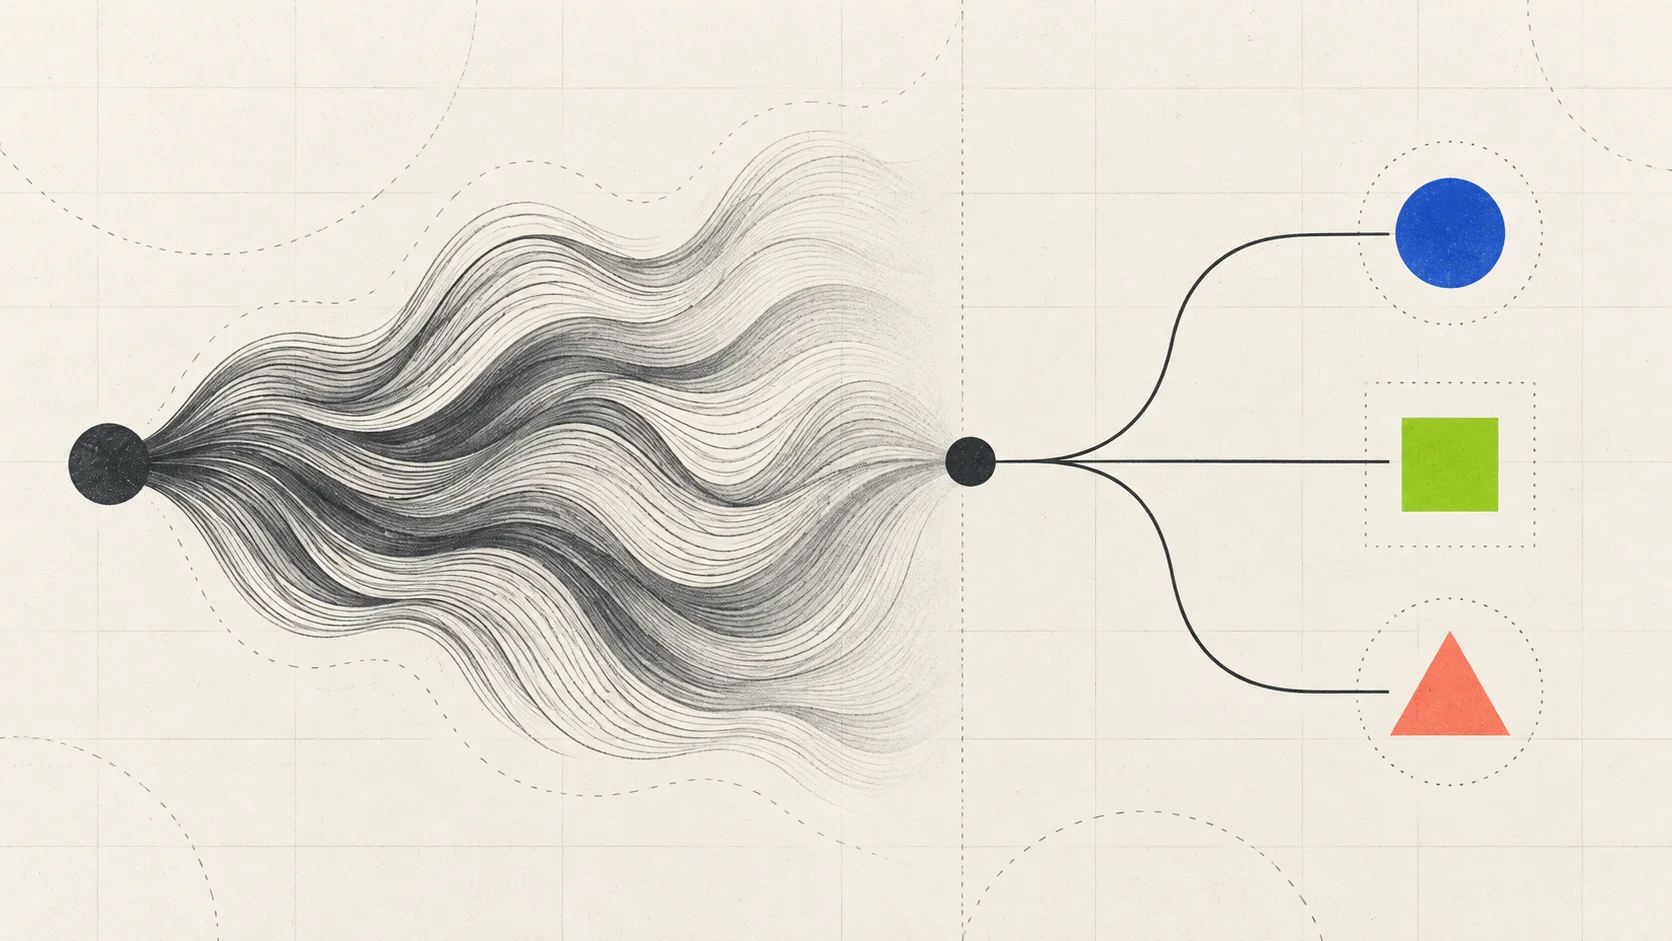
画像:LLMは主に人向けのコンテンツを生成し、Jev AIは主にソフトウェア向けの判断を返します。
LLMは生成モデル、Jevは判断レイヤー
生成LLMはコンテキストから次のトークンを生成します。メールを書いたり、コードを説明したり、レポートを要約したり、プロンプトでJSONを生成したりできます。しかし、そのJSONも依然としてテキスト生成の結果です。アプリケーション側ではフィールドを検証し、欠損値に対応し、書式の揺れを考慮しなくてはなりません。
Jev AIは質問タイプから始めます。アプリケーションがChoice、Score、Noulのどの判断を必要とするか定義してから、Stateを渡します。レスポンスは、選択肢、スコア、Yes/No判断、確率、信頼度を中心に構成されます。Jevは単に小型化されたチャットモデルではなく、ソフトウェアの判断を第一級のインターフェースとして扱います。
結果をコードに戻す必要があるか
人が出力を読んで次の行動を決めるなら、テキストが適していることが多いでしょう。一方、出力を if 文、キュー、ルーター、権限チェック、ツール呼び出しに渡すなら、安定した判断形式がより重要です。
これがJev AIの紹介の中心的な考え方です。Jevが判断し、アプリケーションコードがアクションを実行します。
5つの比較軸
| 比較項目 | Jev AI | 生成LLM |
|---|---|---|
| 主な出力 | Choice、Score、Noul、確率、信頼度 | テキスト、コード、説明、自由形式の構造化コンテンツ |
| 回答範囲 | 開発者が定義 | 通常は自由形式でプロンプトに依存 |
| 得意な制御フロー | 分類、振り分け、順位付け、ブロック、エスカレーション | 生成、要約、説明、計画、作成 |
| 不確実性 | 明示的な確率と信頼度シグナル | 通常は追加の検証または別の判断が必要 |
| システム上の役割 | 業務ロジック内の判断ノード | コンテンツまたは推論の中心 |
1. 出力は実行可能である必要があるか
サポートの振り分け、モデル選択、リスクのエスカレーション、ツール実行前の確認は、きれいな文章を求めているわけではありません。プログラムに進むべき経路を示す結果が必要です。リクエストごとに自然言語を解析すると、トラフィックの増加に伴って複雑さも増します。
Jev AIはこの層をアプリケーションの入力に近づける設計です。LLMでも関数呼び出しやJSON Schemaを使えますが、チームは出力検証、再試行、余計なテキスト、モデルバージョンの変更に引き続き対応する必要があります。
2. 回答範囲をあらかじめ定義できるか
画像:回答範囲が明確なほど、専用の判断インターフェースが役立ちます。
回答が「請求、技術、その他」や0~3の深刻度であれば、その境界を明確に定義します。ChoiceとScoreはこの種の作業向けです。
「説得力のある新製品発表文を書く」のように事前に回答を定義できない場合は、自由形式の生成が適しています。Jevを使うためだけに、創作タスクをラベル一覧に無理に当てはめないでください。
3. 不確実性で自動化を制御する必要があるか
多くのシステムでは、単なるYes/No以上の情報が必要です。結果が自動化に十分安全かを判断したいのです。確率が高くリスクの低いチケットなら自動で振り分けられますが、判断が微妙な決済リクエストは人に回すべきです。
Jevの確率と信頼度は制御フローのシグナルとして活用できますが、業務上の正確さを保証するものではありません。本番システムでは、しきい値、反例、人によるサンプリング、監査ポリシーが引き続き必要です。
4. 同じStateに対して複数の判断が必要か
サポート依頼には、担当部署、緊急度、返金の意図、エスカレーション判断が必要な場合があります。Jevのインターフェースでは、同じStateに対して複数の型付き質問を評価し、質問IDごとの回答を返せます。
LLMでも1つのJSONレスポンスに複数フィールドを含められます。しかし、判断ごとにリスクや評価基準が異なるなら、分けることで監視と調整が簡単になることがあります。
5. 判断レイヤーに低レイテンシーと組み合わせやすさが必要か
Jev AIホームページでは70~500ミリ秒の応答時間が紹介されています。高頻度のワークフロー内で小さな判断を行う場合には有用ですが、SLAではありません。実際のレイテンシーはネットワーク、リクエストの大きさ、同時実行数、サービス状況によって異なります。
LLMのレイテンシーには、コンテキストの長さや生成トークン数が影響することがよくあります。長い回答が必要なら、数百ミリ秒の差を上回る価値がLLMにある場合もあります。1秒あたり多数の小さな判断を行う振り分けレイヤーでは、専用の判断モデルを評価する価値があります。
Jev AIを優先したい場面
次の条件に当てはまるほど、Jev AIを積極的に試す価値があります。
出力が有限の選択肢である
製品要件やコードに候補を列挙でき、それぞれの意味を定義できます。通常はChoiceに適しています。
質問が1つの明確な判断を求める
「このメッセージは明示的に返金を求めているか」「どの深刻度が該当するか」などが例です。判断を分けるとテストや再実行が容易になります。
結果がコードの動作を決める
結果が読み手への表示だけではなく、キュー、権限、モデル選択、ツール呼び出し、データベース項目、人へのエスカレーションに影響します。
不確実性を考慮した自動化が必要
信頼度の高い結果は自動処理し、境界に近い結果は確認し、信頼度の低い結果では追加情報を求めたいと考えています。Jevの確率シグナルが役立つ場面です。
業務ポリシーをアプリケーションに残したい
しきい値、重み、確認ルール、最終アクションをチームが管理します。Jevを使うと、長いプロンプトにポリシー全体を隠さず判断を得られます。
LLMが引き続き適している場面
次のようなタスクでは生成モデルを使い続けましょう。
- マーケティング文、メール、製品説明、コードの作成。
- 長い文書の要約や、根拠の説明。
- 複数の候補回答がある自由形式の調査。
- 回答範囲を列挙できない問題の推論。
- 会話やフィードバックに応じた文章の書き換え。
こうしたワークフローでは、生成の前後にJevでLLMの出力を分類、採点、制御、確認できます。
Jev AIとLLMを連携させる方法
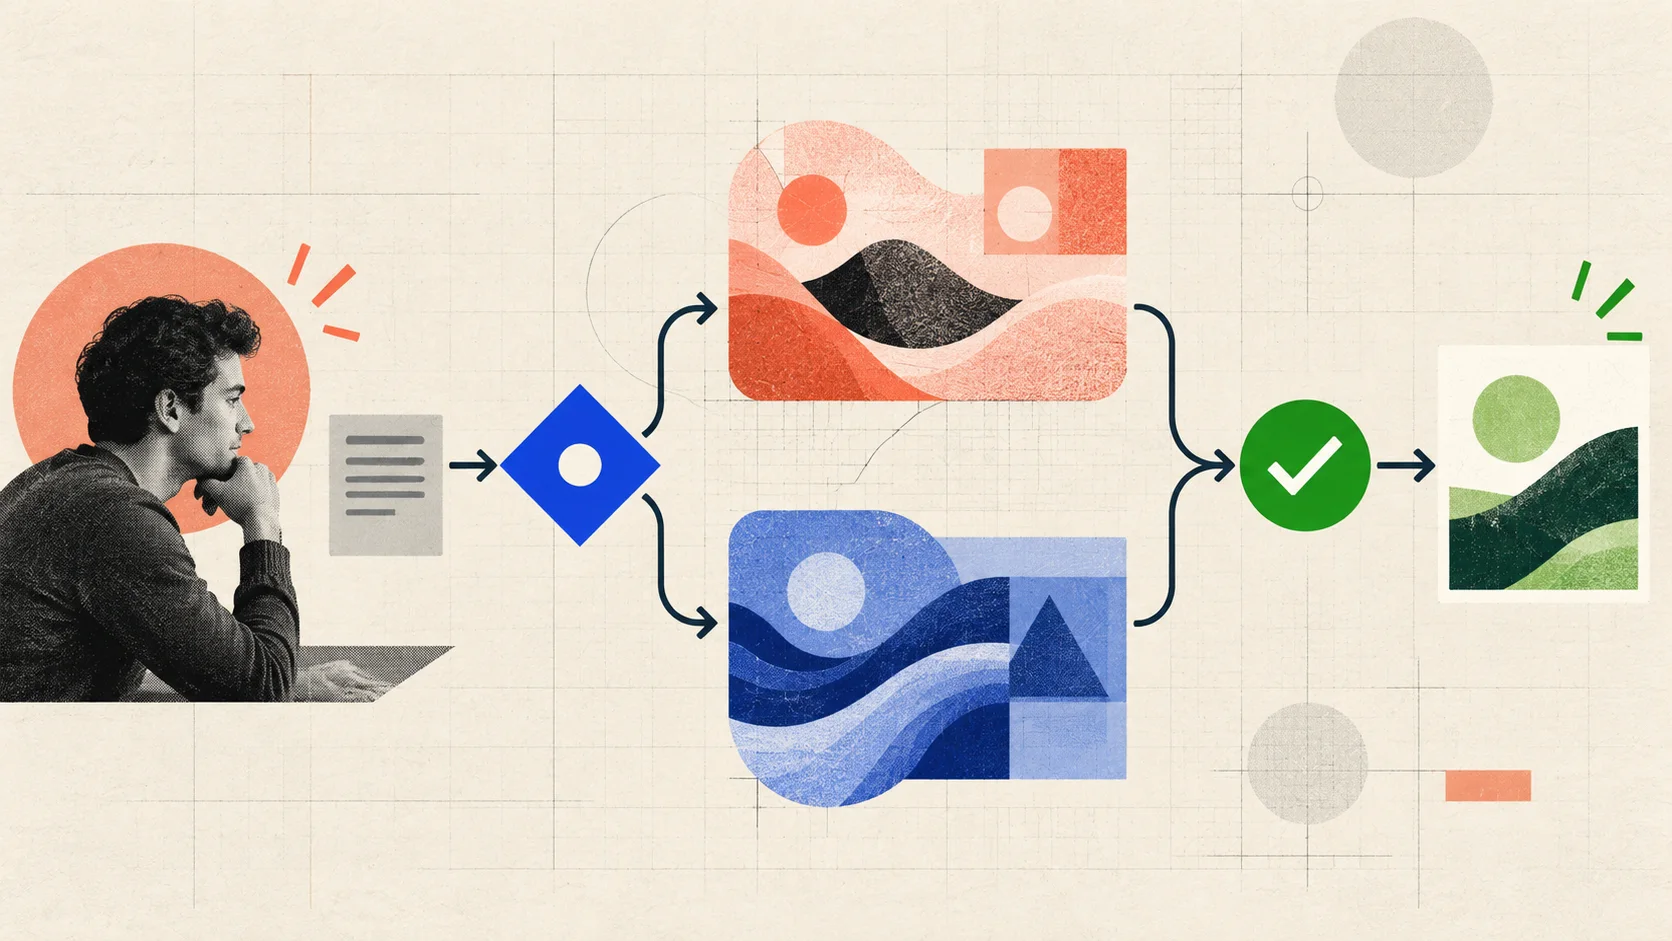
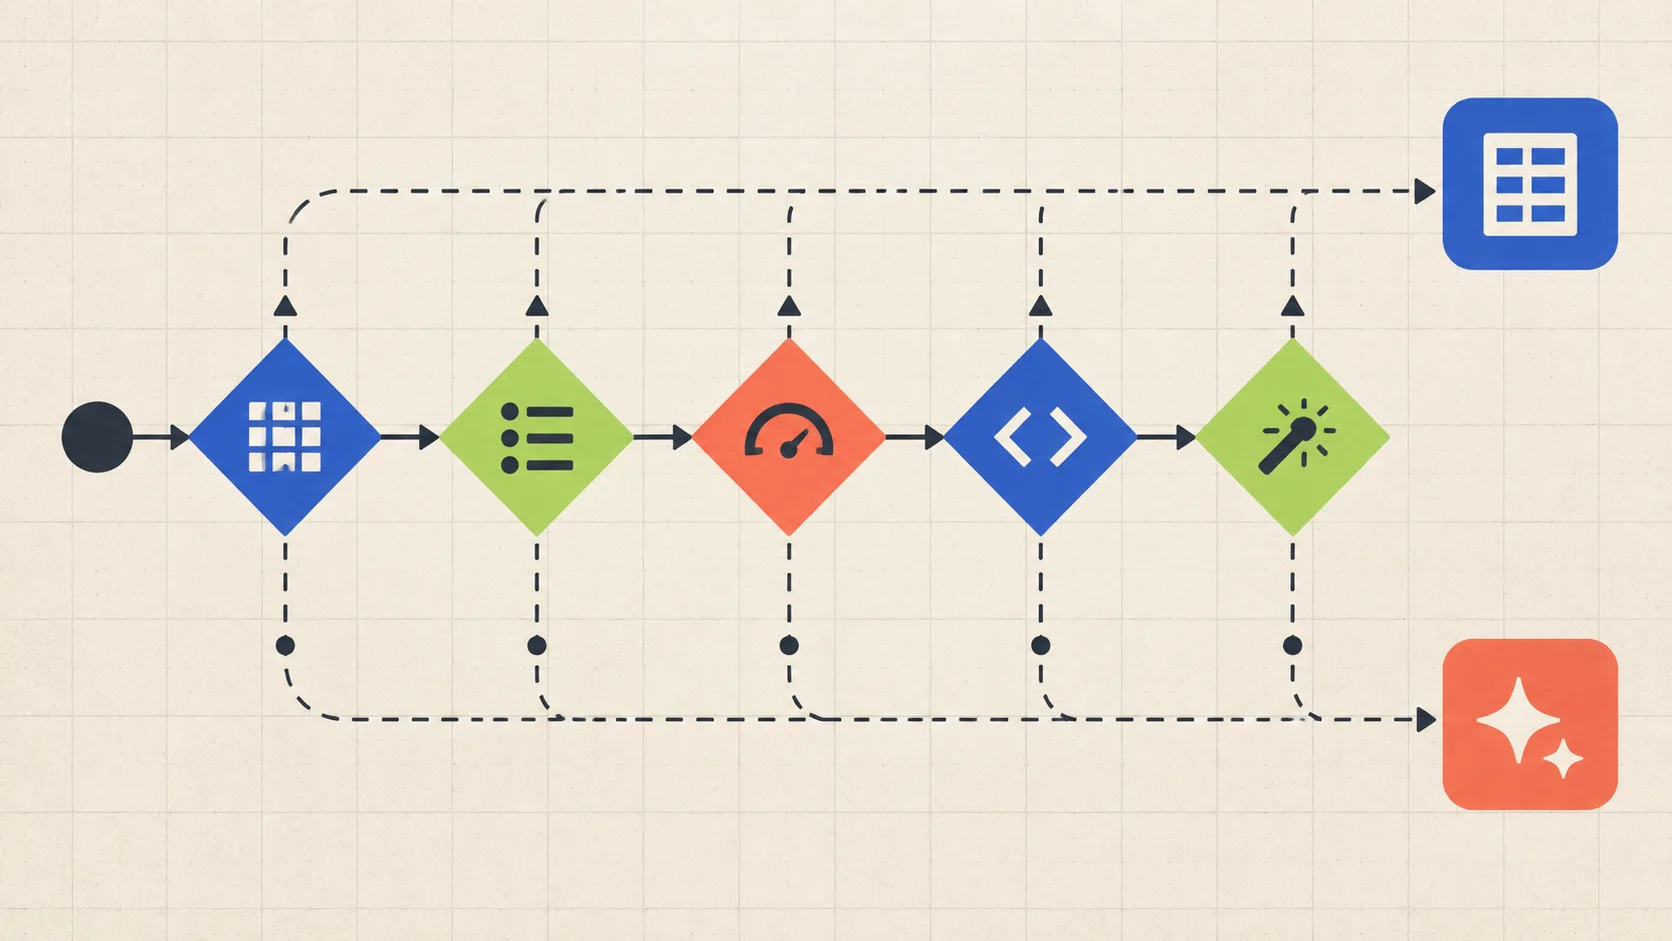
画像:JevはLLMの前後で振り分け、検証、リスクに応じた分岐を担当できます。
実用的な連携アーキテクチャは次のようになります。
- リクエストを受信し、Stateを構築する。
- Jevでタスクの種類、難易度、機密性、ツールの必要性を分類する。
- 簡単な処理は高速モデルに、複雑な処理は高性能モデルに送る。
- LLMに回答生成または自由形式の推論を行わせる。
- Jevまたはハードルールで、出力を送信してよいか、確認が必要か判断する。
- アプリケーションコードで結果を記録し、次のアクションを選ぶ。
モデル呼び出しを増やすこと自体が目的ではありません。それぞれのモデルに最適な部分を担当させます。API形式についてはJev AI APIチュートリアルをご覧ください。
簡略化した疑似コード
decision = jev.classify(
    state=request,
    questions={
        "risk": Score(rubric=["low", "medium", "high"]),
        "needs_tool": Noul("Does this request require a tool call?"),
    },
)

if decision.risk == "high" or decision.needs_tool > 0.9:
    return request_human_review(request)

return call_selected_llm(request, route=decision.risk)
これはアーキテクチャの例であり、SDKの完全な仕様ではありません。現在のフィールドとクライアントについては公式Jevドキュメントを参照してください。
評価方法の設計
例を10件だけ比較して、どちらのシステムが「より人間らしく聞こえるか」で決めるのは避けましょう。有用な評価では、最終的な制御フローを測定します。
代表的なデータセットを作る
通常の入力、境界ケース、曖昧な入力、敵対的な入力を集めます。実際のトラフィックに合わせてサンプリングし、中国語、英語、専門用語、コンテキスト不足を個別に評価してください。
各エラーのコストを測る
誤ったエスカレーション、見逃したエスカレーション、誤振り分け、安全でない実行、人による確認コストを分けて評価します。影響の大きな操作では、平均精度を最適化するより、確認件数を増やす方がよい場合があります。
エンドツーエンドの指標を比較する
レイテンシー、コスト、再試行率、解析失敗、人の介入率、最終的なタスク成功率を記録します。Jevの低レイテンシーが重要なのは、ワークフロー全体を改善する場合に限られます。
保守性を評価する
回答範囲が明確か、質問を独立に変更できるか、判断を再実行できるか、しきい値がコードに残っているかを確認します。安く見えても説明できないシステムは、長期的にコストがかかる場合があります。
よくある質問
Jev AIは単に高速なLLMですか?
それだけでは説明が足りません。Jevは長文ではなく、ソフトウェアが利用できる型付きの判断を返すSystem One判断モデルとして設計されています。速度は利用体験の一部ですが、自分の環境で検証する必要があります。
LLMがJSON Schemaに対応している場合もJevは必要ですか?
必ずしも必要ではありません。JSON Schemaで多くの書式上の問題は解決できます。複数の原子的な判断、確率に基づく振り分け、高頻度の制御フロー内で安定した判断インターフェースが必要なら、Jevとの比較を検討してください。
Jevは業務ルールを置き換えますか?
いいえ。ハードルール、権限、監査、決済管理は決定論的なままにしてください。Jevは、ルールで対応しにくいものの、回答範囲を定義できる意味的な判断に適しています。
LLMなしでJevを使えますか?
製品で必要なのが分類、スコアリング、振り分け、Yes/No判断だけなら使えます。コンテンツ生成や自由形式の説明も必要なら、JevとLLMを組み合わせてください。
どこからテストを始めればよいですか?
Jev AI Playgroundを開いて、測定可能でリスクの低い判断を1つ試し、APIドキュメントを読んでください。インターフェースが動作したら、エージェントの振り分けまたはガードレール層にJevを配置します。
まとめ
Jev AIとLLMの選択は、どちらのモデルが「賢い」かという問題ではありません。ソフトウェアに必要なのが生成なのか、実行可能な判断なのかという問題です。自由形式の生成はLLMに、高頻度で範囲の定まった判断は判断レイヤーに任せ、しきい値と最終アクションはコードに残します。
調査日: 2026-09-20