未分类
用 Jev AI 构建可靠的 AI Agent:模型路由、安全守护与人工复核
AI Agent 不应让一个大模型决定所有事情。本文介绍如何用 Jev AI 做模型路由、工具调用前检查、风险评分和人工复核,把 Agent 的判断层与执行层分开。
用 Jev AI 构建可靠的 AI Agent:模型路由、安全守护与人工复核
AI Agent 的问题通常不是“模型不会回答”,而是它是否应该在当前状态下继续行动。一个 Agent 可能需要决定使用哪个模型、是否调用工具、是否需要更多信息、是否应该暂停并交给人处理。
如果所有判断都交给同一个生成式 LLM,系统很容易把计划、执行和安全审查混在一起:模型可能生成看似合理的解释,却没有给出稳定的控制信号;开发者也很难知道一次错误究竟来自理解、权限、工具还是阈值。
Jev AI 可以作为 Agent 的独立决策层:接收当前 State,提出小而明确的 Choice、Score 或 Noul 问题,然后把概率和置信度交回编排代码。Agent 负责执行,Jev 负责判断,规则和人工负责兜底。
本文给出一套适合实际产品的 Agent 架构,覆盖模型路由、工具调用守护、风险评分、人工复核和上线评估。
核心原则: 不要让一个模型同时拥有理解、决策、授权和执行权。把判断拆成可测试的小问题,再把最终动作交给受约束的代码。
目录
- AI Agent 为什么需要独立决策层
- Jev AI 在 Agent 架构中的位置
- 模式一:调用前做模型路由
- 模式二:工具调用前做安全守护
- 模式三:用概率触发人工复核
- 如何设计 Agent 的 State 和问题
- 上线前的安全与评估清单
- 常见问题
AI Agent 为什么需要独立决策层
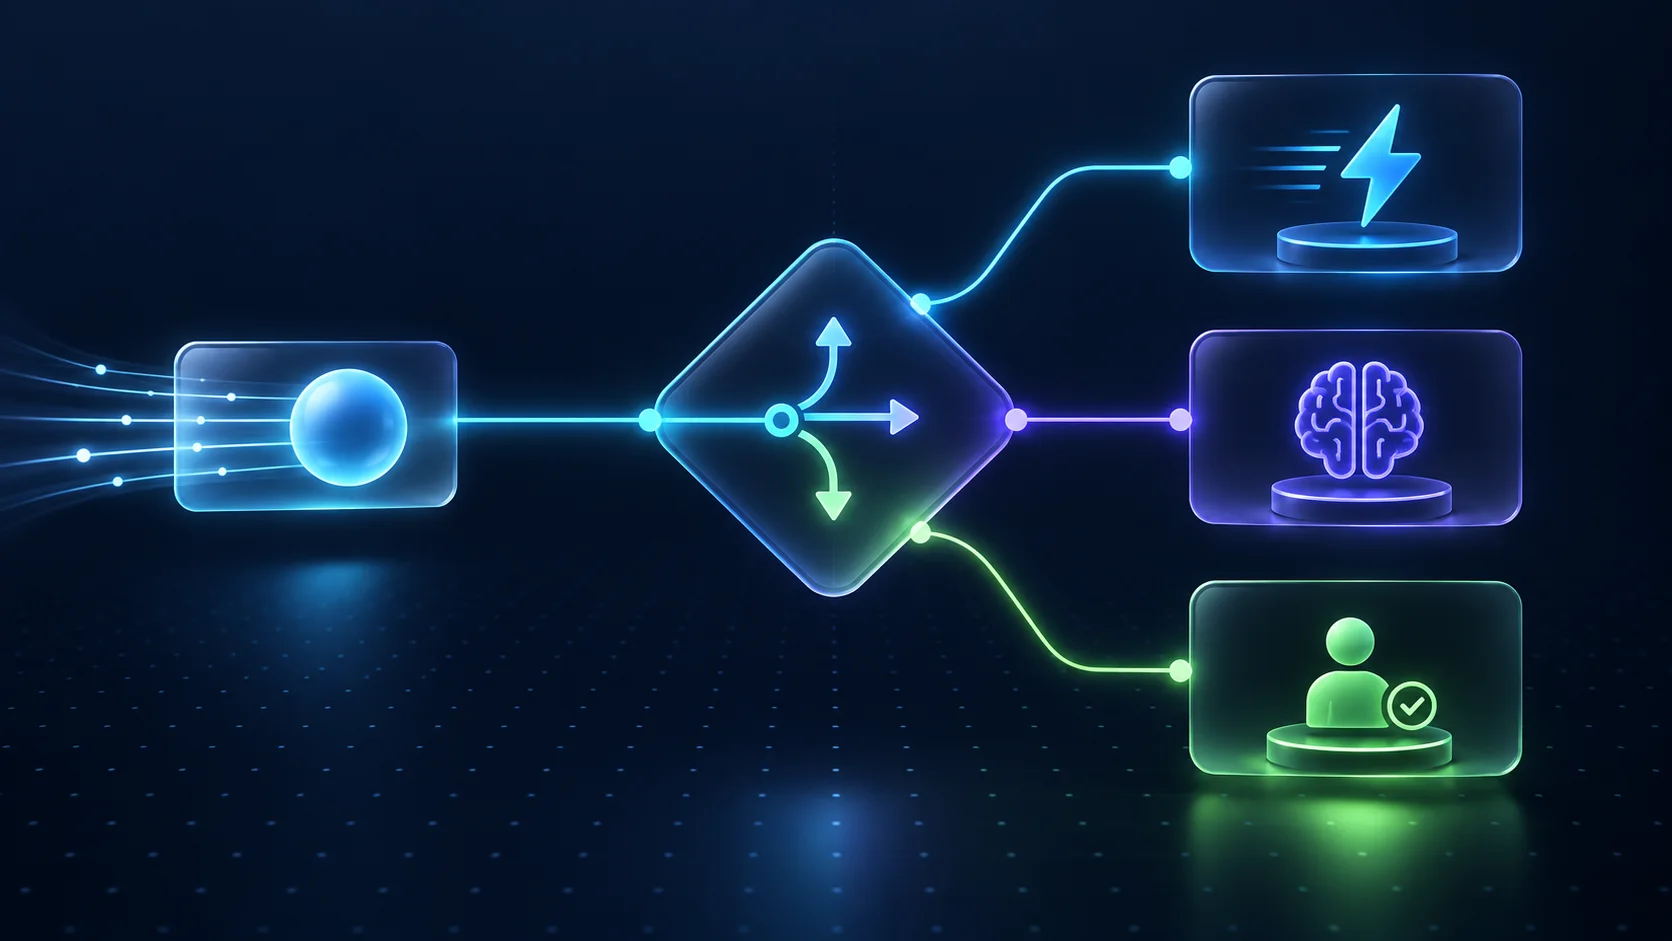
图:把 Agent 的判断层与执行层分开,可以让路由、守护和审核策略更容易测试。
生成文本不等于获得授权
LLM 可以生成“我将删除这个文件”的文字,但文字本身不应该拥有删除权限。真正的动作必须经过应用代码、权限系统和工具参数校验。
Jev AI 的结果也不应该直接等同于授权。它可以判断“用户是否明确要求删除”“当前请求是否看起来高风险”,但最终是否允许执行,仍然应该由确定性规则和权限系统决定。
Agent 中存在许多小决策
一个完整的 Agent 回合可能包含:
- 判断任务类型和难度;
- 选择快速模型还是深度模型;
- 判断是否需要访问外部工具;
- 校验工具名、参数和目标资源;
- 判断操作风险和是否需要确认;
- 决定继续、重试、降级或暂停;
- 记录执行结果并更新上下文。
这些判断并不都需要长篇推理。把它们拆成原子问题,往往比不断加长系统提示词更容易维护。
Jev AI 在 Agent 架构中的位置
一个清晰的分层可以是:
user request
     ↓
state builder  ──► permissions and hard rules
     ↓
Jev decision layer
     ├─ route model
     ├─ score risk
     ├─ check intent
     └─ request human review
     ↓
orchestrator
     ├─ call LLM
     ├─ call tool
     └─ ask user
     ↓
validator + audit log
Jev 不需要知道整个 Agent 的内部实现。它只需要获得当前判断所需的 State 和问题。这样可以让模型、工具和业务政策分别演进。
如果你还不熟悉 State、Choice、Score 和 Noul,可以先阅读 Jev AI API 教程。如果需要理解 Jev 和生成式 LLM 的分工,参见 Jev AI vs LLM 对比。
模式一:调用前做模型路由
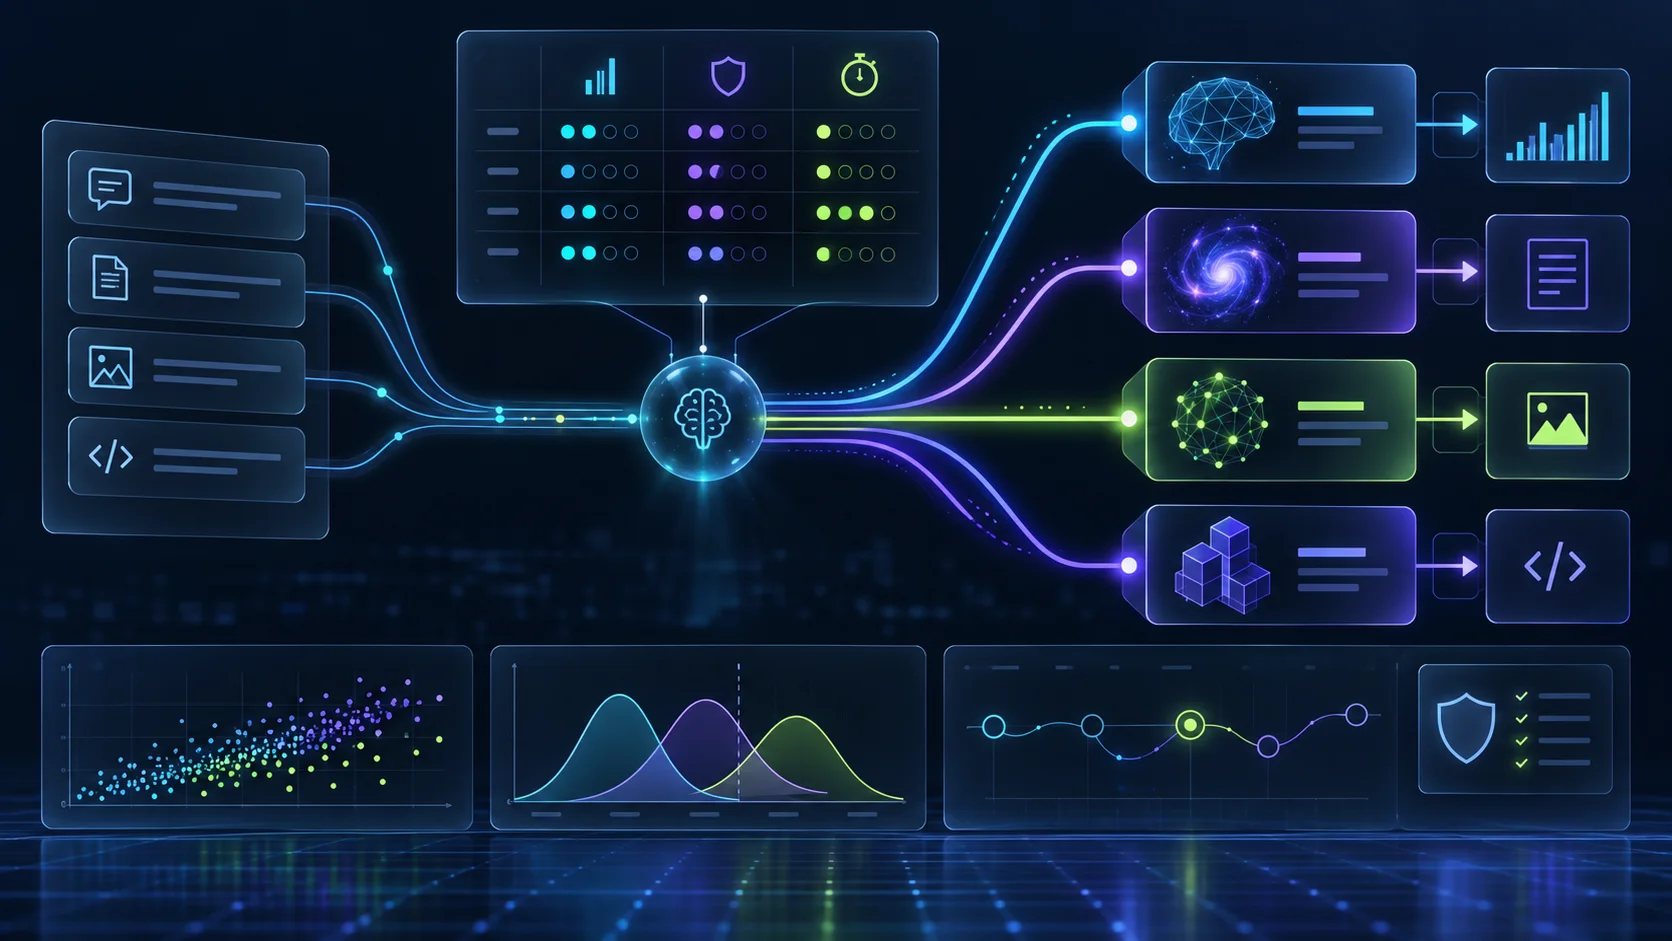
Agent 不应该把每个请求都交给最贵、最慢的模型。可以先用 Jev 做几个小判断:
- 任务是否需要复杂推理?
- 是否需要调用工具?
- 是否涉及敏感数据或高风险动作?
- 当前请求是否可以用短答案完成?
一个实用的路由策略
decision = jev.system_one(
    state={
        "request": user_message,
        "conversation_summary": summary,
        "available_tools": tool_catalog,
    },
    questions={
        "difficulty": Score(rubric=["simple", "moderate", "complex"]),
        "needs_tool": Noul("Does this request require a tool call?"),
        "sensitive": Noul("Does this request involve sensitive data or action?"),
    },
)
代码可以根据结果做初步分流:简单请求交给快速模型,复杂请求交给更强模型,敏感请求先进入守护流程。Jev 的判断不是最终权限,而是帮助编排器选择下一步路径。
路由时要避免的错误
- 不要只用一个分数决定所有模型选择;
- 不要把概率阈值当作安全证明;
- 不要把没有经过测试的工具目录完整塞进每次 State;
- 不要因为一次高置信度判断就跳过权限检查。
模式二:工具调用前做安全守护
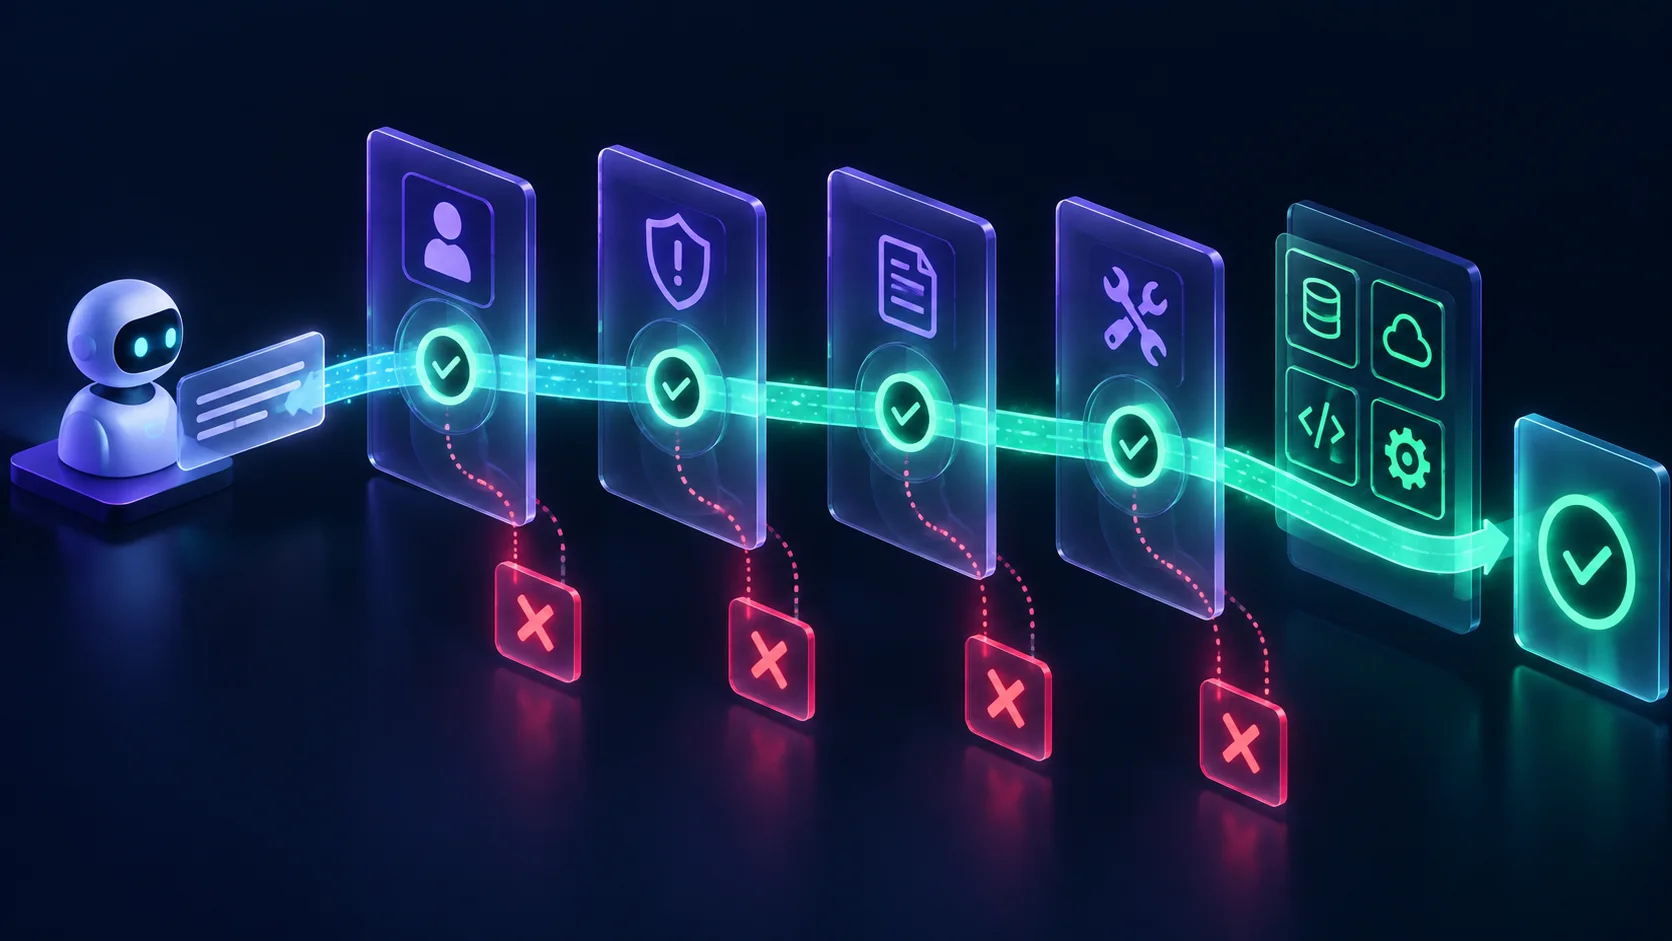
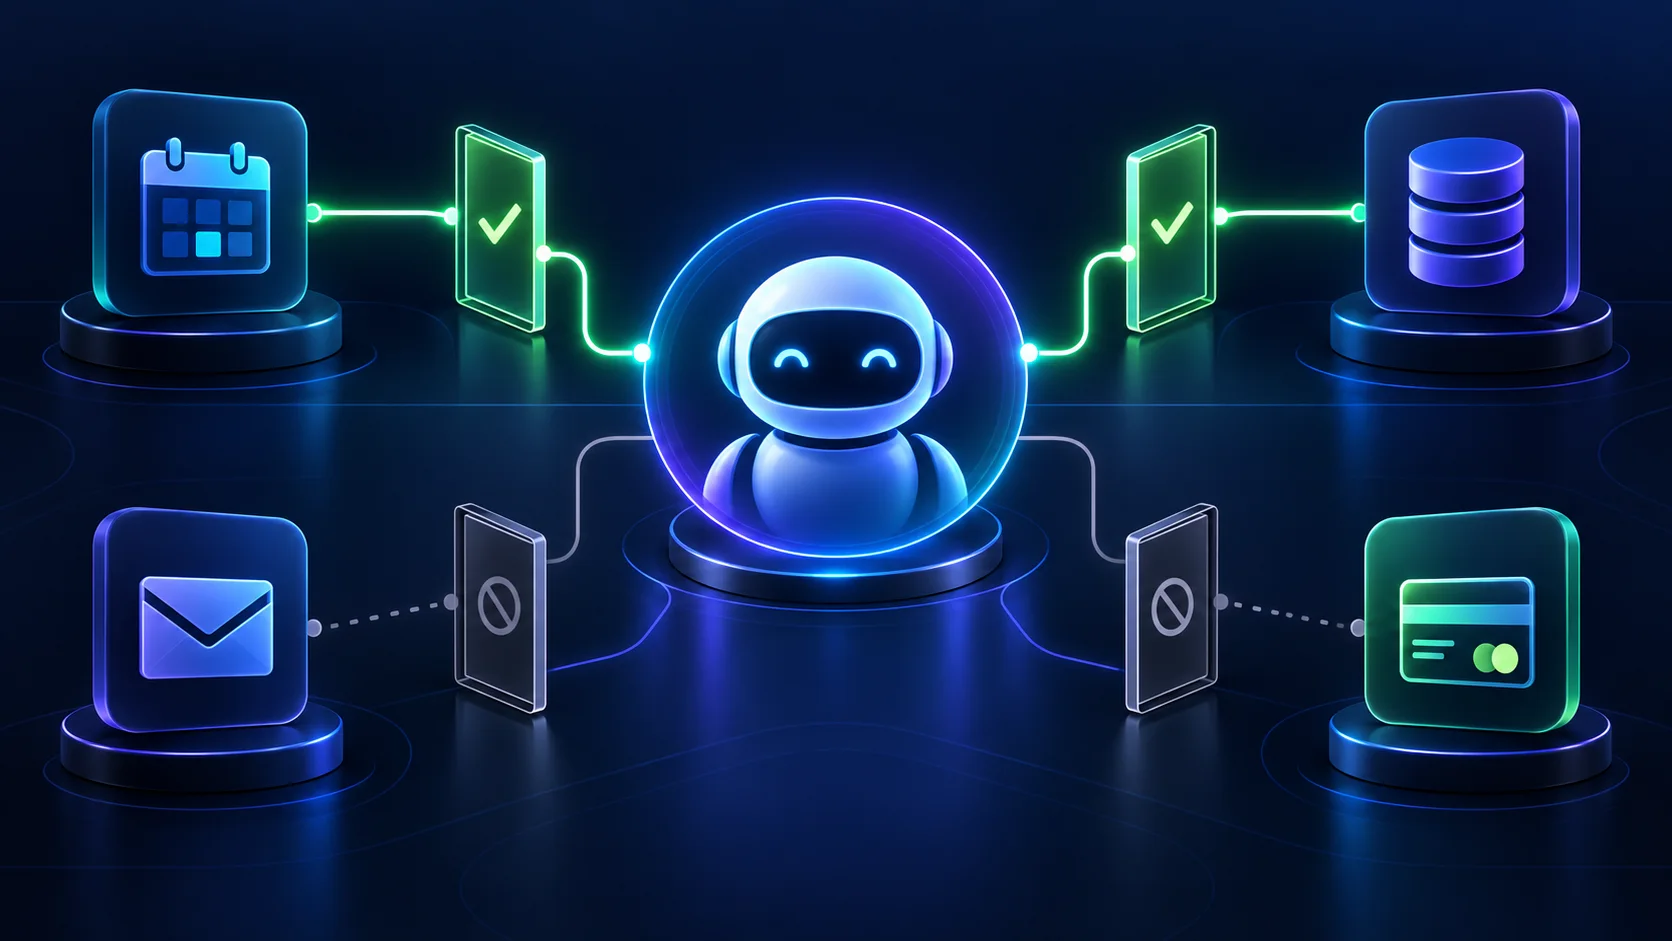
图:工具调用必须先经过意图判断、参数校验、权限检查和风险路径。
对 Agent 来说,最重要的 guardrail 通常不是“拒绝所有危险内容”,而是确保真正的副作用动作拥有足够的上下文和确认。
四层防线
第一层:硬规则
先检查用户、角色、资源归属、金额上限、工具白名单和参数类型。违反硬规则时,不要调用 Jev,也不要调用 LLM,直接拒绝或返回人工路径。
第二层:意图判断
使用 Noul 判断用户是否明确提出了动作。例如:“用户是否明确要求删除这个项目?”如果只是询问“怎么删除”,不应自动解释为授权删除。
第三层:风险评分
使用 Score 对影响范围、可逆性、敏感程度和外部可见性评分。支付、权限修改、批量删除和外部发信可以设置更高的审核阈值。
第四层:确认与审计
高风险操作需要向用户展示目标、参数和后果,要求明确确认,并记录决策、版本、操作者和工具结果。确认后也要重新校验参数,不要把旧确认当作永久授权。
模式三:用概率触发人工复核
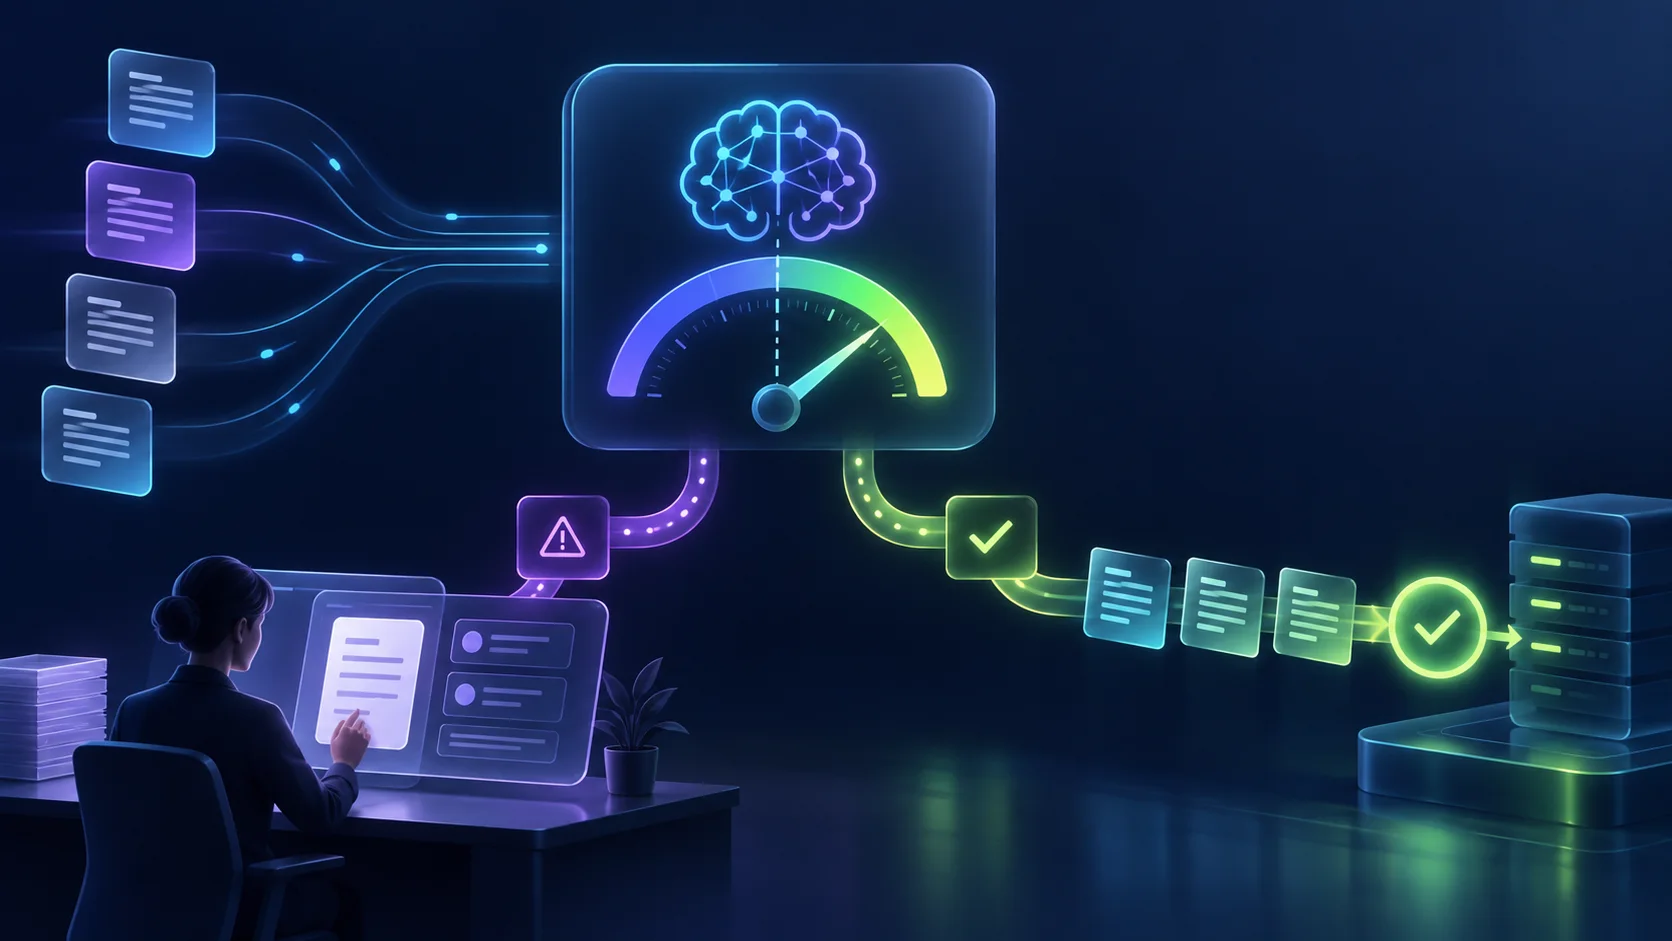
Jev AI 的概率和 confidence 最适合用于决定自动化程度,而不是替代人工。可以把结果划分成三条路径:
| 结果状态 | 处理方式 |
|---|---|
| 高置信度、低风险 | 自动继续,并记录结果 |
| 接近阈值或信息不完整 | 请求更多信息或进入抽样审核 |
| 高风险或低置信度 | 暂停 Agent,转人工处理 |
阈值应该按动作而不是按模型统一设置。例如,自动给工单分类可以接受较低阈值;自动退款、删除数据和改权限则应使用更高阈值和额外确认。
人工复核界面需要展示什么
一个可用的审核界面至少应该显示:
- 原始 State 或经过脱敏的摘要;
- Agent 想执行的动作和工具参数;
- Jev 的问题、选项、概率和 confidence;
- 硬规则和权限校验结果;
- 审核人可以选择批准、拒绝、修改或要求补充信息。
不要只展示“AI 建议:批准”。审核人需要看到做出判断所依据的事实和边界。
如何设计 Agent 的 State 和问题
State 只放当前决策所需的事实
Agent 的长会话可能包含大量历史,但每个 Jev 问题不需要读取全部内容。可以先由代码提取任务摘要、当前工具、资源信息、用户权限和最近一次结果,再形成最小 State。
最小 State 有三个好处:成本更可控、问题更容易复现、敏感数据暴露更少。
一个问题只做一个判断
不要把以下问题写成一个超级问题:
“这个操作是否安全、是否需要确认、应该用哪个模型、参数是否正确?”
更好的拆分是:
intent_explicit:用户是否明确提出该动作?parameter_valid:参数是否符合工具契约?risk_level:操作风险属于哪个等级?needs_human:当前是否必须人工审核?
这样可以在代码中分别处理,也能针对单个问题建立反例集。
决策结果需要版本化
记录问题定义、选项描述、评分标准、模型版本和阈值版本。否则当规则变化后,团队无法解释过去为什么允许或阻止某个动作。
上线前的安全与评估清单
上线前至少验证以下内容:
- Agent 无法绕过硬规则直接调用高风险工具;
- 所有副作用工具都有白名单、参数校验和权限检查;
- Jev 的概率只是信号,关键动作仍有人工或确定性兜底;
- 人工审核路径不会因为超时或服务异常而丢失任务;
- 所有执行都能关联到输入、问题、模型、阈值和操作者;
- 测试集包含正常、模糊、越权、提示注入和故意误导输入;
- 测试了中文、英文、专业术语和上下文缺失的情况;
- 能够在不修改整个 Agent 的情况下单独替换路由或守护问题;
- 有明确的降级方案:暂停、请求确认、转人工或使用静态规则;
- 根据 Jev AI Showcase 观察社区场景,但不把社区示例当作你的安全证明。
Jev 当前支持文本、JSON 对象和文本数组,图片、音频、视频不是直接输入。非英文数据也应使用自己的领域样本验证,不要把官方产品定位直接当作你的准确率承诺。
常见问题
Jev AI 能保证 Agent 不犯错吗?
不能。Jev 提供概率和 confidence 信号,但不是业务准确率或安全保证。可靠的 Agent 仍然需要权限、硬规则、参数校验、人工审核和审计日志。
为什么不让 LLM 自己判断是否安全?
可以让 LLM 参与理解和解释,但最好不要让同一个生成器同时拥有最终授权权。把小判断拆出来,可以独立测试阈值、反例和失败路径,也能减少提示词变化对安全策略的影响。
高置信度结果可以跳过人工确认吗?
低风险动作可以考虑自动化;高风险动作不能只看 confidence。支付、删除、权限修改和外部发信应结合硬规则、权限和明确确认。
Jev 适合所有 Agent 吗?
不一定。如果 Agent 主要负责开放式写作和对话,LLM 仍是核心;如果 Agent 需要大量路由、工具选择、风险评分和人工升级,Jev 更适合作为决策层。
如何开始构建?
先在 Playground 验证一个低风险判断,然后参考 API 教程 接入服务端。完成基础链路后,再把路由和 guardrail 放进 Agent 编排器。
结语:让 Agent 的行动变得可解释
可靠的 AI Agent 不是让模型拥有更多权限,而是让每一步行动都经过合适的判断、规则和回退路径。Jev AI 可以帮助团队把“是否路由、是否调用、是否升级、是否继续”这些隐含决策显式化,再由代码和人工共同掌握最终控制权。
从一个低风险工具开始,记录每次判断和最终动作,持续用真实失败案例调整问题与阈值。这样,Jev AI 才能成为 Agent 的稳定决策层,而不是另一段难以审计的提示词。
资料核验日期: 2026-09-20